

Vi har framgångsrikt designat strukturen för vår PostgreSQL-databas för att lagra konversationer, ett år har gått, användarna fyller den aktivt, och den har redan miljontals poster, och… något har börjat hacka.
- Del 2: partitionera 'live'
Det handlar om att Med ökad tabellvolym ökar även 'djupet' på indexen — även om det är i en logaritmisk takt. Men över tid tvingar det servern att hantera mycket fler datorsidor, än i början.
Här kommer hjälp från partitionering.
Jag vill notera att vi inte pratar om sharding, det vill säga fördelning av data mellan olika databaser eller servrar. För även om du delar upp data på några servrar, kommer du ändå inte undan problemet med 'uppblåsta' index över tid. Det är klart att om du har möjlighet att sätta in en ny server varje dag, så kommer dina problem att ligga i en helt annan dimension än den specifika databasen.
Vi kommer att titta på inte konkreta skript för att implementera partitionering 'i hårdvara', utan själva tillvägagångssättet — vad och hur vi bör 'skära i bitar', och vad detta önskemål leder till.
Koncept
Låt oss återigen definiera vårt mål: vi vill göra så att mängden lästa PostgreSQL-data vid vilken läsning/skrivning som helst förblir ungefär densamma idag, imorgon och om ett år.
För alla data som samlas kronologiskt (meddelanden, dokument, loggar, arkiv, …) är det naturliga valet av partitioneringsnyckel datum/tid för händelsen. I vårt fall är händelsen tillfället för att skicka meddelandet.
Vi noterar att användarna nästan alltid endast arbetar med de 'senaste' data — läser de senaste meddelandena, analyserar de senaste loggarna,… Nej, självklart kan de bläddra längre tillbaka i tiden, men de gör detta väldigt sällan.
Av dessa begränsningar blir det uppenbart att den optimala lösningen för meddelanden blir 'dagliga' sektioner — eftersom vår användare nästan alltid kommer att läsa det som kom 'idag' eller 'i går'.
Om vi under dagen skriver och läser nästan enbart från en sektion, ger det oss även en mer effektiv användning av minnet och disken — eftersom alla index i sektionen enkelt får plats i minnet, till skillnad från "stora och tjocka" över hela tabellen.
steg-för-steg
Allt som sagts ovan låter som en enda stor vinst. Och det är uppnåeligt, men för det måste vi verkligen anstränga oss — för att beslutet att sektionera en av enheterna kräver att vi "skär upp" relaterade.
Meddelandet, dess egenskaper och projektioner
Eftersom vi bestämde oss för att dela upp meddelanden efter datum, så är det även rimligt att dela upp relaterade enheter-egenskaper (bilagor, lista över mottagare), och också efter meddelandets datum.
Eftersom en av våra typiska uppgifter är att granska registren av meddelanden (olästa, mottagna, alla), så är det också logiskt att "dras in" i sektioneringen efter meddelandets datum.
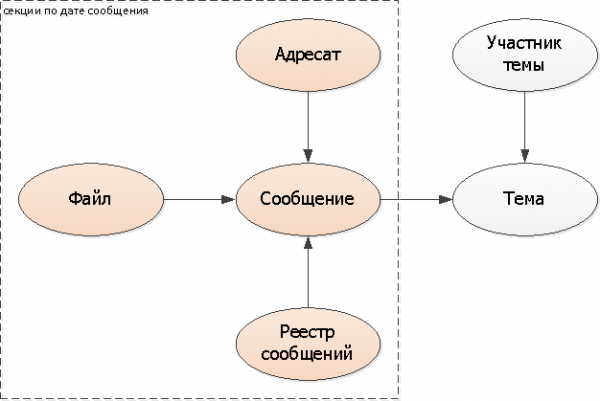
Vi lägger till sektioneringsnyckeln (meddelandets datum) i alla tabeller: mottagare, fil, register. I själva meddelandet behöver vi inte lägga till detta, utan kan använda den befintliga DatumTid.
Ämnen
Eftersom temat är ett av flera meddelanden, så går det inte att "skära" det i samma modell, vi måste förlita oss på något annat. I vårt fall passar det perfekt med datumet för det första meddelandet i konversationen — det vill säga ögonblicket av skapandet av just temat.
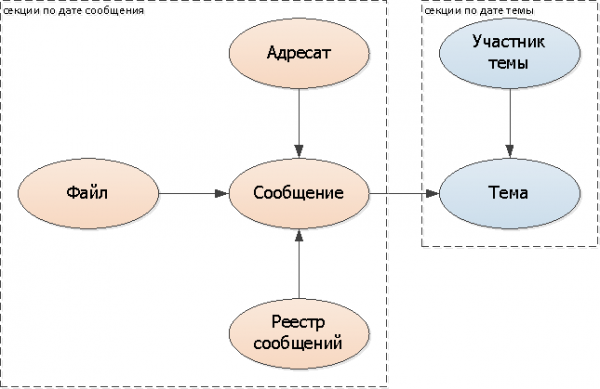
Vi lägger till sektioneringsnyckeln (temadatumet) i alla tabeller: tema, deltagare.
Men nu har vi plötsligt två problem:
- i vilken sektion ska vi leta efter meddelanden om temat?
- i vilken sektion ska vi leta efter temat från meddelandet?
Vi kan naturligtvis fortsätta att söka i alla sektioner, men det skulle bli mycket tråkigt och innebära att förlora alla våra vinster. Därför, för att veta exakt var vi ska leta, ska vi göra logiska länkar/pekare till sektionerna:
- i meddelandet lägger vi till ett fält med temat datum
- till temat lägger vi till ett set av meddelandedatum för denna konversation (kan vara en separat tabell eller en array av datum)
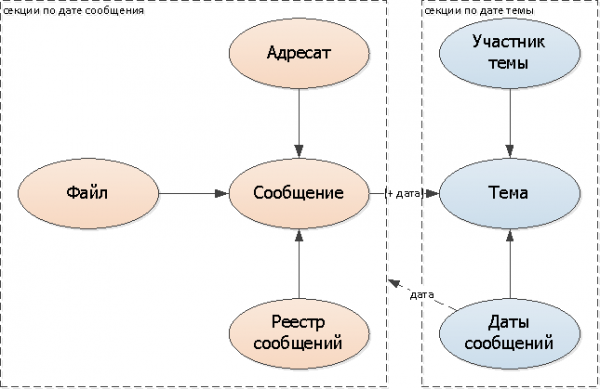
Eftersom modifieringarna av meddelandedatumlistan för varje enskild konversation kommer att vara få (nästan alla meddelanden hamnar inom 1-2 angränsande dagar), så kommer jag att stanna vid just detta alternativ.
Sammanfattningsvis har strukturen av vår databas följande utseende med hänsyn till sektioneringen:
Tabeller: RU, om man har aversion mot kyrilliska bokstäver i namn på tabeller/fält är det bättre att inte titta
-- sektioner efter meddelandedatum
CREATE TABLE "Meddelande_YYYYMMDD"(
  "Meddelande"
    uuid
      PRIMARY KEY
, "Ämne"
    uuid
, "DatumÄmne"
    date
, "Författare"
    uuid
, "DatumTid" -- används som datum
    timestamp
, "Text"
    text
);

CREATE TABLE "Adressat_YYYYMMDD"(
  "DatumMeddelande"
    date
, "Meddelande"
    uuid
, "Person"
    uuid
, PRIMARY KEY("Meddelande", "Person")
);

CREATE TABLE "Fil_YYYYMMDD"(
  "DatumMeddelande"
    date
, "Fil"
    uuid
      PRIMARY KEY
, "Meddelande"
    uuid
, "BLOB"
    uuid
, "Namn"
    text
);

CREATE TABLE "RegisterMeddelanden_YYYYMMDD"(
  "DatumMeddelande"
    date
, "Ägare"
    uuid
, "TypRegister"
    smallint
, "DatumTid"
    timestamp
, "Meddelande"
    uuid
, PRIMARY KEY("Ägare", "TypRegister", "Meddelande")
);
CREATE INDEX ON "RegisterMeddelanden_YYYYMMDD"("Ägare", "TypRegister", "DatumTid" DESC);

-- sektioner efter ämnesdatum
CREATE TABLE "Ämne_YYYYMMDD"(
  "DatumÄmne"
    date
, "Ämne"
    uuid
      PRIMARY KEY
, "Dokument"
    uuid
, "Titel"
    text
);

CREATE TABLE "DeltagareÄmne_YYYYMMDD"(
  "DatumÄmne"
    date
, "Ämne"
    uuid
, "Person"
    uuid
, PRIMARY KEY("Ämne", "Person")
);

CREATE TABLE "DatumMeddelandenÄmne_YYYYMMDD"(
  "DatumÄmne"
    date
, "Ämne"
    uuid
      PRIMARY KEY
, "Datum"
    date
);
Sparar en slant
Men om vi inte använder baserat på värdefältets fördelning (genom triggers och arv eller PARTITION BY), utan "manuellt" på applikationsnivå, kan vi märka att värdet av partitioneringsnyckeln redan lagras i tabellens namn.
Så om du är så oroad över mängden lagrade data, kan vi bli av med dessa "överflödiga" fält och adressera specifika tabeller. Dock kommer alla urval från flera sektioner i detta fall att behöva flyttas till applikationen.
Källa: habr.com
