

Hej, nyligen stötte jag på en intressant uppgift att konfigurera lagring för backup av ett stort antal blockenheter.
Varje vecka gör vi en säkerhetskopiering av alla virtuella maskiner i vår molntjänst, vilket kräver att vi kan hantera tusentals säkerhetskopior och göra det så snabbt och effektivt som möjligt.
Tyvärr passar inte standardkonfigurationerna RAID5, RAID6 i det här fallet på grund av att återställningsprocessen på så stora diskar som våra skulle vara plågsamt långsam och sannolikt aldrig slutföras.
Låt oss överväga vilka alternativ som finns:
— En analog av RAID5, RAID6, men med justerbar paritetsnivå. Backup görs inte blockvis utan för varje objekt separat. Det enklaste sättet att prova erasure coding är att distribuera .
— detta är för närvarande en ännu inte släppt funktion i ZFS. Till skillnad från RAIDZ har DRAID en distribuerad paritetsblock och använder alla diskar i arrayen vid återställning, vilket gör att den bättre klarar av diskfel och återhämtar sig snabbare efter ett fel.
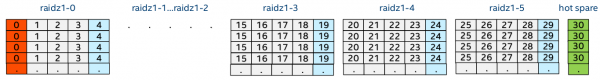
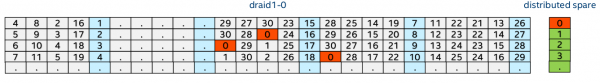
Tillgänglig är en server Fujitsu Primergy RX300 S7 med en processor Intel Xeon CPU E5-2650L 0 @ 1.80GHz, nio moduler RAM-minne Samsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9), en diskhylla Supermicro SuperChassis 847E26-RJBOD1, ansluten via Dual LSI SAS2X36 Expander och 45 diskar Seagage ST6000NM0115-1YZ110 per 6TB varje.
Innan vi kan fatta några beslut måste vi först testa allt ordentligt.
För detta förberedde jag mig och genomförde tester av olika konfigurationer. Jag använde minio som agerade som S3-backend och körde det i olika lägen med olika antal mål.
Huvudsakligen testades fallet minio i erasure coding vs programvaruraid med samma antal diskar och paritetsdiskar, det vill säga: RAID6, RAIDZ2 och DRAID2.
För referens: när du kör minio med bara ett mål, fungerar minio i S3-gatewayläge för att ge din lokala filsystem som S3-lagring. Om du å sin sida startar minio med flera mål aktiveras automatiskt läget för Erasure Coding, vilket kommer att sprida data över dina mål och ge redundans.
Som standard delar MinIO mål på grupper med 16 diskar, där varje grupp har två parity. Det betyder att två diskar kan gå sönder samtidigt utan att data går förlorad.
För att testa prestanda använde jag 16 diskar på 6 TB vardera och skrev små objekt på 1 MB, vilket noggrant beskrev vår framtida belastning, eftersom alla moderna backupverktyg delar data i block på några megabyte och skriver dem på det sättet.
För att genomföra benchmark-testet användes verktyget s3bench som kördes på en fjärrserver och skickade tiotusentals sådana objekt till MinIO i hundratals trådar. Därefter försökte det på samma sätt att hämta dem tillbaka.
Resultaten av benchmark-testet presenteras i följande tabell:
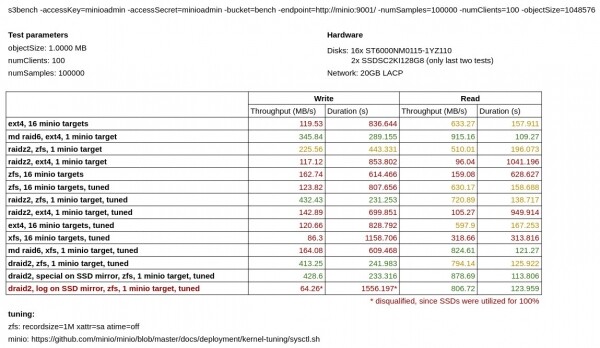
Som vi ser fungerar MinIO i sitt eget erasure coding-läge betydligt sämre vid skrivning än MinIO som körs ovanpå programvaru-RAID6, RAIDZ2 och DRAID2 i samma konfiguration.
Separat blev jag att testa MinIO på ext4 vs XFS. Överraskande nog visade det sig att för min typ av belastning var XFS betydligt långsammare än ext4.
I den första delen av testerna visade Mdadm överlägsenhet över ZFS, men senare , att prestandan för ZFS kan förbättras genom att ställa in följande alternativ:
xattr=sa atime=off recordsize=1Moch efter detta blev testerna med ZFS mycket bättre.
Det kan också noteras att DRAID inte ger någon betydande prestandavinst jämfört med RAIDZ, men i teorin borde det vara mycket säkrare.
I de två senaste testerna försökte jag också flytta metadata (special) och ZIL (logg) till en spegel av SSD. Men flytt av metadata gav ingen betydande ökning i skrivhastighet, och när jag flyttade ZIL stötte mina på en vägg med 100% utnyttjande, så jag anser att detta test misslyckades. Jag utesluter inte att om jag hade snabbare SSD-diskar skulle det kunna ha förbättrat mina resultat kraftigt, men tyvärr hade jag inte tillgång till sådana.
Till slut beslutade jag mig för att stanna vid DRAID och trots sin beta-status är det den snabbaste och mest effektiva lösningen för lagring i vårt fall.
Jag skapade en enkel DRAID2-konfiguration med tre grupper och två distribuerade reservdelar:
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Bra, vi har löst lagringen, nu om vad vi ska använda för backup. Här vill jag direkt berätta om tre lösningar som jag lyckades prova, nämligen:
— en fork , en specialiserad lösning för säkerhetskopiering av blockenheter, har nära integration med Ceph. Kan hämta diffar mellan snapshots och skapa inkrementella säkerhetskopior från dem. Stöder ett stort antal lagringsbackendlösningar, både lokala och S3. Kräver en separat databas för att lagra hash-tabellen för deduplicering. Nackdelar: skriven i python, har en något oresponsiv cli.
— en fork , en välkänd och beprövad lösning för säkerhetskopiering som kan säkerhetskopiera data och utföra bra deduplicering. Kan spara säkerhetskopior både lokalt och på en fjärrserver via scp. Kan säkerhetskopiera blockenheter om den körs med flaggan --special, nackdelar: när en säkerhetskopiering skapas blockeras hela lagret så det rekommenderas att skapa en separat repository för varje virtuell maskin, vilket inte är ett problem eftersom de skapas mycket enkelt.
— ett aktivt växande projekt skrivet i go, ganska snabbt och stödjer ett stort antal lagringsbackends, både lokala lagringslösningar och scp, S3 och mycket mer. Det är värt att notera att det finns en speciellt skapad för restic, som möjliggör snabbaste export av lagret för användning på distans. Av allt ovanstående gillade jag detta mest. Kan säkerhetskopiera från stdin. Har nästan inga märkbara nackdelar, men det finns några egenskaper:
För det första, jag försökte använda det i läge för gemensam repository för alla virtuella maskiner (som Benji), och det fungerade faktiskt ganska bra, men återställningsoperationerna tog ganska lång tid eftersom restic varje gång försöker läsa metadata för alla säkerhetskopior innan återställningen. Detta problem löstes enkelt, precis som med borg, genom att skapa en separat repository för varje virtuell maskin. Denna metod visade sig vara mycket effektiv även för hantering av säkerhetskopior. Separata repositories kan ha ett eget lösenord för åtkomst till data, och vi behöver inte oroa oss för att den globala repository kan gå sönder. Att skapa nya repositories är också lika enkelt som med borg backup.
Under alla omständigheter utförs deduplicering endast i förhållande till den tidigare versionen av säkerhetskopian. Den tidigare säkerhetskopian bestäms av sökvägen för den angivna säkerhetskopian, så om du säkerhetskopierar olika objekt från stdin till ett gemensamt arkiv, glöm inte att ange alternativet
--stdin-filename, eller ange alternativet varje gång explicit--parent.
För det andra tar återställning till stdout betydligt mer tid än återställning till filsystemet på grund av dess parallellitet. I framtiden planeras att lägga till närmare stöd för säkerhetskopior för blockenheter.
För det tredje rekommenderas det för närvarande att använda , eftersom version 0.9.6 har en bugg med långsam återställning av stora filer.
För att testa effektiviteten av säkerhetskopian och hastigheten på skrivning / återställning från säkerhetskopian skapade jag ett separat repo och försökte säkerhetskopiera en liten bild av en virtuell maskin (21 GB). Två säkerhetskopior genomfördes utan att originalet ändrades, med varje av de angivna lösningarna, för att kontrollera hur mycket snabbare/långsammare de deduplicerade data kopieras.
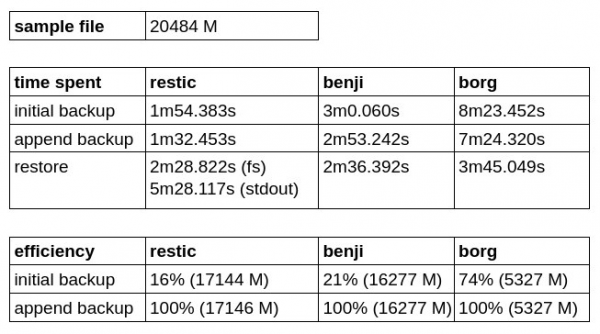
Som vi kan se har Borg Backup den bästa effektiviteten vid den initiala säkerhetskopieringen, men den förlorar i hastighet både för skrivning och återställning.
Restic visade sig vara snabbare än Benji Backup, men tar längre tid att återställa till stdout och kan tyvärr inte skriva direkt till blockenheten än.
Efter att ha vägt för- och nackdelar beslutade jag mig för att stanna vid restic med rest-server som den mest bekväma och lovande lösningen för säkerhetskopior.
I den här skärminspelningen kan du se hur en 10-gigabits kanal fullt utnyttjas när flera säkerhetskopieringsoperationer körs samtidigt. Det är värt att notera att diskutnyttjandet inte överstiger 30%.
Jag är mer än nöjd med den uppnådda lösningen!
Källa: habr.com
