

Inledningen
Den här artikeln handlar om binära sökträd. Nyligen skrev jag en artikel om Där lade jag inte mycket vikt vid binära träd, eftersom metoder för sökning, insättning och borttagning inte var aktuella. Nu har jag bestämt mig för att skriva en artikel just om träd. Låt oss börja.
Ett träd är en datstruktur som består av noder kopplade med kanter. Man kan säga att ett träd är ett specialfall av en graf. Här är ett exempel på ett träd:
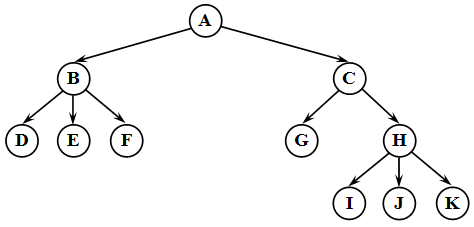
Detta är inte ett binärt sökträd! Allt under kat!
Terminologi
Rot
Roten av ett träd är dess översta nod. I exemplet är detta nod A. I trädet finns det endast en väg från roten till vilken annan nod som helst! I själva verket kan varje nod ses som roten av det underträd som motsvarar denna nod.
Föräldrar/avkommor
Alla noder, förutom roten, har exakt en kant som leder uppåt till en annan nod. Noden som ligger över den aktuella noden kallas förälder till denna nod. Noden som ligger under den aktuella noden och är kopplad till den kallas avkomma till denna nod. Låt oss ta ett exempel. Vi tar nod B, då blir dess förälder nod A, och dess avkommor blir noderna D, E och F.
Blad
En nod som inte har några avkommor kallas ett blad av trädet. I exemplet är noderna D, E, F, G, I, J, K blad.
Detta är den grundläggande terminologin. Andra begrepp kommer att diskuteras senare. Så, ett binärt träd är ett träd där varje nod har högst två avkommor. Som ni gissat kommer trädet i exemplet inte att vara binärt, eftersom noderna B och H har mer än två avkommor. Här är ett exempel på ett binärt träd:
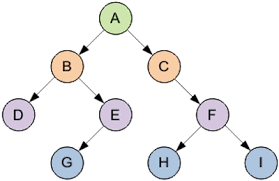
I noderna av trädet kan vilken information som helst finnas. Ett binärt sökträd är ett binärt träd som kännetecknas av följande egenskaper:
- Båda underträden – vänster och höger – är binära sökträd.
- I alla noder i det vänstra underträdet till en godtycklig nod X är datanycklarna mindre än värdet på datanyckeln hos nod X.
- I alla noder i det högra underträdet till en godtycklig nod X är datanycklarna större eller lika med värdet på datanyckeln hos nod X.
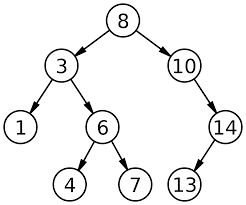
Nyckeln – en egenskap hos noden (till exempel ett nummer). Nyckeln behövs för att man ska kunna hitta elementet i trädet som motsvarar denna nyckel. Exempel på ett binärt sökträd:
Trädets representation
Allteftersom vi går framåt kommer jag att ge vissa (kanske ofullständiga) kodstycken för att förbättra din förståelse. Den fullständiga koden kommer att finnas i slutet av artikeln.
Trädet består av noder. Struktur för en nod:
public class Node<T> {
    private T data;
    private int key;
    private Node<T> leftChild;
    private Node<T> rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }
    public Node<T> getLeftChild() {
        return leftChild;
    }

    public Node<T> getRightChild() {
        return rightChild;
    }
//...övriga metoder för noden
}
Varje nod har två barn (det är möjligt att barnen leftChild och/eller rightChild kommer att ha värdet null). Du har nog förstått att i detta fall är data — de uppgifter som lagras i noden; key — nodens nyckel.
Nu har vi gått igenom noder, så låt oss prata om aktuella problem relaterade till träd. Här och framåt kommer jag att använda termen "träd" för att referera till konceptet av ett binärt sökträd. Strukturen för ett binärt träd:
public class BinaryTree<T> {
     private Node<T> root;

    //metoder för trädet
}
Som klassfält behöver vi endast roten av trädet, eftersom vi från roten med metoderna getLeftChild() och getRightChild() kan nå vilken nod som helst i trädet.
Algoritmer i trädet
Sökandet
Anta att du har ett byggt träd. Hur hittar man elementet med nyckeln key? Du måste systematiskt röra dig nedåt från roten genom trädet och jämföra värdet av key med nyckeln av aktuell nod: om key är mindre än nyckeln för den aktuella noden, gå till vänstra barnet av noden, om större — till högra, om nycklarna är lika — den sökta noden är funnen! Den relevanta koden:
public Node<T> find(int key) {
    Node<T> current = root;
    while (current.getKey() != key) {
        if (key < current.getKey())
            current = current.getLeftChild();
        else
            current = current.getRightChild();
        if (current == null)
            return null;
    }
    return current;
}
Om current blir lika med null, betyder det att sökningen har nått slutet av trädet (på konceptuell nivå befinner du dig på en icke-existerande plats i trädet — barnet av ett blad).
Låt oss granska effektiviteten av sökalgoritmen på ett balanserat träd (ett träd där noderna är distribuera mer eller mindre jämnt). Vidare kommer effektiviteten i sökningen att vara O(log(n)), där logaritmen är bas 2. Se: om det finns n element i det balanserade trädet, innebär det att det kommer att finnas log(n) nivåer i trädet. Och i sökningen, i ett steg av cykeln, går du ner en nivå.
Infoga
Om du har förstått kärnan i sökningen, kommer det inte att vara svårt för dig att förstå insättningen. Du behöver bara gå ner till bladet av trädet (enligt nedstigningsreglerna som beskrivs i sökningen) och bli dess avkomma — vänster eller höger, beroende på nyckeln. Implementering:
   public void insert(T insertData, int key) {
        Node current = root;
        Node parent;
        Node newNode = new Node(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }
I det här fallet behöver vi förutom den aktuella noden lagra information om föräldern till den aktuella noden. När current blir null kommer variabeln parent att innehålla det blad vi behöver.
Effektiviteten för insättning kommer uppenbarligen att vara densamma som för sökningen — O(log(n)).
Ta bort
Borttagning är den mest komplicerade operationen som måste utföras med trädet. Det är uppenbart att vi först måste hitta det element som vi planerar att ta bort. Men vad händer sedan? Om vi bara tilldelar dess referens värdet null, kommer vi att förlora information om delträdet vars rot är denna nod. Borttagningstekniker delas in i tre fall.
Första fallet. Den borttagna noden har inga avkommor
Om den borttagna noden inte har några avkommor betyder det att den är ett blad. Därför kan vi helt enkelt tilldela leftChild eller rightChild i dess förälder värdet null.
Andra fallet. Den borttagna noden har en avkomma
Detta fall är inte heller särskilt svårt. Låt oss återvända till vårt exempel. Anta att vi måste ta bort elementet med nyckeln 14. Håll med om att eftersom den är en höger avkomma till noden med nyckeln 10, kommer vilken avkomma som helst (i det här fallet höger) att ha en nyckel som är större än 10, så vi kan enkelt ”klippa ut” den från trädet och direkt förknippa föräldern med avkomman till den borttagna noden, dvs. noden med nyckeln 10 kopplas till noden 13. En liknande situation skulle vara om vi behövde ta bort en nod som är en vänster avkomma till sin förälder. Tänk på detta själv — exakt analogi.
Tredje fallet. Noden har två avkommor
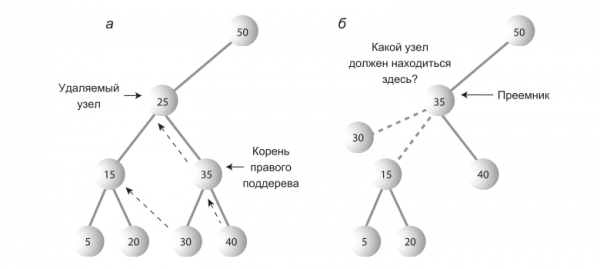
Det mest komplicerade fallet. Vi analyserar det med ett nytt exempel.
Sökning av efterträdare
Anta att vi behöver ta bort noden med nyckeln 25. Vem sätter vi i dess ställe? Någon av dess efterföljare (avkommor eller avkommor till avkommor) måste bli efterträdare(den som ska ta platsen för den borttagna noden).
Hur förstår vi vem som ska bli efterträdare? Det är intuitivt klart att det är noden i trädet vars nyckel är den nästa största efter den borttagna noden. Algoritmen innebär följande. Vi måste gå till dess högra avkomma (alltid till höger, eftersom det redan har sagts att nyckeln för efterträdaren är större än nyckeln för den borttagna noden), och sedan gå ner genom kedjan av vänstra avkommor till denna högra avkomma. I exemplet måste vi gå till noden med nyckeln 35 och sedan gå ner till bladet genom kedjan av dess vänstra avkommor - i detta fall består denna kedja endast av noden med nyckel 30. Strikt talat letar vi efter den minsta noden i uppsättningen av noder som är större än den sökta noden.
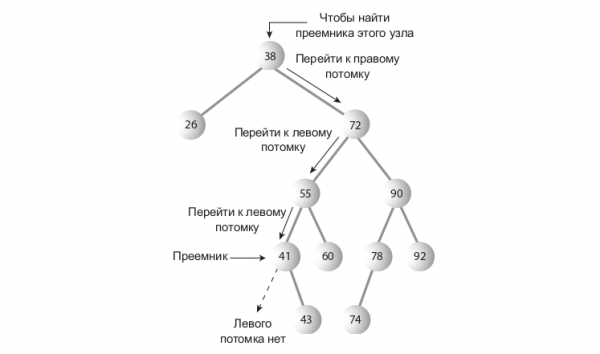
Kod för metoden för att hitta efterträdaren:
    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode; // förälder till efterträdaren
        Node<T> successor = deleteNode; // efterträdare
        Node<T> current = successor.getRightChild(); // bara en "genomgående" nod
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }
        // vid utgången av loopen har vi efterträdaren och föräldern till efterträdaren
        if (successor != deleteNode.getRightChild()) { // om efterträdaren inte är densamma som den högra avkomman till den borttagna noden
            parentSuccessor.setLeftChild(successor.getRightChild()); // tar föräldern över efterträdarens avkomma för att inte förlora den
            successor.setRightChild(deleteNode.getRightChild()); // kopplar efterträdaren till den borttagna nodens högra avkomma
        }
        return successor;
    }
Den fullständiga koden för metoden delete:
public boolean delete(int deleteKey) {
        Node current = root;
        Node parent = current;
        boolean isLeftChild = false; // Beroende på om den borttagna noden är ett vänster- eller högra barn till sin förälder, kommer den booleska variabeln isLeftChild att ta värdet true eller false.
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) { // första fallet
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) { // andra fallet
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else { // tredje fallet
            Node successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }
Tidskomplexiteten kan approximativt anges till O(log(n)).
Sökning av maximum/minimum i trädet
Det är uppenbart hur man hittar det minimi/maksimala värdet i trädet — man måste sekventiellt gå längs kedjan av vänster/höger element i trädet; när man når ett blad, är det minimala/maximala elementet.
    public Node getMinimum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node getMaximum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }
Tidskomplexiteten är O(log(n))
Symmetrisk genomgång
Genomgång — att besöka varje nod i trädet för att utföra en åtgärd med den.
Algoritm för rekursiv symmetrisk genomgång:
- Utför åtgärd med vänster barn
- Utför åtgärd med sig själv
- Utför åtgärd med högra barn
Kod:
    public void inOrder(Node current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");// Här kan det vara vad som helst
            inOrder(current.getRightChild());
        }
    }
Slutsats
Äntligen! Om jag har förklarat något för lite eller om det finns några kommentarer, ser jag fram emot dem i kommentarerna. Som utlovat, här är hela koden.
Node.java:
public class Node {
    private T data;
    private int key;
    private Node leftChild;
    private Node rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }

    public void setLeftChild(Node newNode) {
        leftChild = newNode;
    }

    public void setRightChild(Node newNode) {
        rightChild = newNode;
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public T getData() {
        return data;
    }

    public int getKey() {
        return key;
    }
}
BinaryTree.java:
public class BinaryTree<T> {
    private Node<T> root;

    public Node<T> find(int key) {
        Node<T> current = root;
        while (current.getKey() != key) {
            if (key < current.getKey())
                current = current.getLeftChild();
            else
                current = current.getRightChild();
            if (current == null)
                return null;
        }
        return current;
    }

    public void insert(T insertData, int key) {
        Node<T> current = root;
        Node<T> parent;
        Node<T> newNode = new Node<>(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }

    public Node<T> getMinimum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node<T> getMaximum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }

    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode;
        Node<T> successor = deleteNode;
        Node<T> current = successor.getRightChild();
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }

        if (successor != deleteNode.getRightChild()) {
            parentSuccessor.setLeftChild(successor.getRightChild());
            successor.setRightChild(deleteNode.getRightChild());
        }
        return successor;
    }

    public boolean delete(int deleteKey) {
        Node<T> current = root;
        Node<T> parent = current;
        boolean isLeftChild = false;
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) {
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) {
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else {
            Node<T> successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }

    public void inOrder(Node<T> current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");
            inOrder(current.getRightChild());
        }
    }
}
P.S.
Förfalla till O(n)
Många av er kanske har märkt: vad händer om vi gör så att trädet blir obalanserat? Till exempel genom att lägga in noder med ökande nycklar: 1,2,3,4,5,6… Då kommer trädet att påminna om en länkad lista. Och ja, trädet kommer att förlora sin trästruktur, vilket i sin tur påverkar effektiviteten vid datatillgång. Tidskomplexiteten för operationer som sökning, insättning och borttagning kommer att bli som för en länkad lista: O(n). Det här är en av de viktigaste, enligt min åsikt, nackdelarna med binära träd.
Endast registrerade användare kan delta i omröstningen. , tack.
Jag är inte så länge på Habré, och jag skulle vilja veta vilka ämnen ni skulle vilja se fler artiklar om?
Datastrukturer
Algoritmer (DP, rekursion, datakompression osv.)
Tillämpning av datastrukturer och algoritmer i verkliga livet
Programmering av android-appar i Java
Programmering av web-appar i Java
2 användare röstade. 1 användare avstod.
Källa: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish