

Så, ni samlar in mätvärden. Precis som vi. Vi samlar också in mätvärden. Självklart sådana som är viktiga för affären. Idag kommer vi att berätta om den första länken i vårt övervakningssystem – en statsd-kompatibel aggregationsserver. , varför vi skrev den och varför vi övergav brubeck.
Från våra tidigare artiklar (, ) kan man förstå att vi tills för en tid sedan samlade in etiketterna med hjälp av . Den är skriven i C. Ur kodens synvinkel är den enkel som en kork (detta är viktigt när du vill bidra) och, viktigast av allt, klarar den utan större problem av våra volymer på 2 miljoner mätvärden per sekund (MPS) i toppen. Dokumentationen påstår sig stödja 4 miljoner MPS med en asterisk. Det betyder att du kommer att få den angivna siffran om du konfigurerar nätverket korrekt på Linux. (Vi vet inte hur många MPS man får om man lämnar nätverket som det är). Trots dessa fördelar hade vi flera allvarliga klagomål på brubeck.
Klagomål 1. Github – projektets utvecklare – har slutat att stödja den: publicera patchar och fixar, ta emot våra och (inte bara våra) PR. Under de senaste månaderna (någon gång från februari-mars 2018) har aktiviteten ökat igen, men före det var det nästan två år av total tystnad. Dessutom utvecklas projektet , vilket kan bli ett allvarligt hinder för att införa nya funktioner.
Klagomål 2. Noggrannheten i beräkningarna. Brubeck samlar in endast 65536 värden för aggregation. I vårt fall kan det komma mycket fler värden under aggregationsperioden (30 sekunder) för vissa mätvärden (1 527 392 i toppen). Som ett resultat av sådan sampling verkar max- och minvärdena vara värdelösa. Till exempel så här:
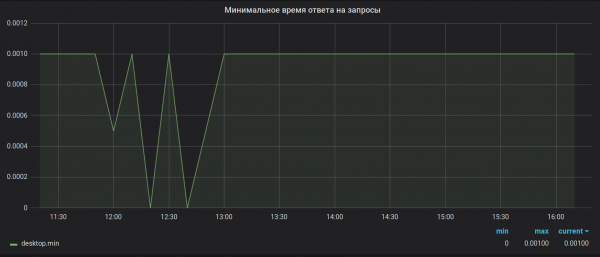
Som det var
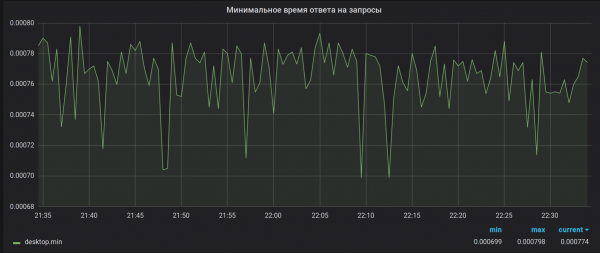
Så som det borde ha varit
Av samma anledning räknas summor överhuvudtaget felaktigt. Lägg till en bugg med överflöde av 32-bitars flyttal, som helt enkelt får servern att krascha vid mottagande av en till synes oskyldig mätning, och det blir verkligen utmärkt. Buggen har för övrigt inte blivit åtgärdad.
Och slutligen, Klagomål X. Vid tidpunkten för artikelns skrivning är vi redo att presentationera alla 14 mer eller mindre fungerande implementationer av statsd, som vi kunnat hitta. Låt oss föreställa oss att en viss avgränsad infrastruktur har vuxit så mycket att 4 miljoner MPS inte längre är tillräckligt. Eller så har den kanske ännu inte vuxit, men metrik för er är redan så viktiga att även korta, 2–3 minuters avbrott i graferna kan bli kritiska och orsaka okontrollerbar ångest hos cheferna. Eftersom behandling av ångest är en tacksam uppgift krävs tekniska lösningar.
För det första, redundans, så att ett plötsligt problem på servern inte utlöser en psykiatrisk zombieapokalyps på kontoret. För det andra, skalbarhet, för att få möjlighet att hantera mer än 4 miljoner MPS, utan att gräva djupt i Linux nätverksstack och kunna växa "brett" till önskad storlek.
Eftersom vi hade marginal för skalbarhet beslutade vi att börja med redundans. "Åh! Redundans! Det är enkelt, det kan vi", tänkte vi och startade 2 servrar, där vi sätter upp en kopia av brubeck på varje. För detta behövde vi kopiera trafiken med metrik till båda servrar och till och med skriva en . Redundansproblemet löste vi så, men... inte särskilt bra. Först verkade allt vara bra: var och en brubeck samlar sin variant av aggregering, skriver data till Graphite var 30:e sekund, skrivandes över det gamla intervallet (detta görs på Graphite-sidan). Om en server skulle fallera har vi alltid en andra med en egen kopia av de aggregerade data. Men här är problemet: om en server fallerar uppstår en "såg" i graferna. Detta beror på att 30-sekundersintervallen vid brubeck inte är synkroniserade, och i ögonblicket av ett fall registreras inte en av dem. Vid uppstart av den andra servern sker samma sak. Ganska acceptabelt, men vi vill ha bättre! Problemet med skalbarhet försvann inte heller. Alla metrik fortsätter att "flyga" till en enda server, och därför är vi begränsade av de samma 2–4 miljoner MPS beroende på nätverkskapaciteten.
Om man tänker lite på problemet och samtidigt gräver snön med en spade, kan en så uppenbar idé dyka upp: vi behöver statsd som kan fungera i distribuerat läge. Det vill säga, ett som har synkronisering mellan noderna baserat på tid och mätdata. "Självklart finns det säkert redan en sådan lösning", sa vi och började googla... och hittade ingenting. Efter att ha grävt igenom dokumentationen för olika statsd ( den 11.12.2017), hittade vi faktiskt ingenting. Tydligen har varken utvecklarna eller användarna av dessa lösningar med SÅDANA mängder mätningar stött på det ännu, annars hade de säkert kommit på något.
Och här kom vi ihåg den "leksaks" statsd - bioyino, som vi skrev på hackathonet just for fun (projektets namn genererade en script inför hackathonet) och insåg att vi akut behövde vår egen statsd. Varför?
- För att det finns för få kloner av statsd i världen,
- för att man kan säkerställa önskad eller närliggande tolerans mot fel och skalbarhet (inklusive synkronisering av aggregerade mätvärden mellan servrar och lösa problemet med konflikter vid sändning),
- för att man kan räkna mätningar mer exakt än vad brubeck gör,
- för att vi kan samla in mer detaljerad statistik, vilket brubeck knappt gav oss,
- för att vi fick chansen att programmera vår egen hyperperformance distributed scalable application, som inte kommer att helt återge arkitekturen av en annan sådan hyper... ni förstår.
Vad ska vi skriva på? Självklart på Rust. Varför?
- för att det redan fanns en prototyp av lösningen,
- för att artikelförfattaren vid den tidpunkten redan kände till Rust och var sugen på att skriva något för produktion med möjlighet att publicera det som open-source,
- för att språk med GC inte passar oss på grund av den typ av trafik vi får (nästan realtime) och GC-pauser är nästan oacceptabla,
- för att vi behöver maximal prestanda, jämförbar med C,
- för att Rust erbjuder oss fearless concurrency, och om vi började skriva detta i C/C++, skulle vi få ännu fler sårbarheter, buffertöverflöden, race conditions och andra skrämmande ord än vad brubeck redan har.
Det fanns också ett argument mot Rust. Företaget hade ingen erfarenhet av att skapa projekt med Rust, och just nu planerar vi inte att använda det i huvudprojektet. Därför fanns det stora farhågor om att inget skulle fungera, men vi beslöt oss för att ta risken och pröva.
Tiden gick...
Till slut, efter flera misslyckade försök, var den första fungerande versionen klar. Vad fick vi? Vi fick något som detta.
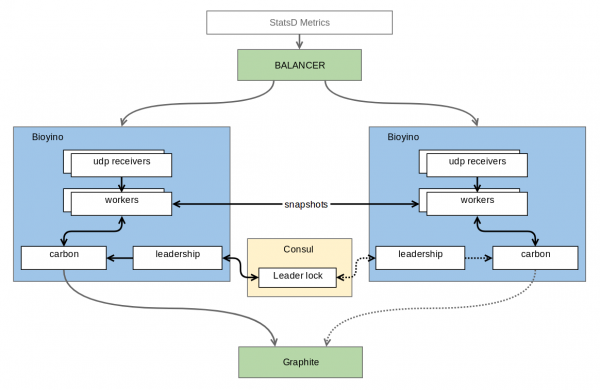
Varje nod får sin egen uppsättning av metrik och samlar dem hos sig själv, utan att aggregera metriker för de typer där full uppsättning krävs för slutlig aggregering. Noderna är kopplade till varandra genom ett protokoll för distribuerad låsning (distributed lock), vilket gör det möjligt att välja den enda (här gråter vi), som är värdig att skicka metrik till den Stora. Just nu löses detta problem med hjälp av , men i framtiden sträcker författarens ambitioner sig till Raft, där den värdiga är självklart konsensusnodens ledare. Förutom konsensus skickar noder ofta (standard en gång per sekund) delar av de föraggregerade metrikerna till sina grannar, som de lyckats samla under denna sekund. Resultatet är att skalbarhet och felresistens bevaras — varje nod håller fortfarande en full uppsättning metriker, men metrikerna skickas nu som aggregerade, över TCP och med kodning i ett binärt protokoll, vilket minskar kostnaderna för duplicering jämfört med UDP avsevärt. Trots det ganska stora antalet inkommande metriker kräver insamlingen mycket lite minne och ännu mindre CPU. För våra väl komprimerade metriker handlar det om endast några tiotal megabyte data. Ytterligare en bonus är att vi slipper onödiga skrivningar av data i Graphite, som det var fallet med burbeck.
UDP-paket med mätningar är fördelade mellan noderna på nätverksutrustningen genom en enkel Round Robin. Naturligtvis analyserar inte nätverksutrustningen innehållet i paketen och kan därför hantera mycket mer än 4M paket per sekund, för att inte tala om mätningarna som den överhuvudtaget inte känner till. Om man tar hänsyn till att mätningarna inte kommer en och en i varje paket, så förutser vi inga prestandaproblem på denna punkt. Vid serverkrasch upptäcker nätverksutrustningen snabbt (inom 1-2 sekunder) detta och tar bort den kraschade servern från rotationen. Som ett resultat av detta kan passiva (dvs. som inte är ledande) noder slås på och av praktiskt taget utan att man märker av nedgångar på graferna. Max, vad vi förlorar — är en del av mätningarna som kommit under den senaste sekunden. Plötslig förlust/avstängning/byte av ledare kommer fortfarande att visa en liten anomali (30-sekundersintervallet är fortfarande desynkroniserat), men med kommunikation mellan noderna kan vi minimera dessa problem, till exempel genom att skicka synkroniserande paket.
Lite om den interna strukturen. Applikationen är naturligtvis flerdimensionell, men trådararkitekturen skiljer sig från den som används i brubeck. Trådarna i brubeck är likartade — var och en ansvarar samtidigt för insamling av information och aggregering. I bioyino är arbetsströmmarna (workers) uppdelade i två grupper: de som ansvarar för nätverket och de som ansvarar för aggregering. Denna uppdelning gör det möjligt att hantera applikationen mer flexibelt beroende på typ av mätningar: där intensiv aggregering krävs kan vi lägga till fler aggregatorer, där det är mycket nätverkstrafik — öka antalet nätverksströmmar. För närvarande arbetar vi på våra servrar med 8 nätverks- och 4 aggregerande strömmar.
Den beräkningsdel (ansvarig för aggregering) är ganska tråkig. De fyllda buffertarna från nätverksströmmarna fördelas mellan beräkningsströmmarna, där de sedan parsar och aggregerar. Vid förfrågan returneras mätningarna för skickning till andra noder. Allt detta, inklusive överföring av data mellan noderna och arbete med Consul, utförs asynkront, på ett ramverk .
Betydligt fler problem under utvecklingen orsakades av den nätverksdel som ansvarar för att ta emot mätvärden. Huvuduppgiften med att separera nätverksflöden i egna enheter var att minska den tid som flödet använder inte för att läsa data från socket. Alternativen med asynkront UDP och vanligt recvmsg föll snabbt bort: den första använde för mycket CPU i user-space för händelsehantering, den andra — för många kontextbyten. Därför används nu med stora buffertar (och buffrar, mina damer och herrar, är inte något oviktigt!). Stöd för vanligt UDP har lämnats kvar för ot belastade fall där det inte är nödvändigt med recvmmsg. I multimeddelande-läget lyckas vi uppnå det viktigaste: majoriteten av tiden klarar nätverksflödet av att rensa operativsystemets kö — läser data från socket och flyttar dem till userspace-bufferten, bara sällan växlar till att ge den fulla bufferten till aggregatörer. Kön i socket ansamlas praktiskt taget inte, antalet bortkastade paket ökar knappt.
Anmärkning
I standardinställningarna är buffertstorleken tillräckligt stor. Om du av någon anledning beslutar dig för att testa servern själv, kanske du stöter på att efter att ha skickat en liten mängd mätvärden, kommer de inte att nå Graphite, utan stanna kvar i nätverksflödets buffert. För att hantera en liten mängd mätvärden behöver du ställa in bufsize och task-queue-size till mindre värden i konfigurationsfilen.
Till sist — lite diagram för de som älskar diagram.
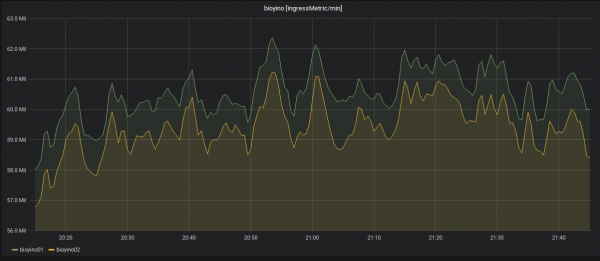
Statistik över antalet inkommande mätvärden per server: över 2 miljoner MPS.
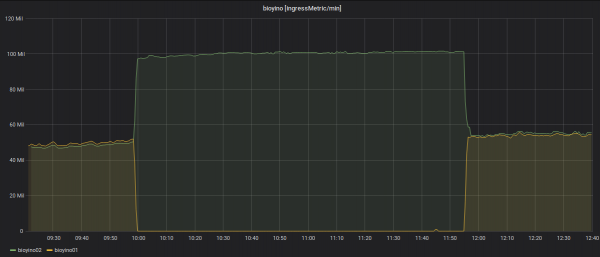
Stängning av en av noderna och omfördelning av inkommande mätvärden.
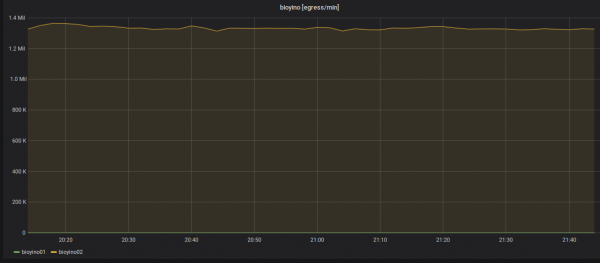
Statistik över utgående mätvärden: endast en nod skickar alltid — raidbossen.
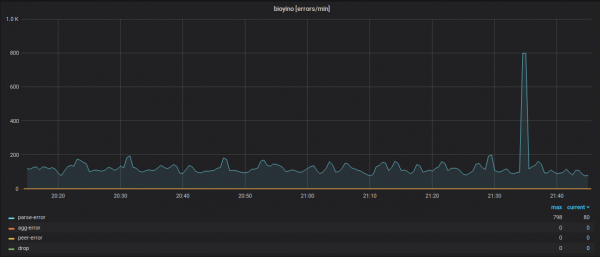
Statistik över varje nods arbete med hänsyn till fel i olika moduler i systemet.
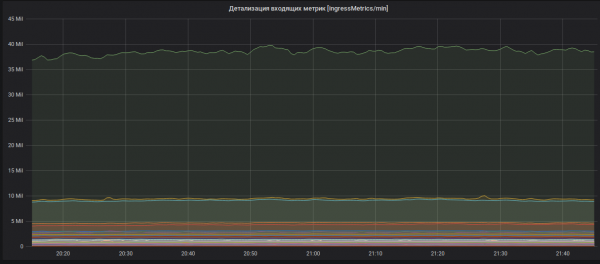
Detaljerad information om inkommande mätvärden (namnen på mätvärdena är dolda).
Vad planerar vi att göra med allt detta vidare? Självklart koda, bl…! Projektet var ursprungligen avsett att vara open-source och kommer att förbli så under hela sin livstid. De närmaste planerna inkluderar att gå över till vår egen version av Raft, byta peer-protokoll till ett mer portabelt, lägga till ytterligare intern statistik, nya typer av mätvärden, fixa buggar och andra förbättringar.
Självklart är alla som vill hjälpa till att utveckla projektet välkomna: skapa PR, Issues, och vi kommer att svara och förbättra när vi kan, osv.
Och med det, som man säger, that’s all folks, köp våra elefanter!
Källa: habr.com
