

I dagsläget har tjänsten "Bitrix24" varken hundratals gigabit trafik eller en stor serverpark (även om det finns en hel del). Men för många kunder är det det viktigaste arbetsverktyget i företaget, en verklig business-critical applikation. Därför får det inte krascha — på något sätt. Men vad händer om det faktiskt inträffar, men tjänsten "återuppstår" så snabbt att ingen märker något? Och hur lyckas man genomföra en failover utan att förlora kvalitet och kunder? Alexander Demidov, chef för den molnbaserade tjänsteverksamheten "Bitrix24", berättade för vår blogg om hur reservsystemet har utvecklats under de 7 år produkten funnits.
Som SaaS lanserade vi "Bitrix24" för 7 år sedan. Den största utmaningen var nog följande: innan lanseringen som SaaS fanns produkten bara i form av en boxlösning. Kunder köpte den från oss, installerade den på sina servrar, skapade en företagsportal — en gemensam lösning för anställdas kommunikation, filhantering, uppgiftshantering, CRM, allt detta. Och vi bestämde oss 2012 för att vi ville lansera detta som SaaS, administrera det själva och säkerställa just den driftsäkerheten och tillförlitligheten. Vi samlade erfarenhet under processen, eftersom vi innan dess inte hade något — vi var bara programvarutillverkare, inte tjänsteleverantörer.
När vi lanserade tjänsten förstod vi att det viktigaste var att säkerställa driftsäkerhet, pålitlighet och ständig tillgänglighet av tjänsten, för om du har en vanlig webbsida, som en butik, och den kraschar och ligger nere i en timme — då drabbas bara du, du förlorar beställningar och kunder, men för din kund — för honom är det inte så kritiskt. Han blir besviken, såklart, men går vidare och köper på en annan webbplats. Men om det är en applikation som hela företagets arbete, kommunikation och beslut hänger på, är det avgörande att vinna användarnas förtroende, dvs. att inte svika dem och att inte krascha. För hela arbetet kan stanna av om något inuti inte fungerar.
Bitrix.24 som SaaS
Den första prototypen satte vi ihop ett år innan den offentliga lanseringen, 2011. Vi byggde den på ungefär en vecka, testade och vridbygde — den fungerade till och med. Man kunde logga in i formuläret, ange namnet på portalen, en ny portal skulle skapas och en användardatabas etableras. Vi tittade på den, värderade produkten i stort, lade ner den, och fortsatte att arbeta med den i ett helt år. Vi hade en stor uppgift: vi ville inte skapa två olika kodbaser, vi ville inte stödja en separat boxprodukt och separata molnlösningar — vi ville göra allt inom en och samma kod.
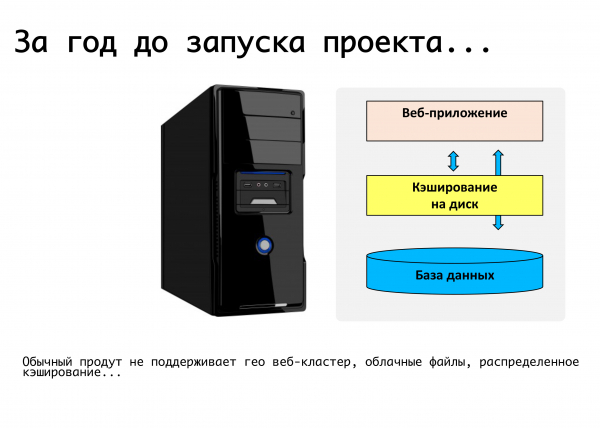
Ett typiskt webbapplikation på den tiden var — en server där något php-kod kördes, en mysql-databas, filer laddades upp, dokument och bilder lades i en upload-mapp – och allt det här fungerade. Tyvärr går det inte att lansera en kritiskt stabil webbservice på detta. Där stöds inte distribuerad cache, och replikering av databaser stöds inte.
Vi formulerade kraven: det handlar om att kunna placera sig på olika platser, stödja replikering, helst att finnas i geografiskt fördelade datacenter. Dela upp produktens logik och lagring av data. Dynamiskt kunna skalas efter belastningen, och statiska datan ska flyttas ut. Utifrån dessa överväganden skapades kraven på produkten vi utvecklade under det året. Under den tiden i plattformen, som blev enhetlig — för boxlösningar, för vår egen tjänst — gjorde vi stöd för de saker som var nödvändiga för oss. Stöd för mysql-replikering på produktnivå: det vill säga utvecklaren som skriver koden behöver inte tänka på hur deras förfrågningar distribueras, de använder vårt api, och vi kan korrekt fördela skriv- och läsförfrågningar mellan master- och slave-servrar.
Vi implementerade stöd på produktiv nivå för olika molnbaserade objektlagringssystem: google storage, amazon s3 — plus, stöd för open stack swift. Därför var det praktiskt både för oss som tjänst och för utvecklarna som arbetar med boxlösningen: om de enbart använder vårt api för arbete, behöver de inte tänka på var filen slutligen sparas, om det är lokalt på filsystemet eller om det hamnar i objektlagringssystemet.
Som resultat beslutade vi direkt att vi skulle göra reservationer på hela datacenter-nivå. År 2012 startade vi helt på Amazon AWS eftersom vi redan hade erfarenhet av att arbeta med denna plattform – vår egen webbplats var placerad där. Det som lockade oss var att det i varje region på Amazon finns flera tillgänglighetszoner – i deras terminologi, flera datacenter, som är mer eller mindre oberoende av varandra och gör att vi kan göra reservationer på datacenter-nivå: om ett av dem skulle gå ner, så replikeras databaserna master-master, webbapplikationsservrarna är reserverade och statiska filer lagras i S3-objektslagring. Belastningen balanseras – vid den tiden med Amazons ELB, men lite senare kom vi till våra egna lastbalanserare eftersom vi behövde en mer komplex logik.
Vad vi ville ha, fick vi...
Alla grundläggande saker som vi ville säkerställa – redundans för själva servrarna, webbapplikationerna, databaserna – fungerade bra. Det enklaste scenariot: om någon av våra webbapplikationer går ner, är det här enkelt – de tas bort från lastbalanseringen.
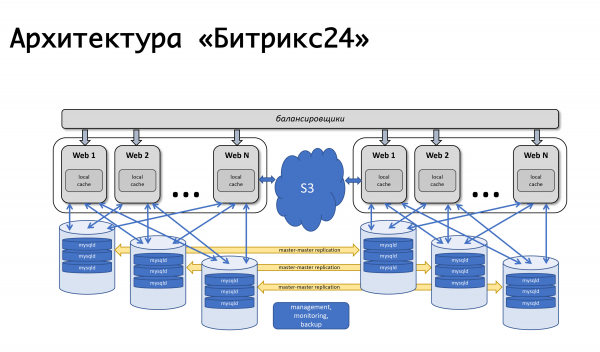
De utrustningar som gick ner markerades som unhealthy av lastbalanseraren (då var det Amazons ELB), som stängde av lastbalanseringen på dem. Amazons autoskalning fungerade: när belastningen ökade, lades nya maskiner till autoskalningsgruppen, och belastningen distribuerades på de nya maskinerna – allt fungerade bra. Med våra lastbalanserare är logiken i stort sett densamma: om något händer med applikationsservern tar vi bort förfrågningar från den, slänger dessa maskiner, startar nya och fortsätter arbeta. Schemat har förändrats något genom åren, men fortsätter att fungera: det är enkelt, tydligt och det finns inga svårigheter med det.
Vi arbetar över hela världen, och belastningstoppar hos kunderna är helt olika, och för att vara ärliga bör vi kunna utföra servicearbete på alla komponenter i vårt system när som helst – utan att kunderna märker det. Därför har vi möjlighet att stänga av databasen och omfördela belastningen till det andra datacentret.
Hur fungerar allt detta? — Vi växlar trafiken till det fungerande datacentret — om det är en krasch i datacentret, så gör vi det helt, om det är vårt planerade arbete i någon specifik databas, så växlar vi en del av trafiken som betjänar dessa kunder till det andra datacentret, replicationen pausas. Om vi behöver nya maskiner för webbapplikationer eftersom belastningen har ökat i det andra datacentret, startar de automatiskt. Vi avslutar arbetet, replicationen återställs, och vi återför hela belastningen. Om vi behöver genomföra speglade arbeten i det andra DC, till exempel installera systemuppdateringar eller ändra inställningar i den andra databasen, så gör vi i stort sett exakt samma, bara i den andra riktningen. Och om det är en krasch, gör vi helt enkelt följande: i övervakningssystemet använder vi mekanismen event-handlers. Om flera kontroller aktiveras och status övergår till kritisk, aktiveras denna handler, en bearbetare som kan utföra viss logik. För varje databas har vi angivit vilken server som är failover för den och vart trafiken ska omkopplas i händelse av att den inte är tillgänglig. Historiskt sett har vi använt nagios eller dess varianter. I princip finns sådana mekanismer i praktiskt taget alla övervakningssystem, något mer komplext använder vi än så länge inte, men vi kanske kommer att göra det i framtiden. För tillfället reagerar övervakningen på brister i tillgängligheten och har möjligheten att omdirigera något.
Har vi reserverat allt?
Vi har många kunder från USA, många kunder från Europa, och många kunder som ligger närmare öst — som Japan, Singapore och så vidare. Självklart är en betydande del av kunderna från Ryssland. Det betyder att verksamheten inte bara är i ett enda område. Användarna vill ha snabb respons, det finns krav på att följa olika lokala lagar, och inom varje region reserverar vi oss för två datacenter, plus att det finns vissa ytterligare tjänster som är bekväma att placera inom en region — för kunder som arbetar i det området. REST-handlarna, autentiseringservrarna, de är mindre kritiska för kundens övergripande arbete, man kan växla mellan dem med en liten acceptabel fördröjning, men man vill inte uppfinna hjulet på nytt när det gäller hur man övervakar dem och vad man ska göra med dem. Därför försöker vi maximalt använda redan existerande lösningar, snarare än att utveckla en egen kompetens inom ytterligare produkter. Och på vissa ställen använder vi helt enkelt DNS-nivåsvängningar, där vi bestämmer tjänstens livskraft med samma DNS. I Amazon finns tjänsten Route 53, men det är inte bara DNS där man kan lägga in poster och vara klar — det är mycket mer flexibelt och praktiskt. Genom den kan man bygga geografiskt distribuerade tjänster med geografiska platser, när man med hjälp av den bestämmer varifrån kunden kom och ger dem olika poster — med den kan man bygga failover-arkitekturer. De samma hälsokontroller ställs in i Route 53, man anger endpoint som övervakas, anger mätvärden, och specificerar vilka protokoll som ska användas för att bestämma tjänstens
Första "men": men hur ska man säkerhetskopiera Route 53? Vad händer om något går fel? Lyckligtvis har vi aldrig stött på det problemet, men jag kommer att berätta varför vi tycker att det är viktigt att säkerhetskopiera. Här förbereder vi oss i förväg. Flera gånger om dagen gör vi en fullständig export av alla zoner vi har i Route 53. Amazons API gör det enkelt att exportera dem i JSON-format, och vi har några reservservrar där vi konverterar och exporterar dem som konfigurationer, och har, grovt sett, en backupkonfiguration. Om något skulle hända kan vi snabbt återställa den manuellt och vi förlorar inte några DNS-inställningar.
Det andra 'men': vad är inte reserverat i denna bild? Själva lastbalanseraren! Vi har fördelat kunderna efter regioner på ett mycket enkelt sätt. Vi har domäner som bitrix24.ru, bitrix24.com, .de — just nu har vi cirka 13 olika domäner som fungerar i många olika zoner. Vi har kommit fram till följande: varje region har sina egna lastbalanserare. Det är lättare att fördela baserat på var den högsta nätbelastningen är. Om det blir ett fel på en specifik lastbalanserare så tas den helt enkelt ur bruk och tas bort från DNS. Om det uppstår problem med en grupp lastbalanserare så reserveras de på andra platser, och omkopplingen mellan dem görs med samma Route 53, eftersom omkopplingen sker med en kort TTL, max inom 2, 3, 5 minuter.
Det tredje 'men': vad är ännu inte reserverat? S3, korrekt. När vi lagrar filer som används av våra användare i S3, trodde vi verkligen att det var oförstörbart och att vi inte behövde göra några reservationer där. Men historien visar att det fungerar annorlunda. Faktum är att Amazon beskriver S3 som en grundläggande tjänst, eftersom Amazon själv använder S3 för lagring av maskinbilder, konfigurationer, AMI-bilder, snapshots… Och om S3 skulle falla, som det en gång gjorde under de 7 år vi har använt Bitrix24, drar det med sig en massa saker — från att virtuella maskiner inte kan starta till problem med API:et och så vidare.
Och S3 kan faktiskt falla — det hände en gång. Därför kom vi fram till följande plan: för flera år sedan fanns det inga seriösa offentliga objekthanteringslagringssystem i Ryssland, och vi övervägde att skapa något eget... Som tur var påbörjade vi aldrig det, för vi skulle ha fastnat i den expertis vi saknar och säkert ”slarvat”. Nu finns det S3-kompatibla lagringslösningar från Mail.ru, Yandex och flera andra leverantörer. Vi kom slutligen fram till att vi ville ha, för det första, reservkopiering och för det andra, möjlighet att arbeta med lokala kopior. För den ryska regionen använder vi Mail.ru Hotbox-tjänsten, som är API-kompatibel med S3. Vi behövde inga större kodförändringar för applikationen, och vi implementerade följande mekanism: det finns triggers i S3 som aktiveras vid skapande/ta bort av objekt, och Amazon erbjuder en tjänst som heter Lambda — det är en serverlös körning av kod som utförs just när de olika triggerna aktiveras.
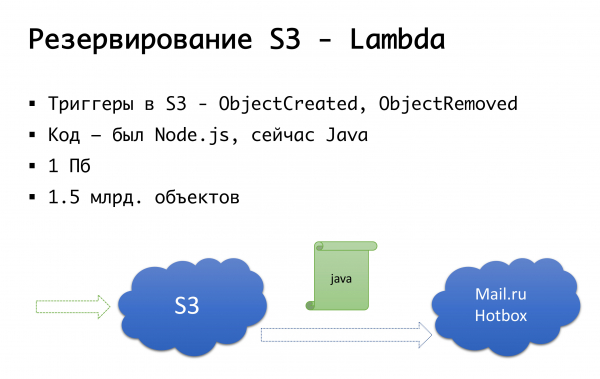
Vi gjorde det väldigt enkelt: när en trigger aktiveras, kör vi koden som kopierar objektet till Mail.ru-lagringen. För att kunna arbeta fullt ut med lokala datakopior behöver vi också bakåtsynkronisering, så att kunder i den ryska sektorn kan arbeta med lagringen som ligger närmare dem. Mail kommer snart att slutföra triggerna i sin lagring — det kommer att vara möjligt att utföra bakåtsynkronisering på infrastrukturnivå, men hittills gör vi det på nivån av vår egen kod. Om vi ser att en kund har laddat upp en fil, placerar vi en händelse i kön på vår kodnivå, bearbetar den och gör bakåtreplikering. Det som är dåligt med detta är: om vi har något arbete med våra objekt utanför vår produkt, med andra externa verktyg, så räknar vi inte med det. Därför väntar vi tills triggerna finns på lagringsnivån, så att oavsett varifrån vi kör koden, kan objektet som kom till oss kopieras åt andra hållet.
På kodnivå anges båda lagringslösningarna för varje kund: en som är primär och en som är backup. Om allt fungerar bra arbetar vi med den lagringslösning som är närmast oss: det vill säga våra kunder som använder Amazon arbetar med S3, medan de som verkar i Ryssland använder Hotbox. Om en signal slår till måste vår failover kopplas in, och vi växlar kunderna till en annan lagringslösning. Vi kan aktivera denna signal oberoende av regioner och växla dem fram och tillbaka. I praktiken har vi ännu inte använt detta, men mekanismen är förberedd och vi hoppas att vi en dag behöver och får användning för denna växling. Detta har redan hänt en gång.
Oj, har er Amazon flytt?
I april i år är det årsdag för start av blockeringen av Telegram i Ryssland. Den mest drabbade leverantören som påverkades är Amazon. Och tyvärr har det framförallt drabbat ryska företag som arbetade globalt.
Om företaget är globalt och Ryssland utgör en väldigt liten del, 3-5% – ja, på ett eller annat sätt kan man offra dem.
Om det är ett rent ryskt företag – jag är säker på att man behöver vara lokaliserad – det kommer helt enkelt att vara enklare och mer bekvämt för användarna, med färre risker.
Och om det är ett företag som arbetar globalt och har ungefär lika många kunder i Ryssland som i resten av världen? Samarbetet mellan segmenten är viktigt, och de måste på något sätt arbeta tillsammans.
I slutet av mars 2018 skickade Roskomnadzor ett brev till de största operatörerna, där de meddelade att de planerade att blockera flera miljoner IP-adresser från Amazon för att blockera... meddelandetjänsten Zello. Tack till dessa leverantörer – de läckte framgångsrikt brevet, och det blev klart att anslutningen till Amazon kan kollapsa. Det var en fredag, och vi rusade i panik till kollegorna på servers.ru och sa: "Vänner, vi behöver flera servrar som inte ligger i Ryssland, inte i Amazon, utan till exempel någonstans i Amsterdam", för att ha möjlighet att på något sätt placera egna. vpn och proxy för vissa endpointar, som vi inte kan påverka, till exempel endpointar för S3 — vi kan inte bara försöka starta en ny tjänst och få en annan ip, vi måste fortfarande nå dit. Under några dagar konfigurerade vi dessa servrar, startade dem, och i allmänhet var vi förberedda tills blockeringarna började. Det är intressant att RKN, efter att ha sett all uppståndelse och panik, sa: "Nej, vi kommer inte att blockera något nu". (Men det var precis fram till dess att de började blockera Telegram.) När vi hade ställt in bypass-möjligheter och förstått att blockeringen inte infördes, valde vi ändå att inte ta itu med hela situationen. Så, bara för säkerhets skull.
Och här lever vi faktiskt 2019 under blockeringar. Jag kollade i går kväll: ungefär en miljon ip-blockeringar fortsätter. Visserligen har de nästan helt avblockerat Amazon, vid toppar nådde det upp till 20 miljoner adresser… I allmänhet är verkligheten sådan att det kan saknas anslutning, bra anslutning — plötsligt. Det kan saknas av tekniska skäl — bränder, grävmaskiner och allt det där. Eller, som vi har sett, inte helt tekniska skäl. Så någon stor och betydande, med egna AS:er, kan förmodligen styra det på andra sätt — direct connect och andra attribut som redan på nivå l2. Men i en enklare variant, som vi eller ännu mindre, kan man för säkerhets skull ha reservkopplingar på servernivå, startade någon annanstans, förkonfigurerade vpn, proxy, med möjlighet att snabbt växla konfiguration i de segment som är kritiska för anslutningen. Detta har vi haft nytta av flera gånger när blockeringarna av Amazon började, vi dirigerade i värsta fall faktiskt S3-trafik genom dem, men så småningom löste allt sig.
Men hur reserverar man… en hel tjänsteleverantör?
För närvarande har vi ingen plan för en total nedstängning av Amazon. Vi har en liknande plan för Ryssland. Vi använde en leverantör i Ryssland där vi valde att ha flera platser. För ett år sedan stötte vi på ett problem: även om det är två datacenter kan det på leverantörens nätverkskonfiguration uppstå problem som påverkar båda datacentren. Vi kan få otillgänglighet på båda platserna. Och så blev det. I slutändan har vi omvärderat vår arkitektur. Den har inte förändrats så mycket, men för Ryssland har vi nu två platser, som inte ligger hos samma leverantör utan hos två olika. Om något går fel hos en av dem kan vi växla till den andra.
Hypotetiskt sett överväger vi att för Amazon reservera hos en annan leverantör; kanske Google, eller någon annan... Men hittills har vi i praktiken sett att om Amazon drabbas av problem i en enskild availability-zon så är stora problem på regional nivå ganska sällsynta. Därför har vi en teoretisk uppfattning om att vi kanske kommer att göra en reservlösning för "Amazon - inte Amazon", men i praktiken har det ännu inte hänt.
Några ord om automatisering
Är automatisering alltid nödvändig? Här är det lämpligt att påminna om Dunning-Kruger-effekten. På x-axeln har vi vår kunskap och erfarenhet som vi samlar, och på y-axeln självförtroendet i våra handlingar. Först vet vi ingenting och har väldigt lite självförtroende. Sedan vet vi lite bättre och blir megasjälvsäkra - det kallas "dumhetens topp", väl illustrerat av bilden "idioti och mod". Därefter har vi lärt oss lite och är redo att gå in i striden. Sedan trillar vi på några allvarliga fallgropar, hamnar i förtvivlans dal, där vi verkar veta något, men i själva verket vet vi fortfarande väldigt lite. Sedan, med mer erfarenhet, blir vi mer självsäkra.
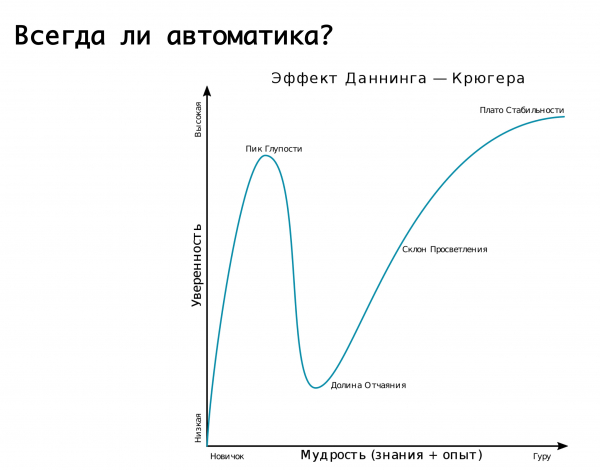
Vår logik kring olika omkopplingar automatiskt vid olika incidenter beskrivs mycket väl av denna graf. Vi började med att vi ingenting kunde, nästan allt arbete utfördes manuellt. Sedan insåg vi att vi kunde sätta på en automatisk lösning för allt och, liksom, sova lugnt. Men plötsligt snubblade vi på stora problem: vi får en falsk positiv, och vi växlar fram och tillbaka trafik när vi egentligen inte borde ha gjort det. Därmed går replikeringen sönder eller något annat — det är den berömda dalen av förtvivlan. Och sedan kommer vi till insikten att man alltid måste tänka smart. Det vill säga, det är meningsfullt att förlita sig på automatik, med tanke på möjligheten för falska positiva. Men! Om konsekvenserna kan vara förödande, är det bättre att överlåta detta till skiftledningen, de jouransvariga ingenjörerna, som kan se till att det verkligen är en incident och utföra de nödvändiga åtgärderna manuellt…
Slutsats
Under 7 år har vi gått från att när något kraschade var det panik-paniken, till att förstå att problem inte existerar, det finns bara uppgifter som måste - och kan - lösas. När du bygger en tjänst, se på den från ovan, bedöm alla risker som kan inträffa. Om du genast ser dem - förutse reservlösningar och möjligheten att bygga en fel-tolerant infrastruktur, eftersom varje punkt som kan gå sönder och få tjänsten att inte fungera - kommer definitivt att göra det. Och även om det verkar som om vissa infrastrukturelement absolut inte kommer att gå sönder — som s3 — kom ihåg att de kan. Och åtminstone i teorin, ha en uppfattning om vad du ska göra med dem om något skulle hända. Ha en plan för riskhantering. När du överväger att göra allt automatiskt eller manuellt - bedöm riskerna: vad händer om automatik börjar växla allt — kommer det att leda till en ännu sämre situation jämfört med en incident? Kanske behöver man någonstans ett rimligt avvägande mellan användningen av automatik och reaktionen från den jouransvarige ingenjören, som bedömer den verkliga situationen och förstår om något hastigt behöver växlas eller "ja, men inte just nu".
En rimlig kompromiss mellan perfektionism och de verkliga resurser, tiden och pengarna som du kan lägga på den lösning du kommer att få.
Denna text är en utökad och fördjupad version av Alexander Demidovs rapport vid konferensen .
Källa: habr.com
