

BLE i mikroskopet (ATT:er GATT:er…)
Del 1, översikt
Det har redan gått ganska lång tid sedan den första specifikationen för Bluetooth 4.0 släpptes. Och även om BLE är ett mycket intressant ämne, avskräcker det fortfarande många utvecklare på grund av sin komplexitet. I mina tidigare artiklar har jag huvudsakligen granskat det mest grundläggande lagret, Link Layer och Physical Layer. Detta gjorde det möjligt att undvika att ta upp så komplexa och förvirrande begrepp som attributprotokoll (ATT) och det generella attributprofil (GATT). Men vi kan inte undvika dem, för att utveckla kompatibla enheter är det omöjligt utan att förstå dem. Idag skulle jag vilja dela med mig av dessa kunskaper. I min artikel kommer jag att bygga på för nybörjare från Nordic. Så låt oss börja.
Varför är allt så komplicerat?
Enligt min åsikt var det tydligt från början att kontroll av enheter via smartphones är ett mycket lovande och långsiktigt ämne. Därför beslutades det att strukturera det omedelbart och maximalt. Så att tillverkare av olika enheter inte skulle hitta på sina egna protokoll som sedan blir inkompatibla. Därav komplexiteten. Redan i det första steget försökte man pressa in allt som var möjligt i BLE-protokollet. Och oavsett om det kommer att vara användbart i framtiden eller inte. Dessutom förutsågs möjligheten att utöka enhetslistan för framtiden.
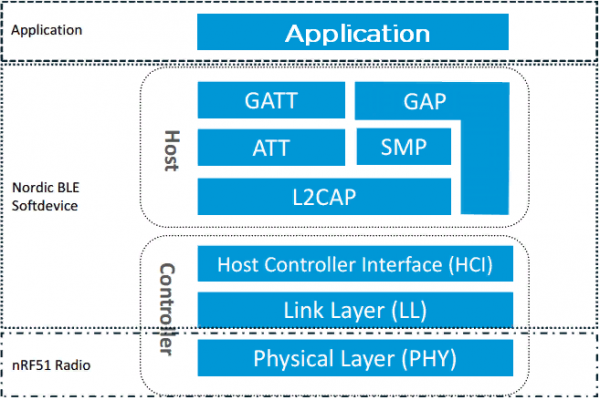
Låt oss titta på en bild där schemat för BLE-protokollet är ritat. Det består av flera lager. Det nedersta, det fysiska lagret (PHY) ansvarar för enhetens radiokanal. Link Layer (LL) innehåller hela sekvensen av byte i det överförda meddelandet. I tidigare artiklar har vi studerat just detta. Host Controller Interface (HCI) är protokollet för utbyte mellan lager eller chip i BLE, om Controller och Host implementerats på olika chip. Logisk länkkontroll och anpassningsprotokoll (L2CAP) ansvarar för bildandet av paket, uppdelning i ramar, felkontroll och paketsammanställning. Security Manager Protocol (SMP) ansvarar för kryptering av paket. Allmän åtkomstprofil (GAP) ansvarar för den initiala datutbytet mellan enheter för att bestämma 'Vem är vem'. Det omfattar också scanning och advertising. I denna artikel kommer jag att fokusera på de två återstående delarna av protokollet — GATT och ATT. GATT är en överbyggnad på ATT, så de är starkt sammanflätade.
För att förenkla berättelsen skulle jag vilja använda en analogi. Jag har hört den någonstans och skulle vilja stödja den. Föreställ dig en BLE-enhet som en bokhylla med flera hyllplan. Varje hylla representerar ett särskilt ämne. Till exempel har vi hyllor med skönlitteratur, matematik, uppslagsverk. På varje hylla står böcker med angivet ämne. Och i vissa böcker finns det till och med pappersbokmärken med anteckningar. Dessutom har vi en liten papperskatalog över alla böcker. Om du minns skolbibliotek — det är en smal låda med papperskort. Med denna analogi är bokhyllan profilen för vår enhet. Hyllorna är tjänster, böcker är egenskaper, och katalogen är en tabell med attribut. Bokmärkena i böckerna är deskriptorer, som jag också kommer att berätta mer om senare.
Alla som har utvecklat enheter vet att det i många projekt finns liknande kodbitar. Faktum är att många enheter har liknande funktionalitet. Till exempel, om enheterna drivs av batterier, kommer problemet med laddning och övervakning av deras nivå att vara detsamma. Det samma gäller sensorer. Egentligen erbjuder det objektorienterade tillvägagångssättet i programmering "möjlighet att skapa objekt som kopplar ihop egenskaper och beteenden i en självständig förening som sedan kan återanvändas på många sätt". Enligt min mening har BLE försökt med en liknande ansats. En grupp från Bluetooth Special Interest Group (SIG) har utvecklat profiler. Enheter från olika tillverkare som har samma profiler bör kunna arbeta tillsammans utan problem. Profiler består i sin tur av tjänster, och tjänster av egenskaper som kompletteras med deskriptorer. I allmänhet kan detta se ut så här:
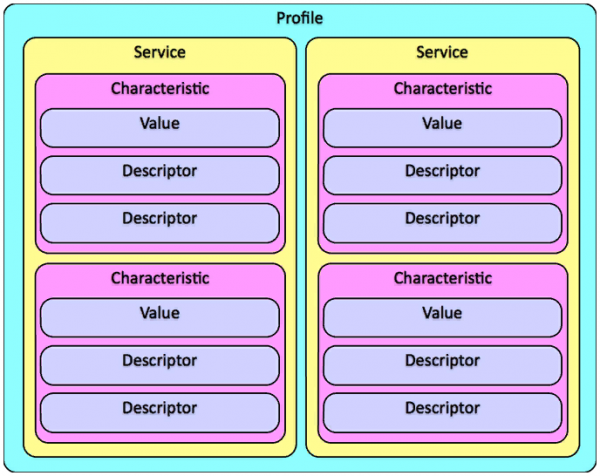
Som exempel kan vi titta på profilen för en pulsmätare (fitnessarmband). Den består av två tjänster och flera egenskaper. Från den kan vi omedelbart förstå hierarkin i profilen. Egenskapen för kontrollpunkten återställer den totala kaloriutgiften till noll.
1. Tjänsten för hjärtfrekvens inkluderar tre egenskaper (0x180D):
a) Obligatorisk egenskap för hjärtfrekvens (0x2A37)
b) Valfri egenskap för kroppens sensorposition (0x2A38)
c) Konditionell egenskap för kontrollpunkten för hjärtfrekvens (0x2A39)
2. Tjänsten för batteriövervakning (0x180F):
a) Obligatorisk egenskap för batterinivå (0x2A19)
UUID
För att vi tydligt ska kunna referera till profilens element (tjänster, egenskaper och deskriptorer) måste vi numrera dem på något sätt. För detta ändamål introduceras begreppet Universally Unique ID (UUID) eller Universell unik identifierare. I parenteserna vid varje rad anges just UUID. Här finns det en egenskap. För UUID beslutades det att använda en kodlängd på 16 och 128 bitar. Varför, undrar ni? I BLE-protokollet styrs allt av energibesparing. Därför är en dimension på 16 bitar helt rimlig. Det är osannolikt att det kommer att skapas fler än 65 000 unika tjänster och egenskaper inom den närmaste framtiden. Just nu har vi redan räknat allt vi kunde (minns ni varifrån det kommer — "han har räknat er också" :-)) Numrerade element , , och du kan titta på länkarna.
Men jag tror att vi alla minns historien om de 4 bytes IP-adressen på internet. Först trodde man att det skulle räcka, men nu kan vi fortfarande inte gå över till en 6 bytes adress. För att inte upprepa det misstaget och ge plats åt busiga händer från amatörer, beslutade SIG redan från början att införa även 128-biters UUID. Detta påminner mig personligen om det olicensierade 433 MHz-bandet, som gavs åt olika hobbyister från radiokanalen. I vårt fall gavs den 128-bitiga identifieraren för tjänster och egenskaper ut. Detta innebär att vi, för våra tjänster och enheter, praktiskt taget kan använda vilket 128-bit värde som helst. Chansen att skapa en identisk UUID är ändå nära noll.
I själva verket har korta 16-biters UUID sitt eget utvidgande till ett 128-bitars värde. I specifikationen kallas denna utvidgning Bluetooth Base UUID och har värdet 00000000-0000-1000-8000-00805F9B34FB. Om, till exempel, 16-biters UUID för attributet har värdet 0x1234, kommer dess motsvarande 128-bitars UUID att ha värdet 00001234-0000-1000-8000-00805F9B34FB. Det finns även en motsvarande formel angiven:
128_bit_value = 16_bit_value * 2^96 + Bluetooth_Base_UUID
Varifrån detta magiska nummer kommer vet jag inte. Om någon av läsarna vet — låt dem skriva i kommentarerna (Användaren med smeknamnet Sinopteek har redan gjort det. Se kommentarerna). När det gäller att skapa 128-bitars UUID, kan man i princip använda en speciell , som gör detta åt dig.
ATT: er GATT: er…
Det är faktiskt här det blir intressant. Jag påminner om att ATT är baserat på en klient-server-relation. Just nu tittar vi på serverdelsystemet. Det innehåller information som sensorvärden, tillstånd för ljusbrytaren, positionsdata, osv. Nu när alla "deltagare i vår parad" är numrerade, måste vi på något sätt placera dem i minnet på enheten. För detta placerar vi dem i en tabell som kallas attributtabellen. Kom ihåg detta noggrant. Detta är hjärtat av BLE. Det är just detta vi kommer att fokusera på i fortsättningen. Nu ska vi kalla varje rad en attribut. Den här tabellen finns i djupet av stacken och vi har vanligtvis ingen direkt åtkomst till den. Vi initierar den och gör anrop till den, men vad som händer där inne är dolt för oss.
Låt oss titta på bilden från specifikationen, men innan dess vill jag genast påpeka förvirringen kring termer, särskilt kring descriptors. Rollen för en descriptor är att komplettera beskrivningen av en egenskap. När vi behöver utöka dess funktioner, då använder vi descriptors. De är också attribut och, liksom tjänster och egenskaper, finns de i attributtabellen. Vi kommer att gå igenom dem i detalj i den andra delen av artikeln. Men ibland kallas descriptors för radnumret i attributtabellen. Det är något att ha i åtanke. För att inte förväxla dem, kommer vi för dessa ändamål att använda termen "attributpekar".
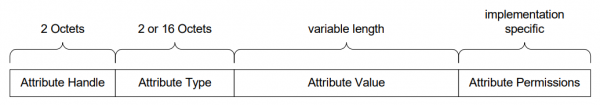
Så, ett attribut är ett diskret värde som har följande egenskaper kopplade till sig:
1. Attributpekar (Attribute Handle) - detta är indexet i tabellen som motsvarar attributet.
2. Attributtyp (Attribute Type) - detta är UUID som beskriver dess typ.
3. Attributvärde (Attribute Value) - detta är data som indexeras av attributpekaren.
4. Attributbehörigheter (Attribute Permissions) - detta är delen av attributet, behörigheter som inte kan läsas eller skrivas med hjälp av attributprotokollet.
Hur ska vi förstå allt detta? Attributpekaren är, för att tala i termer, dess nummer i vår tabell.
Det gör det möjligt för kunden att referera till en attribut i läs- eller skrivförfrågningar. Vi kan numrera våra rader (attribut) från 0x0001 till 0xFFFF. I vår association med ett bibliotek är detta kortnumret i den papperskatalogen. På samma sätt som i ett biblioteks katalog placeras korten i ordning efter stigande nummer. Numret på varje efterföljande rad måste vara större än det föregående. Precis som i ett bibliotek kan vissa kort ibland försvinna, så kan det också finnas luckor i radernas numrering. Detta är tillåtet. Det viktigaste är att de går i ordning.
Attributtypen avgör vad den aktuella attributen representerar. I analogi med C-språket,
där det finns booleska, numeriska variabler och strängar, så är det här. Genom attributtypen får vi veta
vad vi har att göra med och hur vi ska arbeta med denna attribut vidare. Nedan kommer vi att titta på några specifika attributtyper. Till exempel 'service declaration' (0x2800), 'characteristic declaration' (0x2803), 'descriptor declaration' (0x2902).
Attributens värde är faktiskt dess värde, förlåt för tautologin. Om attributtypen är en sträng kan attributvärdet till exempel vara slogan "Hello World !!!". Om attributtypen är en 'service declaration', då är dess värde själva tjänsten. Ibland kan det även vara information om var man kan hitta andra attribut och deras egenskaper.
Attributens behörigheter gör det möjligt för servern att förstå om läs- eller skrivåtkomst är tillåten.
Observera att dessa behörigheter endast gäller attributens värde och inte pekaren, typen och själva behörighetsfältet. Det vill säga, om skrivåtkomst tillåtits för attributet, kan vi byta till exempel, raden "Hello World !!!" mot raden "Good morning". Men vi kan inte förbjuda att skriva en ny rad eller ändra attributtypen och ange raden som en 'service declaration'. När en klient kontaktar servern begär klienten dess attribut. Detta gör det möjligt för klienten att ta reda på vad servern kan tillhandahålla. Även om det inte nödvändigtvis är nödvändigt att läsa och skriva värden.
Hur det ser ut
Konceptet GATT består av att gruppera attribut i en attributtabell ihop i en mycket specifik och logisk ordning. Låt oss ta en närmare titt på profilen för hjärtfrekvensen som visas nedan. Den vänstra kolumnen i denna tabell är valfri. Den beskriver helt enkelt vad denna rad (attributet) är. Alla andra kolumner är redan bekanta för oss.
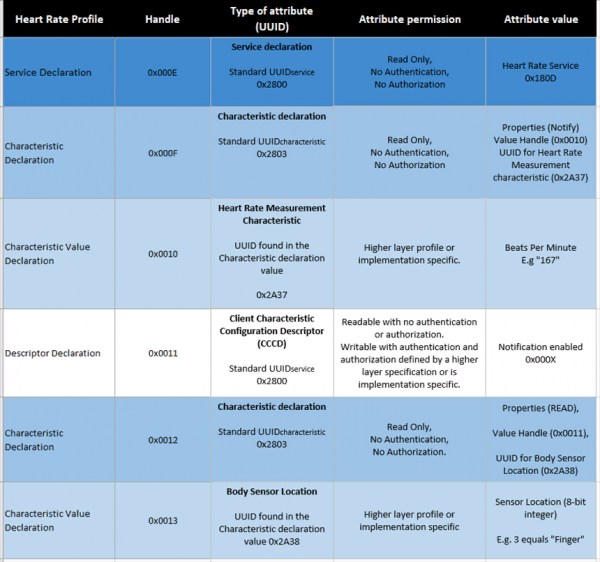
I överkant av varje grupp har vi alltid attributet för tjänstebeskrivning. Dess typ är alltid 0x2800, och pekaren beror på hur många attribut som redan finns i tabellen. Dess behörigheter är alltid endast läsbara, utan någon autentisering eller auktorisering. Vi kommer att prata om dessa begrepp lite senare. Värdet är en annan UUID som definierar vilken tjänst detta är. I tabellen är värdet 0x180D, vilket Bluetooth SIG definierar som tjänsten för hjärtfrekvens.
Efter tjänstebeskrivningen följer en beskrivning av egenskapen. I formen liknar den beskrivningen av tjänsten. Dess UUID har alltid värdet 0x2803, och behörigheterna är också alltid endast läsbara utan någon autentisering eller auktorisering. Låt oss titta på fältet Attributvärde, som inkluderar viss information. Det innehåller alltid en pekare, UUID och en uppsättning egenskaper. Dessa tre element beskriver den efterföljande beskrivningen av egenskapsvärdet. Pekaren indikerar naturligtvis platsen för beskrivningen av egenskapsvärdet i attributtabellen. UUID beskriver vilken typ av information eller värde vi kan förvänta oss. Till exempel, temperaturvärde, status för en ljusströmbrytare eller något annat godtyckligt värde. Slutligen beskriver egenskaperna hur man kan interagera med egenskapsvärdet.
Här står vi inför ytterligare en fälla. Den handlar om behörigheterna för attributen och egenskaperna. Låt oss titta på bilden av bitfältens egenskaper från specifikationen.
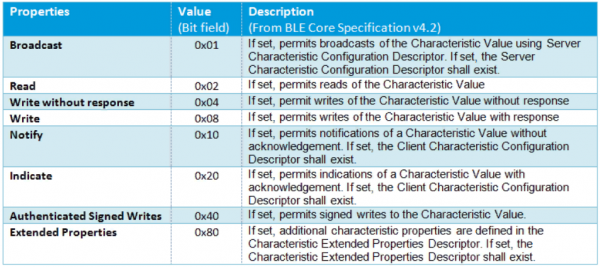
Som ni ser finns det här också fält som ger läs- och skrivmöjligheter. Du kanske undrar varför vi har behörigheter för läsning/skrivning för attributet och egenskapen.
Läs-/skrivåtkomst för egenskapsvärdet? Ska de inte alltid vara desamma? Faktum är att egenskapsvärdena i huvudsak är rekommendationer för kunden, som används i GATT och applikationslager. De är bara tips om vad kunden kan förvänta sig av attributet för egenskapsdeklarationen. Låt oss gå in på detta mer noggrant. Vilka typer av åtkomsträttigheter finns det för attributet?
1. Åtkomsträttigheter:
— läsning
— skrivning
— läsning och skrivning
2. autentiseringstillstånd:
— autentisering krävs
— autentisering krävs inte
3. auktoriseringstillstånd:
— auktorisering krävs
— auktorisering krävs inte
Den viktigaste skillnaden mellan attributåtkomsträttigheter och egenskapsegenskaper är att de förstnämnda gäller servrar medan de senare gäller kunder. En server kan ha läsbehörighet för egenskapsvärdet, men det kan finnas krav på autentisering eller auktorisering. Därför, när kunden begär egenskapsvärden, får vi veta att läsning är tillåten. Men vid försök att läsa får vi ett felmeddelande. Så det är rimligt att säga att rättigheternas prioritet över egenskaperna är avgörande. Kunskapen om vilka rättigheter attributet har kan vi, från kundens sida, inte få.
Descriptor
Låt oss återkomma till vår tabell. Efter att ha deklarerat egenskapsvärdet kan följande attributdeklarationer göras:
1. Ny egenskapsdeklaration (det kan finnas många egenskaper i tjänsten)
2. Ny tjänstdeklaration (det kan finnas många i tabellen)
3. Deklaration av descriptor
När det gäller egenskapen för att mäta hjärtfrekvens, så åtföljs värdet av egenskapen i vår tabell av en deskriptor. En deskriptor är en attribut med ytterligare information om egenskapen. Det finns flera typer av deskriptorer. Vi kommer att diskutera dessa mer ingående i den andra delen av denna artikel. Just nu fokuserar vi endast på deskriptoren för klientens egenskapskonfiguration (Client Characteristic Configuration Descriptor - CCCD). Den har ett UUID som är 0x2902. Med hjälp av denna deskriptor kan klienten aktivera indikation eller notifiering på servern. Skillnaden mellan dem är liten, men ändå finns den. En notifiering kräver ingen bekräftelse från klientens sida. En indikation kräver dock det, även om det sker på GATT-nivå, utan att nå applikationsnivån. Varför är det så, kanske ni undrar? Tyvärr är det något jag inte känner till. Jag kan bara säga att experter från Nordic rekommenderar att använda notifiering. Särskilt eftersom paketintegritetskontrollen (genom CRC) sker i båda fallen.
Slutsats
I slutet av artikeln skulle jag vilja säga något mer. Den sista tabellen är något förvirrande. Men jag valde att ta upp den eftersom den presenteras i , som jag stödjer mig på. I den andra delen av min artikel planerar jag att gå djupare in i specifikationen för Bluetooth 4.0. Där väntar mer korrekt grafik och diagram. I den tredje delen skulle jag vilja gå igenom en logg som erhållits med Wireshark från en av enheterna och se "i verkligheten" all den teori som vi studerar.
Anställd vid koncernen
Vladimir Pechersky
Källa: habr.com
