

Hösten 2019 inträffade en efterlängtad händelse i iOS-teamet för Mail.ru Cloud. Den primära databasen för beständig lagring av appens tillstånd blev ganska exotisk för mobilvärlden. (LMDB). Nedan presenteras en detaljerad översikt i fyra delar. Först kommer vi att diskutera orsakerna till detta otraditionella och svåra val. Sedan går vi vidare till de tre pelarna i LMDB:s arkitektur: minnesmappade filer, B+-träd och copy-on-write-metoden för att implementera transaktionshantering och multiversionering. Slutligen, som en extra bonus – den praktiska delen. Här kommer vi att titta på hur man kan designa och implementera ett databas-schema med flera tabeller ovanpå ett lågnivå key-value API, inklusive en indexering.
Innehåll
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Motivation för implementering
En gång runt 2015 blev vi oroade över att mäta hur ofta gränssnittet i vår applikation laggar. Vi sysslade inte med detta utan anledning. Vi fick fler klagomål om att applikationen ibland slutade reagera på användarens handlingar: knappar svarade inte, listor rullades inte osv. Om mekaniken bakom mätningarna vet jag. på AvitoTech, så jag ger här endast en översikt av siffrorna.
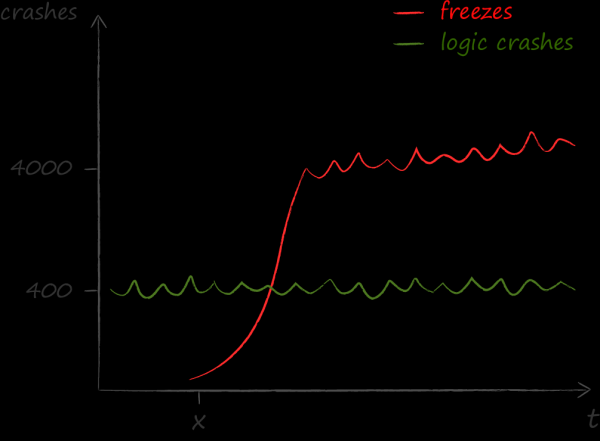
Mätresultaten blev en kall dusch för oss. Det visade sig att problemen som orsakades av låsningar var mycket fler än andra problem. Innan vi insåg detta var den viktigaste tekniska kvalitetsindikatorn kraschfrihet, men efteråt flyttades fokus. Genom att bygga
en dashboard med låsningar en kvantitativ och två trådar en artikel på Habra . В рамках же текущего повествования хочу подчеркнуть те аспекты решения, которые повлияли на выбор базы данных.
Aktörmodellen för systemorganisation innebär att flerkapacitet blir dess andra väsen. Modellens objekt gillar att korsa trösklar mellan trådar. Och de gör detta inte bara ibland och någonstans, utan praktiskt taget ständigt och överallt.
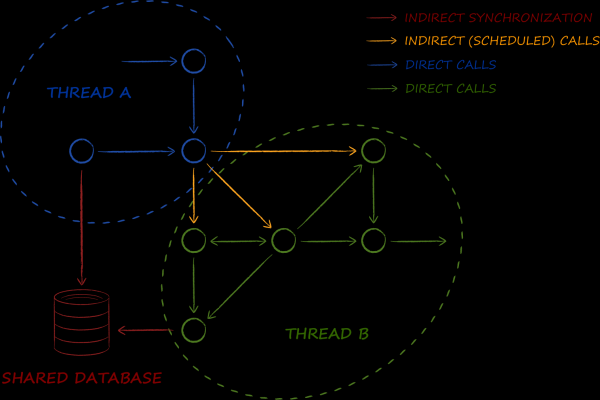
Databasen är en av de grundläggande komponenterna i den presenterade skissen. Dess huvudsakliga uppgift är att genomföra makromönstret. . Om den i företagsvärlden används för att organisera datasynergi mellan tjänster, så handlar det i en aktörsarkitektur om data mellan trådar. Därför behövde vi en sådan databas vars användning i en flerkapacitetmiljö inte orsakar ens minimala svårigheter. Detta innebär i synnerhet att de objekt som erhålls från den minst ska vara trådsäkra, och idealiskt sett helt oföränderliga. Som bekant kan de senaste användas samtidigt från flera trådar utan att behöva använda några lås, vilket gynnar prestandan.
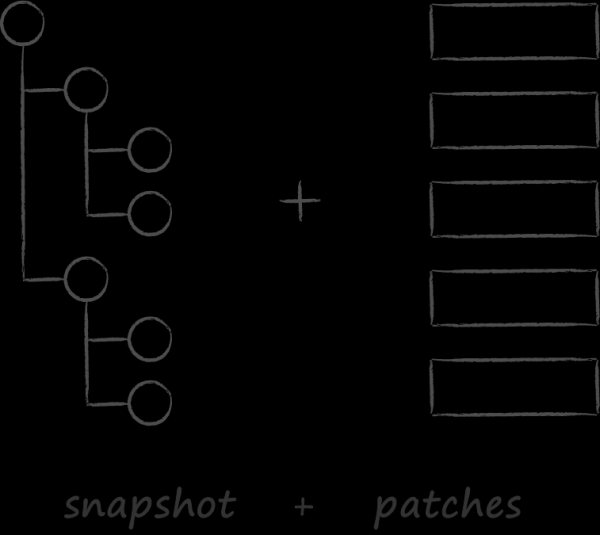 Den andra viktiga faktorn som påverkade valet av databas var vårt moln-API. Det inspirerades av synkroniseringsmetoden som antagits i git. Precis som det siktade vi på , vilket ser mer än rimligt ut för molnkunder. Det förutsattes att de bara skulle ladda ner det kompletta tillståndet av molnet en gång, och att synkroniseringen i de flesta fall skulle ske genom att applicera förändringar. Tyvärr är denna möjlighet fortfarande endast teoretisk, och i praktiken har kunderna inte lärt sig att arbeta med patchar. Det finns en rad objektiva orsaker till detta, som för att inte förlänga inledningen låter vi vara osagda. Just nu är det mycket mer intressant att se de lärande resultaten av lektionen om vad som händer när API:et sa "A", men dess konsument inte sa "B".
Så om du föreställer dig git som vid körning av kommandot pull, istället för att applicera patchar på det lokala snapshots, jämför dess fullständiga tillstånd med serverns fullständiga tillstånd, så får du en ganska klar bild av hur synkronisering sker i molnklienter. Det är inte svårt att gissa att för att genomföra detta måste man allokera två DOM-träd i minnet med meta-information om alla server- och lokala filer. Om en användare lagrar 500 000 filer i molnet, krävs det att återskapa och förstöra två träd med 1 miljon noder för hans synkronisering. Varje nod är en aggregat som innehåller en graf av underobjekt. I detta ljus blev resultaten av profileringen väntade. Det visade sig att även utan att beakta algoritmerna för sammanslagning är själva proceduren för att skapa och sedan förstöra ett stort antal små objekt kostsam. Situationen förvärras av det faktum att den grundläggande synkroniseringsoperationen ingår i ett stort antal användarscenarier. Som en följd av detta fastställer vi det andra viktiga kriteriet vid valet av databas - möjligheten att utföra CRUD-operationer utan dynamisk allokering av objekt.
Andra krav är mer traditionella och deras lista ser helt ut som följande.
- Trådsäkerhet.
- Multiprocessor. Detta motiveras av önskan att använda samma databasinstans för att synkronisera tillståndet inte bara mellan trådar utan även mellan huvudapplikationen och iOS-tillägg.
- Möjlighet att representera lagrade entiteter som immutabla objekt.
- Frånvaro av dynamiska allokeringar inom ramen för CRUD-operationer.
- Stöd för transaktioner med grundläggande egenskaper : atomiskhet, konsekvens, isolering och tillförlitlighet.
- Hastighet i de mest populära fallen.
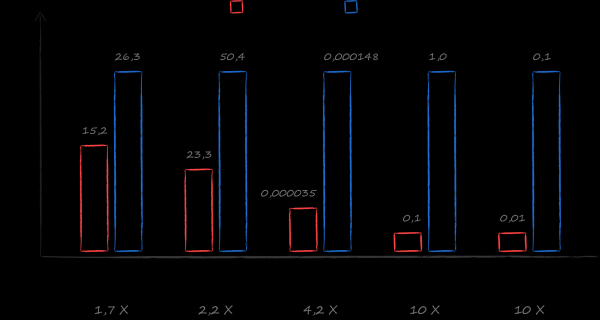
Ett bra val med denna uppsättning krav har varit och förblir SQLite. Men i samband med att studera alternativ snubblade jag över en bok . Under her guidance, a benchmark was written comparing the performance of different databases in real cloud scenarios. The result exceeded even the most ambitious expectations. In the most popular cases — obtaining a cursor for a sorted list of all files and a sorted list of all files for a given directory — LMDB proved to be 10 times faster than SQLite. The choice became obvious.
2. Positioning of LMDB
LMDB is a very small library (only 10K lines) that implements the most fundamental layer of databases — storage.
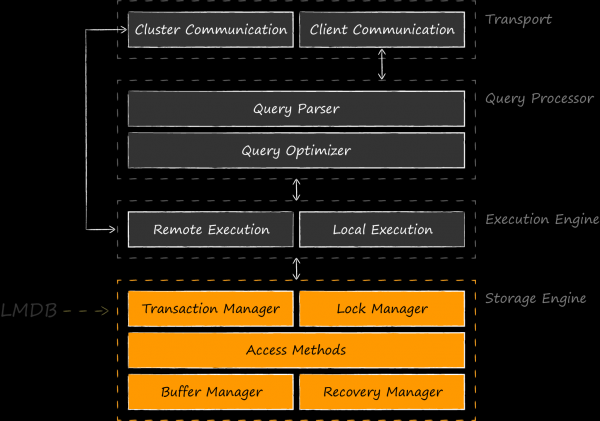
The diagram shown demonstrates that comparing LMDB with SQLite, which also implements higher levels, is not really correct, much like comparing SQLite with Core Data. It would be more fair to mention similar storage engines as equal competitors — BerkeleyDB, LevelDB, Sophia, RocksDB, etc. There are even projects where LMDB acts as a component of the storage engine for SQLite. The first such experiment was conducted in 2012 by the Howard Chu . LumoSQL presented it at LinuxConfAu. , who were strongly dissatisfied with BerkeleyDB as the foundation of their project. Building on a modest library
btree , Howard Chu was able to create one of the most popular alternatives today. He dedicated a very great presentation to this history and the internal structure of LMDB . A good example of conquering storage was shared by Leonid Yurev (aka ) from Positive Technologies in his talk at Highload 2015 . In it, he discusses LMDB in the context of a similar task of implementing ReOpenLDAP, while LevelDB underwent comparative criticism. As a result of this implementation, Positive Technologies even spawned a rapidly developing fork with very attractive features, optimizations, and LMDB is often used as a storage as is. For example, the Mozilla Firefox browser .
it for a number of needs, and starting from version 9, Xcode it over SQLite for index storage. его SQLite для хранения индексов.
Motorn har gjort sig bemärkt inom mobilutveckling. Spår av dess användning kan hittas i iOS-klienten för Telegram. LinkedIn har tagit det ett steg längre och valt LMDB som standardlagring för sitt egenutvecklade cache-ramverk, Rocket Data, om vilket det rapporterades i en artikel 2016.
LMDB slåss framgångsrikt om en plats i solen i det utrymme som lämnades av BerkeleyDB efter att det hamnade under Oracles kontroll. Biblioteket älskas för sin hastighet och tillförlitlighet även jämfört med liknande alternativ. Som bekant finns det inga gratis luncher, och det är värt att betona det trade-off som man kommer att stöta på vid valet mellan LMDB och SQLite. Schemat ovan visar tydligt hur den ökade hastigheten uppnås. För det första betalar vi inte för extra abstraktionslager ovanför den diskbaserade lagringen. Klart är att en bra arkitektur alltid kräver dem, och de kommer oundvikligen att dyka upp i applikationens kod, men de kommer att vara mycket mer smidiga. De kommer inte att ha funktioner som inte efterfrågas av just den specifika applikationen, exempelvis stöd för SQL-frågor. För det andra blir det möjligt att optimalt genomföra mappning av applikationsoperationer till disklagringsfrågor. Om SQLite 3. Tre pelare av LMDB
Nu när vi har sett på LMDB från fågelperspektiv är det dags att gå djupare. De följande tre avsnitten kommer att handla om de grundläggande pelarna som arkitekturen för lagringen vilar på:
Minneskartlagrade filer som mekanism för diskåtkomst och synkronisering av interna datask strukturer.
- B+-träd som struktur för de lagrade data.
- Copy-on-write som metod för att säkerställa ACID-egenskaper vid transaktioner och multiversionering.
- 3.1. Pelare nummer 1. Minneskartlagrade filer
3.1. Pelare nummer 1. Minneskartlagrade filer
De visade minnesfilerna är en så viktig arkitektonisk komponent att de till och med nämns i namnet på lagringssystemet. Frågor kring caching och synkronisering av åtkomst till den lagrade informationen överlämnas helt och hållet till operativsystemet. LMDB innehåller inga cachar. Detta är ett medvetet beslut från författarens sida, eftersom att läsa data direkt från de visade filerna möjliggör att många hörn kan skäras i implementeringen av motorn. Nedan ger jag en långt ifrån fullständig lista över några av dessa.
- Att upprätthålla datakonsistens i lagringssystemet när flera processer arbetar med det blir operativsystemets ansvar. I nästa avsnitt kommer denna mekanik att diskuteras i detalj med bilder.
- Avsaknaden av cachar befriar LMDB från overheadkostnader relaterade till dynamisk allokering. Att läsa data är i praktiken en enkel installation av en pekare till rätt adress i det virtuella minnet och inte mer. Det låter som science fiction, men i källkoden för lagringssystemet är alla anrop till salloc koncentrerade till en funktion för lagringskonfiguration.
- Avsaknaden av cachar innebär även att det inte finns några lås relaterade till synkronisering av deras åtkomst. Läsare, av vilka det kan finnas godtyckligt många samtidigt, stöter inte på en enda mutex på sin väg till data. Detta resulterar i att läshastigheten har idealisk linjär skalbarhet med avseende på antalet CPU:er. I LMDB genomgår endast modifierande operationer synkronisering. Det kan bara finnas en skribent vid varje given tidpunkt.
- Minst mängd caching- och synkroniseringslogik befriar koden från extremt komplexa typer av fel relaterade till arbete i en flertrådad miljö. Vid Usenix OSDI 2014 presenterades två intressanta studier av databaser: och . Dessa kan ge information om såväl den exceptionella tillförlitligheten hos LMDB som den nästan felfria implementeringen av ACID-egenskaper för transaktioner, som överträffar den i SQLite.
- Minimalismen i LMDB gör det möjligt för maskinens representation av dess kod att helt rymmas i CPU:ns L1-cache med de därav följande prestandakarakteristikena.
Tyvärr är det inte så enkelt med minnessatta filer i iOS som man skulle önska. För att kunna diskutera de relaterade nackdelarna mer medvetet behöver vi återkalla de allmänna principerna för hur denna mekanism implementeras i operativsystem.
Allmän information om minnessatta filer
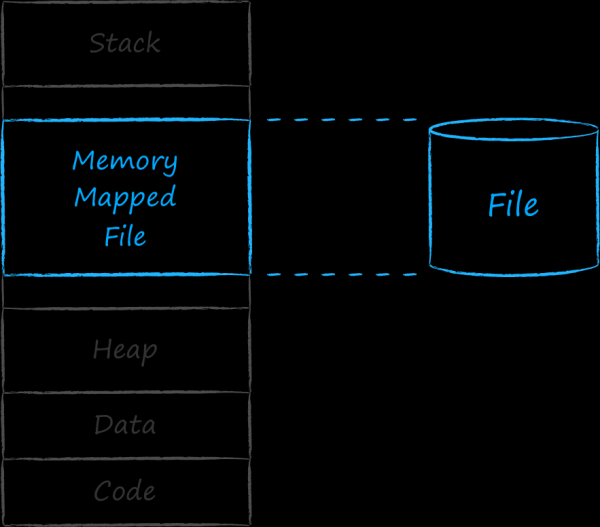 Varje körbart program associerar operativsystemet med en enhet som kallas process. Varje process får ett sammanhängande adressintervall, där den placerar allt den behöver för sitt arbete. I de lägsta adresserna finns sektioner med kod och hårdkodade data och resurser. Därefter följer ett växande block av dynamiskt adressutrymme, som vi känner till som heap. Här finns adresser till enheter som dyker upp under programmets körning. Högst upp finns minnesområdet som används av applikationens stack. Den växer och krymper, med andra ord har dess storlek också en dynamisk natur. För att stacken och heapen inte ska krocka och störa varandra har de separerats åt olika håll i adressutrymmet. Mellan de två dynamiska sektionerna uppe och nere finns ett gap. Adresser i detta mellanrum används av operativsystemet för att associera olika enheter med processen. I synnerhet kan det sätta en viss sammanhängande uppsättning adresser - en fil på disken. En sådan fil kallas en minnessatt fil.
Det tilldelade adressutrymmet för processen är enormt. Teoretiskt är antalet adresser begränsat endast av storleken på pekaren, som bestäms av systemets bitgenomgång. Om det skulle motsvara den fysiska minnet en-till-en skulle den första processen förbruka all RAM, och någon form av multitasking skulle inte kunna ske.
Men av vår erfarenhet vet vi att moderna operativsystem kan köra hur många processer som helst samtidigt. Detta är möjligt eftersom de endast på pappret tilldelar processerna en stor mängd minne, medan de i verkligheten endast laddar den del av minnet som efterfrågas här och nu in i den fysiska minnet. Därför kallas minnet som är associerat med processen virtuellt.
Operativsystemet organiserar virtuell och fysisk minne i form av sidor av en viss storlek. När en viss sida av virtuell minne har efterfrågats, laddar operativsystemet den i det fysiska minnet och upprättar en koppling mellan dem i en särskild tabell. Om det inte finns några lediga platser kopieras en tidigare laddad sida till disken, och den efterfrågade tar dess plats. Denna procedur, som vi snart kommer tillbaka till, kallas swapping. Bilden nedan illustrerar den beskrivna processen. Där har sida A med adress 0 laddats och placerats i sidan av huvudminnet med adress 4. Detta faktum har återspeglats i kopplingstabellen i cell nummer 0.
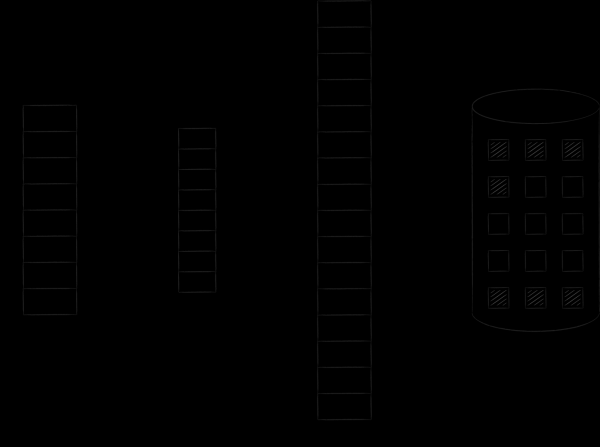
Historien för de visade filerna i minnet är exakt densamma. Logiskt sett placeras de till synes kontinuerligt och helt i det virtuella adresseringsutrymmet. Men i det fysiska minnet kommer de in sida för sida och endast på begäran. Modifiering av sådana sidor synkroniseras med filen på disken. På så sätt kan man utföra filinmatning/utmatning, genom att bara arbeta med byte i minnet – alla förändringar kommer automatiskt att överföras av kärnan till den ursprungliga filen.
Bilden nedan visar hur LMDB synkroniserar sitt tillstånd när den arbetar med en databas från olika processer. Genom att mappa den virtuella minnen av olika processer på samma fil, förbinder vi de facto operativsystemet att transitivt synkronisera vissa block av deras adresseringsutrymmen, som LMDB refererar till.
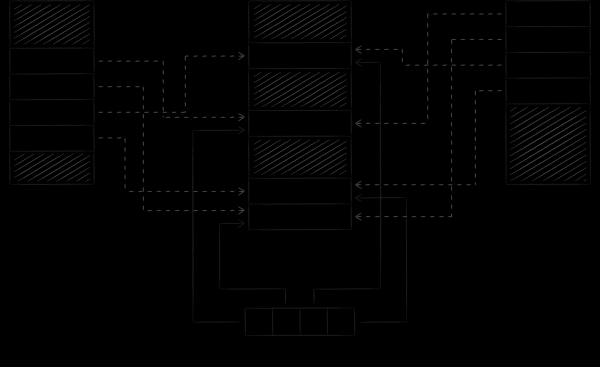
En viktig aspekt är att LMDB som standard modifierar datafilen genom systemanropet write, medan själva filen visas i läsläge (read-only). Denna metod har två viktiga konsekvenser.
Den första konsekvensen är gemensam för alla operativsystem. Dess kärna ligger i att lägga till skydd mot oavsiktlig skada av databasen från felaktig kod. Som bekant har körbara instruktioner i processen frihet att komma åt data från vilket ställe som helst i dess adressutrymme. Samtidigt, som vi just påminde om, innebär visning av en fil i läs- och skrivläge att varje instruktion dessutom kan modifiera den. Om den gör detta av misstag, till exempel genom att försöka skriva över ett arrayelement med ett icke-existerande index, kan den av misstag ändra den fil som är kopplad till den adressen, vilket leder till korruption av databasen. Om filen däremot visas i läsläge kommer försöket att ändra det motsvarande adressutrymmet att orsaka en krasch med en signal. SIGSEGV, och filen förblir intakt.
Den andra konsekvensen är specifik för iOS. Varken författaren eller några andra källor nämner den specifikt, men utan den skulle LMDB vara oanvändbar på detta mobila operativsystem. Denna fråga ägnas nästa avsnitt åt.
Specifikt för minnesavbildade filer i iOS
Under WWDC 2018 hölls en fantastisk presentation . I den beskrivs att i iOS hör alla sidor i det fysiska minnet till en av tre typer: dirty, compressed och clean.
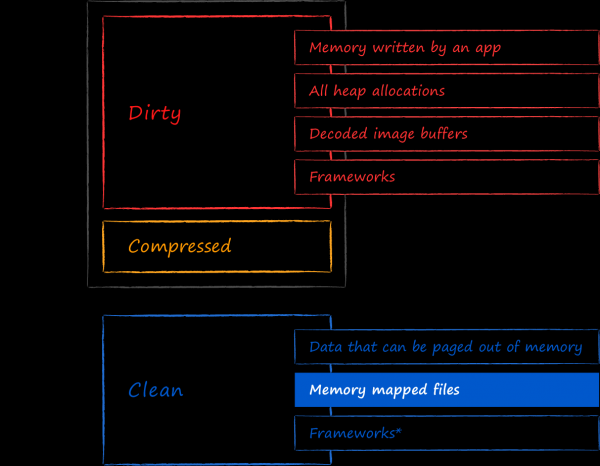
Clean memory — detta är en samling sidor som kan avlastas från det fysiska minnet utan problem. Data som finns där kan laddas om vid behov från dess ursprungliga källor. Read-only memory-mapped filer faller just i denna kategori. iOS har ingen rädsla för att när som helst avlasta avbildade sidor från minnet, eftersom de garanterat är synkroniserade med filen på disken.
Dirty memory inkluderar alla modifierade sidor oavsett var de ursprungligen låg. Särskilt så kommer även memory-mapped filer som ändrats genom skrivning till den associerade virtuella minnet att klassificeras så. Genom att öppna LMDB med flaggan MDB_WRITEMAP, kan man personligen försäkra sig om detta efter att ha gjort ändringar.
När en app börjar ta upp för mycket fysisk minne komprimerar iOS dess smutsiga sidor. Den totala mängden minne som upptas av de smutsiga och komprimerade sidorna kallas appens minnesfotavtryck. När den når en viss tröskel, tar systemdemonen OOM killer över och tvingar den att avslutas. Detta är en skillnad mellan iOS och stationära operativsystem. Till skillnad från dem tillåter iOS inte att minnesfotavtrycket minskas genom att byta sidor från det fysiska minnet till disken. Anledningarna är endast spekulationer. Kanske är själva processen att flytta sidor till och från disken för energikrävande för mobila enheter, eller så sparar iOS resurser i form av att skriva om celler på SSD:er, eller så var systemdesignernas allmänna prestandakrav otillfredsställande med tanke på att allt kontinuerligt byts. Oavsett vad är faktum ett faktum.
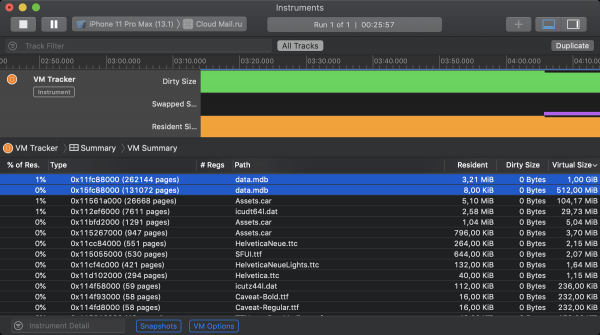
Den goda nyheten, som nämnts tidigare, är att LMDB som standard inte använder mmap-mekanismen för att uppdatera filer. Detta innebär att de visade data klassificeras av iOS som rent minne och bidrar inte till minnesfotavtrycket. Detta kan bekräftas med hjälp av ett Xcode-verktyg som heter VM Tracker. På skärmdumpen nedan visas det virtuella minnet för iOS-appen Obcloud under drift. Vid starten initialiserades två LMDB-instans. Den första fick tillstånd att mappa sin fil till 1GiB virtuellt minne, den andra till 512MiB. Trots att båda lagringarna tar en viss mängd resident minne bidrar ingen av dem till det smutsiga storleken.
Och nu är det dags för de dåliga nyheterna. Tack vare bytte av sidor i 64-bitars stationära operativsystem kan varje process ta upp så mycket virtuell adresseringsutrymme som det finns ledigt utrymme på hårddisken för sin potentiella swap. Ersättningen av swapning med kompression i iOS sänker radikalt det teoretiska maxvärdet. Nu måste alla aktiva processer få plats i det primära (dvs. RAM) minnet, och allt som inte får plats riskerar att avslutas. Detta nämns också i den ovannämnda. .ts Som ett resultat begränsar iOS strikt storleken på minnet som kan tilldelas via mmap. Här är Man kan se på de empiriska gränserna för minnesvolymer som kunnat allokeras på olika enheter med hjälp av detta systemanrop. På de mest moderna iOS-smartphones har det allokerats 2 gigabyte, medan de toppmoderna versionerna av iPad har fått 4. I praktiken måste man självklart hålla sig till de lägsta understödda enhetsmodellerna, där det ser ganska dystert ut. Värre är det att när man tittar på applikationens minnestillstånd i VM Tracker, kan man upptäcka att LMDB inte är den enda som är ute efter minnesmappat minne. Bra delar tas av systemallokatorer, resursfiler, bildbehandlingsramverk och andra mindre rovdjur.
Utifrån experimenten i Molnet har vi kommit fram till följande kompromissvärden för tilldelat LMDB-minne: 384 megabyte för 32-bitars enheter och 768 för 64-bitars enheter. Efter att denna volym har förbrukats börjar alla modifierande operationer att avslutas med koden MDB_MAP_FULL. Sådana fel observerar vi i vår övervakning, men de är tillräckligt få för att vi i detta skede kan bortse från dem.
En icke-uppenbar orsak till överdriven minnesanvändning från lagringen kan vara långlivade transaktioner. För att förstå hur dessa två fenomen hänger ihop, kan vi titta på de två andra pelarna i LMDB.
3.2. Pelare №2. B+-träd
För att emulera tabeller ovanpå ett nyckel-värde-lager krävs att följande operationer finns i dess API:
- Infoga en ny post.
- Söka efter en post med angiven nyckel.
- Ta bort en post.
- Iterera över nyckelintervall i sorterad ordning.
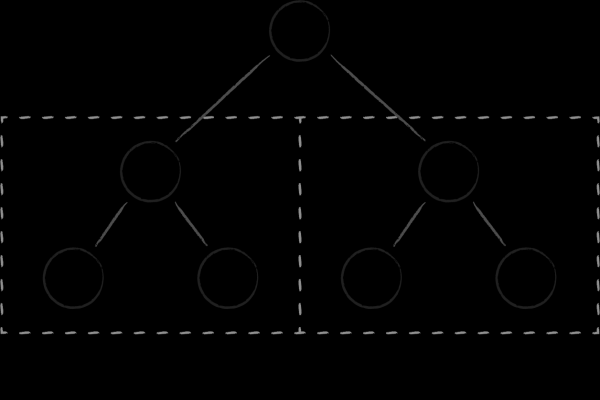 Den enklaste dat strukturen som lätt kan implementera alla fyra operationerna är ett binärt sökträd. Varje nod representerar en nyckel som delar upp alla undergrupper av barnnycklar i två underträd. Till vänster samlas de som är mindre än föräldern, och till höger de som är större. Att få en ordnad uppsättning av nycklar uppnås genom en av de klassiska trädgenomgångarna.
Binärträd har två grundläggande nackdelar som förhindrar dem från att vara effektiva som diskdata-strukturer. För det första är graden av deras balansering oförutsägbar. Det finns en betydande risk att få träd där höjden på olika grenar kan skilja sig avsevärt, vilket försämrar den algoritmiska sökkostnaden jämfört med det förväntade. För det andra gör riklig korsreferens mellan noder att binärträd saknar lokalitet i minnet. Nära noder (med avseende på deras kopplingar) kan befinna sig på helt olika sidor i det virtuella minnet. Som en följd kan det, även för att enkelt gå igenom några angränsande noder i trädet, krävas att man besöker ett jämförbart antal sidor. Detta är ett problem även när vi diskuterar effektiviteten hos binärträd som en in-memory datastruktur, eftersom den ständiga rotationen av sidor i processorns cache är en kostsam affär. När det kommer till frekvent åtkomst av sidor kopplade till noder från disken, blir situationen ännu värre .
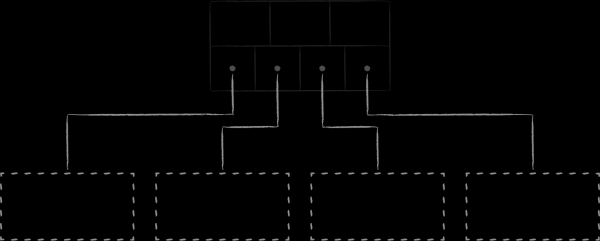 B-träd, som är en evolution av binärträd, löser de problem som nämndes i föregående stycke. För det första är de självbalanserande. För det andra delar varje nod upp antalet underliggande nycklar inte i 2, utan i M ordnade delmängder, där M kan vara ganska stort, ordnar sig i flera hundra eller till och med tusen.
Genom detta:
- Finns det ett stort antal redan ordnade nycklar i varje nod och träden blir mycket låga.
- Trädet får egenskapen av lokalitet i minnet, eftersom nära värdena nycklar naturligtvis placeras nära varandra på en eller angränsande noder.
- Antalet transit-noder minskar när man går ner i trädet under en sökoperation.
- Antalet lästa målnoder minskar vid range-frågor, eftersom varje nod redan innehåller ett stort antal ordnade nycklar.
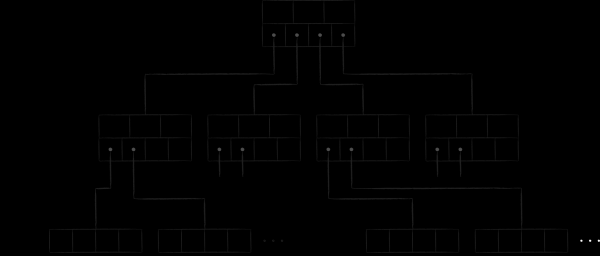
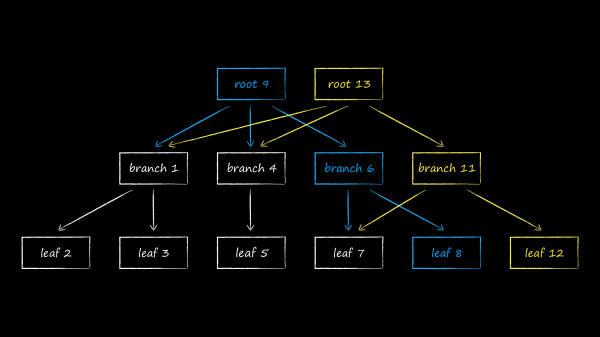
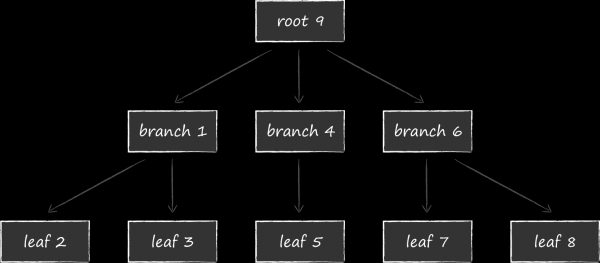
I LMDB används en av variationerna av B-träd som kallas B+-träd för datalagring. På schemat ovan visas tre typer av noder som finns i det.
- I toppen finns roten (root). Den materialiserar inget annat än konceptet av en databas inom lagringsutrymmet. Inom en instans av LMDB kan flera databaser skapas som delar det mappade virtuella adressutrymmet mellan sig. Varje databas börjar med sin egen rot.
- På den lägsta nivån finns bladen (leaf). Det är de som enbart innehåller nyckel-värde-paren som lagras i databasen. Det är just detta som är den särskilda egenskapen hos B+-träd. Om ett vanligt B-träd lagrar värdedelarna i noder på alla nivåer, lagrar B+-varianten dem endast på den lägsta nivån. När vi har fastställt detta faktum, kommer vi härnäst att kalla den undergrupp av trädet som används i LMDB för ett enkelt B-träd.
- Mellan roten och bladen finns 0 eller fler tekniska nivåer med navigationsnoder (branch). Deras uppgift är att dela upp det sorterade mängden nycklar mellan bladen.
Fysiskt är noder block av minne med en fördefinierad längd. Deras storlek är ett multipel av sidstorleken i operativsystemet, som vi nämnde tidigare. Nedan visas en struktur av en nod. I headern finns metadata, där den mest uppenbara för exemplet är en kontrollsumma. Därefter finns information om offsetar för var datacellerna är belägna. Som data kan antingen nycklar representeras, om vi pratar om navigationsnoder, eller hela nyckel-värde-par i fallet med bladen. Mer om strukturen av sidor kan läsas i arbetet .
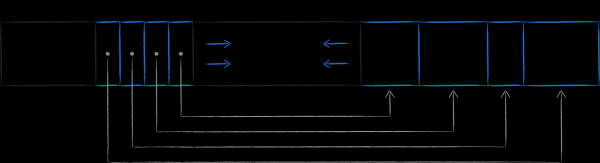
När vi har analyserat det interna innehållet i nodsidorna kommer vi att representera B-trädet av LMDB förenklat på följande sätt.
Sidor med noder är placerade sekventiellt på disken. Sidor med högre nummer är placerade närmare slutet av filen. Den så kallade meta-sidan (meta page) innehåller information om offsetarna, där man kan hitta rötterna till alla träd. När LMDB öppnar filen skannar den sida för sida från slutet till början för att hitta en giltig meta-sida och genom den hitta befintliga databaser.
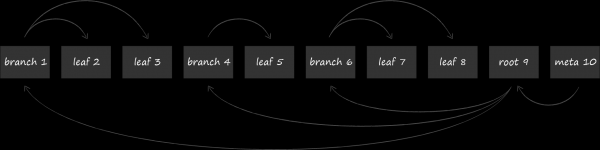
Nu när vi har en förståelse för den logiska och fysiska strukturen av datalagring kan vi gå vidare till att diskutera den tredje pelaren i LMDB. Det är genom den här som alla modifieringar av lagret sker transaktionellt och isolerat från varandra, vilket ger databasen egenskapen av flerversionering.
3.3. Pelare nr 3. Copy-on-write
Vissa operationer med B-träd involverar en serie förändringar i dess noder. Ett exempel är att lägga till en ny nyckel i en nod som redan har nått sin maximala kapacitet. I sådana fall måste noden, för det första, delas i två, och för det andra, en länk till den nya, avknoppade undernoden läggas till i dess förälder. Denna procedur kan potentiellt vara mycket farlig. Om, av någon anledning (krasch, strömavbrott, etc.), endast en del av ändringarna i serien inträffar, förblir trädet i ett inkonsekvent tillstånd.
En av de traditionella lösningarna för att säkerställa databasens motståndskraft mot fel är att lägga till en extra disklagringsstruktur bredvid B-trädet — en transaktionslogg, också känd som write-ahead log (WAL). Det är en fil där den tänkta operationen skrivs innan modifieringen av B-trädet genomförs. Således, om korruption upptäckts under självdiagnosen, konsulterar databasen loggen för att återställa sig själv.
LMDB har valt en annan metod för att säkerställa motståndskraft mot fel, som kallas copy-on-write. Kärnan i denna metod är att istället för att uppdatera data på en befintlig sida, kopieras hela sidan först och alla modifieringar görs sedan i kopian.
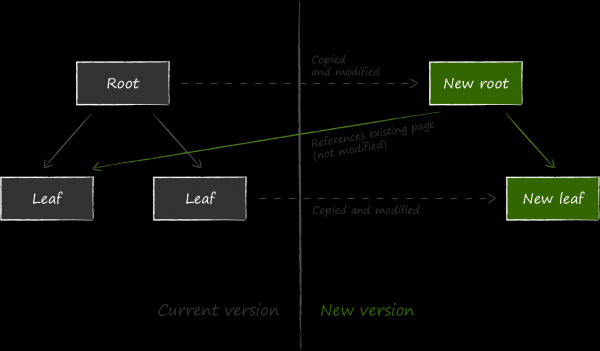
För att de uppdaterade data ska vara tillgängliga måste länken till den aktuella noden ändras i dess föräldranod. Eftersom detta också kräver modifiering, kopieras föräldern också först. Processen fortsätter rekursivt upp till roten. De sista ändringarna sker på metasidan.
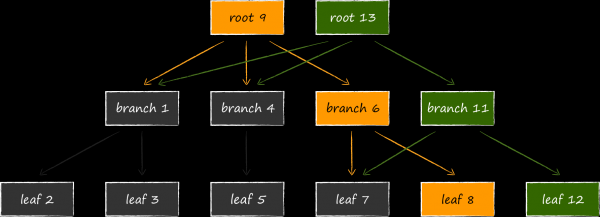
Om det under uppdateringsprocessen skulle inträffa en oväntad avslutning av processen, kommer antingen en ny meta-sida inte att skapas, eller så kommer den inte att sparas på disken förrän den är komplett, och dess kontrollsumma kommer att vara ogiltig. I båda dessa fall kommer de nya sidorna att vara ouppnåeliga, medan de gamla inte kommer att påverkas. Detta befriar LMDB från att behöva föra en skriv-efter-logg för att upprätthålla datakonsistens. Den faktiska datalagringsstrukturen på disken, som beskrivs ovan, tar samtidigt på sig denna funktion. Avsaknaden av en transaktionslogg i tydlig bemärkelse är en av LMDB:s särdrag som säkerställer en hög läshastighet.
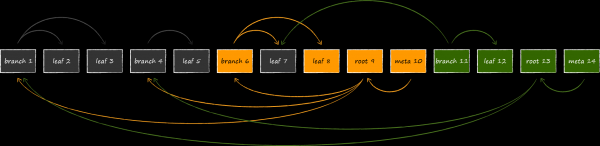
Den resulterande strukturen, kallad append-only B-tree, säkerställer naturligt transaktionsisolering och multi-versionedness. I LMDB är varje öppen transaktion kopplad till den aktuella rot-strukturen av trädet. Så länge transaktionen inte är fullbordad, kommer sidorna i det relaterade trädet aldrig att ändras eller återanvändas för nya versioner av data. Därmed kan man arbeta med exakt det dataset som var aktuellt när transaktionen öppnades, även om lagringsutrymmet samtidigt fortsätter att uppdateras aktivt. Detta är kärnan i multi-versionedness, vilket gör LMDB till en idealisk datakälla för våra älskade. UICollectionViewGenom att öppna en transaktion behöver man inte öka appens minnesanvändning hastigt genom att snabbt hämta aktuella data till någon in-memory-struktur, av rädsla för att bli lämnad utan något. Denna funktion skiljer LMDB från SQLite, som inte kan stoltsera med en sådan total isolering. Om man i det senare öppnar två transaktioner och tar bort en post inom en av dem, kommer samma post inte att kunna nås inom den andra kvarvarande.
Nackdelen är den potentiellt mycket större konsumtionen av virtuell minne. På bilden visas hur databasstrukturen kommer att se ut om den modifieras samtidigt med 3 öppna läs-transaktioner som tittar på olika versioner av databasen. Eftersom LMDB inte kan återanvända noder som nås från rötterna kopplade till aktuella transaktioner, finns det inget annat alternativ för lagringen än att lägga till en fjärde rot i minnet och återigen klona de föränderliga sidorna.
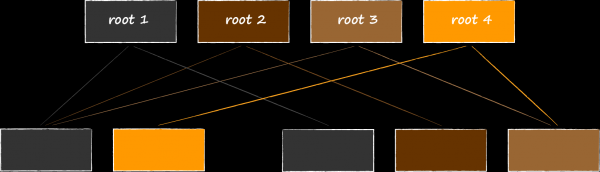
Det kan vara bra att påminna sig om avsnittet om minnesmappade filer. Den extra konsumtionen av virtuell minne borde egentligen inte bekymra oss mycket, eftersom den inte bidrar till applikationens minnesfotavtryck. Samtidigt har det noterats att iOS är mycket snål med tilldelning av detta, och vi kan inte, som på en server eller dator, utan vidare tillhandahålla LMDB med ett område på 1 terabyte och helt ignorera denna egenskap. Så långt som möjligt bör vi sträva efter att göra transaktionernas livslängd så kort som möjligt.
4. Utformning av databasstruktur ovanpå key-value API
Vi börjar analysen av API:t med att granska de grundläggande abstraktionerna som tillhandahålls av LMDB: miljön och databaser, nycklar och värden, transaktioner och markörer.
Kommentarer till kodlistningar
Alla funktioner i LMDB:s offentliga API returnerar resultatet av sitt arbete i form av en felkod, men i alla följande listningar har kontrollen över detta utelämnats för att öka kortfattadheten. I praktiken har vi helt och hållet använt vår C++-wrapper , där fel materialiseras i form av C++-undantag.
Som det snabbaste sättet att ansluta LMDB till ett projekt för iOS eller macOS föreslår jag min CocoaPod .
4.1. Grundläggande abstraktioner
Miljö (environment)
Struktur MDB_env är behållaren för LMDB:s interna tillstånd. Funktionen med prefix mdb_env möjliggör konfiguration av vissa av dess egenskaper. I det enklaste fallet kan initialisering av motorn se ut så här.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512)
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);I Mail.ru:s Cloud-applikation ändrade vi standardvärdena för endast två parametrar.
Den första av dem är storleken på det virtuella adressutrymmet som filsystemet tilldelas. Tyvärr kan det specifika värdet, även på samma enhet, variera kraftigt från gång till gång. För att ta hänsyn till denna egenskap hos iOS väljs den maximala lagringskapaciteten dynamiskt. Börjar från ett visst värde halveras det successivt tills funktionen mdb_env_open inte returnerar ett resultat som är olika från ENOMEM. I teorin finns det en motsatt väg — att först tilldela motorn en minimal mängd minne och sedan, vid mottagna fel, öka det. Men det är mycket mer komplicerat. Orsaken är att proceduren för minnes omallokering (remap) med hjälp av funktionen MDB_MAP_FULLmdb_env_set_map_size ogiltigförklarar alla entiteter (pekare, transaktioner, nycklar och värden) som tidigare fåtts från motorn. Att ta hänsyn till denna vändning i koden skulle leda till betydande komplexitet. Om det virtuella minnet dock är mycket viktigt för dig, kan det vara en anledning att titta på en fork som kommit långt fram, där en av de utlovade funktionerna är "automatisk justering av databasens storlek i realtid". Den andra parametern, vars standardvärde inte passade oss, reglerar mekaniken för trådsäkerhet. Tyvärr finns det minst ett problem med tråd lokal lagring i iOS 10. På grund av detta öppnas lagringen i det ovanstående exemplet med flaggan
MDB_NOTLS . Dessutom behövdes också enfork , för att ta bort variabler med denna attribut i den. Databasen är en separat instans av ett B-träd, som vi diskuterade tidigare. Dess öppnande sker inom en transaktion, vilket först kan verka lite konstigt.
Databaser
MDB_txn *txn; MDB_dbi dbi; mdb_txn_begin(env, NULL, MDB_RDONLY, &txn); mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi); mdb_txn_abort(txn);
I själva verket är en transaktion i LMDB en lagringselement, och inte en specifik databas. Denna konceptualisering möjliggör atomära operationer på entiteter som finns i olika databaser. I teorin öppnar detta möjligheten att modellera tabeller som olika databaser, men jag valde en annan väg som beskrivs i detalj nedan.Nycklar och värden
MDB_val
Struktur MDB_val modellera konceptet av både nyckel och värde. Lagringen har ingen som helst förståelse för deras semantik. För den är det bara en array av byte med en viss storlek. Maximal storlek för nyckeln är 512 byte.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;Med hjälp av en komparator ordnar lagringen nycklarna i stigande ordning. Om man inte ersätter den med en egen kommer den som används vara standardkomparatorn, som sorterar dem byte-för-byte i leksikografisk ordning.
Transaktioner
Transaktionssystemet beskrivs ingående i , så här kommer jag kort att återge deras huvudegenskaper:
- Stöd för alla grundläggande egenskaper : atomicitet, konsistens, isolering och tillförlitlighet. Jag kan inte låta bli att nämna att det finns en bugg gällande hållbarhet på macOS och iOS som har åtgärdats i MDBX. Mer information kan läsas i deras .
- Tillvägagångssättet för flervalsverksamhet beskrivs med schemat "en skribent / flera läsare". Skribenter blockerar varandra, men blockerar inte läsarna. Läsarna blockerar varken skribenter eller varandra.
- Stöd för inbäddade transaktioner.
- Stöd för flerversionersystem.
Flerversionersystemet i LMDB är så bra att jag vill visa det i aktion. Från koden nedan kan vi se att varje transaktion arbetar med den version av databasen som var aktuell vid tidpunkten för dess öppnande, helt isolerad från alla efterföljande förändringar. Initieringen av lagringen och tilläggandet av en testpost erbjuder inget intressant, så dessa ritualer har lämnats under en spoiler.
Tillägg av testpost
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ".\/testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Öppnar 2 transaktioner, var och en av dem tittar
// på databasens version med en post.
mdb_txn_begin(env, NULL, 0, &txn1); // läs- och skrivläge
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // endast läsning
// Inom ramen för den första transaktionen tar vi bort en existerande post från databasen.
mdb_del(txn1, dbi, &key, NULL);
// Bekräftar borttagningen.
mdb_txn_commit(txn1);
// Öppnar den tredje transaktionen som tittar på
// den aktuella versionen av databasen, där posten inte längre finns.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Vi bekräftar att posten med den efterfrågade nyckeln inte längre existerar.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Avslutar transaktionen.
mdb_txn_abort(txn3);
// Vi ser till att vi fortfarande kan hitta posten med nyckeln inom den andra transaktionen, som öppnades medan
// posten fanns i databasen.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Kontrollerar att vi får giltiga data och inte bara skräp.
assert(*(int *)val.mv_data == 997);
// Avslutar transaktionen som även om den arbetar med en föråldrad, är en konsekvent databas.
mdb_txn_abort(txn2);Jag rekommenderar att du också försöker utföra samma trick med SQLite och se vad som händer.
Multiversionering tillför mycket trevliga fördelar för iOS-utvecklare. Med hjälp av denna egenskap kan man enkelt och utan besvär reglera hastigheten för uppdatering av datakällan för skärmkontroller, med hänsyn till användarupplevelsen. Låt oss ta en funktion i appen Mail.ru Cloud som exempel, nämligen automatisk nedladdning av innehåll från det systemmedialivet. Med en bra anslutning kan klienten lägga till flera bilder på servern varje sekund. Om vi efter varje uppladdning uppdaterar UICollectionView med mediekontot i användarens moln, kan vi glömma bort 60 fps och smidig rullning under denna process. För att förhindra frekventa skärmutdragningar måste vi på något sätt begränsa hastigheten för databasens ändringar i grunden. UICollectionViewDataSource.
Om databasen inte stödjer fler versioner och endast tillåter arbete med den aktuella versionen, måste en stabil tidsbild av data skapas genom att kopiera den antingen till en in-memory datastuktur eller till en temporär tabell. Båda dessa metoder är mycket kostsamma. I fallet med en in-memory lagring får vi kostnader både för minnet, som orsakas av lagring av konstruerade objekt, och för tiden, kopplad till överflödiga ORM-konverteringar. När det gäller temporära tabeller är det ännu dyrare, vilket endast har mening i icke-triviala fall.
Fler versioner av LMDB löser problemet med att upprätthålla en stabil datakälla på ett mycket elegant sätt. Det räcker med att öppna en transaktion och voilà – så länge vi inte avslutar den, är vår dataset garanterat fixerat. Logiken för hastigheten av dess uppdatering ligger nu helt och hållet i händerna på presentationsskiktet, utan betydande resurskostnader.
Kursorer
Kursorer tillhandahåller en mekanism för ordnad iterering över nyckel-värde-par genom att traversera ett B-träd. Utan dem skulle det vara omöjligt att effektivt modellera tabeller i databasen, som vi nu går vidare till.
4.2. Modellering av tabeller
Egenskapen av ordning i nycklarna möjliggör att strukturera över grundläggande abstraktioner en högre nivå som en tabell. Vi ska överväga denna process med exemplet av huvudtabellen för en molnkund, där information om alla användarens filer och mappar är cachad.
Tabellschema
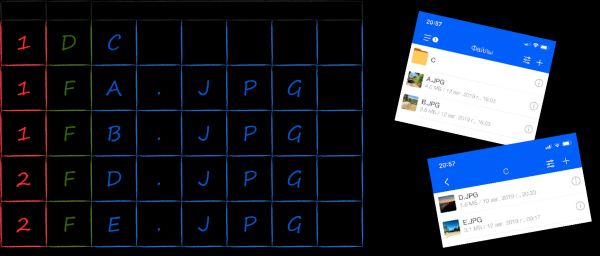
Ett av de vanliga scenarierna som tabellstrukturen med mappträd måste anpassas för är att hämta alla element inom en given katalog. En bra datamodell för effektiva frågor av denna typ är . För att implementera den ovanpå ett key-value lagringssystem måste nycklarna för filer och mappar sorteras så att de grupperas baserat på tillhörighet till förälder-katalogen. Dessutom, för att visa innehållet i katalogen i en bekant Windows-stil (först mappar, sedan filer, och båda sorterade alfabetiskt), är det nödvändigt att inkludera motsvarande ytterligare fält i nyckeln.
På bilden nedan visas hur representationen av nycklar i form av en byte-array kan se ut, baserat på den uppsatta uppgiften. Först placeras bytes med identifikatorn för den överordnade katalogen (röda), sedan med typen (gröna) och till sist med namnet (blåa). När de sorteras av LMDB:s standardkomparator i lexikografisk ordning, organiseras de på det önskade sättet. Sekventiell genomgång av nycklar med samma röda prefix ger oss de relaterade värdena i den ordning de ska presenteras i användargränssnittet (till höger), utan att kräva någon ytterligare efterbehandling.
Serialisering av nycklar och värden
Det finns många metoder för att serialisera objekt. Eftersom vi inte hade något annat krav än hastighet valde vi den snabbaste metoden — dumpning av minnet som används av instansen av C-språkets struktur. Således kan nyckeln till en katalogelement modelleras med följande struktur NodeKey.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;För att spara NodeKey i lagret måste i objektet MDB_val pekar pekaren på data adressen för början av strukturen, och dess storlek beräknas med funktionen sizeof.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = sizeof(NodeKey),
        .mv_data = (void *)key
    };
}
I det första kapitlet om kriterier för val av databas nämnde jag att minimalisering av dynamisk allokering är en viktig faktor. Funktionen serialize visar hur man i fallet med LMDB kan undvika dem helt vid insättning av nya poster i databasen. Den inkommande byte-arrayen från servern transformeras först till stackstrukturer, och sedan dumpas de trivialt i lagret. Med tanke på att det heller inte finns några dynamiska allokeringar inom LMDB, kan man uppnå en fantastisk situation i termer av iOS — att arbeta med data på hela deras väg från nätverket till disken med enbart stackminne!
Sortering av nycklar med en binär komparator
Relation of the key order is set by a special function called a comparator. Since the engine knows nothing about the semantics of the bytes contained within them, the default comparator has no choice but to sort the keys in lexicographical order, resorting to byte-by-byte comparison. Using it for sorting structures is akin to shaving with a cleaver. Nevertheless, in simple cases, I find this method acceptable. The alternative is described a bit further below, and here I will note a couple of bumps along this path.
The first thing to remember is the representation of primitive data types in memory. For example, on all Apple devices, integer variables are stored in the format . This means that the least significant byte will be on the left, and sorting whole numbers by using byte-by-byte comparison will not work. For instance, attempting to do this with a set of numbers from 0 to 511 will yield the following result.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
To solve this problem, whole numbers must be stored in the key in a format suitable for byte-by-byte comparators. The necessary transformation can be accomplished with functions from the hton* family (in particular, htons for the two-byte numbers in the example).
The representation format of strings in programming is, as is known, entirely . If the semantics of the strings and the encoding used for their representation in memory suggest that more than one byte can correspond to a character, then it is better to abandon the idea of using the default comparator right away.
The second thing to keep in mind is the of the compiler for structure fields. Due to this, there may be bytes with garbage values in memory between fields, which, of course, breaks byte-wise sorting. To eliminate the garbage, you either need to declare the fields in a strictly defined order, keeping the alignment rules in mind, or use the attribute packed.
Sorting keys with an external comparator
The logic of comparing keys may prove too complex for a binary comparator. One of many reasons is the presence of technical fields within the structures. I will illustrate their occurrence using the already familiar key for a directory element.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Trots sin enkelhet konsumerar den i de flesta fall för mycket minne. Buffertnamnet tar upp 256 byte, även om genomsnittligt fil- och mappnamn sällan överstiger 20-30 tecken.
Ett av de standardverktyg för att optimera storleken på en post består av att "beskurna" den till den faktiska storleken. Grundidén är att innehållet i alla fält av variabel längd lagras i bufferten i slutet av strukturen, medan deras längder lagras i separata variabler. I enlighet med detta tillvägagångssätt transformeras nyckeln NodeKey på följande sätt.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Vid serialisering anges inte storleken på hela strukturen, utan storleken på alla fält med fast längd plus storleken av den faktiskt använda delen av bufferten. sizeof MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength, .mv_data = (void *)key }; }
Som ett resultat av den utförda refaktoriseringen fick vi en betydande minskning av det minnesutrymme som upptas av nycklar. Men på grund av det tekniska fältetnameLength , är den standard binära komparatorn inte längre lämplig för jämförelse av nycklar. Om vi inte byter ut den mot vår egen, kommer namnlängden att bli en mer prioriterad faktor vid sortering än själva namnet.LMDB tillåter att varje databas får sin egen nyckeljämförelsefunktion. Detta görs med hjälp av funktionen
mdb_set_compare strängt före databasen öppnas. Av uppenbara skäl kan den inte ändras under databasens livstid. Som indata får komparatorn två nycklar i binärt format och returnerar på utdata resultatet av jämförelsen: mindre (-1), större (1) eller lika (0). Pseudokoden för ser ut så här. NodeKey int compare(MDB_val * const a, MDB_val * const b) { NodeKey * const aKey = (NodeKey * const)a->mv_data; NodeKey * const bKey = (NodeKey * const)b->mv_data; return // ... }
Så länge som alla nycklar i databasen har samma typ är det fullt legitimt att obetingat konvertera deras byte-representation till typ av den tillämpade nyckelstrukturen. Det finns en nyans här, men den kommer att behandlas lite senare i avsnittet "Läsa poster".Serialisering av värden
Сериализация значений
Med nycklarna till LMDB:s lagrade poster arbetar man extremt intensivt. Jämförelsen mellan dem sker i samband med varje applikationsoperation, och hastigheten hos komparatorn avgör prestandan för hela lösningen. I en perfekt värld skulle den standard binära komparatorn vara tillräcklig för att jämföra nycklar, men om man måste använda sin egen, bör deserialiseringsprocessen av nycklar vara så snabb som möjligt.
Värdedelen av posten (värdet) intresserar databasen i stort sett inte. Omvandlingen från byterepresentation till objekt sker endast när det redan krävs av applikationskoden, till exempel för att visas på skärmen. Eftersom detta sker relativt sällan, är kraven på hastigheten för denna procedur inte lika kritiska, och i dess implementation har vi mycket större frihet att fokusera på användarvänlighet. Till exempel, för serialisering av metadata om ännu icke-inlästa filer använder vi NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Det finns dock fall när prestandan fortfarande har betydelse. Till exempel, när man sparar metainformation om filstrukturen i användarens moln använder vi fortfarande samma dump av objektens minne. Det unika med uppgiften att skapa deras serialiserade representation är det faktum att delarna av en katalog modelleras med en hierarki av klasser.
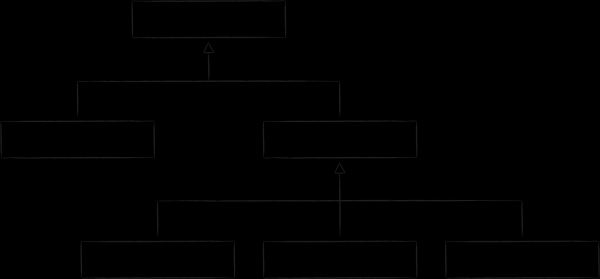
För att implementera detta på C-språket flyttas specifika fält från arvklasser till separata strukturer, och deras koppling till basen fastställs genom fältet av typen union. Det aktuella innehållet i unionen anges genom en teknisk attributtyp.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Lägg till och uppdatera poster
De serialiserade nycklarna och värdena kan läggas till lagringen. För detta används funktionen mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);Under the configuration stage, the storage can allow or deny storing multiple records with the same key. If key duplication is prohibited, when inserting a record, it can be determined whether updating an existing record is permissible or not. If overwriting can only occur due to a code error, it can be safeguarded by setting a flag. NOOVERWRITE.
Reading Records
The function designed for reading records in LMDB is mdb_get. If the key-value pair has been previously represented by dumped structures, this procedure appears as follows.
NodeValue * const readNode(..., NodeKey * const key) {
    MDB_val rawKey = serialize(key);
    MDB_val rawValue;
    mdb_get(..., &rawKey, &rawValue);
    return (NodeValue * const)rawValue.mv_data;
}
The presented listing demonstrates how serialization through dumped structures helps avoid dynamic allocations not only when writing but also when reading data. The pointer obtained from the function mdb_get points exactly to the address in virtual memory where the database stores the byte representation of the object. In effect, we achieve a kind of ORM that provides very high reading speeds almost for free. Despite the beauty of the approach, it is necessary to remember several associated peculiarities.
- For readonly transactions, the pointer to the value-structure will remain valid only until the transaction is closed. As previously noted, the B-tree pages on which the object resides remain unchanged due to the copy-on-write principle as long as at least one transaction refers to them. However, once the last associated transaction is completed, those pages can be reused for new data. If it is necessary for the objects to outlive the transaction that created them, they will still have to be copied.
- For readwrite transactions, the pointer to the obtained value-structure will remain valid only until the first modifying operation (writing or deleting data).
- Despite the fact that the structure
NodeValueis not complete but trimmed (see the subsection “Ordering keys with an external comparator”), one can safely access its fields through the pointer. Just do not dereference it! - Under no circumstances should the structure be modified via the obtained pointer. All changes must be made only through the method
mdb_put. However, even with the desire to do so, it will not be possible, since the memory area where this structure is located is mapped in readonly mode. - Remapping the file to the address space of the process with the aim, for example, of increasing the maximum storage size using the function
ogiltigförklarar alla entiteter (pekare, transaktioner, nycklar och värden) som tidigare fåtts från motorn. Att ta hänsyn till denna vändning i koden skulle leda till betydande komplexitet. Om det virtuella minnet dock är mycket viktigt för dig, kan det vara en anledning att titta på en fork som kommit långt fram,completely invalidates all transactions and the related entities in general, and the pointers to the read objects in particular.
Finally, another feature is so insidious that revealing its essence cannot simply fit into another point. In the chapter on B-trees, I provided a schematic representation of its pages in memory. From it, it follows that the address of the beginning of the buffer with serialized data can be completely arbitrary. Because of this, the pointer to them, obtained in the structure MDB_val and converted to a pointer to the structure, is generally not aligned. At the same time, the architectures of some chips (in the case of iOS, this is armv7) require that any data address be a multiple of the size of the machine word or, in other words, the bitness of the system (for armv7, this is 32 bits). In other words, an operation like *(int *foo)0x800002 is equated to an escape and leads to execution with the verdict EXC_ARM_DA_ALIGN. Such a sad fate can be avoided in two ways.
The first is to copy the data in advance to a deliberately aligned structure. For example, on a custom comparator, this will be reflected as follows.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return
// ...
}
An alternative approach is to notify the compiler in advance that the structures with key and value may be unaligned using the attribute aligned(1). On ARM, the same effect can be achieved using the packed attribute. Considering that it also contributes to the optimization of the space occupied by the structure, I see this method as preferable, even though it leads to increased costs for data access operations.
typedef struct __attribute__((packed)) NodeKey {
    uint8_t parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Range queries
För iteration genom en uppsättning av poster i LMDB finns det en abstraktion av en kursör. Hur man arbetar med den kommer vi att titta på med exemplet av vår bekanta användartabell med metadata.
Inom ramen för att visa en lista över filer i en katalog måste vi hitta alla nycklar som är associerade med dess underliggande filer och mappar. I de föregående avsnitten har vi sorterat nycklarna NodeKey så att de i första hand är ordnade efter identifieraren för den överordnade katalogen. Tekniskt sett innebär uppgiften att få innehållet i en mapp att ställa in kursorn på den övre gränsen för nyckelgruppen med en given prefix och sedan iterera till den nedre gränsen.
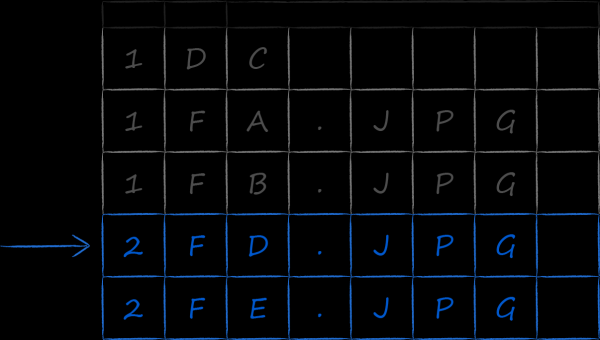
Den övre gränsen kan hittas direkt genom en sekventiell sökning. För att göra detta ställs kursorn i början av hela nyckellistan i databasen och inkrementeras tills den under den hittar nyckeln med identifieraren för den överordnade katalogen. Denna metod har två uppenbara nackdelar:
- Den linjära sökkomplexiteten, även om det är känt att i träd, och speciellt i B-träd, kan det genomföras på logaritmisk tid.
- Det är onödigt att hämta alla sidor som föregår den sökta nyckeln till huvudminnet, vilket är mycket kostsamt.
Lyckligtvis finns det i LMDB API ett effektivt sätt att initialt positionera kursorn. För detta behöver vi skapa en sådan nyckel vars värde kommer vara mindre än eller lika med nyckeln på den övre gränsen av intervallet. Till exempel, med avseende på listan i bilden ovan kan vi skapa en sådan nyckel där fältet parentId är lika med 2, medan alla andra fält är fyllda med nollor. Denna delvis ifyllda nyckel matare in i funktionen mdb_cursor_get anges operationen MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);Om den övre gränsen för nyckelgruppen har hittats, itererar vi sedan över den tills vi antingen hittar en nyckel med en annan parentId, eller nycklarna är slut.
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
// bearbetning...
} while (MDB_NOTFOUND != rc && // kontrollera slutet av tabellen
IsTargetKey(key)); // kontrollera slutet av nyckelgruppenDet är trevligt att mdb_cursor_get-itereringen inte bara ger oss nyckeln utan också värdet. Om vi behöver kontrollera fälten i värdedelen av posten för att uppfylla urvals kriterierna, så är de helt och hållet tillgängliga utan extra åtgärder.
4.3. Modellering av relationer mellan tabeller
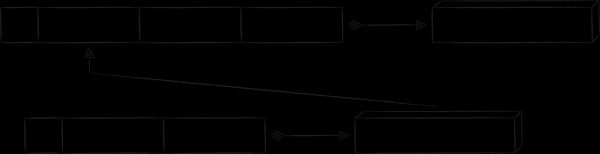
Vid detta tillfälle har vi kunnat granska alla aspekter av design och arbete med en engångstabell databas. Man kan säga att en tabell är en uppsättning sorterade poster som består av homogena nyckel-värde-par. Om man föreställer sig nyckeln som en rektangel och dess relaterade värde som en parallelepiped, får man en visuell schema av databasen.

Men i verkliga livet är det sällan möjligt att klara sig med så få resurser. Ofta krävs det i databasen, för det första, att ha flera tabeller, och för det andra, att genomföra urval i en ordning som skiljer sig från den primära nyckeln. Frågorna om att skapa dem och koppla dem samman är vad det här sista avsnittet handlar om.
Indextablåer
I det molnbaserade programmet finns det en sektion "Galleri". I den visas mediainnehåll från hela molnet, sorterat efter datum. För att optimalt genomföra en sådan urval behöver man skapa en ytterligare tabell med en ny typ av nycklar bredvid den huvudsakliga tabellen. I dessa kommer det att finnas ett fält med datumet för filens skapande, vilket kommer att fungera som den primära sorteringskriteriet. Eftersom de nya nycklarna refererar till samma data som nycklarna i den huvudsakliga tabellen, kallas de indexnycklar. På bilden nedan är de markerade i orange.
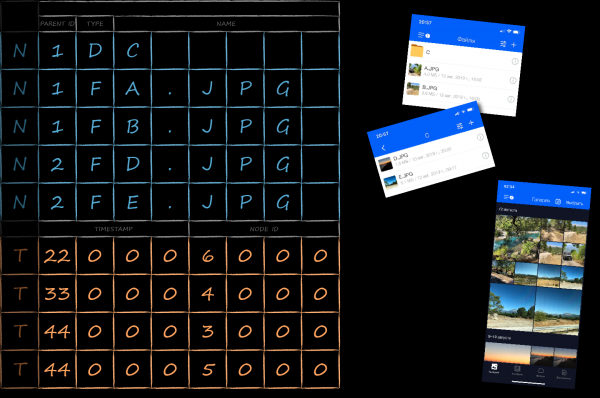
För att särskilja nycklarna från olika tabeller inom en enda databas har ett ytterligare tekniskt fält, tableId, lagts till alla nycklar. Genom att göra detta till det mest prioriterade för sortering, uppnår vi gruppering av nycklar först efter tabeller och sedan inom tabellerna enligt sina egna regler.
Indexnyckeln refererar till samma data som den primära nyckeln. En rak implementation av denna egenskap genom att associera den med en kopia av värdedelen från den primära nyckeln är inte optimalt från flera perspektiv:
- Från perspektivet av upptagen utrymme, eftersom metadata kan vara ganska rika.
- Från perspektivet av prestanda, eftersom vid uppdatering av metadata måste noderna skriva om på två nycklar.
- Ur kodstödets perspektiv, så fort vi glömmer att uppdatera data för en av nycklarna, får vi en svårupptäckbar bugg av datainkonsistens i lagret.
Vi går vidare för att diskutera hur vi kan åtgärda dessa brister.
Organisering av relationer mellan tabeller
För att koppla ihop indexmönstret med huvudtabellen är mönstret som passar bra "nyckel som värde". Som namnet antyder är en kopia av värdet av den primära nyckeln värde-delen av indexposten. Denna metod eliminerar alla de nämnda bristerna kopplade till lagring av en kopia av värde-delen av den primära posten. Den enda kostnaden är att för att hämta värdet med den indexnyckeln, behöver vi göra 2 förfrågningar till databasen istället för en. Schemat för den resulterande databasen ser ut som följer.
Ännu ett mönster för att organisera relationer mellan tabeller är "överskott nyckel". Kärnan är att lägga till ytterligare attribut i nyckeln, som inte behövs för sortering, utan för att återskapa den relaterade nyckeln. I Mail.ru:s Cloud-applikation finns det verkliga exempel på dess användning, men för att undvika att gå för djupt in i kontexten av specifika iOS-ramverk, kommer jag att ge ett påhittat, men tydligare exempel.
I de molnbaserade mobilklienterna finns det en sida där alla filer och mappar visas som användaren har gett tillgång till andra personer. Eftersom det finns relativt få sådana filer, men mycket specifik information om deras offentlighet (vem som har fått tillgång, med vilka rättigheter etc.), skulle det vara oekonomiskt att tynga värde-delen av posten i huvudtabellen med detta. Men om man vill visa sådana filer offline, behöver man förvara den någonstans. En naturlig lösning är att skapa en separat tabell för den. I diagrammet nedan har dess nyckel prefixen "P", och platsinnehållaren "propname" kan ersättas med ett mer konkret värde "offentlig information".
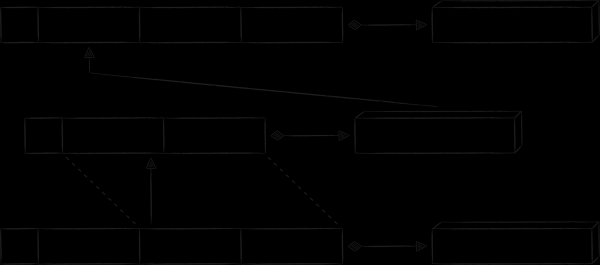
All unique metadata for which a new table was created is contained in the value part of the record. At the same time, we do not wish to duplicate the data about files and folders that are already stored in the main table. Instead, redundant data in the form of the fields 'node ID' and 'timestamp' is added to the key 'P'. Thanks to them, we can construct an index key that allows us to obtain the primary key, which can finally retrieve the node's metadata.
Slutsats
We evaluate the results of implementing LMDB positively. After its introduction, the number of application hangs decreased by 30%.
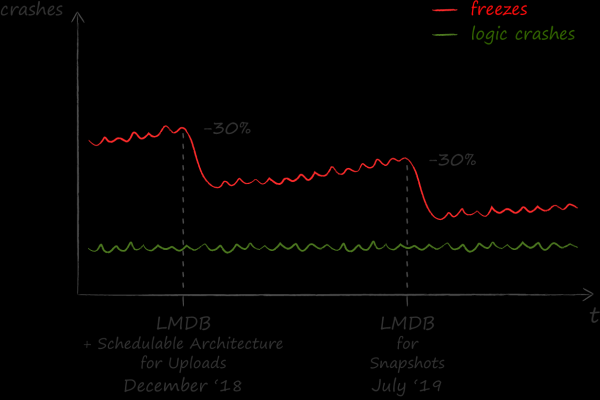
The results of the work carried out have resonated beyond the iOS team. Currently, one of the main sections 'Files' in the Android application has also switched to using LMDB, while other parts are on the way. The C language, in which the key-value storage is implemented, proved to be a good support for initially creating a cross-platform wrapper around it in C++. A code generator was used for seamless integration of the resulting C++ library with the platform code in Objective-C and Kotlin. from Dropbox, but that's a different story.
Källa: habr.com
