

Många som kommer in i området Data Science har inte helt realistiska förväntningar på vad som väntar dem. Många tror att de direkt kommer att kunna skriva fantastiska neurala nätverk, skapa en röstassistent likt Iron Man eller överlista alla på finansmarknaderna.
Men arbetet Data som Scientist är kopplat till data, och en av de viktigaste och mest tidskrävande aspekterna är datahantering innan de matas in i neurala nätverk eller analyseras på specifika sätt.
I denna artikel kommer vårt team att beskriva hur man enkelt och snabbt bearbetar data med steg-för-steg instruktioner och kod. Vi har strävat efter att koden ska vara ganska flexibel så att den kan tillämpas på olika datamängder.
Många yrkesverksamma kanske inte hittar något extraordinärt i denna artikel, men nybörjare kan lära sig något nytt, och alla som länge har drömt om att skapa en egen notebook för snabb och strukturerad datahantering kan kopiera koden och anpassa den till sig själva, eller
Vi har fått datamängden. Vad gör vi nu?
Så, standard: vi behöver förstå vad vi har att göra med, den övergripande bilden. För detta använder vi pandas för att enkelt identifiera olika typer av data.
import pandas as pd #importerar pandas
import numpy as np  #importerar numpy
df = pd.read_csv("AB_NYC_2019.csv") #läser in datamängden och sparar den i variabeln df
df.head(3) #ser på de första 3 raderna för att förstå hur värdena ser ut 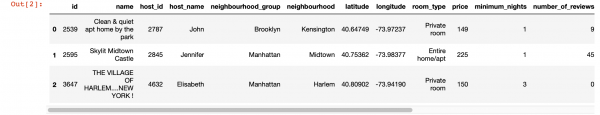
df.info() #Visar information om kolumnerna 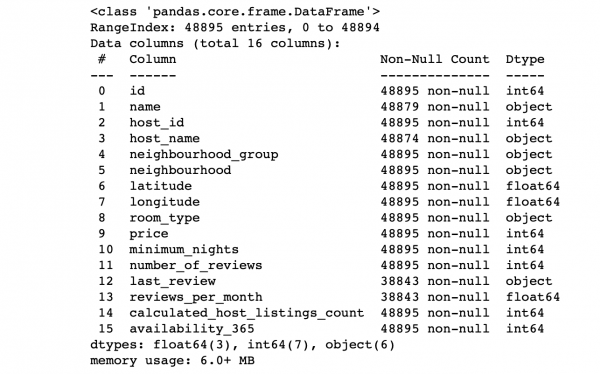
Vi tittar på värdena i kolumnerna:
- Överensstämmer antalet rader i varje kolumn med det totala antalet rader?
- Vad är essensen av data i varje kolumn?
- Vilken kolumn vill vi göra till målet för att göra förutsägelser för den?
Svar på dessa frågor kommer att möjliggöra en analys av datamängden och ungefär skissa en plan för de närmaste åtgärderna.
För en djupare insyn i värdena i varje kolumn kan vi använda pandas-funktionen describe(). En nackdel med denna funktion är dock att den inte ger information om kolumner med string-värden. Vi kommer att ta itu med dem senare.
df.describe() 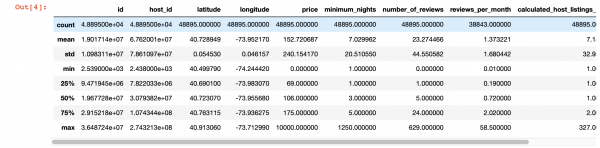
Magisk visualisering
Låt oss titta på var vi har saknade värden:
import seaborn as sns
sns.heatmap(df.isnull(), yticklabels=False, cbar=False, cmap='viridis') 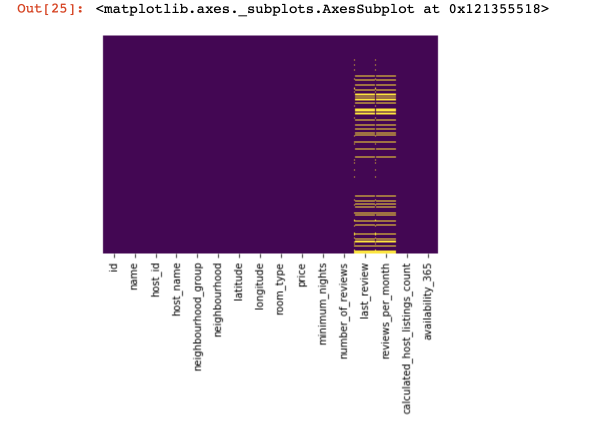
Detta var en liten översikt, nu börjar vi med intressantare saker.
Vi ska försöka hitta och, om möjligt, ta bort kolumner där det endast finns ett värde i alla rader (de kommer inte att påverka resultatet på något sätt):
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] #Överskriv datasetet, behåll endast de kolumner som har mer än ett unikt värde
Nu skyddar vi oss själva och framgången för vårt projekt från dubbelrader (rader som innehåller samma information i samma ordning som redan finns i en av de existerande raderna):
df.drop_duplicates(inplace=True) #Vi gör detta om vi anser att det är nödvändigt.
                                 #I vissa projekt bör sådana data inte tas bort från början.
Vi delar upp datasetet i två: en med kvalitativa värden och en annan med kvantitativa
Här behöver vi göra en liten precisering: om rader med saknade data inom kvalitativa och kvantitativa värden inte helt överensstämmer med varandra, måste vi fatta beslut om vad vi offrar - alla rader med saknade data, endast en del av dem eller specifika kolumner. Om raderna överensstämmer har vi full rätt att dela datasetet i två. I annat fall måste vi först reda ut rader där saknade data inom kvalitativa och kvantitativa värden inte överensstämmer, och först sedan dela datasetet i två.
df_numerical = df.select_dtypes(include=[np.number])
df_categorical = df.select_dtypes(exclude=[np.number])
Vi gör detta för att det ska bli lättare att bearbeta dessa två olika typer av data - senare kommer vi att förstå hur mycket detta förenklar vårt liv.
Arbeta med kvantitativa data
Det första vi bör göra är att avgöra om det finns "spionkolumner" i de kvantitativa data. Vi kallar dessa kolumner så eftersom de utger sig för att vara kvantitativa data, men fungerar som kvalitativa.
Hur kan vi identifiera dem? Naturligtvis beror allt på arten av de data som du analyserar, men i huvudsak kan sådana kolumner ha få unika data (runt 3-10 unika värden).
print(df_numerical.nunique())När vi har identifierat spionkolumnerna kommer vi att flytta dem från de kvantitativa data till de kvalitativa:
spy_columns = df_numerical[['kolumn1', 'kolumn2', 'kolumn3']]# Vi separerar spionkolumnerna och skriver till en separat dataframe
df_numerical.drop(labels=['kolumn1', 'kolumn2', 'kolumn3'], axis=1, inplace=True)# Vi tar bort dessa kolumner från de numeriska data
df_categorical.insert(1, 'kolumn1', spy_columns['kolumn1']) # Vi lägger till första spionkolumnen i de kvalitativa data
df_categorical.insert(1, 'kolumn2', spy_columns['kolumn2']) # Vi lägger till andra spionkolumnen i de kvalitativa data
df_categorical.insert(1, 'kolumn3', spy_columns['kolumn3']) # Vi lägger till tredje spionkolumnen i de kvalitativa data
Äntligen har vi helt separerat de kvantitativa data från de kvalitativa och nu kan vi verkligen arbeta med dem. Först och främst — vi måste förstå var vi har tomma värden (NaN, och i vissa fall även 0 kommer tas som tomma värden).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
I det här skedet är det viktigt att förstå i vilka kolumner nollor kan betyda saknade värden: är det kopplat till hur data samlades in? Eller kan det bero på datavärden? Dessa frågor måste besvaras i varje enskilt fall.
Så om vi beslutar att data kan saknas där det finns nollor, bör vi ersätta nollor med NaN för att senare enklare kunna hantera dessa saknade data:
df_numerical[["kolumn 1", "kolumn 2"]] = df_numerical[["kolumn 1", "kolumn 2"]].replace(0, nan)Låt oss nu se var vi har saknade data:
sns.heatmap(df_numerical.isnull(), yticklabels=False, cbar=False, cmap='viridis') # Vi kan också använda df_numerical.info() 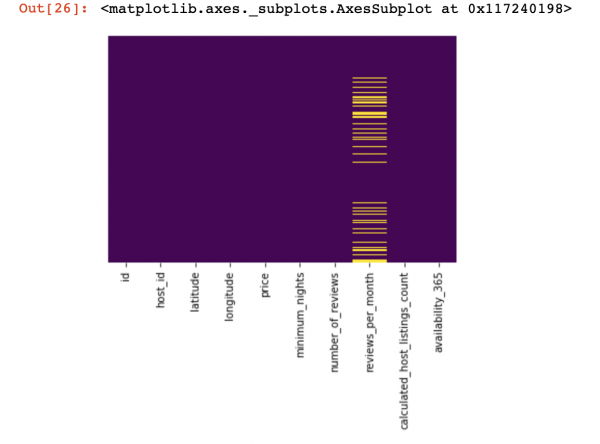
Här ska de värden som saknas inom kolumnerna markeras i gult. Och det mest intressanta börjar nu — hur ska vi hantera dessa värden? Ska vi ta bort rader med dessa värden eller kolumner? Eller fylla dessa tomma värden med något annat?
Här är en ungefärlig plan som kan hjälpa dig att besluta om vad som kan göras med de tomma värdena:
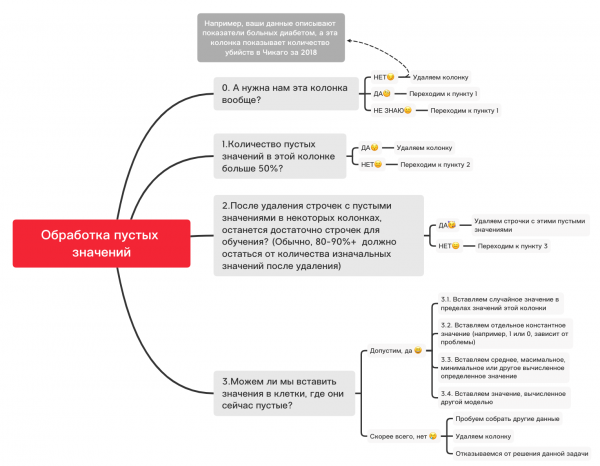
0. Ta bort onödiga kolumner
df_numerical.drop(labels=["kolumn1","kolumn2"], axis=1, inplace=True)1. Finns det fler än 50% tomma värden i denna kolumn?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["kolumn1","kolumn2"], axis=1, inplace=True) # Ta bort om någon kolumn har mer än 50 saknade värden2. Ta bort rader med tomma värden
df_numerical.dropna(inplace=True) # Tar bort rader med tomma värden, om det sedan finns tillräckligt med data för inlärning3.1. Infoga ett slumpmässigt värde
import random # Importera random
df_numerical["kolumn"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolumn"]), inplace=True) # Infoga slumpmässiga värden i tomma celler i tabellen
3.2. Infoga ett konstant värde
from sklearn.impute import SimpleImputer # Importera SimpleImputer, som hjälper till att sätta in värden
imputer = SimpleImputer(strategy='constant', fill_value="") # Infoga ett specifikt värde med hjälp av SimpleImputer
df_numerical[["ny_kolumn1", 'ny_kolumn2', 'ny_kolumn3']] = imputer.fit_transform(df_numerical[['kolumn1', 'kolumn2', 'kolumn3']]) # Tillämpar detta för vår tabell
df_numerical.drop(labels=["kolumn1", "kolumn2", "kolumn3"], axis=1, inplace=True) # Ta bort kolumner med gamla värden
3.3. Infoga det genomsnittliga eller mest frekventa värdet
from sklearn.impute import SimpleImputer # Importera SimpleImputer, som hjälper till att sätta in värden
imputer = SimpleImputer(strategy='mean', missing_values=np.nan) # Istället för mean kan man också använda most_frequent
df_numerical[["ny_kolumn1", 'ny_kolumn2', 'ny_kolumn3']] = imputer.fit_transform(df_numerical[['kolumn1', 'kolumn2', 'kolumn3']]) # Tillämpar detta för vår tabell
df_numerical.drop(labels=["kolumn1", "kolumn2", "kolumn3"], axis=1, inplace=True) # Ta bort kolumner med gamla värden
3.4. Infoga ett värde beräknat av en annan modell
Ibland kan värden beräknas med hjälp av regressionsmodeller, genom att använda modeller från sklearn-biblioteket eller andra liknande bibliotek. Vårt team kommer att ägna en särskild artikel åt hur detta kan göras inom en snar framtid.
Så, berättelsen om kvantitativa data pausar här, eftersom det finns många andra detaljer om hur man bäst gör dataförberedelse och förbehandling för olika uppgifter, och de grundläggande sakerna för kvantitativa data har beaktats i den här artikeln. Nu är det dags att återgå till kvalitativa data, som vi separerade några steg tillbaka från de kvantitativa. Du kan ändra denna notebook som du vill, anpassa den för olika uppgifter så att dataförbehandlingen går mycket snabbt!
Kvalitativa data
Primärt används metoden One-hot-encoding för kvalitativa data för att formatera dem från sträng (eller objekt) till nummer. Innan vi går vidare till detta avsnitt, låt oss använda schemat och koden ovan för att förstå de tomma värdena.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 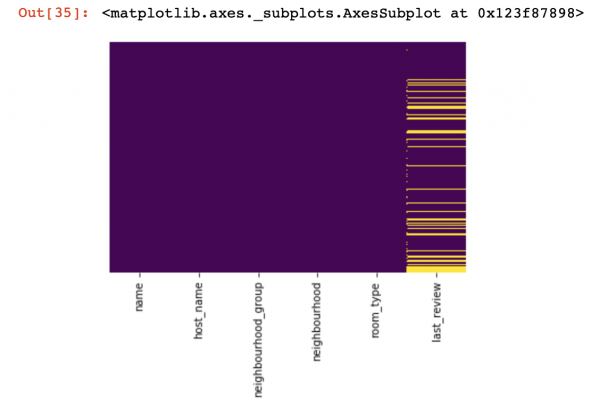
0. Ta bort onödiga kolumner
df_categorical.drop(labels=["kolumn1", "kolumn2"], axis=1, inplace=True)1. Finns det fler än 50% tomma värden i denna kolumn?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["kolumn1", "kolumn2"], axis=1, inplace=True) # Tar bort om någon kolumn
# har mer än 50% tomma värden2. Ta bort rader med tomma värden
df_categorical.dropna(inplace=True) # Tar bort rader med tomma värden,
                                      # om det sedan finns tillräckligt med data för träning
3.1. Infoga ett slumpmässigt värde
import random
df_categorical["kolumn"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolumn"]), inplace=True)
3.2. Infoga ett konstant värde
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["ny_kolumn1", 'ny_kolumn2', 'ny_kolumn3']] = imputer.fit_transform(df_categorical[['kolumn1', 'kolumn2', 'kolumn3']])
df_categorical.drop(labels=["kolumn1", "kolumn2", "kolumn3"], axis=1, inplace=True)
Så, vi har äntligen förstått de tomma värdena i kvalitativa data. Nu är det dags att utföra one-hot-encoding för värdena som finns i din databas. Denna metod används ofta så att din algoritm kan träna med hänsyn till kvalitativa data.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["kolumn1", "kolumn2", "kolumn3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Så, vi har äntligen avslutat att bearbeta kvalitativa och kvantitativa data separat — tid att kombinera dem igen.
new_df = pd.concat([df_numerical, df_categorical], axis=1)Efter att vi har sammanfört dataset i ett enda, kan vi till slut använda datatransformation med hjälp av MinMaxScaler från sklearn-biblioteket. Detta kommer att göra våra värden mellan 0 och 1, vilket hjälper med modellens träning i framtiden.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Dessa data är nu redo för allt — för neurala nätverk, vanliga ML-algoritmer, etc!
I den här artikeln har vi inte tagit hänsyn till arbetet med data som rör tidsserier, eftersom sådana data kräver något andra metoder för bearbetning beroende på din uppgift. I framtiden kommer vårt team att ägna ett separat ämne åt detta och vi hoppas att det kommer att ge något intressant, nytt och användbart i ditt liv, precis som denna artikel.
Källa: habr.com
