

Hej alla! Jag heter Dmitrij Samsonov och jag arbetar som systemadministratör på "Odnoklassniki". Vi har över 7000 fysiska servrar, 11000 containrar i vår molnplattform och 200 applikationer som i olika konfigurationer bildar 700 olika kluster. Den överväldigande majoriteten av servrarna körs på CentOS 7.
Den 14 augusti 2018 publicerades information om sårbarheten FragmentSmack
() och SegmentSmack (). Detta är sårbarheter med nätverksvektor för attack och en ganska hög bedömning (7.5), som hotar med tjänsteavbrott (DoS) på grund av resursutarmning (CPU). En fix för kärnan för FragmentSmack föreslogs inte vid den tiden, och dessutom kom den mycket senare än publiceringen av informationen om sårbarheten. För att åtgärda SegmentSmack rekommenderades att uppdatera kärnan. Själva paketet med uppdateringen släpptes samma dag, och det återstod bara att installera det.
Nej, vi är absolut inte emot att uppdatera kärnan! Men det finns vissa nyanser…
Så här uppdaterar vi kärnan på produktion
För det mesta är det inte så komplicerat:
- Ladda ner paketen;
- Installera dem på ett antal servrar (inklusive servrar som hostar vår molnplattform);
- Se till att inget har gått sönder;
- Säkerställ att alla standardinställningar för kärnan har tillämpats utan fel;
- Vänta några dagar;
- Kontrollera servernas prestanda;
- Byt över deployeringen av nya servrar till den nya kärnan;
- Uppdatera alla servrar per datacenter (ett datacenter i taget för att minimera påverkan för användarna om problem uppstår);
- Starta om alla servrar.
Upprepa för alla versioner av kärnor vi har. För tillfället inkluderar detta:
- Standard CentOS 7 3.10 – för de flesta vanliga servrar;
- Vanilla 4.19 – för vår , eftersom vi behöver BFQ, BBR etc.;
- Elrepo kernel-ml 5.2 – för , eftersom 4.19 tidigare var instabil, och vi behöver samma funktioner.
Som du kan gissa tar omstart av tusentals servrar mest tid. Eftersom inte alla sårbarheter är kritiska för alla servrar, omstartar vi endast de som är direkt tillgängliga från internet. I molnet, för att inte begränsa flexibiliteten, kopplar vi inte utvändiga containrar till separata servrar med ett nytt kärna, utan omstartar alla värdar utan undantag. Lyckligtvis är proceduren där enklare än med vanliga servrar. Till exempel kan stateless-containrar helt enkelt flytta till en annan server under omstarten.
Trots det finns det fortfarande mycket arbete, och det kan ta flera veckor, och om det uppstår några problem med den nya versionen – upp till flera månader. Detta förstår angriparna väl, så en plan "B" behövs.
FragmentSmack/SegmentSmack. Workaround
Lyckligtvis finns det en sådan plan "B" för vissa sårbarheter, och den kallas Workaround. Oftast handlar det om att ändra kärn-/programinställningar som minimerar den möjliga effekten eller helt utesluter utnyttjande av sårbarheterna.
I fallet med FragmentSmack/SegmentSmack en sådan Workaround:
«Du kan ändra standardvärdena 4MB och 3MB i net.ipv4.ipfrag_high_thresh och net.ipv4.ipfrag_low_thresh (och deras motsvarigheter för ipv6 net.ipv6.ipfrag_high_thresh och net.ipv6.ipfrag_low_thresh) till 256 kB och 192 kB respektive eller lägre. Tester visar en från liten till betydande minskning av CPU-användning under attack beroende på hårdvara, inställningar och förhållanden. Men det kan påverka prestandan på grund av ipfrag_high_thresh=262144 bytes, eftersom bara två 64K-fragment kan rymmas samtidigt i kön för ominlämning. Det finns exempelvis en risk att applikationer som arbetar med stora UDP-paket går sönder.».
Själva parametrarna beskrivs så här:
ipfrag_high_thresh - LÅNG HELTAL
     Maximalt minne som används för att återmontera IP-fragment.
ipfrag_low_thresh - LÅNGT HELTAL
     Maximalt minnesutrymme som används för att återsamla IP-fragment innan kärnan
     börjar ta bort ofullständiga fragmentköer för att frigöra resurser.
     Kärnan accepterar fortfarande nya fragment för defragmentering.
Vi har inga produktionsservrar för stora UDP. I LAN finns det inget fragmenterat trafik, medan det i WAN finns, men inte i betydande mängder. Inget tyder på något – Workaround kan implementeras!
FragmentSmack/SegmentSmack. Första blodet
Det första problemet vi stötte på var att de molnbaserade containrarna ibland tillämpade nya inställningar endast delvis (bara ipfrag_low_thresh), och ibland tillämpades de överhuvudtaget inte — de kraschade vid start. Vi kunde inte reproducera problemet konsekvent (manuellt tillämpades alla inställningar utan några svårigheter). Att förstå varför containern kraschar vid start är inte heller så enkelt: inga fel har upptäckts. En sak var säker: återställning av inställningarna löste problemet med kraschande containrar.
Varför räcker det inte att tillämpa Sysctl på värden? Containern lever i sitt dedikerade nätverksnamnrum, så åtminstone i containern kan skilja sig från värden.
Hur tillämpas Sysctl-inställningarna i containern? Eftersom våra containrar är obehöriga går det inte att ändra någon Sysctl-inställning genom att gå in i containern — rättigheterna räcker helt enkelt inte. För att starta containrarna använde vårt moln vid den tiden Docker (nu är det redan ). Till Docker skickades parametrar för den nya containern via API, inklusive de nödvändiga Sysctl-inställningarna.
Under utvärderingen av versioner visade det sig att Docker API inte gav tillbaka alla fel (åtminstone inte i version 1.10). När vi försökte starta containern via "docker run" såg vi äntligen något:
write /proc/sys/net/ipv4/ipfrag_high_thresh: ogiltig parameter docker: Felmeddelande från daemon: Kan inte starta containern <...>: [9] Systemfel: kunde inte synkronisera med containern processen.
Parametervärdet är ogiltigt. Men varför? Och varför är det ogiltigt bara ibland? Det visade sig att Docker inte garanterar ordningen av tillämpningen av Sysctl-parametrarna (senaste verifierade version — 1.13.1), så ibland försökte ipfrag_high_thresh att sättas till 256K medan ipfrag_low_thresh fortfarande var 3M, vilket innebar att övre gränsen var lägre än den nedre, vilket ledde till felet.
Vid den tidpunkten hade vi också redan använt vår egen mekanism för efterkonfigurering av containern efter start (frysning av containern via och utförande av kommandon i containerns namnrymd via ), och vi lade till Sysctl-parametrarna i denna del. Problemet blev löst.
FragmentSmack/SegmentSmack. Första blodet 2
Vi hade knappt hunnit förstå användningen av Workaround i molnet innan de första sällsynta klagomålen började komma in från användarna. Vid den tidpunkten hade det gått flera veckor sedan vi började använda Workaround på de första servrarna. Den initiala undersökningen visade att klagomålen kom från enskilda tjänster, och inte från alla servrar för dessa tjänster. Problemet hade återigen fått en mycket odefinierad karaktär.
Först och främst försökte vi självklart återställa Sysctl-inställningarna, men det hade ingen effekt. Olika manipulationer med server- och applikationsinställningarna hjälpte inte heller. En omtänkning hjälpte. Omtänkning för Linux är lika onaturligt som det en gång var en normal åtgärd för att arbeta med Windows. Ändå hjälpte det, och vi bortförklarade allt med en "bugg i kärnan" vid tillämpning av de nya Sysctl-inställningarna. Vad naivt det var…
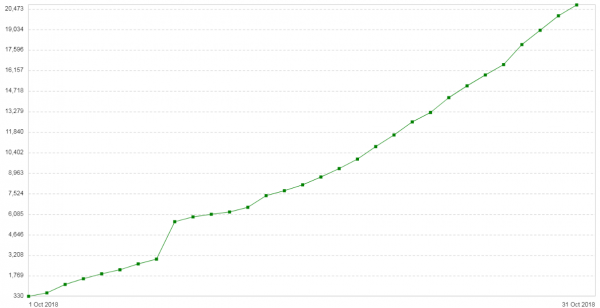
Tre veckor senare upprepades problemet. Konfigurationen av dessa servrar var ganska enkel: Nginx i proxy/balanseringsläge. Lite trafik. En ny insikt: antalet 504-fel hos klienterna ökade dag för dag (). Grafiken visar antalet 504-fel per dag för denna tjänst:
Alla fel handlar om samma backend — den som ligger i molnet. Grafiken över minnesanvändning för paketfragment på denna backend såg ut så här:
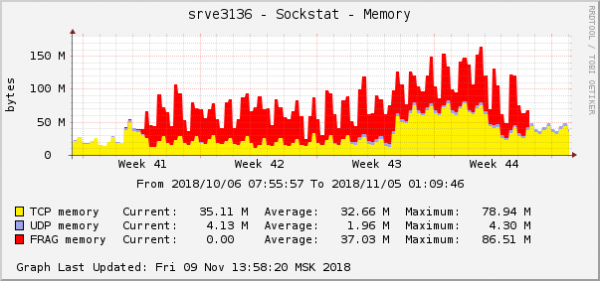
Detta är ett av de mest framträdande uttrycken för problemet i operativsystemets grafer. I molnet hade en annan nätverksproblem med QoS-inställningarna (Traffic Control) blivit åtgärdad just vid denna tidpunkt. Grafiken över minnesanvändning för paketfragment såg exakt likadan ut:
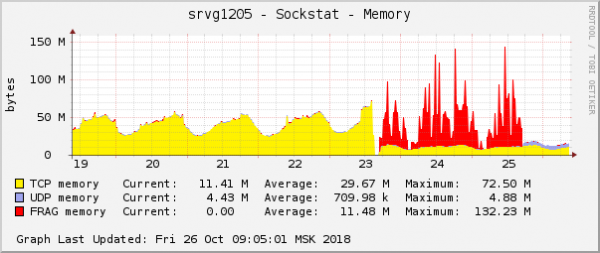
Antagandet var enkelt: om graferna ser likadana ut har de samma orsak. Dessutom inträffar problem med denna typ av minne extremt sällan.
Kärnan i det åtgärdade problemet var att vi använde den packet scheduler fq i QoS med standardinställningar. Som standard tillåter den att en kö med 100 paket läggs till för en anslutning, och vissa anslutningar i situationer med otillräcklig bandbredd började blockera kön till sin kapacitet. I detta fall droppas paketen. I statistiken tc (tc -s qdisc) ser detta ut så här:
qdisc fq 2c6c: förälder 1:2c6c gräns 10000p flödesgräns 100p hinkar 1024 föräldramask 1023 kvantum 3028 initialt_kvantum 15140 återfyllnadsfördröjning 40.0ms
  Skickade 454701676345 byte 491683359 pkt (borttagna 464545, övergränser 0 omprioriteringar 0)
  backlog 0b 0p omprioriteringar 0
   1024 flöden (1021 inaktiva, 0 dämpade)
   0 gc, 0 högprioritet, 0 dämpade, 464545 flöden_plimit
«464545 flows_plimit» är paket som har droppats på grund av att kögränsen för en anslutning har överskridits, medan «dropped 464545» är summan av alla droppade paket från denna schemaläggare. Efter att ha ökat kölängden till 1 000 och startat om containrarna, försvann problemet. Man kan luta sig tillbaka i stolen och dricka en smoothie.
FragmentSmack/SegmentSmack. Sista blodet
För det första, flera månader efter tillkännagivandet av sårbarheterna i kärnan, har det äntligen kommit en fix för FragmentSmack (jag påminner om att fixen för SegmentSmack endast kom med tillkännagivandet i augusti), vilket gav oss möjlighet att avstå från workarounden som orsakade oss en hel del problem. Vi hade redan lyckats uppgradera en del servrar till den nya kärnan under tiden, och nu behövdes det börja om från början. Varför uppdaterade vi kärnan utan att vänta på fixen för FragmentSmack? Det beror på att processen att skydda mot dessa sårbarheter sammanföll (och blev en del av) uppgraderingen av själva CentOS (vilket tar ännu mer tid än att bara uppdatera kärnan). Dessutom är SegmentSmack en mer farlig sårbarhet, och fixen för den kom genast, så det fanns i varje fall mening med det. Men vi kunde inte bara uppdatera kärnan i CentOS, eftersom sårbarheten FragmentSmack, som dök upp under CentOS 7.5, först blev fixad i version 7.6, så vi var tvungna att pausa uppdateringen till 7.5 och börja om med uppdateringen till 7.6. Så kan det också hända.
För det andra har vi fått sällsynta klagomål från användare om problem. Nu vet vi säkert att alla är relaterade till uppladdning av filer från kunder till vissa av våra servrar. Dessutom passerade det väldigt få uppladdningar genom dessa servrar i förhållande till den totala mängden.
Som vi minns från berättelsen ovan, hjälpte inte återställningen av Sysctl. Omstart hjälpte, men bara tillfälligt.
Misstankarna kring Sysctl har inte undanröjts, men denna gång krävdes det att samla så mycket information som möjligt. Det saknades också kraftigt möjligheten att reproducera problemet med uppladdningen hos kunden, för att mer exakt studera vad som pågår.
Analys av all tillgänglig statistik och loggar förde oss inte närmare en förståelse för vad som hände. Vi saknade akut möjligheten att reproducera problemet för att "känna på" den specifika anslutningen. Till slut lyckades utvecklarna med en specialversion av applikationen åstadkomma en stabil reproduktion av problemen på testutrustningen när de anslöt via Wi-Fi. Detta var ett genombrott i undersökningen. Kunden anslöt till Nginx, som proxyade till backend, vilket var vår applikation på Java.
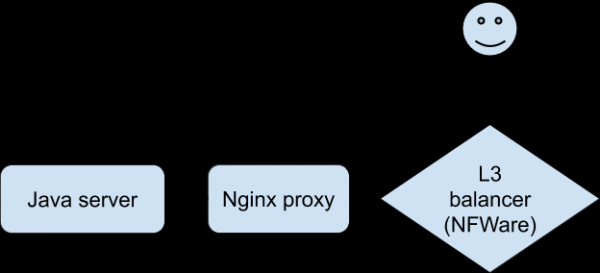
Dialogen vid problem såg ut så här (dokumenterad på Nginx-proxyn):
- Kund: begäran om information om nedladdningsstatus.
- Java-server: svar.
- Kund: POST med fil.
- Java-server: fel.
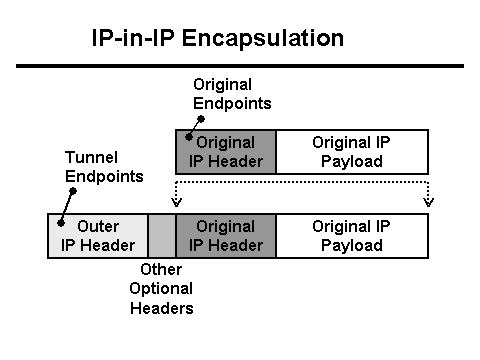
Java-servern skriver i loggen att 0 byte data mottogs från kunden, medan Nginx-proxyn indikerar att begäran tog mer än 30 sekunder (30 sekunder är tidsgränsen för klientapplikationen). Varför är det tidsgräns och varför 0 byte? Ur ett HTTP-perspektiv fungerar allt som det ska, men POST med fil verkar försvinna från nätverket. Det försvinner mellan kunden och Nginx. Dags att beväpna sig med Tcpdump! Men först måste vi förstå nätverkskonfigurationen. Nginx-proxyn står bakom en L3-lastenhet. . Tunneling används för att leverera paket från L3-lastenheten till servern, vilket lägger till sina egna headers i paketen:
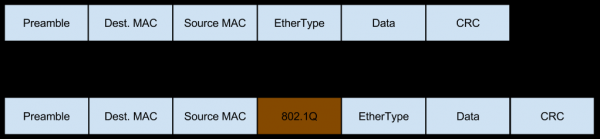
Nätverket till denna server kommer i form av VLAN-taggad trafik, som också lägger till sina egna fält i paketen:
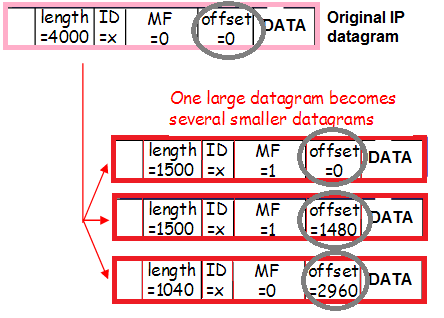
Och dessutom kan denna trafik fragmenteras (den lilla procenten av inkommande fragmenterad trafik som vi pratade om vid riskbedömningen av Workaround), vilket också ändrar innehållet i headers:
För att tydligare förstå hur detta sker, följ paketets väg från klienten till Nginx-proxyn.
- Paketet kommer till L3-lastenheten. För korrekt routing inom datacentret kapslas paketet in i en tunnel och skickas till nätverkskortet.
- Eftersom paketet + tunnelheaders inte får plats i MTU, fragmenteras paketet och skickas ut i nätverket.
- Switchen efter L3-lastenheten lägger till VLAN-taggen när den mottar paketet och skickar det vidare.
- Switchen framför Nginx-proxy ser (enligt portinställningarna) att servern förväntar sig ett VLAN-kapslat paket, så det skickar det direkt utan att ta bort VLAN-taggen.
- Linux tar emot fragment av separata paket och sätter ihop dem till ett stort paket.
- Paketet går sedan till VLAN-gränssnittet, där det första lagret tas bort - VLAN-kapslingen.
- Sedan skickar Linux det till Tunnel-gränssnittet, där ytterligare ett lager tas bort - Tunnel-kapslingen.
Svårigheten ligger i att överföra allt detta som parametrar i tcpdump.
Låt oss börja i slutet: finns det rena (utan överflödiga rubriker) IP-paket från klienter, med borttagen VLAN- och tunnel-kapsling?
tcpdump host
Nej, sådana paket fanns inte på servern. Problemet måste därför ligga tidigare. Finns det paket med endast borttagen VLAN-kapsling?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx är klientens IP-adress i hex-format.
32:4 är adress och längd på fältet där SCR IP är lagrat i Tunnel-paketet.
Fältadressen fick jag fram genom trial and error, eftersom det på nätet stått om 40, 44, 50, 54, men där fanns ingen IP-adress. Man kan också titta på ett av paketen i hex (parametern -xx eller -XX i tcpdump) och räkna ut vilken adress den kända IP-adressen har.
Finns det fragment av paket utan borttagen VLAN- och tunnel-kapsling?
tcpdump ((ip[6:2] > 0) and (not ip[6] = 64))
Denna magi visar oss alla fragment, inklusive det sista. Förmodligen kan man också filtrera efter IP, men jag försökte inte, eftersom sådana paket inte är så många och i det allmänna flödet var de lätt att hitta. Här är de:
14:02:58.471063 I 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), längd 1516: (tos 0x0, ttl 63, id 53652, offset 0, flags [+], proto IPIP (4), längd 1500)
     11.11.11.11 > 22.22.22.22: truncated-ip - 20 bytes saknas! (tos 0x0, ttl 50, id 57750, offset 0, flags [DF], proto TCP (6), längd 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Flags [.”], seq 0:1448, ack 1, win 343, options [nop,nop,TS val 11660691 ecr 2998165860], längd 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 if..MM.*........
14:02:58.471103 In 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), length 62: (tos 0x0, ttl 63, id 53652, offset 1480, flags [none], proto IPIP (4), length 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
Det här är två fragment av ett paket (samma ID 53652) med foto (man ser ordet Exif i det första paketet). Eftersom paketen finns på denna nivå, men inte i det sammansatta formatet i dumpningarna, så är problemet uppenbarligen med sammanställningen. Äntligen finns det dokumentation för detta!
Paketdekodern upptäckte inga problem som hindrar sammanställningen. Jag testade här: . Först, när jag försökte stoppa något där, gillade dekodern inte paketformatet. Det visade sig att det fanns två överflödiga oktetter mellan Srcmac och Ethertype (som inte hörde till fragmentinformationen). Efter att de tagits bort fungerade dekodern. Dock visade den inga problem.
Hur som helst, förutom de specifika Sysctl hittades inget mer. Det återstod att hitta ett sätt att identifiera problematiska servrar för att förstå omfattningen och fatta beslut om vidare åtgärder. Jag hittade ganska snabbt rätt räknare:
netstat -s | grep "packet reassembles failed”
Den finns även i snmpd under OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
«Antalet fel som upptäckts av IP-rekonfigureringen (oavsett anledning: tidsgräns, fel, etc.).»
Bland gruppen servrar där problemet studerades, ökade denna räknare snabbare på två, långsammare på två andra, och på ytterligare två ökade den överhuvudtaget inte. Jämförelsen av dynamiken för den här räknaren med dynamiken för HTTP-fel på Java-servern visade en korrelation. Det vill säga att räknaren kunde sättas på övervakning.
Närvaron av en pålitlig indikator för problem är mycket viktig för att kunna exakt avgöra om en återställning av Sysctl hjälper, eftersom vi från tidigare berättelse vet att det inte är möjligt att förstå detta omedelbart via applikationen. Denna indikator skulle ha identifierat alla problemområden i produktion innan användarna upptäckte dem.
Efter återställningen av Sysctl upphörde felen i övervakningen, vilket bevisade att orsaken till problemen var bekräftad, liksom att återställningen hjälpte.
Vi återställde fragmenteringsinställningarna på andra servrar, där ny övervakning aktiverades, och någonstans tilldelade vi till och med mer minne till fragment än vad som var standard tidigare (det var udp-statistik, vars delvis förlust inte var märkbar i den allmänna bilden).
De viktigaste frågorna
Varför fragmenteras paketen på vår L3-lastbalanserare? De flesta av paketen som kommer från användarna till lastbalanserarna är SYN och ACK. Storlek på dessa paket är små. Men eftersom andelen sådana paket är så hög, så la vi inte märke till de större paket som började fragmenteras.
Orsaken visade sig vara en trasig konfigurationsskript på servrar med Vlan-gränssnitt (det fanns väldigt få servrar med taggad trafik i produktion vid den tiden). Advmss gör det möjligt för kunden att förstå att paketen som går vår väg måste vara mindre i storlek, så att de inte behöver fraktureras efter att tunneltitlar fästs på dem.
Varför hjälpte inte återställningen av Sysctl, men en omstart hjälpte? Återställningen av Sysctl ändrade mängden minne som var tillgängligt för sammanfogning av paket. Samtidigt verkade det faktum att minnet för fragment var överfullt leda till att anslutningarna bromsades, vilket ledde till att fragmenten förblev i kö länge. Processen hamnade alltså i en loop.
En omstart nollställde minnet och allt kom i ordning.
Kunde man klara sig utan workaround? Ja, men risken var stor att lämna användarna utan service vid en attack. Självklart ledde användningen av workaround till olika problem, inklusive förseningar i en av servicen för användarna, men vi anser likväl att åtgärderna var berättigade.
Stort tack till Andrey Timofeyev () för hjälpen med utredningen, samt Alexey Krenyov () — för det titaniska arbetet med att uppdatera CentOS och kärnor på servrarna. Processen som i detta fall fick starta om flera gånger, vilket förlängde den med flera månader.
Källa: habr.com
