

I början fanns det en teknik som kallades BPF. Vi tittade på den i , den gammaltestamentliga artikeln i denna cykel. År 2013 utvecklades en förbättrad version av den av Alexei Starovoitov och Daniel Borkman och inkluderades i Linux-kärnan, optimerad för moderna 64-bitars maskiner. Denna nya teknik hade en kort tid namnet Internal BPF, innan den bytte namn till Extended BPF, och nu, efter några år, kallar alla den helt enkelt BPF.
Grovt sett låter BPF användare köra valfri kod i Linux-kärnans rum, och den nya arkitekturen visade sig vara så framgångsrik att vi kommer att behöva ett dussin artiklar för att beskriva alla dess tillämpningar. (Det enda som utvecklarna inte lyckades med, som du kan se på bilden nedan, är att skapa en anständig logotyp.)
Den här artikeln beskriver konstruktionen av BPF:s virtuella maskin, kärnans gränssnitt för att arbeta med BPF, utvecklingsverktyg samt en kort, mycket kort, översikt över de befintliga möjligheterna, det vill säga allt som vi kommer att behöva för en djupare förståelse av praktiska tillämpningar av BPF.
Sammanfattning av artikeln
Först kommer vi att se på BPF:s arkitektur från en fågelperspektiv och definiera huvudkomponenterna.
Med en översikt över arkitekturen kommer vi att beskriva konstruktionen av BPF:s virtuella maskin.
I det här avsnittet kommer vi att titta närmare på livscykeln för BPF-objekt — program och mappar.
Med en viss förståelse för systemet kommer vi äntligen att titta på hur man skapar och hanterar objekt från användarrummet med hjälp av en speciell systemanrop — bpf(2).
Att skriva program med hjälp av systemanrop är givetvis möjligt. Men det är svårt. För ett mer realistiskt scenario har kärnutvecklare utvecklat biblioteket libbpf. Vi kommer att skapa ett enkelt skelett för BPF-applikationen som vi kommer att använda i de kommande exemplen.
Här kommer vi att lära oss hur BPF-program kan använda kärnans hjälpfunktioner - ett verktyg som, tillsammans med maps, väsentligt utökar det nya BPF:s kapabiliteter jämfört med den klassiska varianten.
Vid det här laget kommer vi att förstå tillräckligt för att veta hur man skapar program som använder maps. Vi kommer även att få en liten inblick i den stora och mäktiga verifieraren.
En referensdel om hur man samlar de nödvändiga verktygen och kärnan för experiment.
I slutet av artikeln hittar de som har läst dit motiverande ord och en kort beskrivning av vad som kommer i kommande artiklar. Vi kommer också att lista ett antal länkar för självstudier för dem som inte har lust eller möjlighet att vänta på fortsättningen.
Introduktion till BPF-arkitekturen
Innan vi börjar titta på BPF-arkitekturen kommer vi en sista gång (eller kanske inte) att referera till , som utvecklades som ett svar på uppkomsten av RISC-maskiner och löste problemet med effektiv paketfiltrering. Arkitekturen blev så framgångsrik att den, född under de turbulenta nittiotalen i Berkeley UNIX, portades till de flesta existerande operativsystem och har överlevt in i de galna tjugotalen och fortfarande finner nya tillämpningar.
Den nya BPF utvecklades som ett svar på den utbredda användningen av 64-bitarsmaskiner, molntjänster och ökade krav på verktyg för att skapa SDN (Software-defined networking). Utvecklad av nätverksingenjörer som en förbättrad ersättning av den klassiska BPF, fann den nya BPF redan efter sex månader tillämpningar i den svåra konsten att spåra Linux-system, och idag, sex år efter sin ankomst, kommer vi att behöva en hel, kommande, artikel bara för att lista olika typer av program.
VeSöLyaE KaRtiNki
I grunden är BPF en sandboxad virtuell maskin som möjliggör körning av "vilken kod som helst" i kärnans utrymme utan att äventyra säkerheten. BPF-program skapas i användarutrymmet, laddas in i kärnan och kopplas till en viss händelsekälla. En händelse kan vara, till exempel, leveransen av ett paket till ett nätverksgränssnitt, anrop av en viss kärnfunktion, osv. I fallet med paket kommer BPF-programmet att ha tillgång till paketets data och metadata (för läsning och kanske för skrivning, beroende på typen av program), och i fallet med anrop av kärnfunktionen – till funktionens argument, inklusive pekare till kärnans minne, osv.
Låt oss titta på denna process mer ingående. Till att börja med, låt oss diskutera den första skillnaden från klassisk BPF, vars program skrevs på assembler. I den nya versionen har arkitekturen utökats så att program kan skrivas på högre nivåers språk, främst C. För detta har en backend för llvm utvecklats, som möjliggör generering av bytekod för BPF-arkitekturen.
BPF-arkitekturen utvecklades, delvis, för att effektivt köras på moderna maskiner. För att detta ska fungera i praktiken översätts BPF-bytekod, efter att den laddats in i kärnan, till nativ kod med hjälp av en komponent som kallas JIT-kompilator (Just In Time). Som ni kanske minns laddades programmet i klassisk BPF in i kärnan och kopplades till händelsekällan atomärt – i kontexten av ett systemanrop. I den nya arkitekturen sker detta i två steg – först laddas koden in i kärnan med hjälp av ett systemanrop bpf(2), och därefter, senare, kopplas programmet (attaches) till händelsekällan med andra mekanismer, olika beroende på typ av program.
Här kan läsaren ställa sig frågan: Är det verkligen möjligt? Hur säkerställs säkerheten vid körning av sådan kod? Säkerheten garanteras av steget att ladda BPF-program som kallas verifierare (på engelska kallas detta steg verifier och jag kommer att använda det engelska ordet vidare):
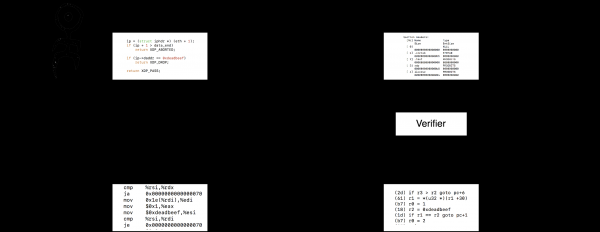
Verifier är en statisk analysator som garanterar att programmet inte stör den normala driften av kärnan. Detta innebär dock inte att programmet inte kan påverka systemets funktion – BPF-program kan, beroende på typ, läsa och skriva till områden i kärnans minne, ändra returvärden för funktioner, trimma, komplettera, skriva över och till och med vidarebefordra nätverkspaket. Verifieraren säkerställer att kärnan inte kraschar vid körning av ett BPF-program och att ett program som enligt reglerna har skrivåtkomst, såsom data från utgående paket, inte kan skriva över kärnans minne utanför paketet. Vi kommer att titta lite mer detaljerat på verifieraren i den relevanta sektionen efter att vi har bekantat oss med alla andra komponenter i BPF.
Så, vad har vi lärt oss vid det här laget? Användaren skriver ett program i C, laddar upp det till kärnan via ett systemanrop bpf(2), där det kontrolleras av verifieraren och översätts till nativ bytekod. Därefter ansluter samma eller en annan användare programmet till en händelsekälla och det börjar köras. Åtskillnad av inladdning och anslutning behövs av flera skäl. För det första, att köra verifieraren är relativt dyrt och genom att ladda samma program flera gånger slösar vi datorns tid. För det andra beror det på hur programmet ansluts på dess typ och en "universell" gränssnitt som utvecklades för ett år sedan kanske inte är lämplig för nya typer av program. (Även om det nu, när arkitekturen blir mer mogen, finns en idé att förena detta gränssnitt på nivån libbpf.)
Den uppmärksamma läsaren kan märka att vi fortfarande inte har avslutat diskussionen om bilder. Och visst, allt som sagts ovan förklarar inte hur BPF principiellt förändrar bilden jämfört med klassisk BPF. Två nyheter som väsentligt utökar tillämpningarna är möjligheten att använda delad minne och kärnfunktioner (kernel helpers). I BPF implementeras delad minne genom så kallade maps — delade datatyper med en specifik API. De fick troligen namnet eftersom den första typen av map som introducerades var en hash-tabell. Därefter kom arrayer, lokala (per-CPU) hash-tabeller och lokala arrayer, sökträd, maps som innehåller pekare till BPF-program och mycket mer. Det som nu intresserar oss är att BPF-program har möjlighet att bevara tillstånd mellan anrop och dela det med andra program samt med användarutrymmet.
Åtkomst till maps sker från användarprocesser genom systemanrop bpf(2), och från BPF-program som körs i kärnan — via kärnfunktioner. Dessutom finns det inte bara helpers för att arbeta med maps, utan också för att få tillgång till andra möjligheter i kärnan. Till exempel kan BPF-program använda kärnfunktioner för att omdirigera paket till andra gränssnitt, generera händelser i perf-subsystemet, få åtkomst till kärnstrukturer och så vidare.
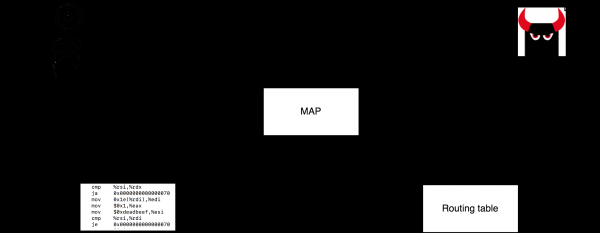
Sammanfattningsvis ger BPF möjlighet att ladda godtycklig, dvs. verifierad kod från användaren till kärnutrymmet. Denna kod kan bevara tillstånd mellan anrop och utbyta data med användarutrymmet, samt har tillgång till de subsystem i kärnan som tillåts för denna typ av program.
Det liknar redan de möjligheter som kärnmoduler erbjuder, jämfört med vilka BPF har vissa fördelar (naturligtvis kan man bara jämföra liknande applikationer, till exempel systemtracing – man kan inte skriva en godtycklig drivrutin för BPF). Man kan notera den lägre inträdeströskeln (vissa verktyg som använder BPF förutsätter inte att användaren har kärnprogrammeringskunskaper, eller ens programmeringskunskaper överhuvudtaget), säkerheten vid körning (räck upp en hand i kommentarerna om du inte har kraschat systemet vid skrivande eller testande av moduler), atomäritet – när moduler laddas om finns det stilleståndstid, medan BPF-systemet garanterar att inga händelser går förlorade (för rättvisans skull, detta gäller inte alla typer av BPF-program).
Att ha sådana möjligheter gör BPF till ett universellt verktyg för att utöka kärnan, vilket bekräftas genom praktiken: allt fler typer av program läggs till BPF, fler stora företag använder BPF på produktionsservrar 24×7, fler startups bygger sina verksamheter kring lösningar baserade på BPF. BPF används överallt: för skydd mot DDoS-attacker, skapande av SDN (till exempel genomförande av nätverk för kubernetes), som huvudverktyg för systemtracing och statistiksamling, i intrångsdetekteringssystem och i sandbox-system, etc.
Låt oss avsluta den översiktliga delen av artikeln och titta på den virtuella maskinen och BPF-ekosystemet mer detaljerat.
Avvikelse: verktyg
För att kunna köra exemplen från de kommande sektionerna kan du behöva ett antal verktyg, minst llvm/clang med stöd för bpf och bpftool. I avsnittet kan du läsa instruktionerna för att bygga verktygen samt din egen kärna. Denna sektion placeras längre ner för att inte störa flödet i vår presentation.
Register och kommandosystem för BPF:s virtuella maskin
Arkitektur och kommandosystem BPF utvecklades med tanke på att program skulle skrivas på C-språket och efter att ha laddats in i kärnan översättas till maskinkod. Därför valdes antalet register och mängden kommandon med beaktande av samspelet, i matematisk mening, mellan moderna maskiners kapabiliteter. Dessutom ställdes olika typer av begränsningar på programmen; till exempel, fram till nyligen fanns det ingen möjlighet att skriva loopar och underprogram, och antalet instruktioner var begränsat till 4096 (nu kan privilegierade program ladda upp till en miljon instruktioner).
I BPF finns det elva tillgängliga 64-bitarsregister för användaren r0—r10 och en programräknare (program counter). Registret r10 innehåller en pekare till stacken (frame pointer) och är endast läsbart. Program får under körning tillgång till en stack på 512 byte och en obegränsad mängd gemensamt minne i form av maps.
Program i BPF får köra en uppsättning hjälpfunktioner (kernel helpers) beroende på programtyp och, nyligen, även vanliga funktioner. Varje anropad funktion kan ta upp till fem argument, som överförs i registren r1—r5, och det returnerade värdet överförs i r0. Det garanteras att efter återgång från funktionen kommer innehållet i registren r6—r9 inte att ändras.
För effektiv översättning av program mappas registren r0—r11 för alla stödda arkitekturer entydigt till verkliga register med beaktande av ABI-specifikationerna för nuvarande arkitektur. Till exempel, för x86_64 registren r1—r5, som används för att överföra funktionsparametrar, mappas till rdi, rsi, rdx, rcx, r8, som används för att överföra parametrar till funktioner på x86_64. Till exempel översätts koden till vänster till koden till höger på följande sätt:
1:  (b7) r1 = 1                    mov    $0x1,%rdi
2:  (b7) r2 = 2                    mov    $0x2,%rsi
3:  (b7) r3 = 3                    mov    $0x3,%rdx
4:  (b7) r4 = 4                    mov    $0x4,%rcx
5:  (b7) r5 = 5                    mov    $0x5,%r8
6:  (85) call pc+1                 callq  0x0000000000001ee8
Registret r0 används också för att returnera resultatet av programkörningen, och i registret r1 skickas en pekare till kontexten — beroende på programtyp kan detta vara, till exempel, en struktur (för XDP) eller strukturen (för olika nätverksprogram) eller strukturen (för olika typer av spårningsprogram) etc.
Så vi hade en uppsättning register, kernel helpers, en stack, en kontextpekare och delat minne i form av maps. Inte för att allt detta var absolut nödvändigt på resan, men…
Låt oss fortsätta beskrivningen och prata om kommandosystemet för att arbeta med dessa objekt. Alla () BPF-instruktioner har en fast storlek på 64 bitar. Om du tittar på en instruktion på en 64-bitars Big Endian-maskin, så kommer du att se

Här Code — detta är instruktionens kodning, Dst/Src — det är kodningarna för mottagaren och källan, respektive, Av — 16-bitars teckenförskjutning, och Imm — det är ett 32-bitars heltal med tecken som används i vissa kommandon (motsvarighet till konstant K från cBPF). Kodningen Code har en av två typer:
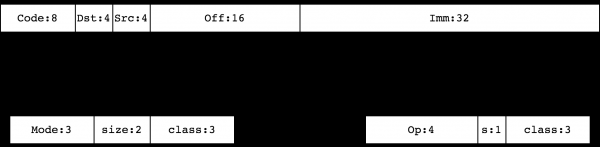
Instruktionsklasser 0, 1, 2, 3 definierar kommandon för att arbeta med minnet. De , BPF_LD, BPF_LDX, BPF_ST, BPF_STX, respektive. Klasserna 4, 7 (BPF_ALU, BPF_ALU64) utgör en uppsättning ALU-instruktioner. Klasserna 5, 6 (BPF_JMP, BPF_JMP32) omfattar instruktioner för villkorssprång.
Den fortsatta planen för att studera BPF-kommandosystemet är att istället för att noggrant lista alla instruktioner och deras parametrar, kommer vi att gå igenom ett par exempel i denna sektion, vilket kommer att klargöra hur instruktioner verkligen fungerar och hur man manuellt disassemblerar vilken binärfil som helst för BPF. För att befästa materialet kommer vi längre fram i artikeln att stöta på individuella instruktioner i sektionerna om Verifier, JIT-kompilatorn, översättning av klassisk BPF, samt när vi studerar maps, anrop av funktioner osv.
När vi pratar om individuella instruktioner, kommer vi att hänvisa till kärnfilerna och , där de numeriska koderna för BPF-instruktioner definieras. Vid självständig studie av arkitekturen och/eller analys av binärer kan du hitta semantiken i följande, sorterade efter svårighetsgrad, källor: , , och naturligtvis i källkoden för Linux — verifier, JIT, BPF-tolk.
Exempel: disassemblera BPF i sinnet
Låt oss gå igenom ett exempel där vi kompilerar programmet readelf-example.c och ser på den resulterande binären. Vi kommer att avslöja det ursprungliga innehållet readelf-example.c nedan, efter att vi har återställt dess logik från de binära koderna:
$ clang -target bpf -c readelf-example.c -o readelf-example.o -O2
$ llvm-readelf -x .text readelf-example.o
Hex dump of section '.text':
0x00000000 b7000000 01000000 15010100 00000000 ................
0x00000010 b7000000 02000000 95000000 00000000 ................
Den första kolumnen i utskriften readelf — detta är indentering och vårt program består således av fyra kommandon:
Kod Dst Src Off  Imm
b7   0   0   0000 01000000
15   0   1   0100 00000000
b7   0   0   0000 02000000
95   0   0   0000 00000000
Kommandokoderna är lika b7, 15, b7 och 95. Vi minns att de tre lägsta bitarna är instruktionens klass. I vårt fall är den fjärde biten tom för alla instruktioner, därför är klasserna lika, det vill säga 7, 5, 7, 5. Klass 7 är BPF_ALU64, och 5 är BPF_JMP. För båda klasserna är formatet för instruktionen detsamma (se ovan) och vi kan skriva om vårt program så här (och vi skriver även om de andra kolumnerna på ett mer begripligt sätt):
Op S  Klass   Dst Src Off  Imm
b  0  ALU64   0   0   0    1
1  0  JMP     0   1   1    0
b  0  ALU64   0   0   0    2
9  0  JMP     0   0   0    0
Operation b klassen ALU64 — detta är . Den tilldelar värdet till mottagarregistret. Om biten s (källa) är inställd, tas värdet från källregistret, och om den, som i vårt fall, inte är inställd, tas värdet från fältet Imm. Så, i den första och tredje instruktionen utför vi operationen r0 = Imm. Därefter är operationen av klass JMP — det är (hoppa om lika). I vårt fall, eftersom biten S är lika med noll, jämför den värdet i källregistret med fältet Imm. Om värdena överensstämmer sker hoppet till PC + Off, där PC, som vanligtvis innehåller adressen till nästa instruktion. Slutligen är operationen av klass JMP 9 — det är . Denna instruktion avslutar programmets körning och returnerar till kärnan r0. Låt oss lägga till en ny kolumn i vår tabell:
Op    S  Klass   Dst Src Off  Imm    Disassm
MOV   0  ALU64   0   0   0    1      r0 = 1
JEQ   0  JMP     0   1   1    0      if (r1 == 0) goto pc+1
MOV   0  ALU64   0   0   0    2      r0 = 2
EXIT  0  JMP     0   0   0    0      exit
Vi kan skriva om detta på ett mer bekvämt sätt:
     r0 = 1
     if (r1 == 0) goto END
     r0 = 2
END:
     exit
Om vi minns att registret r1 till programmet överför en pekare till kontexten från kärnan, och registret r0 returnerar värdet till kärnan, så kan vi se att om pekaren till kontexten är lika med noll, så returnerar vi 1, annars returnerar vi 2. Låt oss kontrollera att vi har rätt genom att titta på källkoden:
$ cat readelf-example.c
int foo(void *ctx)
{
        return ctx ? 2 : 1;
}
Ja, detta är ett meningslöst program, men det kompileras till bara fyra enkla instruktioner.
Exempel på undantag: 16-byte instruktion
Tidigare nämnde vi att vissa instruktioner tar mer än 64 bitar. Detta gäller till exempel instruktionen lddw (Kod = 0x18 = | | ) — att läsa ett dubbelt ord i registret från fälten Imm. Saken är den att Imm har en storlek på 32, och ett dubbelt ord är 64 bitar, så att ladda en 64-biters direktvärde i ett register i en enda 64-bitars instruktion är inte möjligt. För detta används två intilliggande instruktioner för att lagra den andra delen av det 64-bitarsvärdet i fältet Imm. Exempel:
$ cat x64.c
long foo(void *ctx)
{
        return 0x11223344aabbccdd;
}
$ clang -target bpf -c x64.c -o x64.o -O2
$ llvm-readelf -x .text x64.o
Hex dump of section '.text':
0x00000000 18000000 ddccbbaa 00000000 44332211 ............D3".
0x00000010 95000000 00000000                   ........
I det binära programmet finns det endast två instruktioner:
Binär                                 Disassm
18000000 ddccbbaa 00000000 44332211    r0 = Imm[0]|Imm[1]
95000000 00000000                      exit
Vi kommer att stöta på instruktionen lddw, när vi pratar om omplaceringar och arbete med maps.
Exempel: disassemblera BPF med standardverktyg
Så vi har lärt oss att läsa BPF-binära koder och är redo att analysera vilken instruktion som helst, om det behövs. Men det är värt att nämna att det är mer praktiskt och snabbare att disassemblera program med hjälp av standardverktyg, till exempel:
$ llvm-objdump -d x64.o

Disassembly of section .text:

0000000000000000 :
 0: 18 00 00 00 dd cc bb aa 00 00 00 00 44 33 22 11 r0 = 1234605617868164317 ll
 2: 95 00 00 00 00 00 00 00 exit
Livscykeln för BPF-objekt, filsystemet bpffs
(Vissa detaljer som beskrivs i detta avsnitt fick jag veta för första gången från Alexei Starovoitov på .)
BPF-objekt — program och maps — skapas från användarutrymmet med hjälp av kommandon BPF_PROG_LOAD och BPF_MAP_CREATE systemanropet bpf(2), ska vi prata om hur detta exakt går till i nästa avsnitt. Under detta skapas datakonstruktioner i kärnan och för var och en av dem refcount (referensräknare) sätts till ett, och användaren får tillbaka en filbeskrivare som pekar på objektet. När filbeskrivaren stängs refcount minskas objektets räknare med ett, och när den når noll förstörs objektet.
Om programmet använder maps, så refcount ökar referensen för dessa maps med ett efter att programmet laddats, det vill säga att deras filbeskrivare kan stängas från användarprocessen och samtidigt refcount inte blir noll:
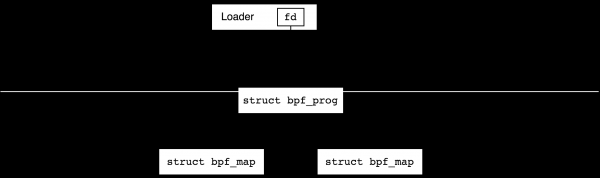
Efter att programmet har laddats framgångsrikt kopplar vi vanligtvis det till någon händelsegenerator. Till exempel kan vi koppla det till ett nätverksgränssnitt för att bearbeta inkommande paket eller koppla det till något tracepoint i kärnan. Vid denna tidpunkt ökar också referensräknaren med ett och vi kan stänga filbeskrivaren i laddningsprogrammet.
Vad händer om vi nu avslutar bootloaderns arbete? Det beror på typen av händelsegenerator (hook). Alla nätverks-hooks kommer att finnas kvar efter att bootloadern avslutats, de så kallade globala hooks. Program för spårning, å andra sidan, kommer att frigöras efter att processen som skapade dem avslutats (och därför kallas de lokala, av "local to the process"). Tekniskt sett har lokala hooks alltid en motsvarande filbeskrivare i användarutrymmet och stängs därför med stängning av processen, medan globala hooks inte gör det. På nästa bild försöker jag med röda kryss visa hur avslutningen av bootloaderprogrammet påverkar livslängden på objekt i fall av lokala och globala hooks.
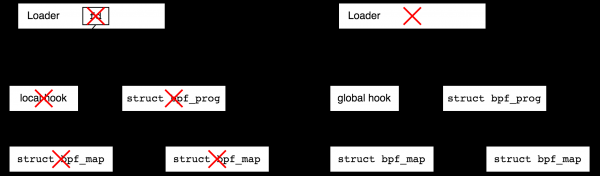
Varför finns det en uppdelning mellan lokala och globala hooks? Att köra vissa typer av nätverksprogram är meningsfullt även utan användarutrymme, till exempel, föreställ dig skydd mot DDoS – bootloadern skriver regler och kopplar ett BPF-program till nätverksgränssnittet, varefter bootloadern kan avsluta sig själv. Å andra sidan, föreställ dig ett avlusningsprogram för spårning som du skrivit snabbt på tio minuter – efter att det avslutats skulle du vilja att systemet inte lämnar skräp, och lokala hooks garanterar detta.
Å andra sidan, föreställ dig att du vill ansluta till tracepoint i kärnan och samla statistik under många år. I det här fallet skulle du vilja avsluta användardelen och återkomma till statistiken då och då. Denna möjlighet erbjuds av filsystemet bpf. Det är ett pseudo-filsystem som endast existerar i minnet, vilket gör att du kan skapa filer som refererar till BPF-objekt och därmed förlänger refcount objektens livslängd. Efter det kan bootloadern avsluta sitt arbete, medan de skapade objekten förblir kvar.
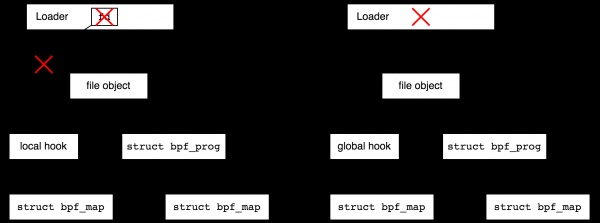
Att skapa filer i bpffs som refererar till BPF-objekt kallas "pinna" ("pin", som i nästa fras: "process can pin a BPF program or map"). Att skapa filobjekt för BPF-objekt är meningsfullt inte bara för att förlänga livslängden på lokala objekt, utan även för att underlätta användningen av globala objekt – för att återgå till exemplet med det globala DDoS-skyddsprogrammet, vi vill ha möjlighet att då och då besöka och titta på statistiken.
BPF-filsystemen monteras vanligtvis i /sys/fs/bpf, men den kan också monteras lokalt, till exempel så här:
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Namnen i filsystmet skapas med kommandot BPF_OBJ_PIN systemanropet BPF. Som exempel låt oss ta ett program, kompilera det, ladda det och fästa det i bpffs. Vårt program gör ingenting användbart, vi ger bara dess kod så att du kan återskapa exemplet:
$ cat test.c
__attribute__((section("xdp"), used))
int test(void *ctx)
{
        return 0;
}

char _license[] __attribute__((section("license"), used)) = "GPL";
Vi kommer att kompilera detta program och skapa en lokal kopia av filsystmet bpffs:
$ clang -target bpf -c test.c -o test.o
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Nu laddar vi vårt program med hjälp av verktyget bpftool och tittar på de relaterade systemanropen bpf(2) (vissa irrelevanta rader har tagits bort från strace-utdata):
$ sudo strace -e bpf bpftool prog load .\/test.o bpf-mountpoint\/test
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="test", ...}, 120) = 3
bpf(BPF_OBJ_PIN, {pathname="bpf-mountpoint\/test", bpf_fd=3}, 120) = 0
Här laddade vi programmet med hjälp av BPF_PROG_LOAD, fick en filbeskrivare från kärnan 3 och med hjälp av kommandot BPF_OBJ_PIN fäste vi denna filbeskrivare som en fil "bpf-mountpoint\/test". Efter detta avslutade laddningsprogrammet bpftool sitt arbete, men vårt program kvarstod i kärnan, även om vi inte kopplade det till någon nätverksgränssnitt:
$ sudo bpftool prog | tail -3
783: xdp  name test  tag 5c8ba0cf164cb46c  gpl
        loaded_at 2020-05-05T13:27:08+0000  uid 0
        xlated 24B  jited 41B  memlock 4096B
Vi kan ta bort filobjektet med en vanlig unlink(2) och efter det kommer motsvarande program att tas bort:
$ sudo rm .\/bpf-mountpoint\/test
$ sudo bpftool prog show id 783
Error: get by id (783): No such file or directory
Borttagning av objekt
När vi talar om att ta bort objekt måste vi klargöra att efter att vi har kopplat bort programmet från hooken (händelsegeneratorn) kommer inga nya händelser att leda till att det startas, men alla aktuella instanser av programmet kommer att avslutas korrekt.
Vissa typer av BPF-program tillåter att programmet byts ut i farten, dvs. ger atomär funktionalitet i sekvensen replace = koppla bort gammalt program, koppla på nytt program. Här betyder atomaritet att inga händelser kommer att missas.
Anslutning av program till händelsekällor
I den här artikeln kommer vi inte att beskriva anslutningen av program till händelsekällor separat, eftersom det är mer meningsfullt att studera det i samband med en specifik typ av program. Se nedan, där vi visar hur program av typen XDP ansluts.
Hantera objekt med systemanropet bpf
BPF-program
Alla BPF-objekt skapas och hanteras från användarrummet med hjälp av systemanropet bpf, som har följande prototyp:
#include <linux/bpf.h>

int bpf(int cmd, union bpf_attr *attr, unsigned int size);
Här är kommandot cmd — det är ett av värdena av typen , attr — en pekare till parametrarna för det specifika programmet och size — storleken på objektet pekaren pekar på, det vill säga vanligtvis sizeof(*attr). I kärnan 5.8 stöder systemanropet bpf 34 olika kommandon, och union bpf_attr tar upp 200 rader. Men vi ska inte låta detta skrämma oss, eftersom vi kommer att bekanta oss med kommandon och parametrar under flera artiklar.
Vi börjar med kommandot BPF_PROG_LOAD, som skapar BPF-program — tar en uppsättning BPF-instruktioner och laddar in den i kärnan. Vid laddning aktiveras verifieraren, och sedan JIT-kompilatorn och, efter att den har utfört framgångsrikt, returneras en filbeskrivare för programmet till användaren. Vi såg vad som hände med det i avsnittet tidigare .
Nu ska vi skriva ett användarprogram som laddar ett enkelt BPF-program, men först måste vi bestämma vilket program vi vill ladda — vi måste välja och inom denna typ skriva ett program som klarar verifierarens kontroller. För att inte komplicera processen, här är en färdig lösning: vi tar ett program av typen BPF_PROG_TYPE_XDP, som kommer att returnera värdet XDP_PASS (skippa alla paket). I BPF assembly ser det väldigt enkelt ut:
r0 = 2
exit
När vi har bestämt oss för vad vi ska ladda kan vi berätta hur vi ska göra det: vad Intressanta händelser i programmet börjar med definitionen av en array
#define _GNU_SOURCE
#include <string.h>
#include <unistd.h>
#include <sys/syscall.h>
#include <linux/bpf.h>

static inline __u64 ptr_to_u64(const void *ptr)
{
        return (__u64) (unsigned long) ptr;
}

int main(void)
{
    struct bpf_insn insns[] = {
        {
            .code = BPF_ALU64 | BPF_MOV | BPF_K,
            .dst_reg = BPF_REG_0,
            .imm = XDP_PASS
        },
        {
            .code = BPF_JMP | BPF_EXIT
        },
    };

    union bpf_attr attr = {
        .prog_type = BPF_PROG_TYPE_XDP,
        .insns     = ptr_to_u64(insns),
        .insn_cnt  = sizeof(insns)/sizeof(insns[0]),
        .license   = ptr_to_u64("GPL"),
    };

    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
insns — vårt BPF-program i maskinkod. Varje instruktion i BPF-programmet packas i en struktur bpf_insn motsvarar instruktionen — vårt BPF-program i maskinkod. Varje instruktion i BPF-programmet packas i en struktur r0 = 2 En anmärkning., den andra — exit.
I kärnan finns mer användarvänliga makron för att skriva maskinkoder, och genom att använda kärnans headerfil tools/include/linux/filter.h skulle vi kunna skriva struct bpf_insn insns[] = { BPF_MOV64_IMM(BPF_REG_0, XDP_PASS), BPF_EXIT_INSN() };
struct bpf_insn insns[] = {
    BPF_MOV64_IMM(BPF_REG_0, XDP_PASS),
    BPF_EXIT_INSN()
};
Men eftersom skrivning av BPF-program i maskinkoder endast är nödvändig för att skriva tester i kärnan och artiklar om BPF, gör avsaknaden av dessa makron faktiskt inte livet svårare för utvecklaren.
Efter att BPF-programmet har definierats går vi vidare till att ladda det i kärnan. Vårt minimalistiska sett av parametrar attr innehåller programtyp, uppsättning och mängd instruktioner, obligatorisk licens samt namn "woo", som vi använder för att hitta vårt program i systemet efter att det har laddats. Programmet, som lovat, laddas in i systemet med hjälp av ett systemanrop bpf.
I slutet av programmet hamnar vi i en oändlig loop som imiterar nyttolasten. Utan den kommer programmet att förstöras av kärnan vid stängning av filbeskrivaren som systemanropet returnerade till oss, bpf, och vi kommer inte att se det i systemet.
Nåväl, vi är redo för testning. Låt oss kompilera och köra programmet under för att kontrollera paketöverföringen åt båda håll, för att kontrollera att allt fungerar som det ska:
$ clang -g -O2 simple-prog.c -o simple-prog

$ sudo strace ./simple-prog
execve("./simple-prog", ["./simple-prog"], 0x7ffc7b553480 /* 13 vars */) = 0
...
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0x7ffe03c4ed50, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(0, 0, 0), prog_flags=0, prog_name="woo", prog_ifindex=0, expected_attach_type=BPF_CGROUP_INET_INGRESS}, 72) = 3
pause(
Allt ser bra ut, bpf(2) vi fick tillbaka deskriptor 3 och vi gick in i en oändlig loop med pause(). Låt oss försöka hitta vårt program i systemet. För att göra det går vi till en annan terminal och använder verktyget bpftool:
# bpftool prog | grep -A3 woo
390: xdp  name woo  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-31T24:66:44+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        pids simple-prog(10381)
Vi ser att det finns ett laddat program i systemet woo vars globala ID är 390, och att det för närvarande finns en öppen filbeskrivare i processen simple-prog som pekar på programmet (och om simple-prog det avslutas, kommer det woo att försvinna). Som förväntat tar programmet woo upp 16 byte – två instruktioner – av binärkod i BPF-arkitekturen, men i sitt ursprungliga format (x86_64) är det redan 40 byte. Låt oss titta på vårt program i sitt ursprungliga skick:
# bpftool prog dump xlated id 390
   0: (b7) r0 = 2
   1: (95) exit
utan överraskningar. Nu låt oss titta på koden som skapades av JIT-kompilatorn:
# bpftool prog dump jited id 390
bpf_prog_3b185187f1855c4c_woo:
   0:   nopl   0x0(%rax,%rax,1)
   5:   push   %rbp
   6:   mov    %rsp,%rbp
   9:   sub    $0x0,%rsp
  10:   push   %rbx
  11:   push   %r13
  13:   push   %r14
  15:   push   %r15
  17:   pushq  $0x0
  19:   mov    $0x2,%eax
  1e:   pop    %rbx
  1f:   pop    %r15
  21:   pop    %r14
  23:   pop    %r13
  25:   pop    %rbx
  26:   leaveq
  27:   retq
inte särskilt effektivt för exit(2), men för rättvisans skull, vårt program är alltför enkelt, och för icke-triviala program är prolog och epilog som JIT-kompilatorn lägger till självklart nödvändiga.
Maps
BPF-program kan använda strukturerade minnesområden som är tillgängliga både för andra BPF-program och för program från användarutrymmet. Dessa objekt kallas map och i detta avsnitt visar vi hur man hanterar dem med hjälp av systemanrop. bpf.
Låt oss snabbt säga att map-funktioner inte bara begränsas till åtkomst till delat minne. Det finns speciella mappar som innehåller exempelvis pekare till BPF-program eller pekare till nätverksgränssnitt, mappar för att arbeta med perf-händelser osv. Här kommer vi inte att prata om dem för att inte förvirra läsaren. Dessutom ignorerar vi synkroniseringsproblem eftersom det inte är viktigt för våra exempel. En fullständig lista över tillgängliga typer av mappar finns i , och i detta avsnitt tar vi som exempel den historiskt första typen, hash-tabellen. BPF_MAP_TYPE_HASH.
Om du skapar en hash-tabell, låt oss säga i C++, skulle du säga unordered_map woo, vilket på svenska betyder "jag behöver en tabell woo utan begränsning i storlek, där nycklar har typ int, och värden är av typ long'. För att skapa en BPF-hash-tabell måste vi göra ungefär samma sak, med den justeringen att vi måste ange den maximala storleken för tabellen, och istället för typerna av nycklar och värden måste vi ange deras storlekar i byte. För att skapa mappar används kommandot BPF_MAP_CREATE systemanropet bpf. Låt oss titta på ett mer eller mindre minimalt program som skapar en map. Efter det föregående programmet som laddar BPF-programmet bör detta verka enkelt:
$ cat simple-map.c
#define _GNU_SOURCE
#include
#include
#include
#include

int main(void)
{
    union bpf_attr attr = {
        .map_type = BPF_MAP_TYPE_HASH,
        .key_size = sizeof(int),
        .value_size = sizeof(int),
        .max_entries = 4,
    };
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));

    for (;;)
        pause();
}
Här definierar vi en uppsättning parametrar attr, där vi säger "jag behöver en hash-tabell med nycklar och värden av storleken sizeof(int), där jag kan lägga högst fyra element." Vid skapandet av BPF-mappar kan man ange andra parametrar, exempelvis, precis som i exemplet med programmet, angav vi objektets namn som "woo".
Vi kompilerar och kör programmet:
$ clang -g -O2 simple-map.c -o simple-map
$ sudo strace ./simple-map
execve("./simple-map", ["./simple-map"], 0x7ffd40a27070 /* 14 vars */) = 0
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_HASH, key_size=4, value_size=4, max_entries=4, map_name="woo", ...}, 72) = 3
pause(
Här är systemanropet bpf(2) gav oss descriptorn för mappen nummer 3 och programmet väntar, som förväntat, på vidare instruktioner i systemanropet pause(2).
Nu skickar vi vårt program till bakgrunden eller öppnar en annan terminal för att titta på vårt objekt med hjälp av verktyget bpftool (vi kan särskilja vår mapp från andra genom dess namn):
$ sudo bpftool map
...
114: hash  name woo  flags 0x0
        key 4B  value 4B  max_entries 4  memlock 4096B
...
Numret 114 är vårt objekts globala ID. Alla program i systemet kan använda detta ID för att öppna den redan existerande mappen med kommandot BPF_MAP_GET_FD_BY_ID systemanropet bpf.
Nu kan vi leka med vår hash-tabell. Låt oss titta på dess innehåll:
$ sudo bpftool map dump id 114
Found 0 elements
Tomt. Låt oss lägga till ett värde hash[1] = 1:
$ sudo bpftool map update id 114 key 1 0 0 0 value 1 0 0 0Låt oss granska tabellen igen:
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
Found 1 element
Hurrra! Vi lyckades lägga till ett element. Observera att vi måste arbeta på byte-nivå, eftersom bpftool inte vet vilken typ värdena i hash-tabellen har. (Det går att ge den denna information via BTF, men inte nu.)
Hur läser och lägger bpftool till element? Låt oss kika under huven:
$ sudo strace -e bpf bpftool map dump id 114
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=NULL, next_key=0x55856ab65280}, 120) = 0
bpf(BPF_MAP_LOOKUP_ELEM, {map_fd=3, key=0x55856ab65280, value=0x55856ab652a0}, 120) = 0
key: 01 00 00 00  value: 01 00 00 00
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=0x55856ab65280, next_key=0x55856ab65280}, 120) = -1 ENOENT
Först öppnade vi mappen med dess globala ID via kommandot BPF_MAP_GET_FD_BY_ID och bpf(2) gav oss descriptorn 3. Därefter använde vi kommandot BPF_MAP_GET_NEXT_KEY vi hittade den första nyckeln i tabellen genom att skicka NULL en pekare till "föregående" nyckel. När vi har en nyckel kan vi göra BPF_MAP_LOOKUP_ELEM, vilket returnerar värdet i pekaren value. Nästa steg är att vi försöker hitta nästa element genom att skicka pekaren till den aktuella nyckeln, men vår tabell innehåller bara ett element, och kommandot BPF_MAP_GET_NEXT_KEY återvänder ENOENT.
Okej, låt oss ändra värdet för nyckel 1, säg att vår affärslogik kräver att skriva hash[1] = 2:
$ sudo strace -e bpf bpftool map update id 114 key 1 0 0 0 value 2 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x55dcd72be260, value=0x55dcd72be280, flags=BPF_ANY}, 120) = 0
Som förväntat är det mycket enkelt: kommandot BPF_MAP_GET_FD_BY_ID öppnar vår mapp via ID, och kommandot BPF_MAP_UPDATE_ELEM överskriver elementet.
Så, efter att ha skapat en hash-tabell från ett program kan vi läsa och skriva dess innehåll från ett annat. Observera att om vi kunde göra detta från kommandoraden, kan vilket annat program som helst i systemet också göra det. Förutom kommandona som beskrivits ovan är följande kommandon tillgängliga för att arbeta med kartor från användarutrymmet :
BPF_MAP_LOOKUP_ELEM: hitta värde efter nyckelBPF_MAP_UPDATE_ELEM: uppdatera/skapa värdeBPF_MAP_DELETE_ELEM: ta bort nyckelBPF_MAP_GET_NEXT_KEY: hitta nästa (eller första) nyckelBPF_MAP_GET_NEXT_ID: gör det möjligt att iterera över alla befintliga kartor, så här fungerarbpftool mapBPF_MAP_GET_FD_BY_ID: öppna en befintlig karta via dess globala IDBPF_MAP_LOOKUP_AND_DELETE_ELEM: atomärt uppdatera objektets värde och returnera det gamlaBPF_MAP_FREEZE: gör en karta oföränderlig från användarutrymmet (denna operation kan inte ångras)BPF_MAP_LOOKUP_BATCH,BPF_MAP_LOOKUP_AND_DELETE_BATCH,BPF_MAP_UPDATE_BATCH,BPF_MAP_DELETE_BATCH: massoperationer. Till exempel,BPF_MAP_LOOKUP_AND_DELETE_BATCH— det är det enda pålitliga sättet att läsa och nollställa alla värden i en karta
Inte alla dessa kommandon fungerar för alla typer av kartor, men generellt sett ser arbetet med andra typer av kartor från användarutrymmet precis likadant ut som arbetet med hash-tabeller.
För ordningens skull, låt oss avsluta våra experiment med hash-tabellen. Kom ihåg att vi skapade en tabell som kan innehålla upp till fyra nycklar? Låt oss lägga till några fler element:
$ sudo bpftool map update id 114 key 2 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 3 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 4 0 0 0 value 1 0 0 0
Hittills så bra:
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
key: 02 00 00 00  value: 01 00 00 00
key: 04 00 00 00  value: 01 00 00 00
key: 03 00 00 00  value: 01 00 00 00
Hittade 4 element
Låt oss försöka lägga till en till:
$ sudo bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
Error: update failed: Argument list too long
Som förväntat lyckades vi inte. Låt oss titta närmare på felet:
$ sudo strace -e bpf bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_OBJ_GET_INFO_BY_FD, {info={bpf_fd=3, info_len=80, info=0x7ffe6c626da0}}, 120) = 0
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x56049ded5260, value=0x56049ded5280, flags=BPF_ANY}, 120) = -1 E2BIG (Argument list too long)
Error: update failed: Argument list too long
+++ exited with 255 +++
Allt i ordning: som förväntat försöker kommandot BPF_MAP_UPDATE_ELEM skapa en ny, femte nyckel, men misslyckas med E2BIG.
Så, vi kan skapa och ladda upp BPF-program samt skapa och hantera maps från användarutrymmet. Nu är det logiskt att titta på hur vi kan använda maps från själva BPF-programmen. Vi skulle kunna berätta om detta på ett sätt som är svårt att läsa med maskinkod-makron, men det är dags att visa hur man faktiskt skriver och underhåller BPF-program — med hjälp av libbpf.
(För läsare som är missnöjda med avsaknaden av en lågnivåexempel: vi kommer att gå igenom program som använder maps och hjälpfunktioner skapade med hjälp av libbpf och berätta vad som händer på instruktionernas nivå. För läsare som är missnöjda med mycket, vi har lagt till i den relevanta delen av artikeln.)
Skriva BPF-program med libbpf
Att skriva BPF-program med maskinkod kan verka intressant till en början, men sen kommer mättnaden. I det ögonblicket bör man rikta sin uppmärksamhet mot llvm, som har en backend för kodgenerering för BPF-arkitekturen, samt på biblioteket libbpf, vilket låter en skriva den användardel av BPF-applikationer och ladda upp BPF-programkoden som genererats med hjälp av llvm/clang.
I själva verket, som vi kommer att se i denna och kommande artiklar, libbpf gör ganska mycket arbete och utan det (eller liknande verktyg — iproute2, libbcc, libbpf-go, osv.) går det inte att leva. En av killer-funktionerna i projektet libbpf är BPF CO-RE (Compile Once, Run Everywhere) — ett projekt som möjliggör att skriva BPF-program som är portabla från en kärna till en annan, med möjlighet till körning på olika API (till exempel när kärnans struktur ändras från version till version). För att kunna arbeta med CO-RE måste din kärna vara kompilerad med stöd för BTF (hur man gör detta beskrivs i avsnittet . Man kan enkelt kontrollera om ens kärna är byggd med BTF eller inte — genom att kolla på följande fil:
$ ls -lh /sys/kernel/btf/vmlinux
-r--r--r-- 1 root root 2.6M Jul 29 15:30 /sys/kernel/btf/vmlinux
Denna fil innehåller information om alla datatyper som används i kärnan och används i alla våra exempel som använder libbpf. Vi kommer att gå in på CO-RE mer detaljerat i nästa artikel, men i denna — bygg bara din kärna med CONFIG_DEBUG_INFO_BTF.
Bibliotek libbpf som finns direkt i katalogen tools/lib/bpf i kärnan och dess utveckling sker via mailinglistan bpf@vger.kernel.org. Men för behov av applikationer som lever utanför kärnan stöds ett separat lager. där kärnan biblioteket speglas för läsåtkomst mer eller mindre som det är.
I det här avsnittet kommer vi att titta på hur man kan skapa ett projekt som använder libbpf, vi kommer att skriva några (mer eller mindre meningslösa) testprogram och vi kommer att gå igenom hur allt fungerar. Detta kommer att hjälpa oss att i nästa avsnitt enklare förklara hur BPF-program interagerar med maps, kernel helpers, BTF osv.
Vanligtvis lägger projekt som använder libbpf ett GitHub-repo som ett git-submodul, låt oss göra det också:
$ mkdir /tmp/libbpf-example
$ cd /tmp/libbpf-example/
$ git init-db
Initierad tom Git-repo i /tmp/libbpf-example/.git/
$ git submodule add https://github.com/libbpf/libbpf.git
Klonar in i '/tmp/libbpf-example/libbpf'...
remote: Enumererar objekt: 200, klart.
remote: Räkning av objekt: 100% (200/200), klart.
remote: Komprimerar objekt: 100% (103/103), klart.
remote: Totalt 3354 (delta 101), återanvänd 118 (delta 79), packåteranvänd 3154
Mottar objekt: 100% (3354/3354), 2.05 MiB | 10.22 MiB/s, klart.
Löser deltan: 100% (2176/2176), klart.
Byggs libbpf väldigt enkelt:
$ cd libbpf/src
$ mkdir build
$ OBJDIR=build DESTDIR=root make -s install
$ find root
root
root/usr
root/usr/include
root/usr/include/bpf
root/usr/include/bpf/bpf_tracing.h
root/usr/include/bpf/xsk.h
root/usr/include/bpf/libbpf_common.h
root/usr/include/bpf/bpf_endian.h
root/usr/include/bpf/bpf_helpers.h
root/usr/include/bpf/btf.h
root/usr/include/bpf/bpf_helper_defs.h
root/usr/include/bpf/bpf.h
root/usr/include/bpf/libbpf_util.h
root/usr/include/bpf/libbpf.h
root/usr/include/bpf/bpf_core_read.h
root/usr/lib64
root/usr/lib64/libbpf.so.0.1.0
root/usr/lib64/libbpf.so.0
root/usr/lib64/libbpf.a
root/usr/lib64/libbpf.so
root/usr/lib64/pkgconfig
root/usr/lib64/pkgconfig/libbpf.pc
Vår vidare plan i detta avsnitt är följande: vi kommer att skriva ett BPF-program av typen BPF_PROG_TYPE_XDP, samma som i det föregående exemplet, men i C, kompilera det med clang, och skriva ett hjälpprogram som kommer att ladda det i kärnan. I följande avsnitt kommer vi att utöka funktionaliteten både i BPF-programmet och hjälpprogrammet.
Exempel: skapa en komplett applikation med libbpf
Till att börja med kommer vi att använda filen /sys/kernel/btf/vmlinux, som omnämndes ovan, och skapa dess motsvarande version som en headerfil:
$ bpftool btf dump file /sys/kernel/btf/vmlinux format c > vmlinux.hI den här filen kommer alla datatyper som finns i vår kärna att lagras, till exempel definieras IPv4-headern i kärnan så här:
$ grep -A 12 'struct iphdr {' vmlinux.h
struct iphdr {
    __u8 ihl: 4;
    __u8 version: 4;
    __u8 tos;
    __be16 tot_len;
    __be16 id;
    __be16 frag_off;
    __u8 ttl;
    __u8 protocol;
    __sum16 check;
    __be32 saddr;
    __be32 daddr;
};
Nu kommer vi att skriva vårt BPF-program i C:
$ cat xdp-simple.bpf.c
#include "vmlinux.h"
#include

SEC("xdp/simple")
int simple(void *ctx)
{
        return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Även om vårt program blev väldigt enkelt, måste vi ändå uppmärksamma många detaljer. För det första är den första headerfilen vi inkluderar vmlinux.h, som vi just har genererat med hjälp av bpftool btf dump — nu behöver vi inte installera paketet kernel-headers för att ta reda på hur kärnans strukturer ser ut. Nästa headerfil kommer från biblioteket libbpf. Just nu behöver vi det bara för att definiera makrot SEC, som skickar symbolen till rätt sektion i ELF-objektfilen. Vårt program ligger i sektionen xdp/simple, där vi före snedstrecket definierar typen av BPF-program — detta är en konvention som används i libbpf, baserat på sektionens namn kommer det att ställa in rätt typ vid körning bpf(2). Själva BPF-programmet i C — är mycket enkelt och består av en rad return XDP_PASS. Slutligen innehåller den separata sektionen "license" namnet på licensen.
Vi kan kompilera vårt program med hjälp av llvm/clang, version >= 10.0.0, helst ännu högre (se avsnittet ):
$ clang --version
clang version 11.0.0 (https://github.com/llvm/llvm-project.git afc287e0abec710398465ee1f86237513f2b5091)
...

$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
Bland de intressanta funktionerna specificerar vi måarchitekturen -target bpf och vägen till headerfilerna libbpf, som vi nyligen har installerat. Kom också ihåg -O2, utan det här alternativet kan du förvänta dig överraskningar senare. Låt oss titta på vår kod, lyckades vi skriva det program vi ville?
$ llvm-objdump --section=xdp/simple --no-show-raw-insn -D xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Disassembly of section xdp/simple:

0000000000000000 :
       0:       r0 = 2
       1:       exit
Ja, det lyckades! Nu har vi en binärfil med programmet, och vi vill skapa en applikation som kommer att ladda den in i kärnan. För detta erbjuder biblioteket libbpf oss olika alternativ – antingen använda ett lägre nivå-API eller ett högre nivå-API. Vi väljer den andra vägen, eftersom vi vill lära oss att skriva, ladda och ansluta BPF-program med minimal ansträngning för vidare studier.
För att börja med måste vi generera en "skelett" av vårt program från dess binärfil med hjälp av samma verktyg bpftool — den schweiziska armén BPF (vilket kan förstås bokstavligt, eftersom Daniel Borkman är en av skaparna och underhållarna av BPF — schweizare):
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.hI filen xdp-simple.skel.h innehåller binärkoden för vårt program samt funktioner för att hantera — ladda, ansluta, radera vårt objekt. I vårt enkla fall verkar detta överdrivet, men det fungerar även när objektfilen innehåller många BPF-program och kartor; för att ladda denna gigantiska ELF räcker det med att generera skelettet och kalla på en till två funktioner från användarapplikationen, som vi nu kommer att skriva.
Faktiskt är vårt laddningsprogram trivialt:
#include <err.h>
#include <unistd.h>
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    pause();

    xdp_simple_bpf__destroy(obj);
}
Här struct xdp_simple_bpf definieras i filen xdp-simple.skel.h och beskriver vår objektfil:
struct xdp_simple_bpf {
    struct bpf_object_skeleton *skeleton;
    struct bpf_object *obj;
    struct {
        struct bpf_program *simple;
    } progs;
    struct {
        struct bpf_link *simple;
    } links;
};
Vi kan här märka spår av lågnivå-API:et: strukturen struct bpf_program *simple och struct bpf_link *simple. Den första strukturen beskriver specifikt vårt program, som är skrivet i sektionen xdp/simple, och den andra beskriver hur programmet kopplas till händelsekällan.
Funktionen xdp_simple_bpf__open_and_load, öppnar ELF-objektet, parsar det, skapar alla strukturer och understrukturer (förutom programmet finns andra sektioner i ELF — data, read-only data, debuginformation, licens osv.), och laddar det sedan till kärnan via systemanropet bpf, vilket vi kan kontrollera genom att kompilera och köra programmet:
$ clang -O2 -I ./libbpf/src/root/usr/include/ xdp-simple.c -o xdp-simple ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz

$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_BTF_LOAD, 0x7ffdb8fd9670, 120)  = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0xdfd580, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(5, 8, 0), prog_flags=0, prog_name="simple", prog_ifindex=0, expected_attach_type=0x25 /* BPF_??? */, ...}, 120) = 4
Låt oss nu titta på vårt program med hjälp av bpftool. Vi hittar dess ID:
# bpftool p | grep -A4 simple
463: xdp  name simple  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-01T01:59:49+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        btf_id 185
        pids xdp-simple(16498)
och dumpa den (vi använder den förkortade formen av kommandot bpftool prog dump xlated):
# bpftool p d x id 463
int simple(void *ctx):
; return XDP_PASS;
   0: (b7) r0 = 2
   1: (95) exit
Något nytt! Programmet skrev ut delar av vår källkod på C-språket. Detta gjordes av biblioteket libbpf, som hittade debugsektionen i binären, kompilerade den till ett BTF-objekt, laddade det till kärnan med hjälp av BPF_BTF_LOAD, och angav sedan den erhållna filbeskrivaren vid laddningen av programmet genom kommandot BPG_PROG_LOAD.
Kernel Helpers
BPF-program kan köra "externa" funktioner – kernel helpers. Dessa hjälpfunktioner tillåter BPF-program att få åtkomst till kärnstrukturer, hantera maps och kommunicera med "den verkliga världen" – skapa perf events, hantera hårdvara (t.ex. omdirigera paket) osv.
Exempel: bpf_get_smp_processor_id
Inom ramen för paradigmet "lärande genom exempel", låt oss titta på en av hjälp-funktionerna, bpf_get_smp_processor_id(), i filen kernel/bpf/helpers.c. Den returnerar numret på den processor som kör det anropande BPF-programmet. Men vi är inte intresserade av dess semantik, utan av att dess implementering tar en rad:
BPF_CALL_0(bpf_get_smp_processor_id)
{
    return smp_processor_id();
}
Definitionerna av BPF-hjälpfunktioner liknar definitionerna av systemanrop i Linux. Här definieras exempelvis en funktion utan argument. (En funktion som tar tre argument definieras med makrot BPF_CALL_3. Det maximala antalet argument är fem.) Men detta är bara den första delen av definitionen. Den andra delen är definieringen av typen struct bpf_func_proto, som innehåller en beskrivning av hjälpfunktionen som verifieraren förstår:
const struct bpf_func_proto bpf_get_smp_processor_id_proto = {
    .func     = bpf_get_smp_processor_id,
    .gpl_only = false,
    .ret_type = RET_INTEGER,
};
Registrering av hjälpfunktioner
För att program av viss typ ska kunna använda denna funktion måste de registrera den, exempelvis för typen BPF_PROG_TYPE_XDP definieras i kärnan funktionen xdp_func_proto, som baserat på ID för hjälpfunktionen avgör om XDP stöder denna funktion eller inte. Vår funktion :
static const struct bpf_func_proto *
xdp_func_proto(enum bpf_func_id func_id, const struct bpf_prog *prog)
{
    switch (func_id) {
    ...
    case BPF_FUNC_get_smp_processor_id:
        return &bpf_get_smp_processor_id_proto;
    ...
    }
}
Nya typer av BPF-program "definieras" i filen med makrot BPF_PROG_TYPE. Definieras åberopas inom citat, eftersom det är en logisk definition, och i termer av C-språket sker definitionen av en uppsättning specifika strukturer på andra ställen. I synnerhet i filen kernel/bpf/verifier.c används alla definitioner från filen bpf_types.h för att skapa en array av strukturer bpf_verifier_ops[]:
static const struct bpf_verifier_ops *const bpf_verifier_ops[] = {
#define BPF_PROG_TYPE(_id, _name, prog_ctx_type, kern_ctx_type)
    [_id] = & _name ## _verifier_ops,
#include
#undef BPF_PROG_TYPE
};
Det vill säga, för varje typ av BPF-program definieras en pekare till datatypens struktur. struct bpf_verifier_ops, som initialiseras till värdet _name ## _verifier_ops, det vill säga, xdp_verifier_ops för xdp. Strukturen xdp_verifier_ops i filen net/core/filter.c på följande sätt:
const struct bpf_verifier_ops xdp_verifier_ops = {
    .get_func_proto     = xdp_func_proto,
    .is_valid_access    = xdp_is_valid_access,
    .convert_ctx_access = xdp_convert_ctx_access,
    .gen_prologue       = bpf_noop_prologue,
};
Här ser vi vår bekanta funktion xdp_func_proto, som kommer att köras av verifier varje gång den stöter på ett anrop någon funktion inom BPF-programmet, se. .
Låt oss titta på hur ett hypotetiskt BPF-program använder funktionen bpf_get_smp_processor_id. För detta syfte omskriver vi programmet från vårt föregående avsnitt på följande sätt:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

SEC("xdp/simple")
int simple(void *ctx)
{
    if (bpf_get_smp_processor_id() != 0)
        return XDP_DROP;
    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Symbolen bpf_get_smp_processor_id på <bpf/bpf_helper_defs.h> bibliotek libbpf som
static u32 (*bpf_get_smp_processor_id)(void) = (void *) 8;det vill säga, bpf_get_smp_processor_id — det är en pekare till funktionen, vars värde är 8, där 8 är värdet BPF_FUNC_get_smp_processor_id av typen enum bpf_fun_id, vilket definieras för oss i filen vmlinux.h (filen bpf_helper_defs.h i kärnan genereras med ett skript, därför är "magiska" nummer ok). Den här funktionen tar inga argument och returnerar ett värde av typen __u32. När vi kör den i vårt program, clang genererar den en instruktion BPF_CALL av "rätt typ". Låt oss kompilera programmet och titta på sektionen xdp/simple:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ llvm-objdump -D --section=xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       filformat elf64-bpf

Dissassembly av sektionen xdp/simple:

0000000000000000 <simple>:
       0:       85 00 00 00 08 00 00 00 call 8
       1:       bf 01 00 00 00 00 00 00 r1 = r0
       2:       67 01 00 00 20 00 00 00 r1 <<= 32
       3:       77 01 00 00 20 00 00 00 r1 >>= 32
       4:       b7 00 00 00 02 00 00 00 r0 = 2
       5:       15 01 01 00 00 00 00 00 if r1 == 0 goto +1 <LBB0_2>
       6:       b7 00 00 00 01 00 00 00 r0 = 1

0000000000000038 <LBB0_2>:
       7:       95 00 00 00 00 00 00 00 exit
I den första raden ser vi instruktionen call, parametern IMM som är lika med 8, och SRC_REG är noll. Enligt ABI-överenskommelsen som verifier används, är detta anropet till hjälpfunktionen med nummer åtta. När den körs är logiken enkel. Det returnerade värdet från registret r0 kopieras till r1 och på raderna 2,3 omvandlas det till typen u32 — de övre 32 bitarna nollställs. På raderna 4,5,6,7 returnerar vi 2 (XDP_PASS) eller 1 (XDP_DROP) beroende på om hjälpfunktionen på rad 0 returnerade ett nollvärde eller ett icke-nollvärde.
Låt oss kontrollera oss själva: ladda upp programmet och titta på utsikten bpftool prog dump xlated:
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple &
[2] 10914

$ sudo bpftool p | grep simple
523: xdp  name simple  tag 44c38a10c657e1b0  gpl
        pids xdp-simple(10915)

$ sudo bpftool p d x id 523
int simple(void *ctx):
; if (bpf_get_smp_processor_id() != 0)
   0: (85) call bpf_get_smp_processor_id#114128
   1: (bf) r1 = r0
   2: (67) r1 <>= 32
   4: (b7) r0 = 2
; }
   5: (15) if r1 == 0x0 goto pc+1
   6: (b7) r0 = 1
   7: (95) exit
Bra jobbat, verifier har hittat rätt kernel-helper.
Exempel: vi skickar argument och till sist kör programmet!
Alla hjälpfunktioner på exekveringsnivå har en prototyp
u64 fn(u64 r1, u64 r2, u64 r3, u64 r4, u64 r5)Parametrarna skickas till hjälpfunktionerna via register r1—r5, och värdet returneras i registret r0. Det finns inga funktioner som tar emot mer än fem argument — och stöd för att lägga till dem förväntas inte i framtiden.
Låt oss titta på den nya kernel-helpern och hur BPF skickar parametrar. Vi skriver om xdp-simple.bpf.c på följande sätt (övriga rader har inte ändrats):
SEC("xdp/simple")
int simple(void *ctx)
{
    bpf_printk("running on CPU%un", bpf_get_smp_processor_id());
    return XDP_PASS;
}
Vårt program skriver ut numret på CPU:n det körs på. Vi ska kompilera det och titta på koden:
$ llvm-objdump -D --section=xdp/simple --no-show-raw-insn xdp-simple.bpf.o

0000000000000000 :
       0:       r1 = 10
       1:       *(u16 *)(r10 - 8) = r1
       2:       r1 = 8441246879787806319 ll
       4:       *(u64 *)(r10 - 16) = r1
       5:       r1 = 2334956330918245746 ll
       7:       *(u64 *)(r10 - 24) = r1
       8:       call 8
       9:       r1 = r10
      10:       r1 += -24
      11:       r2 = 18
      12:       r3 = r0
      13:       call 6
      14:       r0 = 2
      15:       exit
I raderna 0-7 skriver vi på stacken strängen running on CPU%un, och sedan på rad 8 kör vi den bekanta bpf_get_smp_processor_id. I raderna 9-12 förbereder vi argumenten till hjälpfunktionen bpf_printk — register r1, r2, r3. Varför är de tre, och inte två? För att bpf_printk — kring den verkliga hjälpfunktionen bpf_trace_printk, som kräver att storleken på formatsträngen skickas.
Låt oss nu lägga till några rader till xdp-simple.c, så att vårt program kopplar upp sig mot gränssnittet lo och körs på riktigt!
$ cat xdp-simple.c
#include
#include
#include
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    __u32 flags = XDP_FLAGS_SKB_MODE;
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    bpf_set_link_xdp_fd(1, -1, flags);
    bpf_set_link_xdp_fd(1, bpf_program__fd(obj->progs.simple), flags);

cleanup:
    xdp_simple_bpf__destroy(obj);
}
Här använder vi funktionen bpf_set_link_xdp_fd, som kopplar BPF-program av typen XDP till nätverksgränssnitt. Vi har hårdkodad gränssnittets nummer. lo, som alltid är lika med 1. Vi kör funktionen två gånger för att först koppla bort det gamla programmet om det var anslutet. Observera att vi nu inte behöver ett samtal pause eller en oändlig loop: vårt laddningsprogram kommer att avslutas, men BPF-programmet kommer inte att förstöras eftersom det är anslutet till händelsekällan. Efter en framgångsrik laddning och anslutning kommer programmet att köras för varje nätverkspaket som kommer till lo.
Låt oss ladda programmet och titta på gränssnittet lo:
$ sudo ./xdp-simple
$ sudo bpftool p | grep simple
669: xdp name simple tag 4fca62e77ccb43d6 gpl
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 669
Programmet vi laddade har ID 669 och samma ID ser vi på gränssnittet lo. Vi kommer att skicka ett par paket till 127.0.0.1 (request + reply):
$ ping -c1 localhostoch nu låt oss titta på innehållet i den virtuella felsökningsfilen /sys/kernel/debug/tracing/trace_pipe, dit bpf_printk skriver sina meddelanden:
# cat /sys/kernel/debug/tracing/trace_pipe
ping-13937 [000] d.s1 442015.377014: bpf_trace_printk: running on CPU0
ping-13937 [000] d.s1 442015.377027: bpf_trace_printk: running on CPU0
Två paket har registrerats på lo och behandlades på CPU0 – vårt första fullständiga meningsfria BPF-program har kört klart!
Det är värt att notera att bpf_printk det inte är för ingenting som den skriver till felsökningsfilen: det är inte den bästa hjälparen att använda i produktion, men vårt mål var att visa något enkelt.
Tillgång till mappar från BPF-program
Exempel: vi använder en karta från ett BPF-program
I de tidigare avsnitten lärde vi oss att skapa och använda kartor från användarrummet, och nu ska vi titta på kärndelen. Låt oss börja, som vanligt, med ett exempel. Låt oss skriva om vårt program xdp-simple.bpf.c på följande sätt:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

struct {
    __uint(type, BPF_MAP_TYPE_ARRAY);
    __uint(max_entries, 8);
    __type(key, u32);
    __type(value, u64);
} woo SEC(".maps");

SEC("xdp/simple")
int simple(void *ctx)
{
    u32 key = bpf_get_smp_processor_id();
    u32 *val;

    val = bpf_map_lookup_elem(&woo, &key);
    if (!val)
        return XDP_ABORTED;

    *val += 1;

    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
I början av programmet lade vi till en definitionskarta woo: det är en array av 8 element där värden av typen u64 (i C skulle vi definiera en sådan array som u64 woo[8]). I programmet "xdp/simple" får vi nummer på den aktuella processorn i variabeln key och sedan med hjälp av hjälpfunktionen bpf_map_lookup_element får vi en pekare till motsvarande post i arrayen, som vi ökar med ett. Översatt till svenska: vi räknar statistiken för vilken CPU som har behandlat inkommande paket. Låt oss försöka köra programmet:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple
Låt oss kontrollera att det har kopplat sig till lo och skicka lite paket:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 108

$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
Låt oss nu titta på innehållet i arrayen:
$ sudo bpftool map dump name woo
[
    { "key": 0, "value": 0 },
    { "key": 1, "value": 400 },
    { "key": 2, "value": 0 },
    { "key": 3, "value": 0 },
    { "key": 4, "value": 0 },
    { "key": 5, "value": 0 },
    { "key": 6, "value": 0 },
    { "key": 7, "value": 46400 }
]
Nästan alla processer har hanterats av CPU7. Det spelar ingen roll för oss, det viktiga är att programmet fungerar och att vi har förstått hur man får åtkomst till mapparna från BPF-program — via .
Mystisk pekare
Så vi kan få åtkomst från BPF-programmet till mappen genom att använda anrop av typen
val = bpf_map_lookup_elem(&woo, &key);där hjälpfunktionen ser ut som
void *bpf_map_lookup_elem(struct bpf_map *map, const void *key)men vi skickar en pekare &woo till en anonym struktur struct { ... }…
Om vi tittar på assembly av programmet så ser vi att värdet &woo faktiskt inte är definierat (rad 4):
llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       filformat elf64-bpf

Disassemblering av sektion xdp/simple:

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
...
och finns i omflyttningarna:
$ llvm-readelf -r xdp-simple.bpf.o | head -4

Relocation section '.relxdp/simple' at offset 0xe18 contains 1 entries:
    Offset             Info             Type               Symbol's Value  Symbol's Name
0000000000000020  0000002700000001 R_BPF_64_64            0000000000000000 woo
Men om vi tittar på det redan inlästa programmet ser vi en pekare till den rätta mappen (rad 4):
$ sudo bpftool prog dump x name simple
int simple(void *ctx):
   0: (85) call bpf_get_smp_processor_id#114128
   1: (63) *(u32 *)(r10 -4) = r0
   2: (bf) r2 = r10
   3: (07) r2 += -4
   4: (18) r1 = map[id:64]
...
Så vi kan dra slutsatsen att vid starten av vårt laddningsprogram har referensen &woo har blivit ersatt av något av biblioteket libbpf. Först ska vi titta på utskriften för att kontrollera paketöverföringen åt båda håll:
$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, key_size=4, value_size=8, max_entries=8, map_name="woo", ...}, 120) = 4
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="simple", ...}, 120) = 5
Vi ser att libbpf har skapat en karta woo och sedan laddade vårt program simple. Låt oss titta närmare på hur vi laddar programmet:
- vi anropar
xdp_simple_bpf__open_and_loadfrån en filxdp-simple.skel.h - som anropar
xdp_simple_bpf__loadfrån en filxdp-simple.skel.h - som anropar
bpf_object__load_skeletonfrån en fillibbpf/src/libbpf.c - som anropar
bpf_object__load_xattrfrånlibbpf/src/libbpf.c
Den sista funktionen kommer, förutom allt annat, att anropa bpf_object__create_maps, som skapar eller öppnar befintliga maps och omvandlar dem till filhandtag. (Detta är där vi ser BPF_MAP_CREATE i utskriften för att kontrollera paketöverföringen åt båda håll.) Vidare anropas funktionen bpf_object__relocate , och det är just den som intresserar oss, eftersom vi minns att vi såg woo i omplacerings-tabellen. När vi undersöker den hamnar vi slutligen i funktionen bpf_program__relocate, som ansvarar för :
case RELO_LD64:
    insn[0].src_reg = BPF_PSEUDO_MAP_FD;
    insn[0].imm = obj->maps[relo->map_idx].fd;
    break;
Så, vi tar vår instruktion
18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 lloch ersätter källregister med BPF_PSEUDO_MAP_FD, och den första IMM med filhandtaget för vår map, och om det exempelvis är 0xdeadbeef, så får vi som resultat instruktionen
18 11 00 00 ef eb ad de 00 00 00 00 00 00 00 00 r1 = 0 llSå här överförs information om maps till det specifika BPF-programmet som laddas. Observera att en map kan skapas med BPF_MAP_CREATE, eller öppnas med ID med hjälp av BPF_MAP_GET_FD_BY_ID.
Så sammanfattningsvis, algoritmen ser ut som följande: libbpf Under kompileringen skapas poster i omplacerings-tabellen för referenser till maps
- öppnar ELF-objektet, hittar alla använda maps och skapar filhandtag för dem
libbpffilhandtag laddas in i kärnan som en del av instruktionen- LD64
Förstår du att detta inte är allt, och vi måste titta in i kärnan. Lyckligtvis har vi en ledtråd – vi har skrivit värdet
i källregistret och kan söka efter det, vilket för oss till heliga av heliga – BPF_PSEUDO_MAP_FD , där funktionen med det karaktäristiska namnet ersätter filhandtaget med adressen till strukturen av typen kernel/bpf/verifier.cstruct bpf_map static int replace_map_fd_with_map_ptr(struct bpf_verifier_env *env) { ...f = fdget(insn[0].imm); map = __bpf_map_get(f); if (insn->src_reg == BPF_PSEUDO_MAP_FD) { addr = (unsigned long)map; } insn[0].imm = (u32)addr; insn[1].imm = addr >> 32;:
(fullständiga koden hittar du). Så vi kan komplettera vår algoritm: Vid laddningen kontrollerar verifieraren korrekt användning av map och registrerar adressen till den motsvarande strukturen
- Vid laddning av ELF-binärfil med
static int replace_map_fd_with_map_ptr(struct bpf_verifier_env *env) { ...f = fdget(insn[0].imm); map = __bpf_map_get(f); if (insn->src_reg == BPF_PSEUDO_MAP_FD) { addr = (unsigned long)map; } insn[0].imm = (u32)addr; insn[1].imm = addr >> 32;
finns det många fler händelser, men vi kommer att diskutera detta i andra artiklar. libbpf Laddar program och maps utan libbpf
Som utlovat, här är ett exempel för läsare som vill veta hur man skapar och laddar ett program som använder maps utan hjälp.
Som som lovat, här är ett exempel för läsare som vill veta hur man skapar och laddar upp ett program som använder mappar, utan hjälp. libbpf. Det kan vara användbart när du arbetar i en miljö där du inte kan installera beroenden, sparar varje bit, eller skriver ett program av typen , som genererar BPF-binarier på språng.
För att göra det enklare att följa logiken, kommer vi att skriva om vårt exempel xdp-simple. Den fullständiga och något utökade koden för programmet som diskuteras i detta exempel kan du hitta i denna .
Logiken för vår applikation är följande:
- skapa en mapp av typen
BPF_MAP_TYPE_ARRAYmed kommandotBPF_MAP_CREATE, - skapa ett program som använder denna mapp,
- koppla programmet till gränssnittet
lo,
vilket översätts till mänskligt som
int main(void)
{
    int map_fd, prog_fd;

    map_fd = map_create();
    if (map_fd < 0)
        err(1, "bpf: BPF_MAP_CREATE");

    prog_fd = prog_load(map_fd);
    if (prog_fd < 0)
        err(1, "bpf: BPF_PROG_LOAD");

    xdp_attach(1, prog_fd);
}
Här map_create skapar en mapp precis som vi gjorde i det första exemplet om systemanropet bpf — "kärna, var snäll och gör en ny mapp som en array av 8 element av typen __u64 och returnera en filhandtag till mig":
static int map_create()
{
    union bpf_attr attr;

    memset(&attr, 0, sizeof(attr));
    attr.map_type = BPF_MAP_TYPE_ARRAY,
    attr.key_size = sizeof(__u32),
    attr.value_size = sizeof(__u64),
    attr.max_entries = 8,
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    return syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));
}
Programmet laddas också enkelt:
static int prog_load(int map_fd)
{
    union bpf_attr attr;
    struct bpf_insn insns[] = {
        ...
    };

    memset(&attr, 0, sizeof(attr));
    attr.prog_type = BPF_PROG_TYPE_XDP;
    attr.insns     = ptr_to_u64(insns);
    attr.insn_cnt  = sizeof(insns)/sizeof(insns[0]);
    attr.license   = ptr_to_u64("GPL");
    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    return syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));
}
Den svåra delen prog_load – är definitionen av vårt BPF-program som en array av strukturer struct bpf_insn insns[]. Men eftersom vi använder ett program som vi har på C kan vi fuska lite:
$ llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
       7:       b7 01 00 00 00 00 00 00 r1 = 0
       8:       15 00 04 00 00 00 00 00 if r0 == 0 goto +4
       9:       61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0)
      10:       07 01 00 00 01 00 00 00 r1 += 1
      11:       63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1
      12:       b7 01 00 00 02 00 00 00 r1 = 2

0000000000000068 :
      13:       bf 10 00 00 00 00 00 00 r0 = r1
      14:       95 00 00 00 00 00 00 00 exit
Så totalt sett behöver vi skriva 14 instruktioner i form av strukturer av typen struct bpf_insn (tips: ta en dump från toppen, läs igenom avsnittet om instruktioner, öppna och och försök att bestämma struct bpf_insn insns[] själv):
struct bpf_insn insns[] = {
    /* 85 00 00 00 08 00 00 00 call 8 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 8,
    },

    /* 63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0 */
    {
        .code = BPF_MEM | BPF_STX,
        .off = -4,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_10,
    },

    /* bf a2 00 00 00 00 00 00 r2 = r10 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_10,
        .dst_reg = BPF_REG_2,
    },

    /* 07 02 00 00 fc ff ff ff r2 += -4 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_2,
        .imm = -4,
    },

    /* 18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll */
    {
        .code = BPF_LD | BPF_DW | BPF_IMM,
        .src_reg = BPF_PSEUDO_MAP_FD,
        .dst_reg = BPF_REG_1,
        .imm = map_fd,
    },
    { }, /* placeholder */

    /* 85 00 00 00 01 00 00 00 call 1 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 1,
    },

    /* b7 01 00 00 00 00 00 00 r1 = 0 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 0,
    },

    /* 15 00 04 00 00 00 00 00 if r0 == 0 goto +4  */
    {
        .code = BPF_JMP | BPF_JEQ | BPF_K,
        .off = 4,
        .src_reg = BPF_REG_0,
        .imm = 0,
    },

    /* 61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0) */
    {
        .code = BPF_MEM | BPF_LDX,
        .off = 0,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_1,
    },

    /* 07 01 00 00 01 00 00 00 r1 += 1 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 1,
    },

    /* 63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1 */
    {
        .code = BPF_MEM | BPF_STX,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* b7 01 00 00 02 00 00 00 r1 = 2 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 2,
    },

    /* : bf 10 00 00 00 00 00 00 r0 = r1 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* 95 00 00 00 00 00 00 00 exit */
    {
        .code = BPF_JMP | BPF_EXIT
    },
};
En övning för dem som inte skrev detta själva - hitta map_fd.
Det finns en annan okänd del i vårt program - xdp_attach. Tyvärr kan man inte koppla program av typen XDP via systemanrop bpf. Människorna som skapade BPF och XDP kom från Linux-nätverksgemenskapen, vilket innebar att de använde det mest bekanta för dem (men inte för normala människor) gränssnittet för att interagera med kärnan: , se också . Det enklaste sättet att implementera xdp_attach är att kopiera koden från libbpf, nämligen från filen , vilket vi har gjort, och lite förkortat den:
Välkommen till världen av netlink sockets
Vi öppnar en netlink socket av typen NETLINK_ROUTE:
int netlink_open(__u32 *nl_pid)
{
    struct sockaddr_nl sa;
    socklen_t addrlen;
    int one = 1, ret;
    int sock;

    memset(&sa, 0, sizeof(sa));
    sa.nl_family = AF_NETLINK;

    sock = socket(AF_NETLINK, SOCK_RAW, NETLINK_ROUTE);
    if (sock < 0)
        err(1, "socket");

    if (setsockopt(sock, SOL_NETLINK, NETLINK_EXT_ACK, &one, sizeof(one)) < 0)
        warnx("netlink error reporting not supported");

    if (bind(sock, (struct sockaddr *)&sa, sizeof(sa)) < 0)
        err(1, "bind");

    addrlen = sizeof(sa);
    if (getsockname(sock, (struct sockaddr *)&sa, &addrlen) < 0)
        err(1, "getsockname");

    *nl_pid = sa.nl_pid;
    return sock;
}
Vi läser från en sådan socket:
static int bpf_netlink_recv(int sock, __u32 nl_pid, int seq)
{
    bool multipart = true;
    struct nlmsgerr *errm;
    struct nlmsghdr *nh;
    char buf[4096];
    int len, ret;

    while (multipart) {
        multipart = false;
        len = recv(sock, buf, sizeof(buf), 0);
        if (len nlmsg_pid != nl_pid)
                errx(1, "wrong pid");
            if (nh->nlmsg_seq != seq)
                errx(1, "INVSEQ");
            if (nh->nlmsg_flags & NLM_F_MULTI)
                multipart = true;
            switch (nh->nlmsg_type) {
                case NLMSG_ERROR:
                    errm = (struct nlmsgerr *)NLMSG_DATA(nh);
                    if (!errm->error)
                        continue;
                    ret = errm->error;
                    // libbpf_nla_dump_errormsg(nh); för mycket kod att kopiera...
                    goto done;
                case NLMSG_DONE:
                    return 0;
                default:
                    break;
            }
        }
    }
    ret = 0;
done:
    return ret;
}
Till sist, här är vår funktion som öppnar en socket och skickar ett speciellt meddelande till den som innehåller en filbeskrivare:
static int xdp_attach(int ifindex, int prog_fd)
{
    int sock, seq = 0, ret;
    struct nlattr *nla, *nla_xdp;
    struct {
        struct nlmsghdr  nh;
        struct ifinfomsg ifinfo;
        char             attrbuf[64];
    } req;
    __u32 nl_pid = 0;

    sock = netlink_open(&nl_pid);
    if (sock nla_type = NLA_F_NESTED | IFLA_XDP;
    nla->nla_len = NLA_HDRLEN;

    /* add XDP fd */
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FD;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(int);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &prog_fd, sizeof(prog_fd));
    nla->nla_len += nla_xdp->nla_len;

    /* if user passed in any flags, add those too */
    __u32 flags = XDP_FLAGS_SKB_MODE;
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FLAGS;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(flags);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &flags, sizeof(flags));
    nla->nla_len += nla_xdp->nla_len;

    req.nh.nlmsg_len += NLA_ALIGN(nla->nla_len);

    if (send(sock, &req, req.nh.nlmsg_len, 0) < 0)
        err(1, "send");
    ret = bpf_netlink_recv(sock, nl_pid, seq);

cleanup:
    close(sock);
    return ret;
}
Allt är klart för testning:
$ cc nolibbpf.c -o nolibbpf
$ sudo strace -e bpf ./nolibbpf
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, map_name="woo", ...}, 72) = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=15, prog_name="woo", ...}, 72) = 4
+++ exited with 0 +++
Låt oss se om vårt program har kopplat ihop sig med lo:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 160
Vi skickar pingar och kollar på mappen:
$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
$ sudo bpftool m dump name woo
key: 00 00 00 00  value: 90 01 00 00 00 00 00 00
key: 01 00 00 00  value: 00 00 00 00 00 00 00 00
key: 02 00 00 00  value: 00 00 00 00 00 00 00 00
key: 03 00 00 00  value: 00 00 00 00 00 00 00 00
key: 04 00 00 00  value: 00 00 00 00 00 00 00 00
key: 05 00 00 00  value: 00 00 00 00 00 00 00 00
key: 06 00 00 00  value: 40 b5 00 00 00 00 00 00
key: 07 00 00 00  value: 00 00 00 00 00 00 00 00
Hittade 8 element
Hurray, allt fungerar. Observera att vår mapp återigen visas i form av bytes. Detta händer eftersom vi inte laddade information om typer (BTF). Men mer om det tar vi nästa gång. libbpf I det här avsnittet kommer vi att titta på den minimala uppsättningen verktyg för BPF-utvecklare.
Utvecklingsverktyg
I allmänhet behövs inget speciellt för att utveckla BPF-program — BPF fungerar på vilken anständig distribution som helst och programmen kompileras med hjälp av
Generellt sett krävs det inget speciellt för att utveckla BPF-program — BPF fungerar på vilken anständig distributionskerna som helst, och programmen byggs med hjälp av. clang, som kan installeras från paketet. Men eftersom BPF är under utveckling ändras kärnan och verktygen ständigt. Om du inte vill skriva BPF-program med gammaldags metoder från 2019, måste du bygga
llvm/clangpahole- din egen kärna
bpftool
(För referens: denna sektion och alla exempel i artikeln kördes på Debian 10.)
llvm/clang
BPF fungerar bra med LLVM och även om program för BPF nyligen kan kompileras också med gcc, pågår all nuvarande utveckling för LLVM. Så först kommer vi att bygga den aktuella versionen clang från git:
$ sudo apt install ninja-build
$ git clone --depth 1 https://github.com/llvm/llvm-project.git
$ mkdir -p llvm-project/llvm/build/install
$ cd llvm-project/llvm/build
$ cmake .. -G "Ninja" -DLLVM_TARGETS_TO_BUILD="BPF;X86"
                      -DLLVM_ENABLE_PROJECTS="clang"
                      -DBUILD_SHARED_LIBS=OFF
                      -DCMAKE_BUILD_TYPE=Release
                      -DLLVM_BUILD_RUNTIME=OFF
$ time ninja
... många timmar senare
$
Nu kan vi kontrollera om allt har byggts korrekt:
$ ./bin/llc --version
LLVM (http://llvm.org/):
  LLVM version 11.0.0git
  Optimerad byggnad.
  Standardmål: x86_64-unknown-linux-gnu
  Värd CPU: znver1

  Registrerade mål:
    bpf    - BPF (host endian)
    bpfeb  - BPF (big endian)
    bpfel  - BPF (little endian)
    x86    - 32-bit X86: Pentium-Pro och uppåt
    x86-64 - 64-bit X86: EM64T och AMD64
(Bygginstruktionen clang är tagen av mig från .)
Vi kommer inte att installera nyss byggda program, utan istället bara lägga till dem i PATH, till exempel:
export PATH="`pwd`/bin:$PATH"(Detta kan läggas till i .bashrc eller i en separat fil. Personligen lägger jag sådana saker i ~/bin/activate-llvm.sh och när det behövs gör jag . activate-llvm.sh.)
Pahole och BTF
Verktyg pahole används vid byggandet av kärnan för att skapa debug-information i BTF-format. Vi kommer inte att gå in på detaljer kring BTF-teknologin i denna artikel, förutom att det är praktiskt och vi vill använda det. Så om du tänker bygga din egen kärna, bygg först pahole (utan pahole du kan inte bygga kärnan med alternativet CONFIG_DEBUG_INFO_BTF:
$ git clone https://git.kernel.org/pub/scm/devel/pahole/pahole.git
$ cd pahole/
$ sudo apt install cmake
$ mkdir build
$ cd build/
$ cmake -D__LIB=lib ..
$ make
$ sudo make install
$ which pahole
/usr/local/bin/pahole
Kärnor för experiment med BPF
När man utforskar möjligheterna med BPF vill man gärna samla sitt eget kärna. Detta är i och för sig inte nödvändigt, eftersom du kan samla och ladda BPF-program även på en distributionskärna. Men att ha sitt eget kärna tillåter dig att använda de senaste BPF-funktionerna, vilka i bästa fall kommer att finnas i din distribution om några månader, eller i värsta fall, som i fallet med vissa debuggningsverktyg, inte kommer att paketeras i överskådlig framtid. Dessutom ger ditt eget kärna en känsla av att kunna experimentera med koden.
För att bygga ett kärna behöver du, för det första, själva kärnan, och för det andra, en konfigurationsfil för kärnan. För experiment med BPF kan vi använda en vanlig kärna eller en av utvecklarkärnorna. Historiskt sett sker utvecklingen av BPF inom den nätverksgemenskapen i Linux, och därför går alla ändringar рано eller поздно через David Miller — underhållare för Linux nätverksdel. Beroende på deras karaktär — reparationar eller nya funktioner — tilldelas nätverksändringar en av två kärnor — eller . Ändringar för BPF delas på samma sätt mellan och , som sedan skjuts ut till net och net-next, respektive. Mer information finns i och . Så välj kärna baserat på din smak och behov för systemstabilitet på vilket du testar (*-next kärnorna är de mest instabila av de som nämnts).
Denna artikel omfattar inte hur man hanterar konfigurationsfiler för kärnor — det antas att du antingen redan kan göra det, eller själv. Men följande instruktioner bör vara tillräckliga för att du ska få ett fungerande system med BPF-stöd.
Ladda ner en av de ovan nämnda kärnorna:
$ git clone git://git.kernel.org/pub/scm/linux/kernel/git/bpf/bpf-next.git
$ cd bpf-next
Bygg en minimal fungerande konfiguration för kärnan:
$ cp /boot/config-`uname -r` .config
$ make localmodconfig
Aktivera BPF-alternativen i filen .config efter eget val (antagligen kommer själva CONFIG_BPF att redan vara aktiverad, eftersom systemd använder det). Här är en lista över alternativen från kärnan som användes för denna artikel:
CONFIG_CGROUP_BPF=y
CONFIG_BPF=y
CONFIG_BPF_LSM=y
CONFIG_BPF_SYSCALL=y
CONFIG_ARCH_WANT_DEFAULT_BPF_JIT=y
CONFIG_BPF_JIT_ALWAYS_ON=y
CONFIG_BPF_JIT_DEFAULT_ON=y
CONFIG_IPV6_SEG6_BPF=y
# CONFIG_NETFILTER_XT_MATCH_BPF is not set
# CONFIG_BPFILTER is not set
CONFIG_NET_CLS_BPF=y
CONFIG_NET_ACT_BPF=y
CONFIG_BPF_JIT=y
CONFIG_BPF_STREAM_PARSER=y
CONFIG_LWTUNNEL_BPF=y
CONFIG_HAVE_EBPF_JIT=y
CONFIG_BPF_EVENTS=y
CONFIG_BPF_KPROBE_OVERRIDE=y
CONFIG_DEBUG_INFO_BTF=y
Därefter kan vi enkelt sammanställa och installera moduler och kärnan (för övrigt kan kärnan sammanställas med just sammanställd clang, genom att lägga till CC=clang):
$ make -s -j $(getconf _NPROCESSORS_ONLN)
$ sudo make modules_install
$ sudo make install
och starta om med den nya kärnan (jag använder kexec från paketet kexec-tools):
v=5.8.0-rc6+ # om du omkompilerar den aktuella kärnan kan du använda v=`uname -r`
sudo kexec -l -t bzImage /boot/vmlinuz-$v --initrd=/boot/initrd.img-$v --reuse-cmdline &&
sudo kexec -e
bpftool
Den mest använda verktyget i artikeln kommer att vara verktyget bpftool, som levereras med Linux-kärnan. Det är skrivet och underhållet av BPF-utvecklarna för BPF-utvecklare och kan användas för att hantera alla typer av BPF-objekt — ladda program, skapa och ändra maps, utforska livscykeln för BPF-ekosystemet, osv. Dokumentationen i form av källkod till man-sidor kan hittas eller, redan kompilerad, .
Vid tidpunkten för skrivandet av artikeln bpftool levereras i färdig form endast för RHEL, Fedora och Ubuntu (se exempelvis , där den ofärdiga historien om paketering diskuteras bpftool i Debian). Men om du redan har sammanställt din kärna är det enklare än någonsin: bpftool $ cd ${linux}/tools/bpf/bpftool # ... ange vägar till senaste clang, som beskrivits ovan $ make -sAuto-detecting system features: ... libbfd: [ on ] ... disassembler-four-args: [ on ] ... zlib: [ on ] ... libcap: [ on ] ... clang-bpf-co-re: [ on ]Auto-detecting system features: ... libelf: [ on ] ... zlib: [ on ] ... bpf: [ on ]$
(här${linux} är din katalog med kärnan.) Efter att dessa kommandon har körts kommer det att sammanställas i katalogen bpftool ${linux}/tools/bpf/bpftool och det kan läggas till i sökvägen (först och främst för användaren ) eller helt enkelt kopieras till rootDet är bäst att sammanställa med den senaste /usr/local/sbin.
, sammanställd, som beskrivits ovan, och för att kontrollera om den har sammanställts korrekt kan du använda till exempel kommandot bpftool $ sudo bpftool feature probe kernel Scanning system configuration... bpf() syscall for unprivileged users is enabled JIT compiler is enabled JIT compiler hardening is disabled JIT compiler kallsyms exports are enabled for root ... clangsom visar vilka BPF-funktioner som är aktiverade i din kärna.
För övrigt kan det föregående kommandot köras somDetta är gjort på analogi med verktyg från paketet
Förresten kan den tidigare kommandot köras som.
# bpftool f p kDetta görs på analogi med verktyg från paketet. iproute2, där vi kan till exempel säga ip a s eth0 istället för ip addr show dev eth0.
Slutsats
BPF möjliggör för en fälla att effektivt mäta och på språng förändra kärnans funktionalitet. Systemet har visat sig vara mycket framgångsrikt, i bästa UNIX-tradition: en enkel mekanism som tillåter att (om)programmera kärnan, har gjort det möjligt för ett stort antal människor och organisationer att experimentera. Och även om experimenten, liksom utvecklingen av själva BPF-infrastrukturen, fortfarande pågår, har systemet redan en stabil ABI som möjliggör bygget av pålitlig, och framför allt, effektiv affärslogik.
Jag vill påpeka att, enligt min åsikt, teknologin blivit så populär för att den å ena sidan gör det möjligt att leka (maskinens arkitektur kan förstås mer eller mindre på en kväll), och å andra sidan — lösa uppgifter som inte kunde lösas (vackert) innan den introducerades. Dessa två komponenter tillsammans tvingar människor att experimentera och drömma, vilket leder till nya och innovativa lösningar.
Denna artikel, även om den inte är särskilt kort, är bara en introduktion till BPF-världen och beskriver inte de "avancerade" möjligheterna och viktiga delar av arkitekturen. Den fortsatta planen är ungefär följande: nästa artikel kommer att vara en översikt av BPF-programtyper (i kärnan 5.8 stöds 30 programtyper), sedan kommer vi äntligen att se på hur man skriver riktiga applikationer på BPF genom exempel på kärnspårningsprogram, sedan kommer det bli dags för en mer ingående kurs om BPF-arkitekturen, och därefter — för exempel på nätverks- och säkerhetsapplikationer för BPF.
Tidigare artiklar i denna cykel
Länkar
— dokumentation om BPF från cilium, närmare bestämt från Daniel Borkman, en av skaparna och underhållarna av BPF. Detta är en av de första seriösa beskrivningarna som skiljer sig från de andra i det avseendet att Daniel vet exakt vad han pratar om och det finns inga slarvfel. I denna dokumentation beskrivs hur man arbetar med BPF-program av typerna XDP och TC med hjälp av det välkända verktyget
ipfrån paketetiproute2.— den ursprungliga filen med dokumentation om klassisk, och senare utvidgad BPF. Det är användbart att läsa om du vill gräva i assembler och tekniska detaljer i arkitekturen.
. Uppdateras sällan, men träffsäkert, eftersom Alexei Starovoitov (skaparen av eBPF) och Andrii Nakryiko — (underhållare
libbpf).. En fascinerande twitter-tråd av Quentin Monnet med exempel och hemligheter för användning av bpftool.
. En gigantisk (och fortfarande underhållen) lista med länkar till dokumentation om BPF av Quentin Monnet.
Källa: habr.com
