

I takt med att IPv4-adresserna tar slut har många teleoperatörer stött på behovet av att organisera sina kunders åtkomst till nätet genom adressöversättning. I den här artikeln kommer jag att gå igenom hur man kan uppnå Carrier Grade NAT-prestanda på commodity-servrar.
Lite historia
Ämnet kring uttömning av IPv4-adressutrymmet är inte nytt. Vid någon tidpunkt uppstod det köer i RIPE, och sedan dök det upp börser där man handlade med adressblock och ingick avtal om deras uthyrning. Gradvis började teleoperatörer erbjuda internetåtkomst genom adress- och portöversättning. Vissa hann inte få tillräckligt med adresser för att kunna ge varje abonnent en "vit" adress, medan andra började spara pengar genom att avstå från att köpa adresser på sekundärmarknaden. Tillverkare av nätverksutrustning stödde denna idé, eftersom denna funktionalitet vanligtvis kräver ytterligare expansionsmoduler eller licenser. Till exempel, hos Juniper i MX-serien av routrar (förutom de senaste MX104 och MX204) kan NAPT utföras på ett separat servicekort MS-MIC, på Cisco ASR1k krävs en licens CGN, och på Cisco ASR9k en separat modul A9K-ISM-100 samt licens A9K-CGN-LIC till denna. Sammanfattningsvis kostar det en hel del.
IPTables
Att utföra NAT kräver inga specialiserade beräkningsresurser; det kan hanteras av allmänna processorer som finns i exempelvis vilken hemrouter som helst. På teleoperatörsnivå kan denna uppgift lösas med commodity-servrar som kör FreeBSD (ipfw/pf) eller GNU/Linux (iptables). Vi kommer inte att behandla FreeBSD här, eftersom jag för länge sedan slutade använda detta operativsystem, så vi fokuserar på GNU/Linux.
Att aktivera adressöversättning är inte svårt. Först måste du skriva in en regel i iptables i nat-tabellen:
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
Operativsystemet kommer att ladda modulen nf_conntrack, som kommer att övervaka alla aktiva anslutningar och utföra nödvändiga omvandlingar. Det finns några subtiliteter här. För det första, eftersom vi pratar om NAT på operatörsnivå, måste timeout-värden justeras, eftersom standardvärdena gör att storleken på översättningstabellen snabbt kan växa till katastrofala dimensioner. Här är ett exempel på inställningar som jag använde på mina servrar:
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
Och för det andra, eftersom standardstorleken på översättningstabellen inte är avsedd för användning på operatörsnivå, behöver den ökas:
net.netfilter.nf_conntrack_max = 3145728
Det är också nödvändigt att öka antalet buckets för hash-tabellen som lagrar alla översättningar (detta är en alternativmodul för nf_conntrack):
options nf_conntrack hashsize=1572864
Efter dessa enkla manipuleringar får man en helt fungerande konstruktion som kan översätta ett stort antal klientadresser till en pool av externa. Men prestandan hos den här lösningen lämnar mycket att önska. Under mina första försök med att använda GNU/Linux för NAT (ungefär 2013) fick jag en prestanda på cirka 7 Gbit/s vid 0,8 Mpps på en server (Xeon E5-1650v2). Sedan dess har många olika optimeringar gjorts i nätverksstacken av kärnan GNU/Linux, och prestandan på en server med samma hårdvara har vuxit nästan till 18-19 Gbit/s vid 1,8-1,9 Mpps (detta var gränsvärden), men behovet av trafikvolym som hanteras av en server har växt mycket snabbare. Så småningom utvecklades scheman för lastbalansering på olika servrar, men allt detta ökade komplexiteten i konfigurationen, underhållet och kvaliteten på de tillhandahållna tjänsterna.
NFTables
Just nu är en modeinriktning inom programvaru "paketöverföring" användningen av DPDK och XDP. Det har skrivits många artiklar om detta ämne, hållits olika presentationer, och kommersiella produkter har dykt upp (till exempel SKAT från VasExperts). Men under förhållandena med begränsade resurser hos programmerarna på telekomoperatörerna är det ganska problematiskt att själva snickra ihop något "projekt" baserat på dessa ramverk. Att driva en sådan lösning vidare kommer att bli mycket mer komplicerat, särskilt eftersom det måste utvecklas diagnostikverktyg. Till exempel fungerar inte den vanliga tcpdump med DPDK så bra, och paket som skickas tillbaka till kablarna med XDP kommer den inte "se". Bland alla diskussioner om nya teknologier för pakethantering i användarutrymme har man missat och Pablo Neira Ayuso, underhållare av iptables, om utvecklingen av flow offloading i nftables. Låt oss granska denna mekanism närmare.
Huvudidén är att om routern har släppt igenom paket från en session i båda riktningarna (TCP-sessionen har gått över i tillståndet ESTABLISHED), så finns det ingen anledning att låta de efterföljande paketen från denna session passera genom alla brandväggsregler, eftersom alla dessa kontroller ändå kommer att sluta med att paketet skickas vidare till routing. Och valet av rutt behöver egentligen inte göras – vi vet redan vilket gränssnitt och vilken värd paketen inom denna session ska skickas till. Det återstår bara att spara denna information och använda den för routing i ett tidigt skede av paketbehandlingen. När NAT genomförs måste dessutom information om adress- och portförändringar som omvandlats av nf_conntrack-modulen sparas. Ja, i detta fall slutar olika policys och andra informationsstatistiska regler i iptables att fungera, men inom ramen för uppgiften för en separat stående NAT eller till exempel en border – är detta inte så viktigt, eftersom tjänsterna är distribuerade över enheter.
Konfiguration
För att använda denna funktion behöver vi:
- Använda en ny kärna. Trots att funktionen först dök upp i kärnan 4.16, var den länge ganska "omogen" och orsakade regelbundet kernel panic. Allt stabiliserades ungefär i december 2019, när LTS-kärnorna 4.19.90 och 5.4.5 släpptes.
- Omarbetta iptables-regler till nftables-format, med en tillräckligt ny version av nftables. Fungerar exakt i version 0.9.0
Om det första punkten är relativt förståeligt, kom ihåg att aktivera modulen i konfigurationen vid kompilering (CONFIG_NFT_FLOW_OFFLOAD=m), så kräver den andra punkten förklaringar. nftables-regler beskrivs på ett helt annat sätt än i iptables. täcker praktiskt taget alla aspekter, och det finns också speciella av regler från iptables till nftables. Därför kommer jag endast att ge ett exempel på konfiguration av NAT och flow offload. En kort legend för exemplet: <i_if>, <o_if> — dessa är nätverksgränssnitt genom vilka trafiken passerar, och det kan faktiskt finnas fler än två. <pool_addr_start>, <pool_addr_end> — den första och sista adressen i intervallet av "vita" adresser.
NAT-konfigurationen är mycket enkel:
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
Flow offload är lite mer komplicerat, men helt förståeligt:
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
Detta är faktiskt hela konfigurationen. Nu kommer all TCP/UDP-trafik att gå till tabellen fastnat och behandlas mycket snabbare.
Resultat
För att förstå hur mycket "mycket snabbare" det är, kommer jag att bifoga en skärmdump av belastningen på två verkliga servrar, med samma hårdvara (Xeon E5-1650v2), lika konfigurerade, som använder samma Linux-kärna, men utför NAT i iptables (NAT4) respektive i nftables (NAT5).
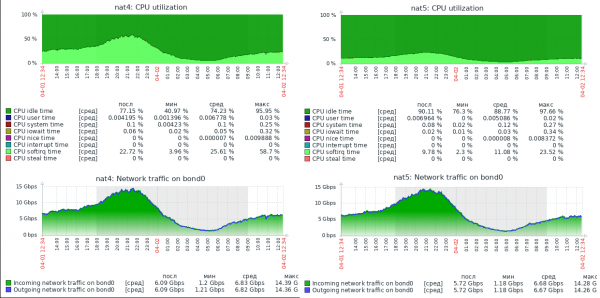
I skärmdumpen finns ingen graf över paket per sekund, men i belastningsprofilen för dessa servrar är det genomsnittliga paketstorleken cirka 800 byte, så värdena når upp till 1.5Mpps. Som synligt, finns det en stor prestandareserv för servern med nftables. För närvarande hanterar denna server upp till 30Gbit/s vid 3Mpps och kan tydligt nå det fysiska nätverksbegränsningen på 40Gbps, samtidigt som CPU-resurserna fortfarande är lediga.
Jag hoppas att detta material kommer att vara användbart för nätverksingenjörer som försöker förbättra prestandan för sina servrar.
Källa: habr.com
