

Kapacitetsteamet (eller som vi kallar det internt — kaptir) introducerades redan under Veeam Backup and Replication 9.5 Update 4 under namnet Archive Tier. Idén bakom det är att ge möjlighet att flytta backuper som har fallit utanför det så kallade operationella återställningsfönstret till objektlagring. Detta hjälpte till att frigöra diskutrymme för användare som hade ont om det. Denna funktion kallades Move Mode.
För att utföra denna relativt enkla (som det verkar) åtgärd krävdes det att två villkor uppfylls: alla punkter från den flyttade backupen måste ligga utanför det ovan nämnda operationella återställningsfönstret, vilket anges tydligt i användargränssnittet. Och för det andra: kedjan måste vara i så kallad "förseglad form" (sealed backup chain eller Inactive Backup Chain). Det betyder att det inte sker några förändringar i kedjan över tid.
Men i VBR v10 kompletterades konceptet med nya funktioner — Copy Mode, Sealed Mode och en grej med det svåra namnet Immutability dök upp.
Det är om dessa fascinerande saker vi kommer att prata idag. Först om hur det fungerade i VBR9.5u4 och sedan om förändringarna i den tionde versionen.
Och förlåt mig språkvårdare, men det finns för många termer som är omöjliga att översätta.
Så här kommer det att vara fullt av anglicismer.
Och många gifar.
Och bilder.
- Utan minsta sorg. Artikelns författare.
Som det var
Så, vi börjar med att diskutera operationella återställningsfönstret och sealed backup (eller som de kallas i dokumentationen Inactive Backup Chain). Utan förståelsen av dessa två går det inte att förklara vidare.
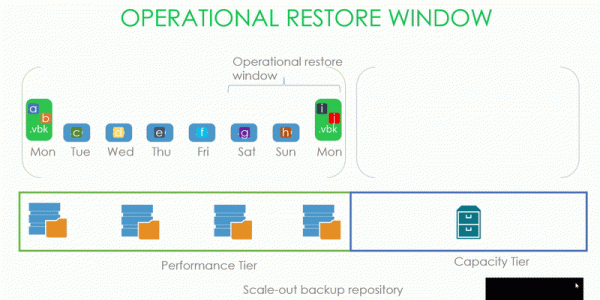
Som vi ser på bilden har vi en viss backupkedja med datablokkar, som ligger på Performance tier av SOBR-repositoriet, som är kopplat till Capacity Tier. Vårt operationella backupfönster är tre dagar.
Därmed förseglade den skapade .vbk-filen kedjan som har ett fönster inställt på tre dagar. Och det betyder att man lugnt kan börja flytta till kapacitetstier allt som är äldre än dessa tre dagar.
Men vad menades egentligen med en sealed kedja och vad kunde skickas till kapacitetstier i update 4?
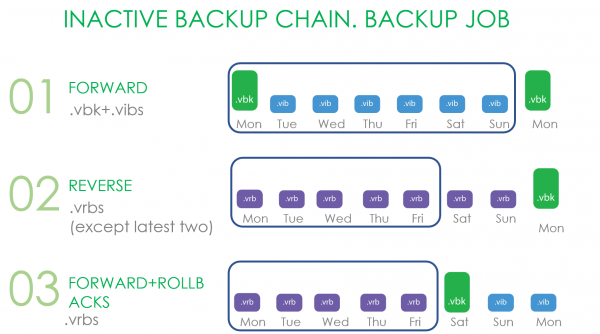
För Forward Incremental är kännetecknet för att kedjan är förseglad att en ny full backup skapas. Och det spelar ingen roll hur denna fulla backup erhålls: både syntetiska fullbackuper och aktiva fullbackuper räknas.
I fallet Reverse är det alla filer som inte faller inom det operationella fönstret.
I fallet Forward increment med rollbacks är det alla rollbacks och .vbk, om det finns en annan .vbk på performance extenten.
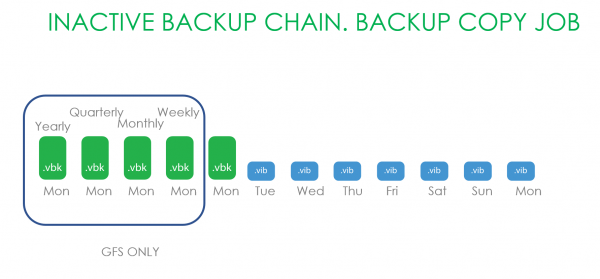
Nu ska vi titta på alternativet att arbeta med Backup Copy-kedjor. Här bevarades endast det som omfattades av GFS-retention. Eftersom allt som finns i nyare backup copy-kedjor kan på olika sätt ha ändrats.
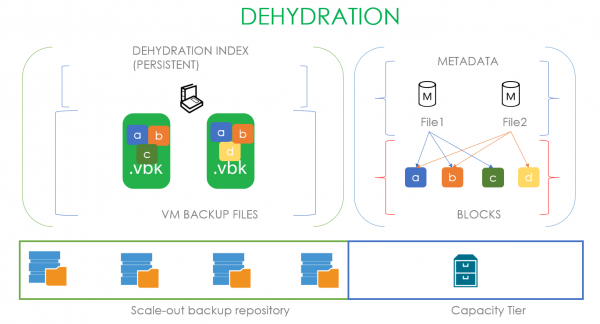
Nu ser vi under huven. Där sker en process som kallas dehydrering - att lämna tomma backupfiler på extenten och flytta block från dessa filer till capacity tier. För att optimera denna process används en så kallad dehydrering-index som gör att vi inte behöver kopiera block som redan har kopierats till capacity tier.
Låt oss se hur detta ser ut med ett exempel: låt oss anta att vi har en .vbk som har gått ut från det operationella fönstret och tillhör en förseglad kedja. Det betyder att vi har full rätt att flytta den till capacity tier. När vi flyttar skapas en metadatas fil i capacity tier och blocken från den flyttade filen. I metadatafilen på länkivå beskrivs av vilka block vår fil består. I bilden består vår första fil av blocken a, b, c och i metadata finns länkar till dessa block. När vi får en andra .vbk-fil, redo att flytta och bestående av block a, b och d, förstår vi genom att analysera dehydrering-index att vi bara behöver flytta block d. Dess metadatafil kommer att innehålla länkar till de två tidigare blocken och ett nytt.
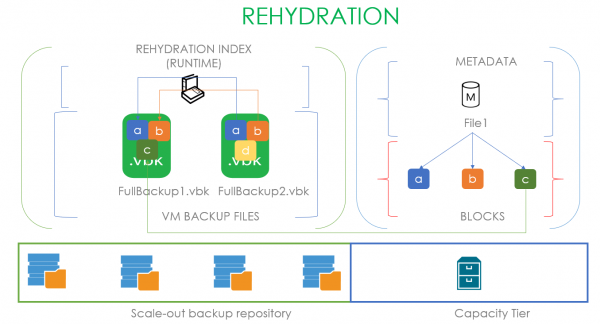
Därför kallas processen för att fylla dessa tomma block med data för rehydrering. Här används redan sitt eget rehydrering-index som baseras på den äldsta .vbk-filen på den lokala performance extenten. Det vill säga, om användaren vill återställa en fil från capacity tier, skapar vi först en index över blocken från den äldsta fulla backupen och flyttar endast de saknade blocken från capacity tier. I det visade fallet, för att rehydrera FullBackup1.vbk enligt rehydrering-indexet saknar vi endast block C, som vi hämtar från capacity tier. Om capacity tier är en molnlagringslösning sparar detta enorma pengar.
Här kan det verka som att denna teknik är identisk med den som används i WAN Accelerators, men det är bara en illusion. I acceleratorer sker en global deduplicering, medan här används lokal deduplicering inom varje fil baserat på ett visst offset. Detta beror på skillnaden i de uppgifter som ska lösas: här behöver vi kopiera stora filer av fullständiga säkerhetskopior, och enligt våra undersökningar ger en sådan dedupliceringsalgoritm bättre resultat även om det går lång tid mellan dem.
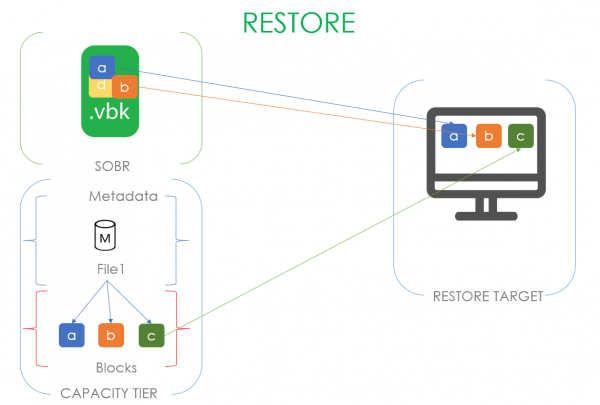
Men fler index till indexens gud! Det finns också ett index för återställning av data! När vi påbörjar återställningen av en maskin som ligger i ett kapacitetsterräng, läser vi bara de unika databloken som inte finns i prestandaterräng.
Som det blev
Detta avslutar introduktionen. Den är ganska detaljerad, men som nämnts ovan går det inte att förklara hur de nya funktionerna fungerar utan dessa detaljer. Så utan fler förord övergår vi till det första.
Kopieringsläget
Även om det till stor del bygger på existerande teknologier, bär det med sig en helt annan logik för användning.
Målet med detta läge är att säkerställa att all data som finns på det lokala utrymmet har en kopia i kapacitetsterrängen.
Om vi jämför Move och Copy-lägena direkt, ser det ut så här:
- Flyttning kan endast ske för en låst kedja. I kopieringsläget transporteras allt, oavsett vad som händer i säkerhetskopieringsjobbet.
- Flyttning aktiveras när filer går utanför fönstret för operationell säkerhetskopiering, medan kopiering aktiveras så snart säkerhetskopieringsfilen blir tillgänglig.
- Övervakning av nya data för kopiering sker kontinuerligt, medan flyttning aktiverades var fjärde timme.
Vid framställningen av det nya läget föreslår jag att vi börjar med enkla exempel och går mot mer komplicerade.
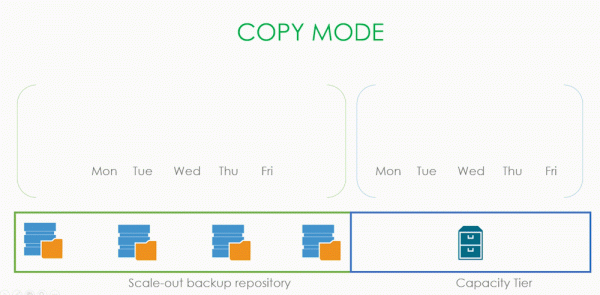
I det mest grundläggande fallet dyker det helt enkelt upp nya filer med inkrement, och vi kopierar dem till kapacitetsterrängen. Oavsett vilket läge som används i säkerhetskopieringsjobbet, oavsett om det hör till den låsta delen av kedjan eller inte, oavsett om vårt operationella fönster har löpt ut. Vi tog bara och kopierade.
Processen bakom detta är fortfarande dehydrering på det sätt som beskrivits ovan. I kopieringsläge ser den även till att vi inte kopierar block som redan finns i vårt objektlager. Den enda skillnaden är att om vi i flyttläge ersatte riktiga filer med platshållarfiler, så rör vi dem inte här utan lämnar allt som det är. I övrigt är detta precis samma dehydreringindex som noggrant försöker spara dina pengar och tid.
Frågan uppstår — om man tittar på användargränssnittet finns det möjlighet att välja båda alternativen samtidigt. Hur kommer ett sådant kombinerat läge att fungera?
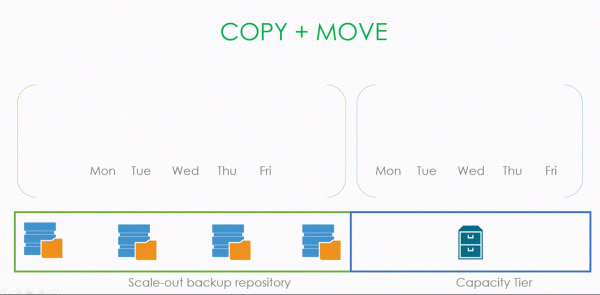
Låt oss reda ut detta.
Inledningen är standard: en backupfil skapas och kopieras direkt. En inkrement skapas och kopieras också. Detta fortsätter tills vi inser att filer har passerat vårt operationella fönster och en innesluten kedja har uppstått. Vid denna punkt utför vi dehydrationsoperationen och ersätter dessa filer med platshållare. Naturligtvis kopierar vi ingenting tillbaka till kapacitetstjärnan.
All denna spännande logik styrs av bara en kryssruta i gränssnittet: Copy backups to object storage as soon as they are created.
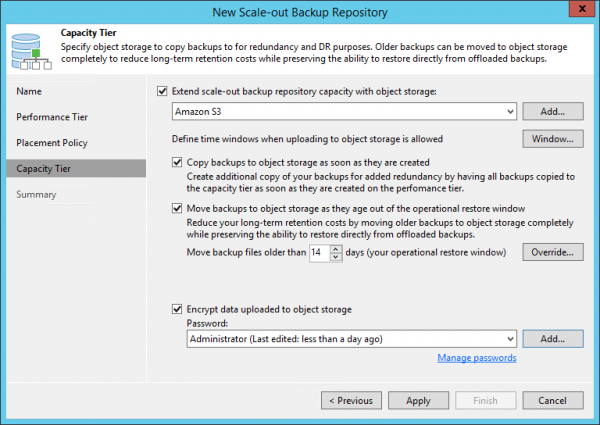
Men varför behöver vi detta kopieringsläge?
Det är ännu bättre att omformulera frågan så här — vilka risker skyddar vi oss ifrån med hjälp av det? Vilket problem hjälper det oss att lösa?
Svaret är uppenbart: självklart handlar det om dataräddning. Om vi har en fullständig kopia av lokala data i objektlagret, så spelar det ingen roll vad som händer med vår produktion, vi kan alltid återställa data från filer som finns i den hypotetiska Amazon.
Därför låt oss gå igenom möjliga scenarier, från det enklaste till det mer komplexa.
Den enklaste olyckan som kan drabba oss är när en av filerna i backupkedjan blir otillgänglig.
En mer sorglig historia är om en av extensorna i vårt SOBR-repositorium har gått sönder.
Det blir ännu värre när hela SOBR-repositoriet har blivit otillgängligt, men kapacitetstjärnan fungerar.
Och allt är verkligen dåligt — det är när backupservern dör och din första impuls är att försöka springa till den kanadensiska gränsen på tio minuter.
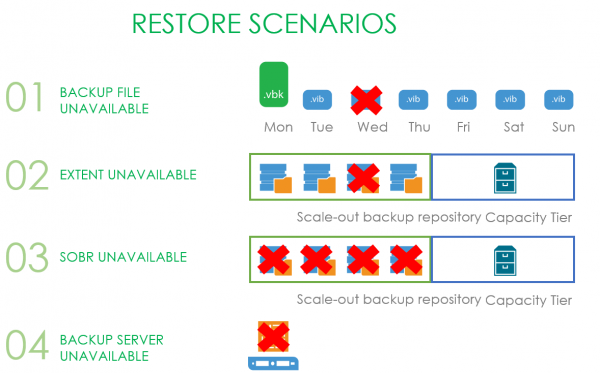
Och nu låt oss gå igenom varje situation separat.
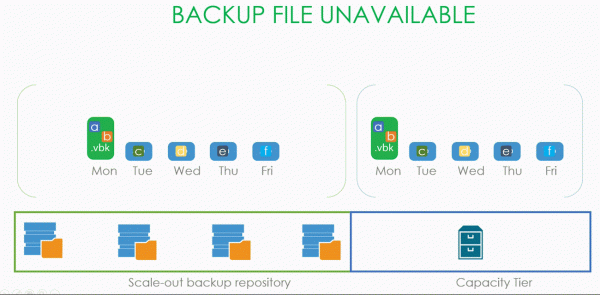
När vi förlorade en (ja, och till och med flera) backupfiler, räcker det med att starta processen för att skanna om lagret, och den förlorade filen ersätts av en tom fil. Med hjälp av återhydratiseringsprocessen (som nämnts i inledningen av artikeln) kan användaren ladda ner data från kapacitetslagret till det lokala lagret.
Nu blir situationen mer komplicerad. Anta att vår SOBR består av två extenter som arbetar i prestandaläge, vilket innebär att våra .vbk och .vib är fördelade över dem med ganska ojämn täckning. Vid en viss tidpunkt blir en av extenterna otillgänglig, och användaren behöver snabbt återställa en maskin vars data delvis ligger just på denna extention.
Användaren startar återställningsguiden, väljer en punkt att återställa till, och i processen inser guiden att alla nödvändiga data för återställning inte finns lokalt och därför måste laddas ner från kapacitetslagret. Under tiden kommer de block som finns kvar på det lokala lagret inte att laddas ner från molnet. Tack vare restore-indexet (ja, det nämndes också i inledningen av artikeln).
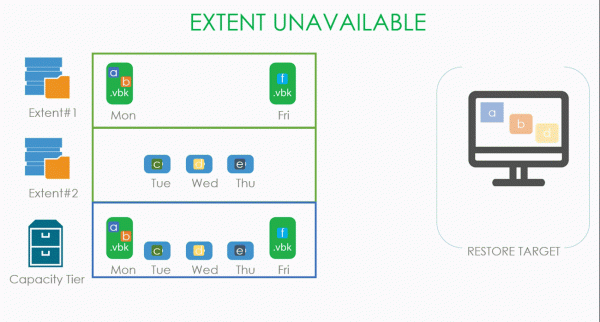
En underkategori av detta fall är att hela SOBR-lagret blivit otillgängligt. I så fall har vi inget att kopiera från de lokala lagren, och alla block laddas ner från molnet.
Och den mest intressanta situationen är att backupservern har kraschat. Här finns det två alternativ: administratören är duktig och har gjort konfigurationsbackups, eller så har administratören själv varit en elak Puppa och inte gjort en konfigurationsbackup.
I det första fallet räcker det med att på något sätt installera en ren version av VBR och återställa dess databas från backup med hjälp av de inbyggda verktygen. I slutet av denna process kommer allt att återgå till det normala. Eller så kommer återställningen att ske enligt något av de ovan nämnda scenarierna.
Men om administratören är sin egen fiende, eller om backupkonfigurationen drabbas av en sagolik otur, kommer vi inte att överge dem åt sitt öde. För detta fall har vi infört en ny procedur som kallas Import Object Storage. Denna procedur möjliggör att hoppa över den manuella återställningen av SOBR-repositoriet och kopplingen av kapacitetstiran med efterföljande skanning, och helt enkelt lägga till objektlagring i Vima-gränssnittet och starta Import Storage Repository- proceduren. Det enda som kan stå i vägen mellan dig och dina backuper är en begäran om att ange ett lösenord om dina backuper har krypterats.
Detta var allt om Copy Mode, och vi går vidare till
Sealed Mode
Det grundläggande syftet är att inga nya backuper får skapas på den valda delen av SOBR-repositoriet. Fram till version 10 hade vi bara Maintenance Mode, där all verksamhet med repositoriet var helt förbjuden. Det var en hård kärnprocess som stängde lagringen, där endast knappen Evacuate var tillgänglig, vilket en gång förde bort backuperna till en annan del.
Sealed Mode är en slags 'mjuk' version: vi förhindrar skapandet av nya backuper och tar gradvis bort gamla enligt den valda retentionen, men förlorar inte möjligheten att återställa från de lagrade punkterna. Mycket användbart när maskinens livslängd närmar sig sitt slut och den behöver bytas ut, eller när den helt enkelt behöver frigöras för något viktigare, och det finns ingen möjlighet att flytta allt på en gång. Eller så kan det vara omöjligt att ta bort.
Därför är arbetsprincipen ganska enkel: man måste förbjuda alla skrivoperationer (skapande av nya data), och lämna läsningar (återställningar) och radering (retention).
Båda lägena kan användas samtidigt, men man måste också beakta att Maintenance har högre prioritet.
Som exempel överväger vi en SOBR bestående av två delar. Anta att vi under de första fyra dagarna skapat backuper i läget Forward Forever Incremental, och sedan stänger vi den ena delen. Detta leder till att vi initierar skapandet av en ny aktiv full återställning på den andra tillgängliga delen. Om vår retention är fyra, då när hela kedjan som ligger på den stängda delen överskrider dess gränser, kan den utan betänkligheter tas bort.
Det finns situationer där raderingen sker tidigare. Till exempel är detta fallet med Forward incremental med periodiska fulla säkerhetskopior. Om vi har skapat fulla säkerhetskopior de första två dagarna, och på torsdag bestämmer vi oss för att stänga lagringsutrymmet, så när vi på fredag skapar en ny fullständig säkerhetskopiering kommer filen från måndag att raderas eftersom det vid denna tidpunkt inte finns några beroenden. Och själva punkten är inte beroende av någon annan. Därefter väntar vi tills fyra punkter har skapats på det tillgängliga utrymmet och raderar de tre kvarstående, som inte kan raderas oberoende av varandra.
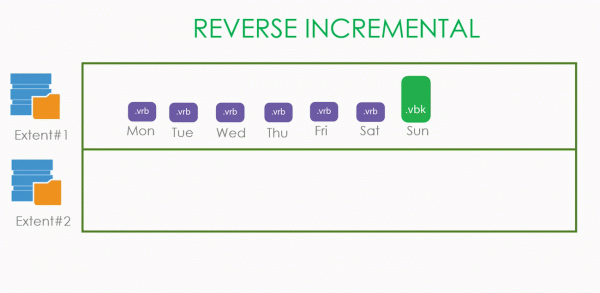
Det är enklare med Reverse Incremental. I det fallet är de äldsta punkterna oberoende och kan raderas utan problem. Så snart det nya .vbk har skapats på det nya utrymmet, kommer de gamla .vrb att raderas en och en.
För övrigt, varför skapar vi varje gång en ny .vbk: om vi inte gör det och fortsätter den gamla inkrementella kedjan, skulle den gamla .vbk hänga kvar för en oändligt lång tid i vilket läge som helst, vilket hindrar radering. Därför fattades beslutet att så snart utrymmet stängs, skapar vi en fullständig säkerhetskopiering på ett ledigt utrymme.
Svårare är situationen med kapacitetstira.
Först ser vi på copy mode. Anta att vi har skapat säkerhetskopior aktivt i fyra dagar, och sedan stängdes kapacitetstiran. Vi raderar ingenting, utan tålamod väntar vi på retentionen, varefter vi raderar data från kapacitetstiran.
Ungefär samma sak händer i move mode — vi väntar på retentionen, raderar det gamla i det lokala lagret och raderar det som lagras i objektlagret.
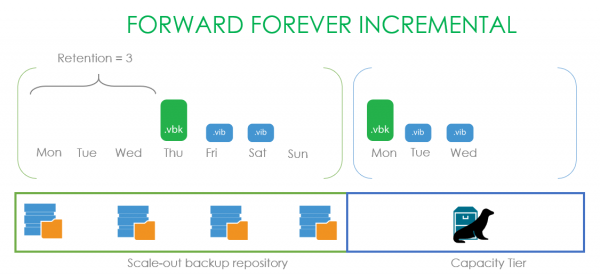
Ett intressant exempel med Forever forward incremental. Vi ställer retentionen till tre punkter och börjar göra säkerhetskopior från måndag, som pålitligt kopieras till molnet. Efter att lagringen stängts fortsätter säkerhetskopiorna att skapas, vilket upprätthåller tre punkter, men de data som lagras i kapacitetstiran förblir beroende och kan inte raderas. Därför väntar vi till torsdag när vår .vbk går utanför retentionen, och först då raderar vi hela den sparade kedjan.
Och en liten kommentar: alla exempel här visas med en maskin. Om ni har flera i säkerhetskopian kommer retentionen att skilja sig beroende på om en Aktiv Full har gjorts eller inte.
Detta är, i princip, allt. Så vi går vidare till den mest hardcore-funktionen —
Immutability
Precis som med de tidigare punkterna, börjar vi med att förklara vilket problem denna funktion löser. Så snart vi laddar upp våra säkerhetskopior för lagring, uppstår en stark önskan att garantera deras säkerhet, det vill säga att fysiskt förbjuda deras radering och all modifiering under den angivna retentionstiden. Detta inkluderar administratörer, även under deras root-konton. Detta gör det möjligt att skydda dem mot oavsiktlig eller avsiktlig skada. Den som arbetar med AWS kan ha stött på en liknande funktion kallad Object Lock.
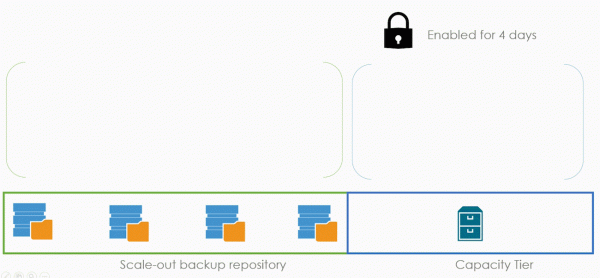
Låt oss nu titta på läget i allmänna ordalag, och sedan dyka djupare in i detaljerna. I vårt exempel kommer Immutability att aktiveras för vår kapacitetstier med en retention på fyra dagar. Och i säkerhetskopian aktiveras kopieringsläget.
Immutability interagerar inte med den allmänna retentionen. Till exempel lägger det inte till några extra punkter eller liknande. Under fyra dagar kan personen inte ta bort säkerhetskopiornas filer. Om en säkerhetskopia görs på måndag, kan filen tas bort först på fredag.
Alla tidigare förklarade koncept av dehydrering, index och metadata fortsätter att fungera på exakt samma sätt. Men med ett villkor — blocket sätts inte bara för datan, utan också för metadata. Detta görs ifall en listig angripare skulle besluta att radera vår metadata-databas, så att datablocken inte förvandlas till en meningslös binär röra.
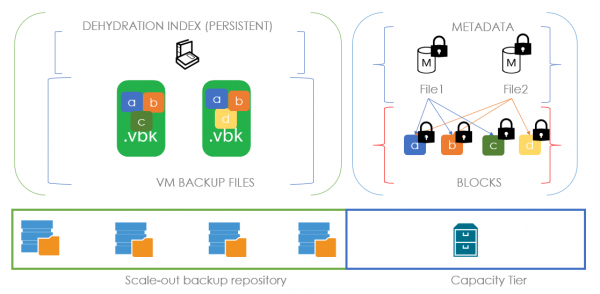
Och nu är det ett utmärkt tillfälle att förklara vår blockgenereringsteknik. Eller block generation. För detta kommer vi att betrakta situationen som ledde till dess uppkomst.
Låt oss ta en tidslinje på sex dagar och markera tiden för förväntad utgång av immutability längst ner. Vi skapar en fil på den första dagen som består av datablocket a och dess metadata. Om immutability är inställt på tre dagar, är det rimligt att anta att data kommer att låsas upp och tas bort på den fjärde dagen. På den andra dagen lägger vi till en ny file2 som består av block b med samma inställningar. Block a bör fortfarande tas bort på den fjärde dagen. Men på den tredje dagen händer något hemskt — en fil File3 skapas som består av det nya blocket d och en länk till det gamla blocket a. Detta innebär att immutability-flagg för block a måste ställas om till en ny period, som flyttas till den sjätte dagen. Och här uppstår problemet — i verkliga säkerhetskopior av sådana block uppstår en stor mängd. För att förlänga deras immutability-period måste vi hela tiden göra en stor mängd förfrågningar. Detta blir i praktiken en nästan oändlig daglig process, eftersom vi med stor sannolikhet kommer att hitta stora högar av deduplicerade block vid varje kopiering. Vad innebär detta stora antal förfrågningar för leverantörer av objektlagring? Rätt! En enorm räkning i slutet av månaden.
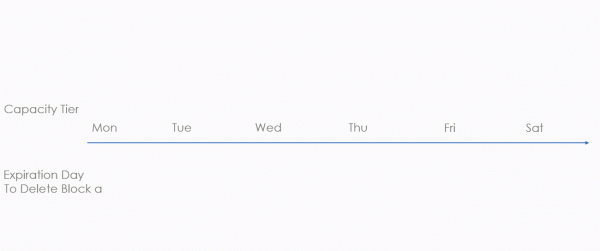
Och för att inte fakturera sina älskade kunder med stora summor för inget, har mekanismen block generation skapats. Detta är en tilläggsperiod som vi lägger till den befintliga immutability-perioden. I exemplet nedan är en sådan period två dagar. Men detta är bara för exemplet. I verkligheten används en egen formel som ger ungefär tio ytterligare dagar vid en månads lås.
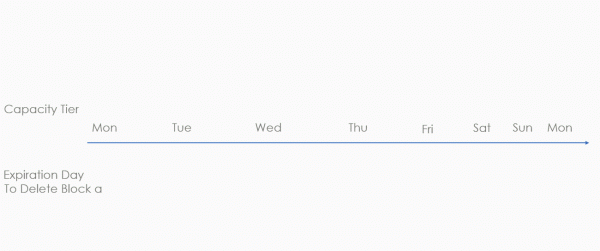
Vi fortsätter att överväga samma situation, men med blockgenerering. Den första dagen skapar vi filen file1 från block a och metadata. Vi sammanställer generationsperioden och oföränderliga data — vilket innebär att filen kan tas bort först på sjätte dagen. Om vi på andra dagen skapar File2, som består av block b och en länk till block a, händer inget med den förväntade borttagningsdatumet. Den förblev som tidigare på sjätte dagen. Vi försöker således spara pengar på antalet förfrågningar. Den enda situation där tidsperioden kan flyttas är om generationsperioden har gått ut. Om det på tredje dagen nya File3 innehåller en länk till block a, kommer generation 2 att läggas till eftersom Gen1 redan har gått ut. Det förväntade borttagningsdatumet för block a flyttas då till åttonde dagen. Detta gör att vi dramatiskt kan minska antalet förfrågningar för att förlänga livslängden för deduplicerade block, vilket sparar mycket pengar för kunderna.
Själva teknologin är tillgänglig för S3-användare och S3-kompatibel hårdvara, vars tillverkare garanterar att deras implementationer inte skiljer sig från Amazons. Därför svarar vi på den berättigade frågan om varför Azure inte stöds — de har en liknande funktion, men den fungerar på kontonivå, inte på enskilda objekt. Förresten, i själva Amazon finns objektlokalisering i två lägen: compliance och governance. I det andra fallet finns möjligheten kvar för den högsta administratören av alla administratörer och roten av alla rötter, trots objektlokaliseringen, att radera data. I compliance-läget är allt spikat för alltid och ingen kan ta bort säkerhetskopior, inte ens Amazons administratörer (enligt deras officiella uttalanden). Vi stöder just det läget.
Och, traditionellt, lite användbara länkar:
- Om i alla detaljer.
- All information om i bästa skick
- Till i detalj
Källa: habr.com
