

Idag finns det 100500 kurser i Data Science, och det är länge känt att man kan tjäna mest pengar på Data Science genom kurser i Data Science (varför gräva när man kan sälja spadar?). Den största nackdelen med dessa kurser är att de inte har något att göra med verkligt arbete: ingen kommer att ge dig rena, bearbetade data i rätt format. Och när du går ut från kurserna och börjar lösa en riktig uppgift, dyker det upp många nyanser.
Därför startar vi en serie artiklar "Vad kan gå fel med Data Science", baserade på verkliga händelser som har hänt mig, mina vänner och kollegor. Vi kommer att analysera typiska Data Science-uppgifter med verkliga exempel: hur det verkligen går till. Vi börjar idag med uppgiftshantering av datasamling.
Och det första som folk snubblar över när de börjar arbeta med verkliga data är just själva insamlingen av dessa relevanta data. Huvudbudskapet i den här artikeln:
Vi underskattar systematiskt tid, resurser och insatser för insamling, rengöring och förberedelse av data.
Och viktigast av allt, vi kommer att diskutera vad man ska göra för att undvika detta.
Enligt olika uppskattningar tar rengöring, omvandling, databehandling, feature engineering osv 80-90% av tiden, medan analysen tar 10-20%, medan nästan allt studiematerial fokuserar enbart på analys.
Låt oss bryta ner ett enkelt analytiskt problem i tre varianter som ett typiskt exempel och se vilka 'försvårande omständigheter' som kan förekomma.
Och som exempel kommer vi återigen att betrakta sådana variationer av datasamlingens uppgift och jämförelse av samhällen för:
- Två subreddits på Reddit
- Två avsnitt på Habré
- Två grupper på Odnoklassniki
Hypotetisk metod inom teorin
Öppna webbplatsen och läs exempel, om det är förståeligt, avsätta några timmar för läsning, några timmar för kod utifrån exemplen och felsökning. Lägg till några timmar för insamling. Lägg till några timmar som buffert (multiplicera med två och lägg till N timmar).
Huvudpoängen: tidsbedömningen baseras på antaganden och gissningar om hur lång tid detta kommer att ta.
Analysen av tiden bör inledas med att bedöma följande parametrar för den hypotetiska uppgiften som beskrivits ovan:
- Vad är datastorleken och hur mycket av den behöver samlas fysiskt (*se nedan*).
- Hur lång tid tar det att samla in en post och hur länge måste man vänta innan man kan samla in nästa.
- Inkludera kodskrivning för att spara tillstånd och påbörja omstart när (inte om) allt kraschar.
- Ta reda på om vi behöver autentisering och inkludera tid för att få åtkomst via API.
- Inkludera antalet fel som en funktion av datakomplexitet — bedöm detta utifrån den specifika uppgiften: struktur, hur många transformationer, vad och hur vi extraherar.
- Inkludera nätverksfel och problem med oönskat beteende i projektet.
- Bedöm om de nödvändiga funktionerna finns i dokumentationen, och om de inte gör det, hur mycket som behövs för en workaround.
Det viktigaste är att för tidsbedömning — ni måste verkligen avsätta tid och ansträngningar för 'reconnaissance by combat' — endast då blir er planering adekvat. Så oavsett hur mycket ni pressas att säga 'hur länge tar det att samla in data' — ge er tid för en föranalys och argumentera för hur mycket tiden kan variera beroende på uppgiftens verkliga parametrar.
Och nu kommer vi att visa konkreta exempel där sådana parametrar kommer att variera.
Nyckelpunkten: bedömningen baseras på analys av de huvudsakliga faktorer som påverkar omfattningen och komplexiteten av arbetet.
En gissningsbaserad bedömning är en bra metod när de funktionella elementen är tillräckligt små och det inte finns så många faktorer som kan påverka uppgiftens struktur avsevärt. Men i fallet med vissa Data Science-uppgifter blir dessa faktorer extremt många och en sådan metod blir otillräcklig.
Jämförelse av Reddit-gemenskaper
Låt oss börja med det enklaste fallet (som senare visar sig vara fallet). Ärligt talat, när vi ser på det så har vi nästan ett perfekt fall som vi ska kontrollera vår svårighetschecklista med:
- Det finns ett ordnat, tydligt och väldokumenterat API.
- Mycket enkelt och framför allt får vi automatiskt en token.
- Det finns — med massor av exempel.
- Gemenskapen som sysslar med analys och insamling av data på Reddit (inklusive YouTube-videor som förklarar hur man använder python wrapper) .
- De metoder vi behöver finns troligen i API:et. Dessutom ser koden kompakt och ren ut, nedan är ett exempel på en funktion som samlar in kommentarer på ett inlägg.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Taget från en samling användbara verktyg för inslagning.
Trots att vi har det bästa scenariot här, är det ändå viktigt att ta hänsyn till ett antal viktiga faktorer från verkliga livet:
- API-gränser — vi måste hämta data i batcher (pausa mellan förfrågningarna osv.).
- Insamlingstiden — för en fullständig analys och jämförelse måste vi avsätta betydande tid för att bara låta spindeln gå igenom subreddit.
- Boten måste köras på en server — du kan inte bara starta den på din bärbara dator, stoppa den i väskan och åka iväg. Därför körde jag allt på en VPS. Med rabattkoden habrahabr10 kan du spara ytterligare 10% på kostnaden.
- Fysisk otillgänglighet av vissa data (de är synliga för administratörer eller är för svåra att samla in) — detta måste beaktas, inte alla data kan i princip samlas in på rimlig tid.
- Nätverksfel: arbete med nätverk är smärtsamt.
- Detta är riktiga levande data — de är aldrig rena.
Självklart måste man ta hänsyn till de angivna nuanserna i utvecklingen. De specifika timmarna/dagarna beror på utvecklingserfarenhet eller erfarenhet av liknande uppgifter, men vi ser att uppgiften här är uteslutande ingenjörsmässig och inte kräver några ytterligare åtgärder för att lösa — allt kan bedömas, beskrivas och göras mycket bra.
Jämförelse av Habr-sektioner
Vi går vidare till ett mer intressant och icke trivialt fall av jämförelse mellan flöden och/eller Habr-sektioner.
Vi kommer att kontrollera vår svårighetschecklista — här, för att förstå varje punkt, måste man redan experimentera med själva uppgiften och göra tester.
- Först tror du att det finns ett API, men det gör det inte. Ja, Habr har ett API, men det är bara inte tillgängligt för användare (eller kanske fungerar det inte alls).
- Sedan börjar du helt enkelt att parsa html — "import requests", vad kan gå fel?
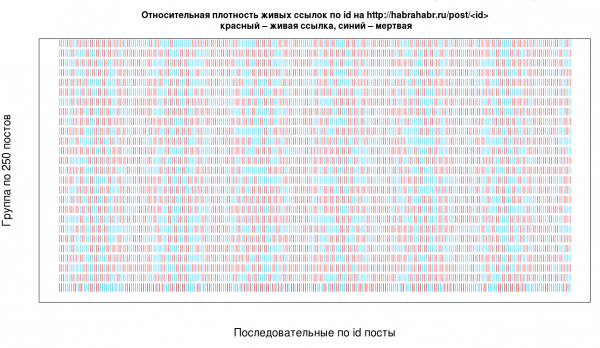
- Hur parsar man överhuvudtaget? Det enklaste och mest använda tillvägagångssättet är att iterera över ID, vi noterar att det inte är det mest effektiva och vi kommer att behöva hantera olika fall — här är ett exempel på densiteten av verkliga ID bland alla som finns.

Taget från artiklar. - Rådata som är insvept i HTML över nätverket är en plåga. Till exempel, om du vill samla in och spara artikels poäng: du har extraherat poäng från HTML och beslutat att spara det som ett nummer för vidare behandling:
1) int(score) ger ett fel: eftersom det på Habré är minus, som i strängen "–5" — det är ett kort bindestreck, inte minus tecken (överraskande, eller hur?), så vid något tillfälle fick man väcka upp parsern med en sådan hemsk fix.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
Det kan hända att det inte alls finns några datum, plus eller minus (som vi ser ovan i funktionen check_date, och sådant har hänt).
2) Oskyddade specialtecken — de kommer, så man måste vara beredd.
3) Strukturen förändras beroende på typen av inlägg.
4) Gamla inlägg kan ha **konstig struktur**.
- I grunden måste felhantering och vad som kan eller inte kan hända hanteras, och man kan inte förutsäga vad som kommer att gå fel och hur strukturen kan se ut, man får helt enkelt försöka och ta hänsyn till de fel som parsers ger.
- Sen inser du att du behöver parsa i flera trådar, annars tar det över 30 timmar att parsa i en enda tråd (detta är rent exekveringstid för en fungerande entrådsparser som sover och inte hamnar under några bannlysningar). I artikeln ledde det vid något tillfälle till ett sådant schema:
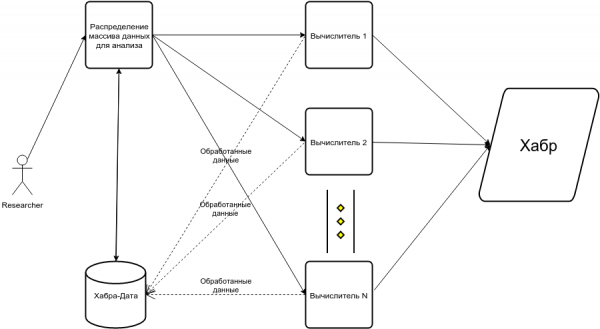
Här är checklistan över svårigheterna:
- Arbeta med nätverket och parsa HTML med iteration och ID-överskrift.
- Dokument med heterogen struktur.
- Många ställen där koden lätt kan falla.
- Det är nödvändigt att skriva || kod.
- Det saknas nödvändig dokumentation, kodexempel och/eller samhälle.
Den tidsmässiga bedömningen för denna uppgift kommer att vara 3-5 gånger större än för att samla in data från Reddit.
Jämförelse av grupper i Odnoklassniki
Låt oss gå vidare till det mest tekniskt intressanta fallet bland de som beskrivs. För mig var det intressant just för att det vid första anblick verkar ganska trivialt, men så är det verkligen inte — så fort du petar på det med en pinne.
Vi börjar med vår svårighetschecklista och noterar att många av dem kommer att visa sig vara mycket svårare än de verkar i början:
- API finns, men nästan helt saknar de nödvändiga funktionerna.
- Vissa funktioner måste begäras åtkomst till via e-post, så tilldelningen av åtkomst är inte omedelbar.
- Det är fruktansvärt dokumenterat (för att börja med, blandas ryska och engelska termer överallt, och det görs helt inkonsekvent — ibland måste du helt enkelt gissa vad de vill ha från dig någonstans) och dessutom passar det inte designmässigt för att hämta data, till exempel .
- Det kräver session i dokumentationen, men i praktiken använder det inte detta — och det finns inget sätt att förstå alla detaljer i API-lägena, förutom att pröva sig fram och hoppas att något fungerar.
- Det finns inga exempel eller community, den enda stödpunkten för att samla information är en liten i Python (utan ett stort antal exempel på användning).
- Det mest fungerande alternativet verkar vara Selenium, eftersom många av de nödvändiga uppgifterna är låsta.
1) Det vill säga att autentisering sker genom en skenbar användare (och registrering för hand).2) Men med Selenium finns det inga garantier för korrekt och repeterbar funktion (i alla fall i fallet med ok.ru definitivt).
3) Ok.ru-webbplatsen innehåller JavaScript-fel och beter sig ibland konstigt och inkonsekvent.
4) Man måste hantera paginering, laddning av element osv ...
5) API-fel som wrapper ger måste hanteras på ett hackigt sätt, till exempel så här (ett avsnitt av experimentell kod):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#makes sense to keep track of already processed discussions
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Min favoritfel var:
OdnoklassnikiError("Error(code: 'None', description: 'HTTP error', method: 'discussions.getComments', params: …)")6) I slutändan verkar kombinationen av Selenium + API vara det mest rationella alternativet.
- Det krävs bevarande av tillstånd och omstart av systemet, hantering av många fel, inklusive inkonsekvent beteende från webbplatsen — dessutom är dessa fel ganska svåra att föreställa sig (om du inte professionellt skriver parsers, förstås).
Den uppskattade tiden för denna uppgift kommer att vara 3-5 gånger längre än för att samla in data från Habr. Trots att vi i fallet med Habr använder en rak approach med HTML-parsing, kan vi i kritiska lägen arbeta med API i fallet med OK.
Slutsatser
Oavsett hur mycket ni kanske blir ombedda att ge en tidsuppskattning "på plats" (vi har ju planering idag!) för det omfattande databehandlingsmodulen, är det praktiskt taget aldrig möjligt att bedöma utförandet kvalitativt utan en analys av uppgiftsparametrarna.
Om man pratar lite mer filosofiskt, så passar strategier för bedömningar inom agile bra för ingenjörsuppgifter, men med uppgifter som är mer experimentella och på något sätt "kreativa" och forskande, det vill säga mindre förutsägbara, uppstår svårigheter, liknande de exempel vi diskuterat här.
Självklart är datainsamling en tydlig illustrativ exempel — vanligtvis verkar det vara en otroligt enkel och tekniskt okomplicerad uppgift, och just i detaljerna här döljer sig ofta djävulen. Och just på detta uppdrag kan man visa hela spektrumet av möjliga alternativ på vad som kan gå fel och hur mycket arbetet kan dra ut på tiden.
Om man snabbt kollar på uppgiftens egenskaper utan ytterligare experiment, så ser Reddit och OK liknande ut: det finns API, python wrapper, men i själva verket är skillnaden enorm. Om man bedömer utifrån dessa parametrar, så verkar parsing av Habr vara mer komplicerat än OK — men i praktiken är det precis tvärtom och det kan man avgöra genom att utföra enkla experiment för att analysera uppgiftens parametrar.
Utifrån min erfarenhet är den mest effektiva metoden att göra en ungefärlig tidsuppskattning för den inledande analysen och de första experimenten, läsningen av dokumentationen — det är dessa som gör att du kan ge en exakt uppskattning för hela arbetet. I termer av den populära agile-metodologin — jag ber om att få ett ärende under "bedömning av uppgiftens parametrar", baserat på vilket jag kan ge en uppskattning av vad som kan genomföras inom ramen för "sprinten" och ge en mer exakt bedömning för varje uppgift.
Därför verkar det mest effektiva argumentet vara att förklara för en "icke-teknisk" specialist hur mycket tid och resurser som kan variera beroende på parametrarna som fortfarande ska bedömas.
Källa: habr.com
