

Marknaden för distribuerad databehandling och big data växer, om man får tro , med 18-19 % per år. Det innebär att valet av programvara för dessa ändamål förblir aktuellt. I detta inlägg börjar vi med att förklara varför distribuerad databehandling behövs, vi går närmare in på urvalet av mjukvara, berättar om användningen av Hadoop med hjälp av Cloudera, och avslutningsvis diskuterar vi valet av hårdvara och hur detta på olika sätt påverkar prestandan.
Varför är distribuerad databehandling viktigt i vanlig affärsverksamhet? Det är både enkelt och komplicerat samtidigt. Enkelt — eftersom vi i de flesta fall gör relativt okomplicerade beräkningar på enheter av information. Komplicerat — eftersom det finns mycket av sådan information. Väldigt mycket. Som en följd måste vi . På så sätt är användningsscenarierna ganska universella: beräkningar kan tillämpas överallt där man behöver ta hänsyn till ett stort antal mätvärden på en ännu större datamängd.
Ett av de senaste exemplen: pizza kedjan Dodo Pizza baserat på analys av kundernas beställningsdatabas, vilket visar att när de väljer pizza med en valfri topping använder användarna vanligtvis bara sex grundläggande ingrediensuppsättningar plus några slumpmässiga. I enlighet med detta anpassade pizzerian sina inköp. Dessutom lyckades de bättre rekommendera ytterligare produkter till kunderna under beställningsprocessen, vilket ledde till ökad lönsamhet.
Ett annat exempel: produkter gjorde att butiken H&M kunde minska sortimentet i vissa butiker med 40 %, samtidigt som försäljningsnivån upprätthölls. Detta åstadkoms genom att utesluta dåligt säljande artiklar, där säsongsvariationer beaktades.
Val av verktyg
Branschstandarden för denna typ av beräkningar är Hadoop. Varför? För att Hadoop är ett utmärkt, väl dokumenterat ramverk (den samme Habr publicerar många detaljerade artiklar om detta), som kommer med ett helt set av verktyg och bibliotek. Du kan mata in stora mängder både strukturerade och ostrukturerade data, och systemet kommer automatiskt att fördela dem mellan beräkningsresurserna. Dessutom kan dessa resurser när som helst ökas eller stängas av — den horisontella skalbarheten i aktion.
År 2017 hävdade det inflytelserika konsultföretaget Gartner , att Hadoop snart skulle bli föråldrat. Anledningen är ganska banal: analytiker tror att företag kommer att migrera massivt till molnet, eftersom de där kan betala för faktisk användning av beräkningsresurser. En annan viktig faktor som påstås kunna 'begravda' Hadoop är hastigheten. Alternativ som Apache Spark eller Google Cloud DataFlow arbetar snabbare än MapReduce, som ligger till grund för Hadoop.
Hadoop vilar på flera pelare, de mest framträdande är MapReduce-teknologierna (ett system för datadistribution för beräkningar mellan servrar) och filsystemet HDFS. Det senare är speciellt utformat för att lagra information som är distribuerad över klusterets noder: varje block av fast storlek kan placeras på flera noder, och genom replikering säkerställs systemets motståndskraft mot fel på enskilda noder. Istället för en filtabell används en speciell server som kallas NameNode.
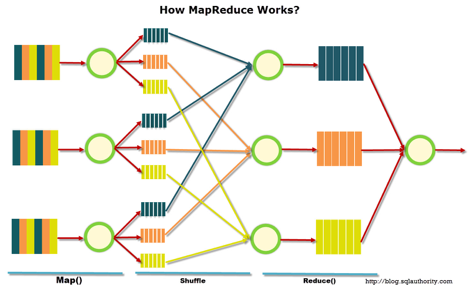
I illustrationen nedan visas hur MapReduce fungerar. I det första steget delas data upp utifrån ett visst kännetecken, i det andra distribueras de över beräkningsresurserna, och i det tredje sker beräkningen.
Ursprungligen utvecklades MapReduce av Google för deras sökmotor. Två därefter gjorde MapReduce öppen källkod, och projektet togs över av Apache. Google har gradvis migrerat till andra lösningar. En intressant detalj är att Google för närvarande har ett projekt kallat Google Cloud Dataflow, som positioneras som nästa steg efter Hadoop, som en snabb ersättning.
Vid närmare granskning framgår det att Google Cloud Dataflow baseras på en variant av Apache Beam, och att Apache Beam inkluderar det väldokumenterade ramverket Apache Spark, vilket gör att man kan säga att hastigheten på utförandet är praktiskt taget identisk. Dessutom fungerar Apache Spark utmärkt på HDFS, vilket gör att det kan implementeras på Hadoop-servrar.
Om vi lägger till mängden dokumentation och färdiga lösningar för Hadoop och Spark jämfört med Google Cloud Dataflow, blir valet av verktyg uppenbart. Dessutom kan ingenjörerna själva avgöra vilken kod - för Hadoop eller Spark - de ska köra, beroende på uppgiften, erfarenheten och kvalifikationen.
Molnet eller lokal server
Trenden att övergå till molnet har skapat ett intressant begrepp som Hadoop-as-a-service. I detta scenario har administrationen av anslutna servrar blivit mycket viktig. Tyvärr är ren Hadoop ganska komplicerat att konfigurera, eftersom mycket måste göras manuellt. Till exempel att konfigurera servrarna enskilt, övervaka deras prestanda och noggrant ställa in många parametrar. Sammanfattningsvis är det arbete för entusiaster, och det finns en stor risk att något går fel eller att något förbises.
Därför har olika distributioner som från början kommer med användarvänliga verktyg för distribution och administration blivit mycket populära. En av de mest populära distributionerna som stöder Spark och förenklar allt är Cloudera. Den har både betalversioner och gratisversioner – och den senare har all grundläggande funktionalitet utan begränsning av antalet noder.
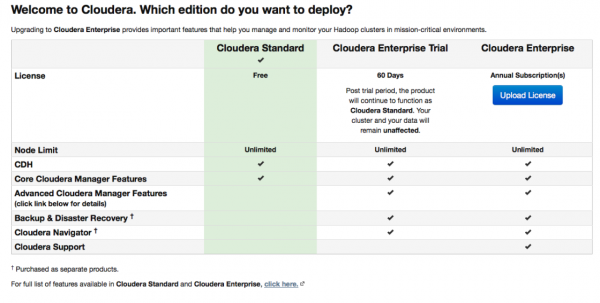
Under installationen kommer Cloudera Manager att ansluta till dina servrar via SSH. En intressant punkt: vid installationen är det bäst att ange att den ska utföras med så kallade paket: speciella paket som innehåller alla nödvändiga komponenter som är inställda för att fungera tillsammans. I grunden är detta en förbättrad version av en pakethanterare.
Efter installationen får vi en kontrollpanel för klustret där vi kan se telemetri för kluster, installerade tjänster, plus att du kan lägga till/ta bort resurser och redigera klusterkonfigurationen.
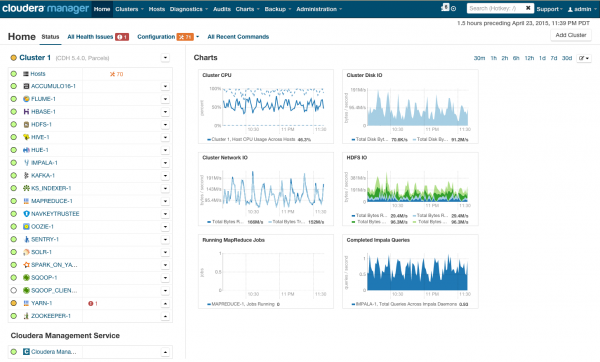
Som resultat får du en sektion av den raket som kommer att föra dig mot en ljus framtid inom Big Data. Men innan vi säger "bekväm resa", låt oss titta under huven.
Krav på hårdvara
På sin webbplats nämner Cloudera olika möjliga konfigurationer. De allmänna principerna för hur de byggs visas i illustrationen:
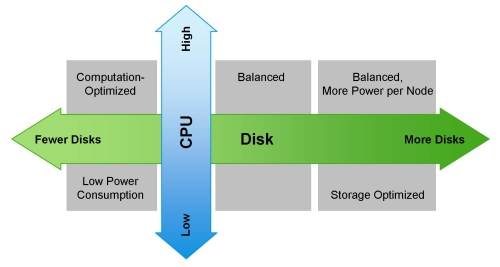
En optimistisk bild kan dämpas av MapReduce. Om man ser på schemat från föregående avsnitt igen blir det uppenbart att nästan alla MapReduce-uppgifter kan stöta på en "flaskhals" vid läsning av data från disken eller nätverket. Detta påpekas också i Clouderas blogg. Därför, för alla snabba beräkningar, inklusive genom Spark, som ofta används för realtidsberäkningar, är hastigheten på in-/utmatning mycket viktigt. Det är därför viktigt att klustret innehåller balanserade och snabba maskiner, vilket medgivetvis inte alltid garanteras i molninfrastrukturen.
Balanseringen i belastningsfördelningen uppnås genom att använda OpenStack-virtualisering på servrar med kraftfulla flerkärniga CPU:er. Dataknutarna tilldelas sina egna processorresurser och specifika diskar. I vår lösning Atos Codex Data Lake Engine uppnås omfattande virtualisering, vilket ger oss fördelar både i prestanda (påverkan från det nätverksinfrastrukturen minimeras) och i TCO (överskott av fysiska servrar undviks).
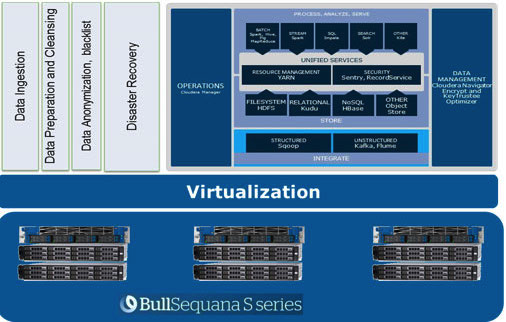
Vid användning av BullSequana S200-servrar uppnår vi en ganska jämn belastning, fri från vissa flaskhalsar. I den minimi-konfiguration ingår 3 BullSequana S200-servrar, var och en med två JBOD, plus valfritt kopplade ytterligare S200 som innehåller fyra dataknutar vardera. Här är ett exempel på belastningen från TeraGen-testet:
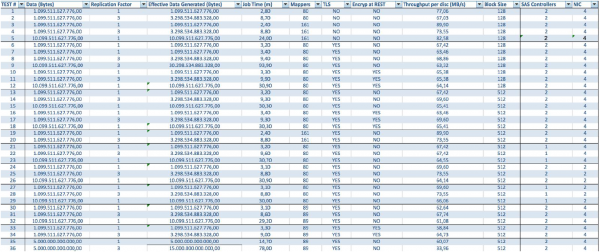
Tester med olika datavolymer och replikationsvärden visar liknande resultat när det gäller belastningsfördelning mellan klustrets noder. Nedan visas en graf över diskåtkomstfördelningen från prestandatesterna.
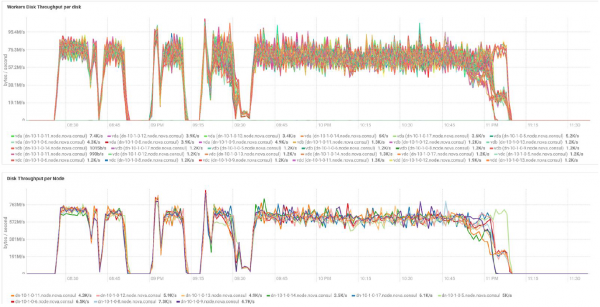
Beräkningarna har genomförts baserat på den minimala konfigurationen av 3 BullSequana S200-servrar. Den inkluderar 9 dataknutar och 3 huvudnoder samt reserverade virtuella maskiner för eventuellt skydd baserat på OpenStack-virtualisering. Resultatet av TeraSort-testet: blockstorlek på 512 MB med en replikationskoefficient av tre med kryptering tar 23,1 minuter.
Hur kan systemet utvidgas? För Data Lake Engine finns olika typer av utvidgningar tillgängliga:
- Dataöverföringsnoder: för varje 40 TB nyttjandeutrymme
- Analytiska noder med möjlighet för GPU-installation
- Andra alternativ beroende på affärsbehov (till exempel om du behöver Kafka och liknande)
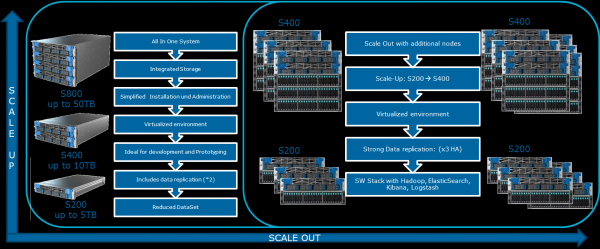
Atos Codex Data Lake Engine består av både servrarna och den förinstallerade programvaran, inklusive Cloudera-paketet med licens; själva Hadoop, OpenStack med virtuella maskiner baserade på RedHat Enterprise Linux-kärnan, datasäkerhetssystem och backup (inklusive med hjälp av backup-nod och Cloudera BDR – Backup and Disaster Recovery). Atos Codex Data Lake Engine blev den första lösningen med virtualisering som certifierades. .
Om du är intresserad av detaljer, svarar vi gärna på dina frågor i kommentarerna.
Källa: habr.com
