

Den 9 januari släpptes Pandas 1.0.0rc. Den tidigare versionen av biblioteket är 0.25.
Den första stora versionen innehåller många fantastiska nyheter, inklusive förbättrad automatisk summering av dataframes, fler utdataformat, nya datatyper och till och med en ny dokumentationswebbplats.
Alla förändringar kan ses , i artikeln begränsar vi oss till en liten, mindre teknisk översikt av det viktigaste.
Biblioteket kan installeras som vanligt med hjälp av pip, men eftersom Pandas 1.0 fortfarande är release candidate, måste versionen anges tydligt:
pip install --upgrade pandas==1.0.0rc0Var försiktig: eftersom detta är en större version kan uppdateringen bryta gammal kod!
Förresten, med denna version upphör helt stöd för Python 2 (vilket kan vara en bra anledning att — anm. övers.). Pandas 1.0 kräver minst Python 3.6+, så om du är osäker, kontrollera vilken version du har installerad:
$ pip --version
pip 19.3.1 från /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Att kontrollera versionen av Pandas är enklast så här:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Förbättrad automatisk summering med DataFrame.info
Min favoritnyhet blev uppdateringen av metoden DataFrame.info. Funktionen har blivit mycket mer läsbar, vilket gör datainsiktsprocessen ännu enklare:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Utdata av tabeller i Markdown-format
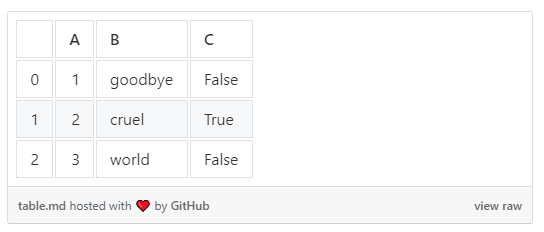
En annan trevlig nyhet blev möjligheten att exportera dataframes till Markdown-tabeller med hjälp av DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
Detta förenklar starkt publiceringen av tabeller på webbplatser som Medium med användning av github-gists.
Nya typer för strängar och logiska värden
I Pandas 1.0 har de även lagt till nya experimentella typer. Deras API kan fortfarande förändras, så använd det med försiktighet. Men generellt rekommenderar Pandas att använda de nya typerna där det är meningsfullt.
Fram tills nu måste konverteringen göras explicit:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Observera hur kolumnen Dtyp visar nya typer — sträng och bool.
Den mest användbara funktionen med den nya strängtypen är möjligheten att välja endast strängkolumner från dataramar. Detta kan avsevärt förenkla analysen av textdata:
df.select_dtypes("string")Tidigare kunde strängkolumner inte väljas utan att namnen angavs uttryckligen.
Mer om de nya typerna kan du läsa .
Tack för att du läste! Den fullständiga listan över ändringar, som redan nämnts, kan ses .
Källa: habr.com
