

Definitionen av DevOps är mycket komplexa, så varje gång måste diskussionen börja om från början. Endast på Habr finns det tusen publiceringar om detta ämne. Men om du läser detta, vet du säkert vad DevOps är. För eftersom jag inte gör det. Hej, jag heter Alexander Titov (@), och vi kommer bara att prata om DevOps och jag kommer att dela med mig av min erfarenhet.
Jag har länge funderat på hur jag ska göra min berättelse användbar, så här kommer det att finnas många frågor - sådana som jag ställer till mig själv, och sådana som jag ställer till kunderna i vårt företag. Genom att svara på dessa frågor blir förståelsen bättre. Jag kommer att förklara varför DevOps är viktigt ur min synvinkel, vad det innebär, återigen från min position, och hur man kan förstå om ni rör er mot DevOps, återigen från min synvinkel. Den sista punkten kommer att ställas genom frågor. Genom att svara på dem till mig själv kan ni förstå om ert företag rör sig mot DevOps eller om det finns problem.
En tid gick jag på vågorna av sammanslagningar och förvärv. Först arbetade jag på den lilla start-upen Qik, sedan köptes den av det något större företaget Skype, som sedan köptes av det ännu större företaget Microsoft. I det ögonblicket fick jag insikt om hur uppfattningen om DevOps förändras i företag av olika storlekar. Efter det blev jag intresserad av att se DevOps ur marknadens perspektiv, och vi, tillsammans med kollegor, grundade företaget Express 42. I över 6 år har vi navigerat på marknaden.
Förutom allt detta är jag en av organisatörerna av DevOps Moscow-samhället och arrangör av DevOps-Days 2017, men 2018 organiserade jag inte. Express 42 jobbar med många företag. Vi utvecklar DevOps där, ser hur det går till, drar slutsatser, analyserar, berättar våra slutsatser för alla, utbildar folk i DevOps-praktiker. Sammanfattningsvis växer vi på det här området vad gäller erfarenhet och expertis.
Varför DevOps
Den första frågan som alltid plågar alla är - varför? Många tror att DevOps bara handlar om automatisering eller liknande saker, som redan existerar i varje företag.
- Vi hade Continuous Integration - det betyder att vi redan hade DevOps, och varför behövs all denna babblan? Där borta roar de sig, men här stör de vårt arbete!
Under 9 years of community and methodology development, it has become clear that this is not just marketing hype, but it is still not entirely clear why it is needed. Like any tool or process, DevOps has specific goals that it ultimately addresses.
This is all related to the fact that the world is changing. It is moving away from the enterprise approach where companies move straight towards their dreams, as our St. Petersburg classic sang, from point A to point B according to a specific strategy, with a dedicated structure built for that purpose.
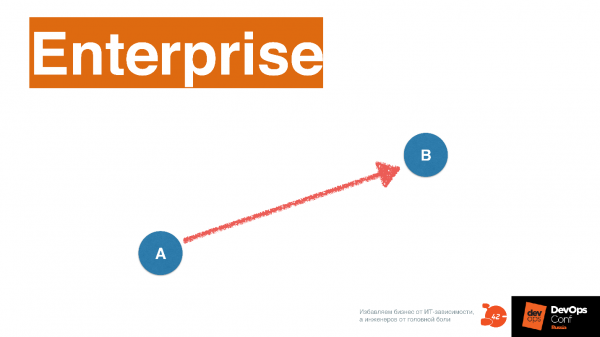
In principle, IT should be structured under this approach. Here, IT is used solely for automating processes.
Automation does not change often, because when a company is on a well-trodden path — why change anything? If it works, don't touch it. Now in the world, approaches are changing, and the one called Agile indicates that the endpoint B is not immediately visible.
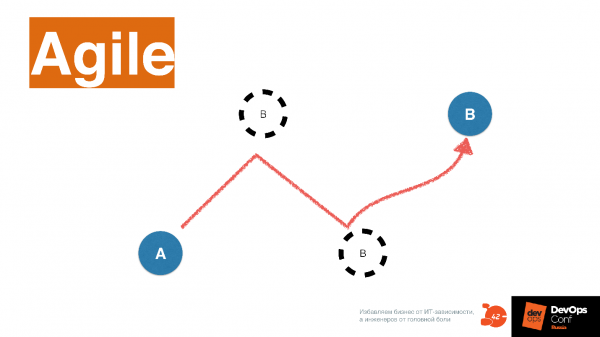
As a company navigates the market and works with clients, it is constantly researching the market and changing its endpoint B. Moreover, the more often a company shifts its direction, the more successful it ultimately becomes as it captures more market niches.
An interesting company illustrates this strategy, which I recently learned about. One Box Shave — a subscription service for delivering razors and shaving supplies in a box. They can customize their "box" for different clients. This is handled by specific software that then sends the order to a Korean factory producing the product.
This product was bought by Unilever for $1 billion. It is now competing with Gillette and has taken a significant share of consumers in the American market. One Box Shave says:
"Four blades? Are you serious? Why do you need that—it does not improve shaving quality at all. A carefully selected cream, fragrance, and a quality razor with two blades address many more issues than those silly four blades from Gillette! Are we soon going to have ten?"
Thus, the world is changing. Unilever claims to have a cool IT system that makes this possible. Ultimately, it looks like the concept of Time-to-market, which has been discussed by many.
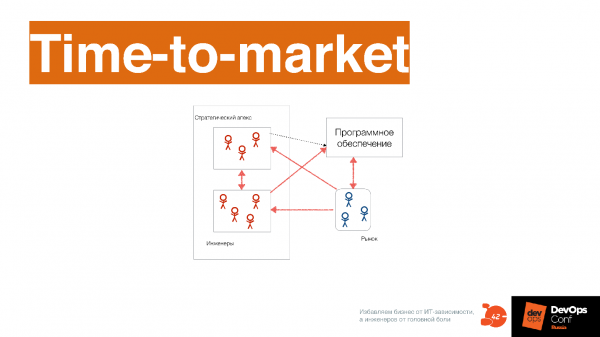
Betydelsen av Time-to-market handlar inte om hur ofta vi deployar. Vi kan ofta deploya, men releasecyklerna kan vara långa. Om vi lägger tre månader långa releasecykler ovanpå varandra, flyttande dem med en vecka, så verkar det som om företaget deployar en gång i veckan. Men från idé till slutlig implementation tar det tre månader.
Time-to-market handlar om att minimera tiden från idé till slutlig implementation.
I det här fallet interagerar programvaran med marknaden. Så i One Box Shave interagerar webbplatsen med kunden. De har inga säljare - bara en webbplats där besökaren klickar och lämnar önskemål. Därför måste man ständigt publicera något nytt på webbplatsen och uppdatera den i enlighet med önskemålen. Till exempel, i Sydkorea rakar man sig inte som i Ryssland, och de föredrar dofter som inte är av tall utan till exempel morotsvanilj.
Eftersom det krävs att snabbt ändra innehållet på webbplatsen, förändras programvaruutvecklingen avsevärt. Genom programvaran måste vi ta reda på vad kunden vill ha. Tidigare fick vi veta detta på olika omvägar, till exempel genom affärsadministration. Sedan designade vi, lade in kraven i IT-systemet, och allt var bra. Nu är det annorlunda - programvaran designas av alla som är involverade i processen, inklusive ingenjörer, eftersom de får insikter om hur marknaden fungerar genom tekniska specifikationer och också delar sina insikter med affärssidan.
Till exempel, i företaget Qik fick vi plötsligt veta att folk verkligen gillar att ladda upp kontaktlistor till servern, och de gav oss en app. Vi tänkte inte på detta från början. I ett klassiskt företag skulle alla ha bedömt att det var en bugg eftersom det inte stod i specifikationen att det skulle fungera bra och det var dessutom genomfört på ett hastigt sätt, de skulle ha stängt av funktionen och sagt: "Det behövs inte, det viktigaste är att den grundläggande funktionaliteten fungerar." Men ett teknologiskt företag ser en möjlighet i detta och börjar ändra programvaran i enlighet med det.
År 1968 formulerade den kloka killen Melvin Conway följande idé.
Organisationen som skapar ett system är begränsad av designen som speglar kommunikationsstrukturen i denna organisation.
För att producera system av en annan typ behöver ni dessutom ha en kommunikationsstruktur inom företaget av en annan typ. Om ni har en topp-ner hierarkisk kommunikationsstruktur, kommer det inte att tillåta er att skapa system som kan säkerställa en mycket hög Time-to-market.
Läs mer kan . Den är viktig för att förstå kulturen eller filosofin bakom DevOps, eftersom det enda som grundläggande förändras inom DevOps är just kommunikationsstrukturen mellan teamen..
Ur processens synvinkel har alla faser: analys, utveckling, testning, drift, i DevOps varit linjära.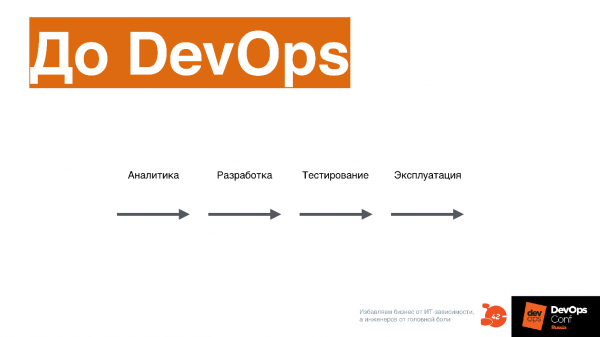
I DevOps pågår alla dessa processer samtidigt.
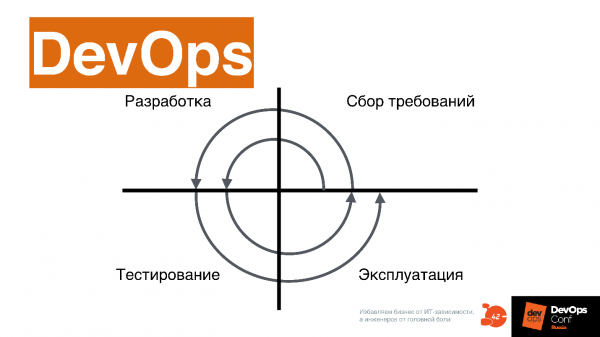
Time-to-market kan endast uppnås på detta sätt. För personer som har arbetat i den gamla processen kan detta verka ganska futuristiskt, och överlag inte så tilltalande.
Så varför behövs DevOps?
För utvecklingen av digitala produkter.Om ni inte har en digital produkt i ert företag, behövs inte DevOps - detta är mycket viktigt.
DevOps övervinner de hastighetsbegränsningar som är förknippade med en sekventiell produktionsmodell.I den sker alla processer samtidigt.
Komplexiteten ökar. När DevOps-evangelister säger att det kommer att bli enklare att släppa programvara med DevOps - det är nonsens.
Med DevOps blir allt bara mer komplext.
På konferensen på Avitos monter kunde man se hur man deployar en Docker-container - en orealistisk uppgift. Komplexiteten blir överväldigande, man måste jonglera med många bollar samtidigt.
DevOps förändrar helt processen och organisationen i företaget – snarare förändrar inte DevOps, utan den digitala produkten. För att nå DevOps måste man ändå förändra hela denna process.
Frågor för specialisten
Och vad har ni? Frågor som ni kan ställa till er själva när ni arbetar i företaget och utvecklas som specialist.
Har ni en strategi för att skapa en digital produkt? Om ni har det – bra. Det betyder att ert företag rör sig mot DevOps.
Skapar ert företag redan en digital produkt? Det innebär att ni kan ta ett steg uppåt till, engagera er i intressantare verksamhet – ur DevOps-perspektiv. Jag hänvisar endast till detta perspektiv.
Är ert företag en av marknadsledarna inom en nisch med digital produkt? Spotify, Yandex, Uber – företag som just nu är i framkant av teknologisk utveckling.
Ställ dessa frågor till dig själv, och om alla svar är negativa, är det kanske bäst att du inte sysslar med DevOps på det här företaget. Men om DevOps verkligen intresserar dig, kanske… du borde överväga att byta företag? Om ditt företag vill gå över till DevOps, men du svarade "Nej" på alla frågor, påminner det om den här vackra noshörningen som aldrig kommer att förändras.
Organisationen
Som jag redan har nämnt, enligt Conway’s lag, förändras organisationen inom företaget. Jag börjar med vad som hindrar DevOps från att tränga in i företaget just ur organisatoriskt perspektiv.
Problemet med "siloer"
Det engelska ordet "Silo" översätts här till ryska som "колодец" (brunn). Problemet här handlar om att det inte finns något informationsutbyte mellan teamen.. Varje team gräver djupt inom sin egen expertis, utan att bygga en gemensam karta där man kan orientera sig.
Det påminner lite om en person som just har anlänt till Moskva och ännu inte kan navigera på tunnelbanekartan. Moskva-invånare brukar känna till sitt område bra, och i hela Moskva orienterar de sig efter tunnelbanekartan. När du kommer till Moskva för första gången har du inte den färdigheten, och du är bara desorienterad.
DevOps erbjuder att gå igenom denna desorienteringsperiod och tillsammans med alla avdelningar bygga en gemensam interaktionskarta.
Två faktorer hindrar detta.
Konsekvenserna av företagets ledningssystem. Det är uppbyggt av separata hierarkiska "siloer". Till exempel finns det vissa KPI:er i företag som stöder detta system. Å andra sidan hindras det av människors tänkande, där det kan vara svårt att gå utanför sin egen expertis och orientera sig i hela systemet. Det är helt enkelt obekvämt. Tänk dig att du hamnat på Bangkok flygplats – där är det svårt att snabbt orientera sig. Det är också svårt att navigera i DevOps, och därför säger folk att man måste hitta en guide för att komma dit.
Men det viktigaste är att problemet med "siloer" för en ingenjör som har anammat DevOps-andan och läst Fowler och massor av andra böcker, uttrycker sig i att "siloer" hindrar att "uppenbara" saker görs. Vi samlas ofta efter DevOps Moscow, pratar med varandra, och folk klagar:
— Vi ville bara starta CI, men det visade sig att ledningen inte behövde det.
Det beror just på att CI och Continuous Delivery-processen ligger på gränsen till många expertiser. Genom att inte övervinna problemet med «brunnar» på organisationsnivå kommer det inte att gå att göra framsteg, oavsett vad ni gör och hur sorgligt det än kan verka.
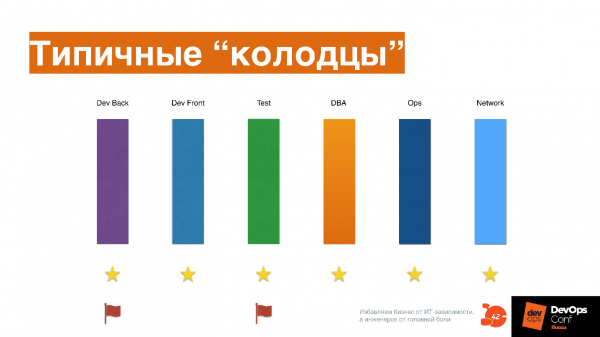
Varje deltagare i processen inom företaget: backend- och frontend-utvecklare, testning, DBA, drift, nätverk, gräver på sin egen sida, medan ingen har en gemensam karta, utom förvaltaren som på något sätt överser dem och styr med metoden «dela och härska».
Människor kämpar för olika stjärnor eller flaggor, varje person fördjupar sin egen expertis.
Som ett resultat, när uppgiften att koppla samman allt detta och bygga en gemensam pipeline uppstår, och det inte längre handlar om att kämpa för stjärnor och flaggor, uppstår frågan – vad ska man göra överhuvudtaget? Man måste på något sätt komma överens, och hur man gör det, lärde ingen oss i skolan. Vi har lärt oss redan i skolan: åttonde klass – wow! – jämfört med sjunde klass! Här är det samma.
Är det likadant i ert företag?
För att kontrollera detta kan man ställa sig följande frågor.
Använder teamen gemensamma verktyg och bidrar de med förändringar i dessa gemensamma verktyg?
Hur ofta omorganiseras teamen – övergår specialister från ett team till ett annat? Just i DevOps-miljöer blir detta normalt, eftersom en person ibland helt enkelt inte kan förstå vad en annan expertis sysslar med. Han går till en annan avdelning, jobbar där i två veckor för att skapa en karta för orientering och interaktion med den avdelningen.
Kan en kommitté bildas för att göra förändringar och ändra något? Eller krävs det en stark hand från den högsta ledningen och ett beslut? Nyss skrev jag på Facebook om hur en relativt okänd bank genom beslut implementerar verktyg: de skrev ett beslut, implementerade i ett år och ser vad som händer. Det är naturligtvis långsamt och sorgligt.
Hur viktigt är det för chefer att få personliga prestationer oavsett företagets prestationer?
Om ni svarar på dessa frågor blir det tydligare om ni har detta problem i företaget.
Infrastruktur som kod
När detta problem är löst är den första viktiga praktiken, utan vilken det är svårt att avancera ytterligare inom DevOps, att infrastruktur som kod.
Oftast uppfattas infrastruktur som kod så här:
— Låt oss automatisera allt med bash, överösa oss med skript så att administratörerna får mindre manuellt arbete!
Men så är det inte.
Infrastruktur som kod innebär att du beskriver den IT-system du arbetar med i form av kod, för att ständigt förstå dess tillstånd.
Tillsammans med andra team skapar du en karta i form av kod som alla kan förstå, som kan användas för att orientera och navigera. Oavsett vilket verktyg som används – Chef, Ansible, Salt, eller om YAML-filer används i Kubernetes – spelar det ingen roll.
På konferensen berättade en kollega från 2GIS hur de skapade sin interna lösning för Kubernetes, som beskriver strukturen för varje enskilt system. För att beskriva 500 system behövde de ett särskilt verktyg som genererade denna beskrivning. När denna beskrivning finns, kan alla kontrollera med varandra, övervaka ändringar, hur det kan ändras och förbättras, och vad som saknas.
Förstås ger separata bash-skript vanligtvis inte denna insyn. På ett av de företag jag arbetade på fanns det till och med ett namn som "write only"-skript – när skriptet är skrivet går det inte att läsa. Jag tror att ni också känner igen detta.
Infrastruktur som kod är Kod som beskriver det aktuella tillståndet för infrastrukturen. Denna kod hanteras gemensamt av många produkt-, infrastrukturs- och serviceteam, och viktigast av allt, alla måste förstå hur denna kod faktiskt fungerar.
Koden underhålls enligt bästa praxis för kodhantering: gemensam utveckling, kodgranskning, XP-programmering, testning, pull requests, CI för infrastrukturkod – allt detta är värdefullt och kan användas.
Koden blir ett gemensamt språk för alla ingenjörer.
Att ändra infrastrukturen i koden tar inte mycket tid. Ja, det kan finnas teknisk skuld även i infrastrukturkoden. Vanligtvis möter team denna skuld efter ungefär ett och ett halvt år efter att de börjat implementera "infrastruktur som kod" i form av en massa skript eller till och med Ansible, som de skriver som spaghettikod, och sedan slänger in bash-skript i grytan!
Det är viktigt: om ni inte har provat denna skräpa än, kom ihåg att Ansible är inte bash! Läs noga igenom dokumentationen, studera vad som faktiskt skrivs om det här.
Infrastruktur som kod — det handlar om att dela upp infrastrukturell kod i separata lager.
I vårt företag identifierar vi tre grundläggande lager som är tydliga och enkla, men det kan finnas fler. Du kan titta på din infrastrukturella kod och se om du uppfyller detta villkor eller inte. Om inga lager har identifierats, bör du ta tid att refaktorera lite.
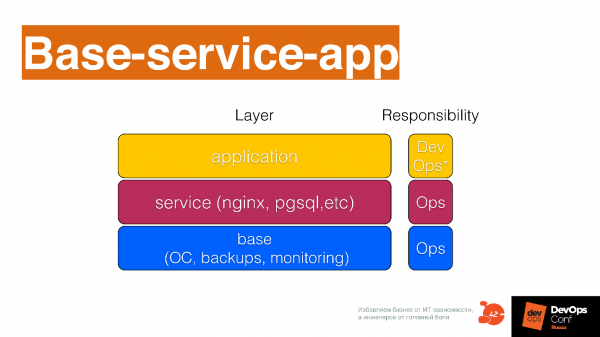
Grundlager — det handlar om hur operativsystemet konfigureras, säkerhetskopior och andra låg nivå saker, till exempel hur Kubernetes distribueras på grundnivå.
Tjänstlager — det är de tjänster som du tillhandahåller utvecklaren: loggning som tjänst, övervakning som tjänst, databas som tjänst, load balancer som tjänst, kö som tjänst, Continuous Delivery som tjänst — en mängd tjänster som olika team kan erbjuda utvecklingen. Allt detta måste beskrivas i separata moduler i ditt konfigurationshanteringssystem.
Lagret där applikationer görs och där det beskrivs hur de ska distribueras ovanpå de två föregående lagren.
Kontrollfrågor
Har ditt företag ett gemensamt infrastrukturellt arkiv? Kontrollerar ni teknisk skuld i infrastrukturen? Använder ni utvecklingspraxis i det infrastrukturella arkivet? Är er infrastruktur uppdelad i lager? Man kan verifiera med schemat Base-service-APP. Hur svårt är det att göra en förändring?
Om du har stött på situationen där en förändring tog en och en halv dag, betyder det att ni har fått teknisk skuld som ni måste arbeta med. Du har precis stött på en fälla av teknisk skuld i den infrastrukturella koden. Jag minns många sådana historier där för att ändra något CCTL måste man skriva om hälften av den infrastrukturella koden, eftersom kreativitet och viljan att automatisera allt har lett till att allt är överbelastat, alla handgrepp har tagits bort och refaktorisering behövs.
Kontinuerlig leverans
Vi sammanfattar debet och kredit. Först finns en beskrivning av infrastrukturen, som kan vara ganska grundläggande. Det är inte nödvändigt att beskriva allt i detalj, men en viss grundläggande beskrivning krävs för att ni ska kunna arbeta med detta. Annars är det oklart hur man ska genomföra kontinuerlig leverans. Alla dessa metoder införs samtidigt när ni kommer till DevOps, men man måste börja med att förstå vad man har och hur man hanterar det. Det är just denna praktik för infrastruktur som kod.
När ni har förstått vad ni har och hur ni kan hantera det, börjar ni fundera på hur utvecklarens kod snabbt kan skickas till produktion. Jag menar tillsammans med utvecklaren – kom ihåg problemet med "brunnar", det vill säga det är inte bara enskilda personer som kommer på detta, utan det görs som ett team.
När vi såg Vanya Evtuchevich första boken Jez Humble och en grupp författare "Continuous Delivery", som kom ut 2009, funderade vi länge på hur vi skulle översätta titeln till svenska. Vi ville översätta den som "Ständigt leverera", men tyvärr översatte vi det som "Kontinuerlig leverans". Jag tycker att det finns något sådant ryskt i vår titel, med kraft.
Ständigt leverera – det betyder
Koden som ligger i produktrepositoriet kan alltid rullas ut till produktion. Den kan kanske inte rullas ut, men den är alltid redo för det. Därför skriver ni alltid kod med en svårförklarad känsla av viss oro i nedre delen av ryggen. Denna känsla av oro uppstår ofta när man rullar ut infrastrukturkod. Det är just denna känsla av oro som måste vara närvarande – den väcker mentala processer som gör att man kan skriva kod på ett lite annat sätt. Detta bör dokumenteras i reglerna inom utvecklingen.
För att ständigt kunna leverera behöver man ett artefaktformat som går igenom den infrastrukturella plattformen. Om ni slänger olika typer av "avfallsprodukter" över den infrastrukturella plattformen, så blir den icke-enhetlig, svår att underhålla och det uppstår ett tekniskt skuldproblem. Artefaktformatet måste jämnas ut – detta är också en kollektiv uppgift: man måste samlas, tänka tillsammans och komma på detta format.
Artefakten förbättras kontinuerligt och anpassas till produktionsmiljön under hela leveranspipeline processen. När artefakten rör sig genom pipelinen, stöter den hela tiden på olika utmaningar som liknar dem som artefakten möter när ni släpper den till produktion. Om en systemadministratör hanterar detta i klassisk utveckling, så händer det kontinuerligt i DevOps-processen: här prövar de den med olika tester, där kastas den in i ett Kubernetes-kluster som mer eller mindre liknar produktionen, och plötsligt körs belastningstestning.
Det påminner om spelet Pac-Man - artefakten genomgår en historia. Det är viktigt att övervaka om koden faktiskt genomgår en historia som är relaterad till er produktion. Historier om produktion kan integreras i Continuous Delivery-processen: det har varit så tidigare när något har kraschat, låt oss programmera det scenariot direkt i systemet. Varje gång kommer koden också att genomgå detta scenario, och ni kommer att upptäcka problemet mycket tidigare innan det når era kunder.
Olika distributionsstrategier. Till exempel kan ni använda A/B-testning eller kanariefågelsutdelningar för att på olika sätt "känna av" koden hos olika kunder, få information om hur koden fungerar och mycket tidigare än när den distribueras till 100 miljoner användare.
"Kontinuerlig leverans" ser ut så här.
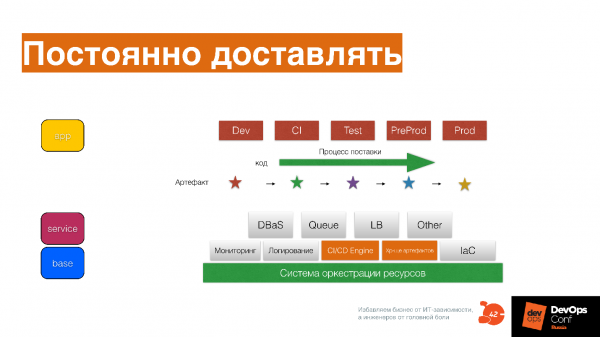
Leveransprocessen Dev, CI, Test, PreProd, Prod är inte en separat miljö, det är steg eller stationer med icke-brännbara summor där er artefakt passerar.
Om ni har infrastrukturkod som beskrivs som Base Service APP, hjälper den att inte glömma alla scenarier, och att också skriva ner dem i form av kod för denna artefakt, att föra artefakten framåt och att förändra den under sin väg.
Frågor för självkontroll
Är tiden från beskrivning av funktionen till distribution i produktion i 95 % av fallen mindre än en vecka? Förbättras kvaliteten på artefakten vid varje steg i pipelinen? Finns det en historia som den genomgår? Använder ni olika distributionsstrategier?
Om alla svar är ja, då är ni otroligt duktiga! Skriv svaren i kommentarerna - jag ser fram emot dem).
Feedback
Det här är den mest komplexa praktiken av alla. Under konferensen DevOpsConf blev en kollega från Infobip lite osäker i sina ord när han pratade om detta, eftersom det verkligen är en mycket komplex praktik om vad man faktiskt behöver övervaka överhuvudtaget!
Till exempel, för länge sedan, när jag arbetade på Qik och vi insåg att vi verkligen behövde övervaka allt. Vi gjorde det, och vi hade 150 000 objekt i Zabbix som ständigt övervakades. Det var skrämmande, teknisk chef snurrade fingret vid tungan:
— Grabbar, varför misshandlar ni servern med något oklart?
Men sedan inträffade en händelse som visade att detta verkligen är en riktigt cool strategi.
En av tjänsterna började ständigt falla. Ursprungligen föll den inte, intressant nog, eftersom ingen kod lades till, eftersom det var en grundläggande broker där det praktiskt taget inte fanns någon affärsfunktionalitet – den skickade bara meddelanden mellan olika tjänster. Tjänsten hade inte förändrats på 4 månader, och plötsligt började den falla med ett felmeddelande "Segmentation fault".
Vi var i chock, vi öppnade våra grafer i Zabbix, och det visade sig att beteendet hos förfrågningar i API-tjänsten som använder denna broker hade förändrats kraftigt för en och en halv vecka sedan. Senare såg vi att frekvensen för att skicka vissa typer av meddelanden hade förändrats. Efteråt fick vi veta att det var android-klienterna. Vi frågade:
— Grabbar, vad hände för en och en halv vecka sedan?
Som svar hörde vi en intressant berättelse om att de hade gjort om UI. Vem skulle i så fall omedelbart säga att de bytte HTTP-bibliotek? För android-klienter är det som att byta tvål i badrummet – de glömmer helt enkelt bort det. Resultatet blev att efter 40 minuter av samtal kom vi fram till att de faktiskt hade bytt HTTP-bibliotek, och dess standardtidsinställningar hade ändrats. Det ledde till att beteendet hos trafiken på API-servern förändrades, vilket ledde till situationen som orsakade en race condition inuti brokern, och den började falla.
Utan djupgående övervakning är det helt omöjligt att avslöja detta.. Om det finns ett problem med "brunnar" i organisationen, där alla skyller på varandra, kan det pågå i flera år. Du startar bara om servern eftersom det är omöjligt att lösa problemet. När du övervakar, spårar och följer alla händelser som du har, och använder övervakning som testning – skriver kod och anger genast hur den ska övervakas, också i form av kod (vi har redan infrastruktur som kod), blir allt kristallklart. Även sådana komplexa problem kan enkelt spåras.
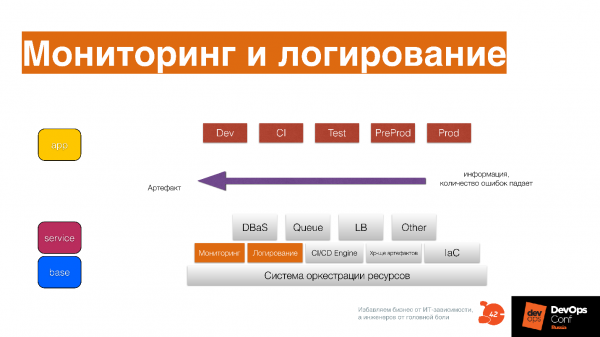
Samla all information om vad som händer med artefakten i varje steg av leveransprocessen – inte i produktion.
Ladda upp övervakningen på CI, och där kommer några grundläggande saker att synas. Du kommer att se dem även i Test, PredProd och vid belastningstestning. Samla information på alla stadier, och inte bara metrik, statistik utan även loggar: hur applikationen rullas ut, anomalier – samla allt.
Annars blir det svårt att förstå. Jag har redan sagt att DevOps innebär en större komplexitet. För att hantera denna komplexitet behöver man ha god analys..
Frågor för egenkontroll.
Är din övervakning och loggning ett utvecklingsverktyg för er? Tänker dina utvecklare, inklusive du själv, när de skriver kod på hur den ska övervakas?
Får ni veta om problem från kunder? Förstår ni kunderna bättre genom övervakning och loggning? Förstår ni systemet bättre genom övervakning och loggning? Ändrar ni systemet bara för att ni ser att trenden i systemet ökar och förstår att om tre veckor kommer allt att kollapsa?
När ni har dessa tre komponenter kan ni fundera på vilken infrastrukturplattform ni har i företaget.
Infrastrukturplattform.
Poängen är inte att det är en uppsättning av skilda verktyg som finns i varje företag.
Poängen med infrastrukturplattformen är att alla team använder dessa verktyg och utvecklar dem tillsammans.
Det är klart att det finns separata team som ansvarar för utvecklingen av specifika delar av infrastrukturplattformen. Men ansvaret för utvecklingen, funktionaliteten och främjandet av infrastrukturplattformen ligger på varje ingenjör. På en intern nivå blir detta ett gemensamt verktyg.
Alla team utvecklar infrastrukturplattformen och behandlar den varsamt som sin egen IDE. I din IDE installerar du olika plugins för att allt ska se bra och snabbt ut, och du konfigurerar genvägar. När du öppnar Sublime, Atom eller Visual Studio Code, hur koden kraschar och du inser att det är nästan omöjligt att arbeta, blir du genast nedslagen och springer för att fixa din IDE.
Behandla din infrastrukturplattform på samma sätt. Om du upptäcker att något är fel med den, lämna en förfrågan om hjälp om du inte kan fixa det själv. Men om det är något enkelt - fixa det själv och skicka en pull request - teamet kommer att granska och lägga till det. Det är en något annan syn på ingenjörsverktyg i utvecklarens huvud.
Infrastrukturplattformen möjliggör överföring av artefakten från utvecklingen till klienten med ständiga kvalitetsförbättringar. På IP finns en uppsättning berättelser programmerade som händer med koden i produktion. Under åren av utveckling har det blivit väldigt många av dessa berättelser; en del av dem är unika och handlar bara om dig - de går inte att hitta på nätet.
Vid denna tidpunkt blir infrastrukturplattformen din konkurrensfördel, eftersom den har inslag som saknas i konkurrentens verktyg. Ju djupare din IP är, desto större är din konkurrensfördel i termer av Time-to-market. Här uppstår problemet med vendor lock: du kan ta en annan plattform, men genom att använda någon annans erfarenhet kommer du inte att förstå hur relevant det är för dig. Ja, inte alla företag kan bygga en plattform som Amazon. Det är en svår gräns där ett företags erfarenhet är relevant för dess position på marknaden, och att släppa in vendor lock är inte tillrådligt. Det är också något som är viktigt att tänka på.
Diagram
Detta är den grundläggande schemat för infrastrukturplattformen, som kommer hjälpa dig att etablera alla praxis och processer i ett DevOps-företag.
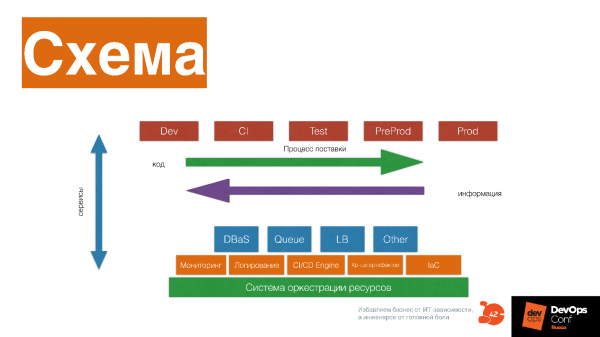
Låt oss titta på vad den består av.
Resursorkestreringssystemet, som tillhandahåller CPU, minne och disk för applikationerna och andra tjänster. Ovanpå detta finns det tjänster på låg nivå: övervakning, loggning, CI/CD-motor, lagring av artefakter, infrastruktur som kod-system.
Tjänster på högre nivå: databas som en tjänst, köer som en tjänst, Load Balance som en tjänst, resizing av bilder som en tjänst, Big Data fabrik som en tjänst. Över detta - pipeline som ständigt levererar modifierad kod till din klient.
Du får information om hur din programvara fungerar hos kunden, ändrar, levererar denna kod igen, får information - och så utvecklar du ständigt både din infrastrukturplattform och din programvara.
I schemat består leveranspipeline av många steg. Men detta är en principskiss som ges som exempel - du behöver inte återskapa den exakt. Stegen interagerar med tjänster som tjänster - varje byggsten i plattformen bär sin egen historia: hur resurser tilldelas, hur applikationen startas, arbetar med resurser, övervakas och förändras.
Det är viktigt att förstå att varje del av plattformen bär en historia, och att fråga sig - vilken historia bär denna byggsten, kanske bör den slängas och ersättas med en extern tjänst. Till exempel, kan vi istället för byggstenen sätta in Okmeter? Kanske har de redan utvecklat denna expertis mycket mer än vi. Men kanske inte - kanske har vi unik expertis, och vi behöver sätta in Prometheus och utveckla detta vidare.
Att bygga en plattform
Detta är en komplex kommunikationsprocess. När du har grundläggande praxis, startar du kommunikationen mellan olika ingenjörer och specialister, som utvecklar krav och standarder, och ständigt förändrar dem till olika verktyg och metoder. Här är kulturen viktig, som finns i DevOps.
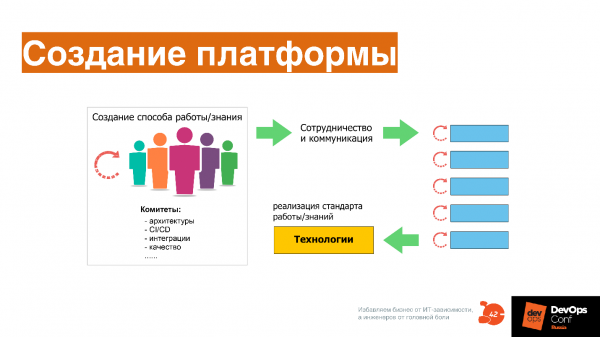
Med kultur är allt väldigt enkelt - det är samarbete och kommunikation, det vill säga en vilja att arbeta på gemensam mark med varandra, en vilja att tillsammans behärska ett verktyg. Det finns ingen rocket science här - allt är väldigt enkelt, banalt. Till exempel, vi alla bor i en trappuppgång och upprätthåller dess renlighet - en sådan nivå av kultur.
Och hur är det med er?
Återigen frågor som du kan ställa dig själv.
Är infrastrukturplattformen avskild? Vem ansvarar för dess utveckling? Förstår ni konkurrensfördelarna med er infrastrukturplattform?
Dessa frågor måste man ständigt ställa sig själv. Om något kan outsourcas till externa tjänster — bör det göras; om den externa tjänsten börjar blockera din framfart, måste man bygga ett system inifrån.
Så, DevOps…
… är ett komplext system som måste innehålla:
- En digital produkt.
- Affärsmoduler som utvecklar denna digitala produkt.
- Produktionsteam som skriver kod.
- Praktiker för Continuous Delivery.
- Plattformar som tjänst.
- Infrastruktur som tjänst.
- Infrastruktur som kod.
- Separata praktiker för att upprätthålla tillförlitlighet, inbyggda i DevOps.
- Feedback-praktik som beskriver allt detta.
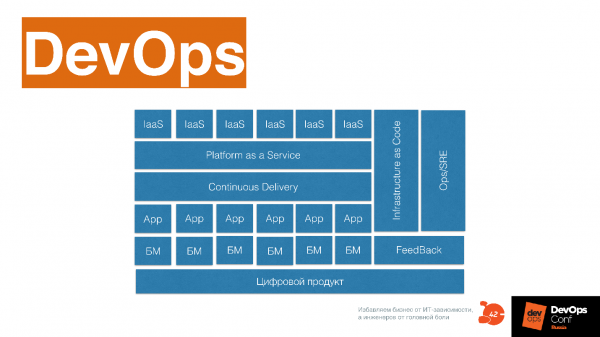
Denna modell kan användas, med färgkodning av det som redan finns i ert företag i något format: det har utvecklats eller behöver fortfarande utvecklas.
Redan om ett par veckor kommer . som en del av RIT++. Kom till konferensen där många fantastiska föreläsningar om kontinuerlig leverans, infrastruktur som kod och DevOps-transformation väntar på er. , sista datum för priser 20 maj
Källa: habr.com
