

I det här inlägget vill vi dela med oss av ett intressant sätt att hantera konfigurationen av ett distribuerat system.
Konfigurationen representeras direkt i Scala-språket på ett typ-säkert sätt. En exempelimplementation beskrivs i detalj. Olika aspekter av förslaget diskuteras, inklusive inverkan på den övergripande utvecklingsprocessen.
()
Introduktion
Att bygga robusta distribuerade system kräver användning av korrekt och sammanhängande konfiguration på alla noder. En typisk lösning är att använda en textuell distributionsbeskrivning (terraform, ansible eller något liknande) och automatiskt genererade konfigurationsfiler (ofta dedikerade för varje nod/roll). Vi vill även använda samma protokoll av samma version på varje kommunicerande nod (annars skulle vi uppleva kompatibilitetsproblem). I JVM-världen innebär detta att åtminstone måste meddelandehanteringsbiblioteket vara av samma version på alla kommunicerande noder.
Vad sägs om att testa systemet? Självklart bör vi ha enhetstester för alla komponenter innan vi går vidare till integrationstester. För att kunna extrapolera testresultat på körningstid, måste vi säkerställa att versionerna av alla bibliotek hålls identiska i både körnings- och testmiljöer.
Vid körning av integrationstester är det ofta mycket lättare att ha samma classpath på alla noder. Vi måste bara se till att samma classpath används vid distribution. (Det är möjligt att använda olika classpaths på olika noder, men det är svårare att representera denna konfiguration och korrekt distribuera den.) Så för att hålla saker enkla kommer vi endast att överväga identiska classpaths på alla noder.
Konfiguration har en tendens att utvecklas tillsammans med programvaran. Vi brukar använda versioner för att identifiera olika
faser av programvaruutvecklingen. Det verkar rimligt att täcka konfiguration under versionshantering och identifiera olika konfigurationer med vissa etiketter. Om det bara finns en konfiguration i produktion kan vi använda en enda version som identifierare. Ibland kan vi ha flera produktionsmiljöer. Och för varje miljö kan vi behöva en separat gren av konfiguration. Så konfigurationer kan märkas med gren och version för att unikt identifiera olika konfigurationer. Varje grennamn och version motsvarar en enda kombination av distribuerade noder, portar, externa resurser, classpath-biblioteksversioner på varje nod. Här kommer vi endast att täcka en enda gren och identifiera konfigurationer med en tre komponenters decimalversion (1.2.3), på samma sätt som andra artefakter.
I moderna miljöer modifieras inte konfigurationsfiler manuellt längre. Typiskt genererar vi
konfigurationsfiler vid distributionstid och därefter. Så man kan fråga sig varför vi fortfarande använder textformat för konfigurationsfiler? Ett genomförbart alternativ är att placera konfigurationen inuti en kompilationsenhet och dra nytta av validering av konfigurationen vid kompileringstid.
I det här inlägget kommer vi att granska idén att hålla konfigurationen i den kompilerade artefakten.
Kompilerbar konfiguration
I detta avsnitt kommer vi att diskutera ett exempel på statisk konfiguration. Två enkla tjänster — en echo-tjänst och klienten till echo-tjänsten konfigureras och implementeras. Sedan instansieras två olika distribuerade system med båda tjänsterna. Ett är för en enkel nodkonfiguration och det andra för en tvånoderskonfiguration.
Ett typiskt distribuerat system består av några noder. Noderna kan identifieras med någon typ:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
eller bara
case class NodeId(hostName: String)eller till och med
object Singleton
type NodeId = Singleton.type
Dessa noder utför olika roller, kör olika tjänster och bör kunna kommunicera med andra noder via TCP/HTTP-anslutningar.
För TCP-anslutning krävs åtminstone ett portnummer. Vi vill också försäkra oss om att klient och server pratar samma protokoll. För att modellera en anslutning mellan noder, låt oss deklarera följande klass:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])där Port är bara en Int inom det tillåtna intervallet:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Refined-typer
Se bibliotek. Kort sagt, det tillåter att lägga till kompileringstidsbegränsningar på andra typer. I detta fall Int är det endast tillåtet att ha 16-bitars värden som kan representera portnummer. Det finns inget krav på att använda detta bibliotek för denna konfigurationsmetod. Det verkar bara passa mycket bra.
För HTTP (REST) kan vi också behöva en tjänsteväg:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Phantomtyp
För att identifiera protokoll under kompileringen använder vi Scala-funktionen för att deklarera typargument — alla, om du använder HTTPS för kommunikationen mellan balansieraren och instanserna, måste du ladda certifikatet på dem. I det här exemplet kommer vi inte att göra det, utan bara lämna port 80. som inte används i klassen. Det är en så kallad phantomtyp. Vid körtid behöver vi sällan en instans av protokollidentifieraren, därför lagrar vi inte den. Under kompileringen ger denna phantomtyp ytterligare typ-säkerhet. Vi kan inte skicka port med fel protokoll.
En av de mest använda protokollen är REST API med Json-serialisering:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]där RequestMessage är bas-typen av meddelanden som klienten kan skicka till servern och ResponseMessage är svaret från servern. Naturligtvis kan vi skapa andra protokollbeskrivningar som specificerar kommunikationsprotokollet med önskad precision.
För syftena med detta inlägg använder vi en enklare version av protokollet:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]I detta protokoll läggs begäran meddelande till url och svarmeddelandet returneras som en vanlig sträng.
En tjänstekonfiguration kan beskrivas av tjänstnamn, en samling portar och några beroenden. Det finns flera möjliga sätt att representera alla dessa element i Scala (till exempel, HList, algebraiska datatyper). För syftena med detta inlägg använder vi Cake Pattern och representerar kombinerbara delar (moduler) som traits. (Cake Pattern är inte ett krav för denna kompileringbara konfigurationsmetod. Det är bara en möjlig implementering av idén.)
Beroenden kan representeras med Cake Pattern som slutpunkter för andra noder:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Ekokonfigurationen behöver bara en konfigurerad port. Och vi deklarerar att denna port stöder ekoprotokollet. Observera att vi inte behöver ange en specifik port vid detta tillfälle, eftersom traitens tillåter deklarationer av abstrakta metoder. Om vi använder abstrakta metoder kommer kompilatorn att kräva en implementering i en konfigurationsinstans. Här har vi tillhandahållit implementeringen (8081) och den kommer att användas som standardvärde om vi hoppar över det i en konkret konfiguration.
Vi kan deklarera ett beroende i konfigurationen av ekotjänstklienten:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Beroendet har samma typ som echoService. I synnerhet kräver det samma protokoll. Därför kan vi vara säkra på att om vi kopplar dessa två beroenden kommer de att fungera korrekt.
Tjänsternas implementation
En tjänst behöver en funktion för att starta och stänga av på ett ordnat sätt. (Förmågan att stänga av en tjänst är kritisk för testning.) Återigen finns det några alternativ för att specificera en sådan funktion för en given konfiguration (till exempel, vi skulle kunna använda typklasser). För detta inlägg kommer vi återigen att använda Cake Pattern. Vi kan representera en tjänst med cats.Resource som redan tillhandahåller inramning och resursfrisättning. För att få en resurs bör vi tillhandahålla en konfiguration och viss köruppstartsinformation. Så funktionen som startar tjänsten kan se ut som följer:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
där
Konfigurera— typ av konfiguration som krävs av denna tjänststartareAddressResolver— ett körningsobjekt som har förmågan att erhålla riktiga adresser till andra noder (fortsätt läsa för detaljer).
de andra typerna kommer från cats:
F[_]— effekttyp (I det enklaste falletF[A]kan vara bara() => A. I detta inlägg kommer vi att användacats.IO.)Reader[A,B]— är mer eller mindre en synonym för en funktionA => Bcats.Resource— har sätt att erhålla och frigöraTimer— gör det möjligt att sova/mäta tidContextShift— analog tillExecutionContextApplicative— omslag av funktioner i effekt (nästan en monad) (vi kanske så småningom ersätter den med något annat)
Genom att använda detta gränssnitt kan vi implementera ett par tjänster. Till exempel, en tjänst som inte gör någonting:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Se för andra tjänstimplementeringar — ,
och .)
En nod är ett enda objekt som kör ett par tjänster (starta en kedja av resurser möjliggörs av Cake-mönstret):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Observera att vi i noden specificerar den exakta typ av konfiguration som behövs av denna nod. Kompilatorn låter oss inte bygga objektet (Cake) med otillräcklig typ, eftersom varje tjänsttyp deklarerar en begränsning på den Konfigurera typ. Vi kommer inte heller kunna starta noden utan att tillhandahålla fullständig konfiguration.
Nodens adressupplösning
För att upprätta en anslutning behöver vi en verklig värdadress för varje nod. Den kan bli känd senare än andra delar av konfigurationen. Därför behöver vi ett sätt att tillhandahålla en mappning mellan nod-id och dess faktiska adress. Denna mappning är en funktion:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Det finns några möjliga sätt att implementera en sådan funktion.
- Om vi vet de faktiska adresserna före distributionen, under nodvärdarens instansiering, då kan vi generera Scala-kod med de faktiska adresserna och köra bygget därefter (vilket utför kompileringstidskontroller och sedan kör integrationssviten). I detta fall är vår mappningsfunktion känd statiskt och kan förenklas till något som en
Map[NodeId, NodeAddress]. - Ibland får vi de faktiska adresserna först vid ett senare tillfälle när noden faktiskt startas, eller vi har inte adresser för noder som inte har startats än. I detta fall kan vi ha en upptäcktsjänst som startas före alla andra noder och varje nod kan annonsera sin adress i den tjänsten och prenumerera på beroenden.
- Om vi kan modifiera
/etc/hosts, kan vi använda fördefinierade värdnamn (sommy-project-main-nodeochecho-backend) och koppla detta namn till ip-adressen vid distribution.
I detta inlägg täcker vi inte dessa fall mer detaljerat. I själva verket i vårt leksaksexempel kommer alla noder att ha samma IP-adress — 127.0.0.1.
I detta inlägg kommer vi att överväga två layouter för distribuerade system:
- Enkelnodlayout, där alla tjänster placeras på den enda noden.
- Två nodlayout, där tjänst och klient ligger på olika noder.
Konfigurationen för en layout är följande:
Enkelnodkonfiguration
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifier av den enda noden
  \/\/ konfiguration av server
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Typ-säker tjänstportsspecifikation. *\/
  override def portNumber: PortNumber = 8088

  \/\/ konfiguration av klient

  \/** Vi kommer att använda tjänsten från samma värd. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hej"

  def pollInterval: FiniteDuration = 1.second

  \/\/ livscykelkontrollerkonfiguration
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ ytterligare 0,5 sekunder så att det blir 10 förfrågningar, inte 9.
}
Här skapar vi en enda konfiguration som utökar både server- och klientkonfigurationen. Dessutom konfigurerar vi en livscykelkontroller som normalt kommer att avsluta klient och server efter lifetime intervallet har passerat.
Samma uppsättning tjänsteimplementationer och konfigurationer kan användas för att skapa en systems layout med två separata noder. Vi behöver bara skapa med lämpliga tjänster:
Konfiguration för två noder
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! beroendespecifikation
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ ytterligare 0,5 sekunder så att det blir 10 förfrågningar, inte 9.

    def testMessage: String = "dolly"
  }
Se hur vi specificerar beroendet. Vi nämner den andra nodens tillhandahållna tjänst som ett beroende för den aktuella noden. Typen av beroende kontrolleras eftersom den innehåller en fantomtyp som beskriver protokollet. Och vid körning kommer vi att ha rätt nod-ID. Detta är en av de viktiga aspekterna av den föreslagna konfigurationsmetoden. Det ger oss möjlighet att ställa in porten endast en gång och se till att vi refererar till rätt port.
Implementering av två noder
För denna konfiguration använder vi exakt samma tjäntimplementationer. Inga förändringar alls. Men vi skapar två olika nodimplementationer som innehåller olika uppsättningar av tjänster:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Den första noden implementerar servern och behöver endast serverns konfiguration. Den andra noden implementerar klienten och behöver en annan del av konfigurationen. Båda noder kräver någon livslängdsspecifikation. För ändamålen av detta inlägg kommer tjänsten nod att ha oändlig livslängd som kan avslutas med SIGTERM, medan echo-klienten kommer att avslutas efter den konfigurerade tidsbegränsade perioden. Se för detaljer.
Övergripande utvecklingsprocess
Låt oss se hur detta tillvägagångssätt förändrar vårt arbete med konfiguration.
Konfigurationen som kod kommer att kompileras och producera en artefakt. Det verkar rimligt att separera konfigurationens artefakt från andra kodartefakter. Ofta kan vi ha en mängd olika konfigurationer på samma kodbas. Och självklart kan vi ha flera versioner av olika konfigurationsgrenar. I en konfiguration kan vi välja specifika versioner av bibliotek och detta kommer att förbli konstant varje gång vi distribuerar denna konfiguration.
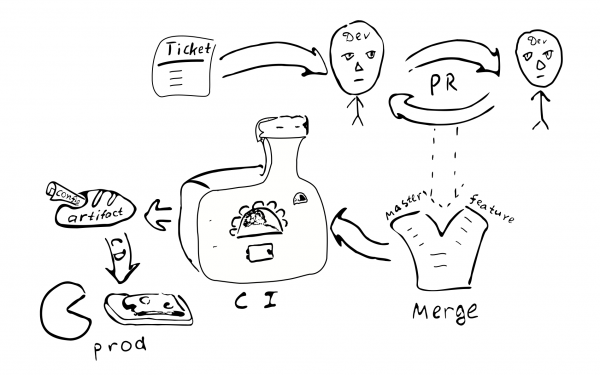
En konfigurationsändring blir en kodändring. Så den bör täckas av samma kvalitetssäkringsprocess:
Biljett -> PR -> granskning -> sammanslagning -> kontinuerlig integration -> kontinuerlig distribution
Det finns följande konsekvenser av tillvägagångssättet:
- Konfigurationen är sammanhängande för en specifik systemsinstans. Det verkar inte finnas något sätt att ha en felaktig koppling mellan noder.
- Det är inte lätt att ändra konfigurationen i bara en nod. Det verkar orimligt att logga in och ändra några textfiler. Så konfigurationsavvikelser blir mindre möjliga.
- Små konfigurationsändringar är inte lätta att göra.
- De flesta av konfigurationsändringarna kommer att följa samma utvecklingsprocess och kommer att passera någon form av granskning.
Behöver vi ett separat arkiv för produktionskonfigurationen? Produktionskonfigurationen kan innehålla känslig information som vi vill hålla utom räckhåll för många personer. Så det kan vara värt att ha ett separat arkiv med begränsad åtkomst som innehåller produktionskonfigurationen. Vi kan dela upp konfigurationen i två delar - en som innehåller de flesta öppna parametrarna för produktion och en som innehåller den hemliga delen av konfigurationen. Detta skulle möjliggöra åtkomst för de flesta utvecklare till den stora majoriteten av parametrarna samtidigt som åtkomsten till verkligen känsliga saker begränsas. Det är lätt att genomföra detta med hjälp av mellanliggande egenskaper med standardparametervärden.
Variationer
Låt oss se fördelar och nackdelar med det föreslagna tillvägagångssättet jämfört med andra tekniker för konfigurationshantering.
Först och främst listar vi några alternativ till de olika aspekterna av det föreslagna sättet att hantera konfiguration:
- Textfil på målmaskinen.
- Centraliserad nyckel-värde lagring (som
i den motsvarande Docker-bilden/zookeeper). - Undernätskomponenter som kan omkonfigureras/omstartas utan att processerna startas om.
- Konfiguration utanför artefakt och versionskontroll.
Textfil ger en viss flexibilitet när det gäller ad-hoc-fix. En systemadministratör kan logga in på målnoden, göra en ändring och helt enkelt starta om tjänsten. Detta kanske inte är lika bra för större system. Inga spår lämnas efter ändringen. Ändringen granskas inte av en annan person. Det kan vara svårt att ta reda på vad som orsakade ändringen. Den har inte testats. Från ett distribuerat systems perspektiv kan en administratör helt enkelt glömma att uppdatera konfigurationen i en av de andra noderna.
(Förresten, om det till slut blir nödvändigt att börja använda textkonfigurationsfiler, behöver vi bara lägga till en parser + validerare som kan producera samma Konfigurera typ och det skulle vara tillräckligt för att börja använda textkonfigurationer. Detta visar också att komplexiteten i konfiguration vid kompilering är något mindre än komplexiteten hos textbaserade konfigurationer, eftersom vi i textversionen behöver viss extra kod.)
Centraliserad nyckel-värde lagring är en bra mekanism för att distribuera applikationens meta-parametrar. Här behöver vi tänka på vad vi betraktar som konfigurationsvärden och vad som bara är data. Givet en funktion C => A => B kallar vi normalt sällan föränderliga värden C — «konfiguration», medan ofta föränderliga data A — bara indata. Konfiguration bör ges till funktionen tidigare än datan. A. Givet denna idé kan vi säga att det är den förväntade frekvensen av förändringar som kan användas för att särskilja konfigurationsdata från bara data. Dessutom kommer data typiskt från en källa (användare) och konfiguration från en annan källa (administratör). Att hantera parametrar som kan ändras efter processens initialisering leder till en ökning av applikationens komplexitet. För sådana parametrar måste vi hantera deras leveransmekanism, parsa och validera, samt hantera felaktiga värden. Därför, för att minska programkomplexiteten, är det bättre att minska antalet parametrar som kan ändras vid körning (eller till och med eliminera dem helt).
Ur denna inläggsperspektiv bör vi göra en åtskillnad mellan statiska och dynamiska parametrar. Om tjänstens logik kräver sällsynta ändringar av vissa parametrar vid körning, kan vi kalla dem dynamiska parametrar. Annars är de statiska och kan konfigureras med den föreslagna metoden. För dynamisk omkonfiguration kan andra metoder behövas. Till exempel kan delar av systemet startas om med de nya konfigurationsparametrarna på ett liknande sätt som att starta om separata processer i ett distribuerat system.
(Min ödmjuka åsikt är att undvika omkonfigurering vid körning eftersom det ökar systemets komplexitet.
Det kan vara mer okomplicerat att bara förlita sig på operativsystemets stöd för att starta om processer. Även om det kanske inte alltid är möjligt.)
En viktig aspekt av att använda statisk konfiguration är att människor ibland överväger dynamisk konfiguration (utan andra skäl) på grund av stillestånd under konfigurationsuppdateringar. Om vi måste göra ändringar i den statiska konfigurationen måste vi starta om systemet för att de nya värdena ska träda i kraft. Kraven på stillestånd varierar mellan olika system, så det kanske inte är så kritiskt. Om det är kritiskt måste vi planera i förväg för eventuella systemomstarter. Till exempel skulle vi kunna implementera . I detta scenario, när vi behöver starta om systemet, startar vi en ny instans av systemet parallellt, och sedan växlar vi ELB till det, medan vi låter det gamla systemet avsluta tjänsten för befintliga anslutningar.
Vad gäller att hålla konfigurationen antingen inom en versionerad artefakt eller utanför? Att hålla konfigurationen inom en artefakt betyder i de flesta fall att denna konfiguration har genomgått samma kvalitetskontrollprocess som andra artefakter. Så man kan vara säker på att konfigurationen håller hög kvalitet och är tillförlitlig. Å andra sidan, konfiguration i en separat fil innebär att det inte finns några spår av vem som gjorde och varför ändringar i den filen. Är detta viktigt? Vi tror att det för de flesta produktionssystem är bättre att ha en stabil och högkvalitativ konfiguration.
Versionen av artefakten gör att man kan ta reda på när den skapades, vilka värden den innehåller, vilka funktioner som är aktiverade/avstängda och vem som var ansvarig för att göra varje ändring i konfigurationen. Det kan kräva en del ansträngning att hålla konfigurationen inom en artefakt och det är ett designval som måste göras.
Fördelar & nackdelar
Här vill vi lyfta fram några fördelar och diskutera några nackdelar med den föreslagna metoden.
Fördelar
Egenskaper hos den kompilerbara konfigurationen av ett komplett distribuerat system:
- Statisk kontroll av konfigurationen. Detta ger en hög nivå av förtroende för att konfigurationen är korrekt med hänsyn till typbegränsningar.
- Rik konfigurationsspråk. Vanligtvis är andra konfigurationsmetoder begränsade till högst variabelersättning.
Genom att använda Scala kan man använda ett brett spektrum av språkfunktioner för att förbättra konfigurationen. Till exempel kan vi använda traits för att tillhandahålla standardvärden, objekt för att ställa in olika scope, och vi kan referera tillvals som definieras endast en gång i det yttre omfånget (DRY). Det är möjligt att använda litterära sekvenser eller instanser av vissa klasser (Seq,Karta, osv.). - DSL. Scala har ett anständigt stöd för DSL-skribenter. Man kan använda dessa funktioner för att etablera ett konfigurationsspråk som är mer praktiskt och användarvänligt, så att den slutliga konfigurationen åtminstone är läsbar av domänanvändare.
- Integritet och sammanhang över noder. En av fördelarna med att ha konfigurationen för hela det distribuerade systemet på ett ställe är att alla värden definieras strikt en gång och sedan återanvänds på alla ställen där vi behöver dem. Också typ-säkra portdeklarationer säkerställer att i alla möjliga korrekta konfigurationer kommer systemets noder att prata samma språk. Det finns explicita beroenden mellan noder vilket gör det svårt att glömma att tillhandahålla vissa tjänster.
- Hög kvalitet på ändringar. Den övergripande metoden att överföra konfigurationsändringar genom den normala PR-processen upprättar höga standarder för kvalitet även i konfiguration.
- Samtidig konfigurationsändringar. När vi gör några ändringar i konfigurationen säkerställer automatisk distribution att alla noder uppdateras.
- Förenkling av applikationen. Applikationen behöver inte parsa och validera konfigurationen och hantera felaktiga konfigurationsvärden. Detta förenklar den övergripande applikationen. (Viss ökning av komplexiteten finns i själva konfigurationen, men det är en medveten avvägning för säkerhet.) Det är ganska enkelt att återgå till vanlig konfiguration — bara lägga till de saknade delarna. Det är lättare att börja med komplierad konfiguration och skjuta upp implementeringen av ytterligare delar till senare.
- Versionerad konfiguration. Eftersom konfigurationsändringar följer samma utvecklingsprocess får vi ett artefakt med unik version. Detta gör att vi kan återgå till en tidigare konfiguration vid behov. Vi kan till och med distribuera en konfiguration som användes för ett år sedan och den kommer att fungera exakt likadant. Stabil konfiguration förbättrar förutsägbarheten och tillförlitligheten i det distribuerade systemet. Konfigurationen är fast vid kompileringstid och kan inte enkelt manipuleras på ett produktionssystem.
- Modularitet. Den föreslagna ramverkslösningen är modulär och moduler kan kombineras på olika sätt för
att stödja olika konfigurationer (uppsättningar/layouter). I synnerhet är det möjligt att ha en liten enkel nodlayout och en stor flernodig inställning. Det är rimligt att ha flera produktionslayouter. - Testning. För teständamål kan man implementera en mocktjänst och använda den som en beroende på ett typsäkert sätt. Flera olika testlayouter med olika delar ersatta av mocks kan upprätthållas samtidigt.
- Integreringstestning. Ibland kan det vara svårt att köra integrationstester i distribuerade system. Genom att använda den beskrivna metoden för typsäker konfiguration av det kompletta distribuerade systemet kan vi köra alla distribuerade delar på en enda server på ett kontrollerbart sätt. Det är enkelt att efterlikna situationen
när en av tjänsterna blir otillgänglig.
Nackdelar
Den komplierade konfigurationsmetodiken skiljer sig från "normal" konfiguration och den kanske inte passar alla behov. Här är några av nackdelarna med den komplierade konfigurationen:
- Statisk konfiguration. Den kanske inte är lämplig för alla applikationer. I vissa fall finns det ett behov av att snabbt fixa konfigurationen i produktion utan att följa säkerhetsåtgärderna. Denna metod gör det mer komplicerat. Kompilering och omdistribution krävs efter varje förändring i konfigurationen. Detta är både en funktion och en börda.
- Konfigurationsgenerering. När konfigurationen genereras av ett automatiseringsverktyg kräver denna metod efterföljande kompilering (som i sin tur kan misslyckas). Det kan kräva ytterligare arbete för att integrera detta extra steg i byggsystemet.
- Verktyg. Det finns många verktyg som används idag som förlitar sig på textbaserade konfigurationer. Vissa av dem
kommer inte att vara tillämpliga när konfigurationen är komplierad. - Ett tankesätt behöver förändras. Utvecklare och DevOps är vana vid textkonfigurationsfiler. Idén om att kompilera konfiguration kan verka märklig för dem.
- Innan kompilering av konfiguration införs krävs en högkvalitativ mjukvaruutvecklingsprocess.
Det finns vissa begränsningar i det implementerade exemplet:
- Om vi tillhandahåller extra konfiguration som inte efterfrågas av nodimplementeringen, hjälper inte kompilatorn oss att upptäcka den frånvarande implementeringen. Detta kan åtgärdas genom att använda
HListeller ADTs (fallklasser) för nodkonfiguration istället för traits och Cake-mönster. - Vi måste tillhandahålla viss mall i konfigurationsfilen: (
paket,import,objectdeklarationer;
override def‘s för parametrar som har standardvärden). Detta kan delvis åtgärdas med en DSL. - I detta inlägg täcker vi inte dynamisk omkonfiguration av kluster av liknande noder.
Slutsats
I det här inlägget har vi diskuterat idén att representera konfiguration direkt i källkoden på ett typ-säkert sätt. Denna metod kan användas i många applikationer som en ersättning för XML- och andra textbaserade konfigurationer. Trots att vårt exempel har implementerats i Scala kan det även översättas till andra kompilerbara språk (som Kotlin, C#, Swift, etc.). Man kan prova denna metod i ett nytt projekt och, om den inte passar bra, byta till det gamla sättet.
Självklart kräver kompilerbar konfiguration en utvecklingsprocess av hög kvalitet. I utbyte lovar den att ge en lika högkvalitativ och robust konfiguration.
Denna metod kan utvidgas på olika sätt:
- Man kan använda makron för att utföra konfigurationsvalidering och misslyckas vid kompileringstid vid eventuella misslyckanden med affärslogikens begränsningar.
- En DSL kan implementeras för att representera konfiguration på ett domänanvändarvänligt sätt.
- Dynamisk resursförvaltning med automatiska justeringar av konfigurationen. Till exempel, när vi justerar antalet klusternoder kan vi vilja (1) att noderna får en något modifierad konfiguration; (2) att klusterchefen får information om de nya noderna.
Tack
Jag vill tacka Andrey Saksonov, Pavel Popov, Anton Nehaev för deras inspirerande feedback på utkastet till detta inlägg som hjälpte mig att göra det tydligare.
Källa: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish