

Just nu är DevOps ett hett ämne. Pipelines för kontinuerlig integration och leverans implementeras av alla som orkar. Men de flesta uppmärksammar inte alltid den pålitlighet som informationssystemens drift kräver i olika skeden av CI/CD-pipelinen. I den här artikeln skulle jag vilja dela med mig av mina erfarenheter av att automatisera kvalitetskontroller av programvara och implementera möjliga scenarier för dess "självåterställning".
Jag arbetar som ingenjör inom IT-tjänstehantering på företaget . Mitt fokusområde är implementering av olika system för övervakning av prestanda och tillgänglighet av applikationer. Jag kommunicerar ofta med IT-kunder från olika marknadssegment angående aktuella frågor kring övervakning av deras IT-tjänsters kvalitet. Huvudmålet är att minimera cykeltiden för lanseringar och öka frekvensen av dessa. Det låter bra: fler lanseringar – fler nya funktioner – fler nöjda användare – högre intäkter. Men i verkligheten går det inte alltid så bra. Med väldigt hög lanseringstakt dyker genast frågan om kvaliteten på våra lanseringar upp. Även med en helt automatiserad pipeline är en av de största problemen övergången av tjänster från testning till produktion, utan att påverka driftsäkerheten och användarnas interaktion med applikationen.
Enligt resultat av många samtal med kunder kan jag säga att kvaliteten på lanseringar, applikationens tillförlitlighet och möjligheten till dess "självåterställning" (till exempel en rollback till en stabil version) i olika skeden av CI/CD-pipelinen är bland de mest angelägna och aktuella ämnena.
Nyligen arbetade jag själv på kundens sida - inom supporttjänsten för applikationsprogramvara för en onlinebank. I vår applikations arkitektur användes ett stort antal skräddarsydda mikrotjänster. Det mest sorgliga var att inte alla utvecklare klarade av den höga utvecklingstakten; kvaliteten på vissa mikrotjänster led, vilket ledde till komiska smeknamn för dem och deras skapare. Det började cirkulera historier om vad dessa produkter verkligen består av.
«Uppgiftsformulering»
Hög frekvens av releaser och ett stort antal mikrotjänster gör det svårt att förstå hur applikationen fungerar som helhet, både under testning och drift. Förändringar sker ständigt och att kontrollera dem utan bra övervakningsverktyg är mycket svårt. Ofta sitter utvecklarna som på nålar efter en nattrelease och väntar på att ingenting ska gå fel, även om alla tester var framgångsrika under testfasen.
Det finns en annan aspekt. Under testfasen kontrolleras programvarans funktionalitet: utförandet av applikationens grundläggande funktioner och avsaknad av fel. Kvalitetsbedömningar av prestanda saknas ofta, eller så beaktar de inte alla aspekter av applikationens arbete och integrationslagret. Vissa mätvärden kan överhuvudtaget inte kontrolleras. Som ett resultat får supportavdelningen veta om ett fel i produktionsmiljön först när riktiga användare börjar klaga. Vi vill minimera påverkan av dålig programvara på slutkunder.
Ett av sätten att lösa problemet är att implementera kvalitetskontrollprocesser för programvaran på olika steg i CI/CD-pipelinen och lägga till olika scenarier för systemåterställning vid nödsituationer. Kom ihåg att vi har DevOps. Företaget förväntar sig en så snabb leverans av nya produkter som möjligt. Därför måste alla våra tester och scenarier automatiseras.
Uppgiften delas upp i två delar:
- kontroll av kvalitén på byggen under testfasen (automatisera processen för att fånga upp dåliga byggen);
- kontroll av kvalitén på programvaran i produktionsmiljö (automatiska mekanismer för att upptäcka problem och möjliga scenarier för att självåterhämta sig).
Verktyg för övervakning och insamling av mätvärden
För att kunna genomföra de uppsatta målen krävs ett övervakningssystem som kan upptäcka problem och vidarebefordra dem till automatiseringssystem på olika steg i CI/CD-konceptet. Det är också positivt om detta system erbjuder användbara mätvärden för olika team: utveckling, test och drift. Och det skulle vara fantastiskt om det också gynnar affärsverksamheten.
För att samla in mätdata kan en kombination av olika system (Prometheus, ELK Stack, Zabbix etc.) användas, men enligt min åsikt passar APM-lösningar () bäst för dessa uppgifter och kan verkligen förenkla ert arbete.
Inom ramen för mitt arbete i supporttjänsten började jag med ett liknande projekt, där jag använde APM-lösningen från Dynatrace. Nu, i min roll som integratör, känner jag marknaden för övervakningssystem ganska väl. Min subjektiva åsikt: Dynatrace är den mest lämpliga för att lösa sådana uppgifter.
Dynatraces lösning erbjuder en horisontell visualisering av varje användaroperation med djup detaljrikedom ända ner till kodnivå. Man kan följa hela kedjan av interaktioner mellan olika informationssystem: från nivåerna av frontend webb- och mobilapplikationer, backend applikationsservrar, integrationsbuss till det specifika anropet i databasen.
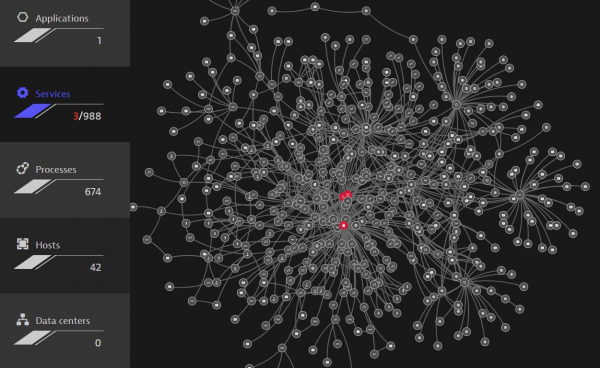 . Automatisk konstruktion av alla beroenden mellan systemkomponenterna
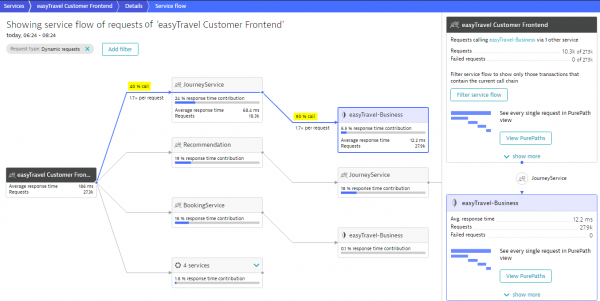 . Automatisk identifiering och konstruktion av serviceoperationens väg
Kom ihåg att vi också behöver integrera med olika automatiseringsverktyg. Här har lösningen ett praktiskt API som möjliggör att skicka och ta emot olika mätdata och händelser.
Låt oss gå vidare till en mer detaljerad genomgång av hur man löser de angivna uppgifterna med hjälp av Dynatrace-systemet.
Uppgift 1. Automatisering av kvalitetskontroll av byggnader i teststeget
Den första uppgiften är att upptäcka problem så tidigt som möjligt i applikationens leveranskedja. Endast "bra" kodbyggnader bör nå produktionsmiljön. För detta ska ni i er pipeline i teststeget inkludera ytterligare övervakare för att kontrollera kvaliteten på era tjänster.
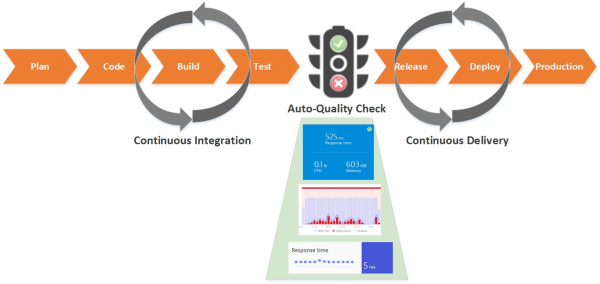
Låt oss stega igenom hur detta kan realiseras och automatiseras:
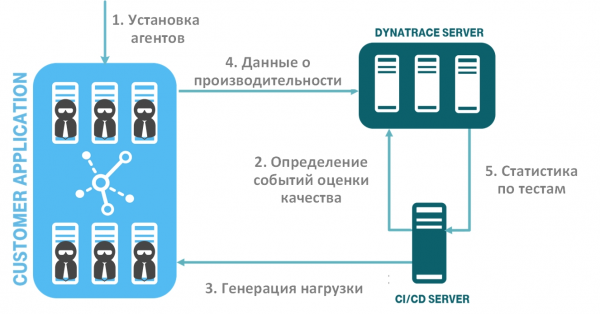
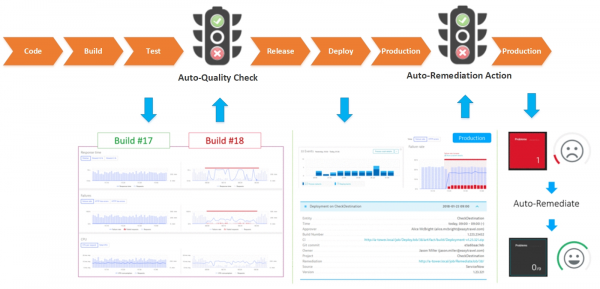
Diagrammet visar flödet av automatiserade steg för kvalitetskontroll av programvara:
- implementering av övervakningssystemet (installation av agenter);
- identifiering av kvalitetsbedömningshändelser för er programvara (mätdata och tröskelvärden) och överföring till övervakningssystemet;
- generering av belastning och prestandatester;
- insamling av data om prestanda och tillgänglighet i övervakningssystemet;
- överföring av data om tester baserade på händelser för kvalitetsbedömning av programvara, från övervakningssystemet till CI/CD-systemet. Automatisk analys av byggnader.
Steg 1. Utveckling av övervakningssystemet
Först måste du installera agenter i din testmiljö. Dynatrace-lösningen har en trevlig funktion – den använder den universella agenten OneAgent, som installeras på OS-instansen (Windows, Linux, AIX), automatiskt upptäcker dina tjänster och börjar samla in övervakningsdata om dem. Du behöver inte konfigurera en agent för varje process separat. Samma förhållande gäller för moln- och containerplattformar. Installationsprocessen för agenter kan också automatiseras. Dynatrace passar perfekt in i konceptet 'infrastruktur som kod' (): det finns redan färdiga skript och instruktioner för alla populära plattformar. Du integrerar agenten i konfigurationen av din tjänst, och vid dess distribution får du omedelbart en ny tjänst med en redan fungerande agent.
Steg 2. Bestämning av kvalitetsbedömningshändelser för din programvara
Nu måste du bestämma vilka tjänster och affärsoperationer som ska ingå. Det är viktigt att ta hänsyn till just de användaroperationer som är affärskritiska för din tjänst. Här rekommenderas att rådgöra med affärs- och systemanalytiker.
Därefter måste du bestämma vilka metrik du vill inkludera i kontrollen för varje nivå. Till exempel kan detta vara genomströmningstid (uppdelat på medelvärde, median, percentiler osv.), fel (logiska, tjänster, infrastruktur osv.) och olika infrastrukturmetriker (minnesheap, skräpnivå, trådantal osv.).
För att automatisera och underlätta användningen av DevOps-teamet introduceras konceptet 'Övervakning som kod'. Vad jag menar med detta är att utvecklare/testare kan skriva en enkel JSON-fil som definierar indikatorerna för programvarukvalitet.
Låt oss ta en titt på ett exempel på en sådan JSON-fil. Som en nyckel/värde-par används objekt från Dynatrace API (API-beskrivning kan ses här ).
{
    "timeseries": [
    {
      "timeseriesId": "service.ResponseTime",
      "aggregation": "avg",
      "tags": "Frontend",
      "severe": 250000,
      "warning": 1000000
    },
    {
      "timeseriesId": "service.ResponseTime ",
      "aggregation": "avg",
      "tags": "Backend",
      "severe": 4000000,
      "warning": 8000000
    },
    {
      "timeseriesId": "docker.Container.Cpu",
      "aggregation": "avg",
      "severe": 50,
      "warning": 70
    }
  ]
}
Filen är en array av definitioner av tidsserier (timeseries):
- timeseriesId – den mätta metrik, som till exempel svarstid, antalet fel, använd minne osv.;
- aggregation – nivån för aggregering av metrik, i vårt fall avg, men du kan använda vilken som helst som du behöver (avg, min, max, sum, count, percentile);
- tags – taggen för objektet i övervakningssystemet, eller så kan du ange ett specifikt objekt-ID;
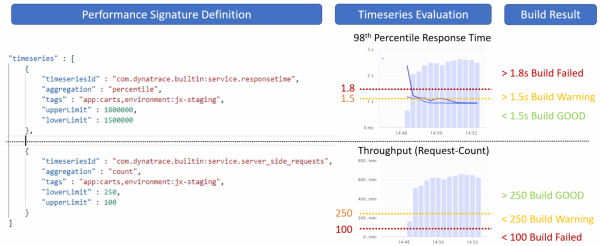
- severe och warning – dessa indikatorer styr tröskelvärdena för våra metrik, om testvärdet överstiger det allvarliga tröskelvärdet, så markeras vår körning som misslyckad.
Följande bild visar ett exempel på användning av sådana trösklar.
Steg 3. Generering av belastning
Efter att vi har fastställt kvalitetsnivåerna för vår tjänst, behöver vi generera en testbelastning. Du kan använda vilket verktyg för testning som helst som passar dig, till exempel Jmeter, Selenium, Neotys, Gatling osv.
Övervakningssystemet Dynatrace möjliggör insamling av olika metadata från dina tester och identifierar vilket test som hör till vilken releasecykel och vilken tjänst. Det rekommenderas att lägga till ytterligare headers i HTTP-begärningarna för testerna.
Följande bild visar ett exempel där vi med hjälp av den ytterligare headern X-Dynatrace-Test markerar att detta test hör till testningen av operationen att lägga en vara i varukorgen.
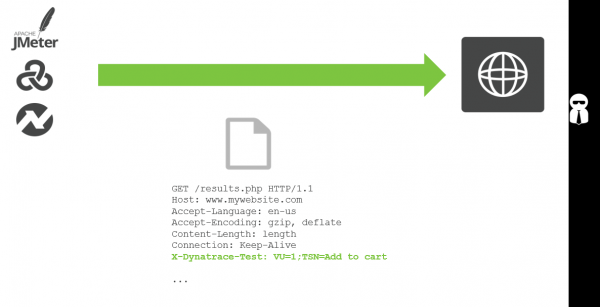
Vid varje belastningstest skickar du ytterligare kontextinformation till Dynatrace via API-händelsen från CI/CD-servern. På så sätt kan systemet särskilja olika tester.
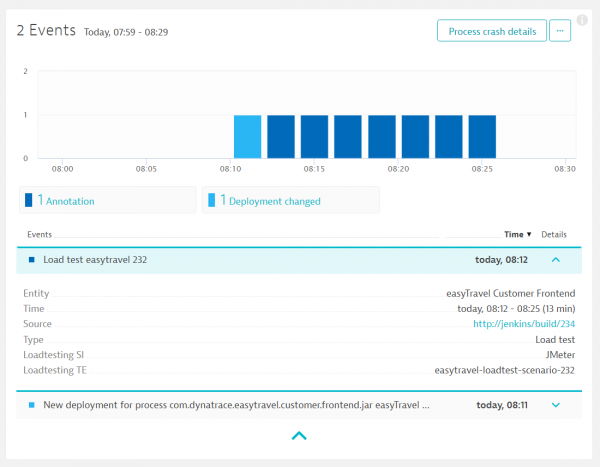 . Händelse i övervakningssystemet om starten av belastningstestning
Steg 4-5. Insamling av prestandadata och överföring av data till CI/CD-systemet
Tillsammans med den genererade testen skickas en händelse till övervakningssystemet om behovet av att samla in data om kvalitetsindikatorerna. Dessutom anges vår JSON-fil, i vilken nyckelmetrik har definierats.
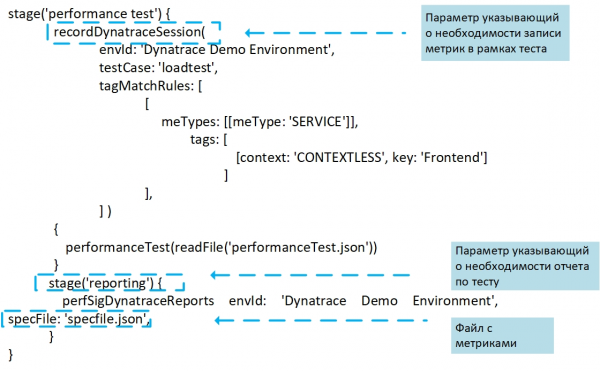 Ett händelse om behovet av att verifiera programvarukvalitet som genereras på CI/CD-servern för att skickas till övervakningssystemet
I vårt exempel kallas händelsen för kvalitetsverifiering perfSigDynatraceReport (Performance_Signature) – är färdig för integration med Jenkins, som utvecklades av teamet från T-Systems Multimedia Solutions. Varje händelse om start av verifiering innehåller information om tjänsten, byggnumret och testtiden. Plugins samlar in prestandavärden under byggprocessen, utvärderar dem och jämför resultaten med tidigare byggen och icke-funktionella krav.
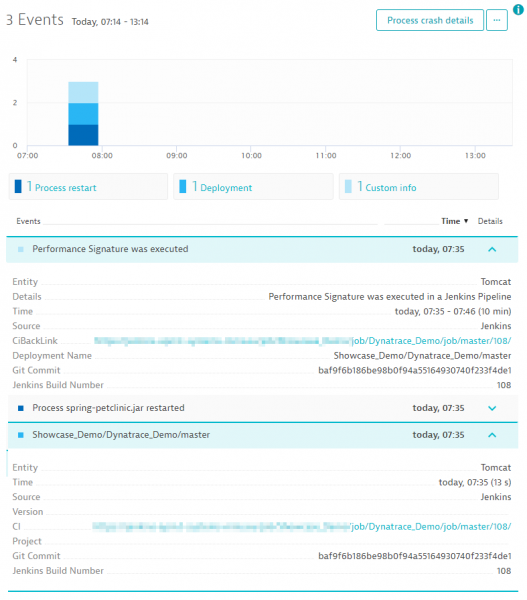 Händelsen i övervakningssystemet om start av kvalitetsverifiering av bygget.
När testet är avslutat skickas alla kvalitetsvärden tillbaka till det kontinuerliga integrationssystemet, till exempel Jenkins, som genererar en rapport baserad på resultaten.
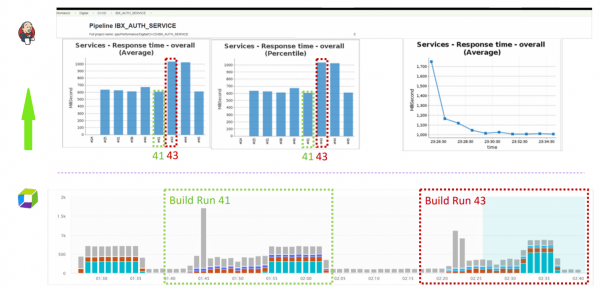 Statistikresultat per bygge på CI/CD-servern.
För varje enskilt bygge ser vi statistiken för varje angiven mätvärde under hela testets utförande. Vi ser också om det förekommit överträdelser av vissa tröskelvärden (varning och svåra trösklar). Baserat på sammanlagda indikatorer märks hela bygget som stabilt, instabilt eller misslyckat. För bekvämlighet kan du också lägga till jämförelseindikatorer för det aktuella bygget med det föregående i rapporten.
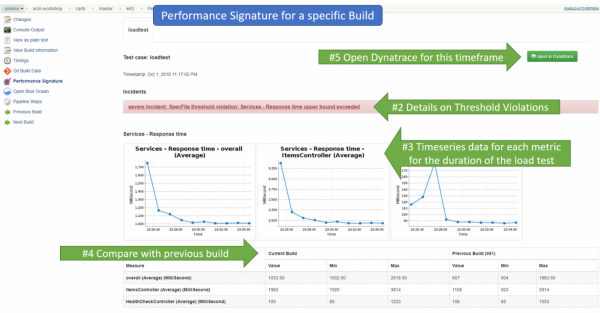 Visa detaljerad statistik över byggen på CI/CD-servern.
Detaljerad jämförelse av två byggen
Vid behov kan du gå till Dynatrace-gränssnittet och där mer detaljerat granska statistiken för varje av dina byggen och jämföra dem med varandra.
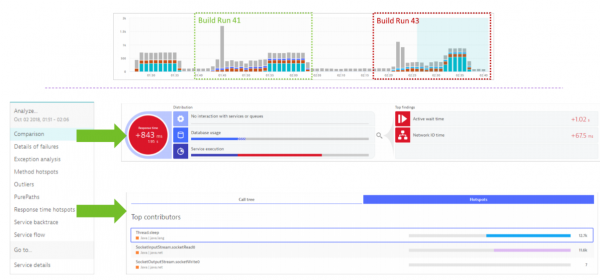 Jämförelse av statistik för byggen i Dynatrace.
Slutsatser
Resultatet är en tjänst "övervakning som en tjänst", automatiserad i den kontinuerliga integrationskanalen. Utvecklaren eller testaren behöver bara ange en lista med mätvärden i en JSON-fil, därefter sker allt automatiskt. Vi får transparent kontroll över kvaliteten på releaser: alla aviseringar om prestanda, resursförbrukning eller arkitektoniska regressioner.
Uppgift 2. Automatisering av programvarukvalitetskontroll i produktionsmiljö
Så vi har löst problemet med hur man automatiserar övervakningsprocessen under testning i pipeline. På så sätt minimerar vi andelen kvalitetsmässigt dåliga byggen som når produktionsmiljön.
Men vad ska man göra om dålig programvara ändå har nått produktion, eller om något helt enkelt har slutat fungera? För vår utopi ville vi att det skulle finnas mekanismer för automatisk upptäckte av problem och, om möjligt, att systemet självt skulle återställa sin funktionalitet, åtminstone på natten.
För detta behöver vi, i likhet med föregående avsnitt, förutse automatiska kvalitetskontroller av programvaran i produktionsmiljö och lägga in scenarier för systemets självåterställning.
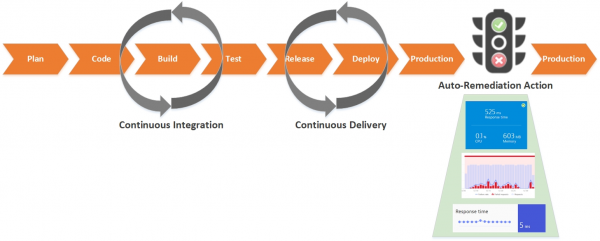
Självkorrektion som kod
Flera företag har redan en samlad kunskapsbas om olika typer av vanliga problem och en lista över åtgärder för att åtgärda dem, till exempel att starta om processer, rensa resurser, återställa versioner, återställa felaktiga ändringar i konfigurationen, öka eller minska antalet komponenter i klustret, växla mellan blå eller grön miljö, och mer.
Trots att dessa användningsområden har varit kända i många år av många team, har få funderat på och investerat i deras automatisering.
Om man tänker efter, så finns det inget särskilt komplicerat i att implementera processer för självåterställning av applikationens funktionalitet; det handlar bara om att representera de kända arbetsflödena från dina administratörer i form av kodscenarier (konceptet "självkorrektion som kod"), som du har förberett i förväg för varje specifik situation. Scenarier för automatisk korrigering bör syfta till att åtgärda grundorsaken till problemet. Du bestämmer själv vilka reaktionsåtgärder som ska vidtas vid incidenter.
Som en trigger för att starta scenariet kan vilken som helst metrisk från ditt övervakningssystem användas, så länge dessa metrik exakt identifierar att något är fel, eftersom man inte vill få falska larm i produktionsmiljö.
Du kan använda vilket system eller kombination av system som helst: Prometheus, ELK Stack, Zabbix och så vidare. Men jag kommer att ge några exempel baserade på APM-lösningar (som återigen kommer att vara Dynatrace), vilket också kommer att underlätta ditt liv.
För det första finns allt som rör funktionalitet sett ur applikationens perspektiv. Lösningen erbjuder hundratals metrik på olika nivåer som du kan använda som triggers:
- användarnivå (webbläsare, mobilappar, IoT-enheter, användarbeteende, konvertering etc.);
- tjänst- och driftsnivå (prestanda, tillgänglighet, fel etc.);
- applikationsinfrastrukturnivå (OS-metrik för värd, JMX, MQ, webbserver etc.);
- plattformsnivåer (virtualisering, moln, behållare etc.).
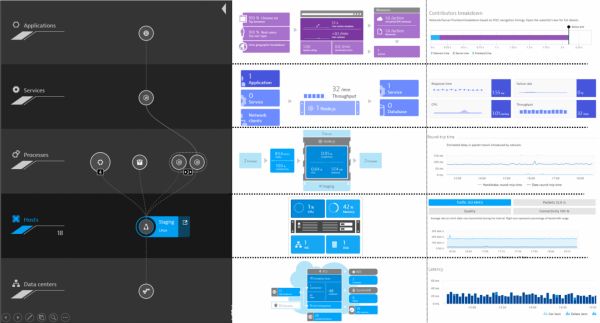 Övervakningsnivåer i Dynatrace.
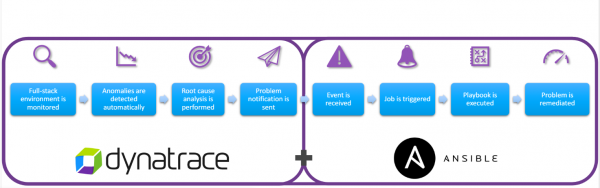
För det andra, som jag nämnde tidigare, har Dynatrace ett öppet API som gör det mycket enkelt att integrera med olika tredjepartssystem. Till exempel att skicka en notifikation till automatiseringssystemet vid överskridande av kontrollparametrar.
Nedan följer ett exempel på interaktion med Ansible.
Jag kommer nu att ge några exempel på vilka automatiseringar som kan göras. Dessa är bara en del av fallen, och listan i din miljö kan begränsas av endast din fantasi och de verktyg du använder för övervakning.
1. Dålig deploy – återställning av version
Även om vi kontrollerar allt mycket noggrant i testmiljön finns det alltid en chans att den nya utgåvan kan döda din applikation i produktionsmiljön. Den mänskliga faktorn kan inte negligeras.
I nästa bild ser vi att det sker ett plötsligt hopp i operationernas genomförandetid på tjänsten. Början av detta hopp sammanfaller med tiden för deployment på applikationen. All denna information överförs som händelser till automatiseringssystemet. Om tjänstens funktionalitet inte normaliseras efter den angivna tiden, så anropas automatiskt ett script som återställer versionen till den gamla.
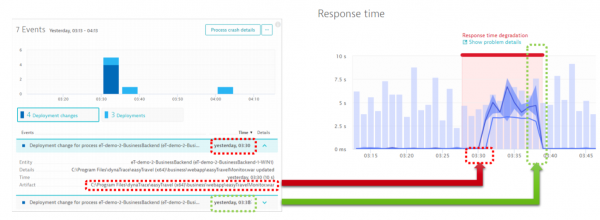 Prestandadegradering av operationer efter deployment.
2. Resursbelastning på 100% – lägg till en nod i routingen
I nästa exempel identifierar övervakningssystemet att en av komponenterna visar 100% CPU-belastning.
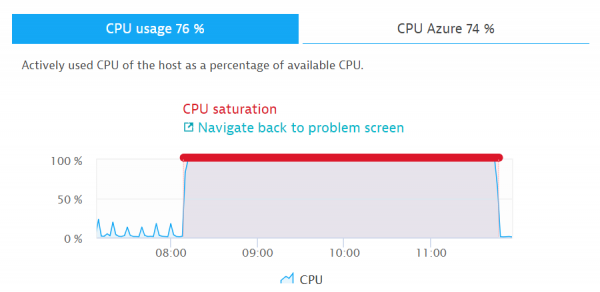 CPU-belastning 100%
Det finns flera olika scenarier som kan följas för detta evenemang. Till exempel kontrollerar övervakningssystemet om resursbristen är relaterad till ökad belastning på tjänsten. Om ja, körs ett script som automatiskt lägger till en nod i routingen, vilket återställer systemets funktionalitet som helhet.
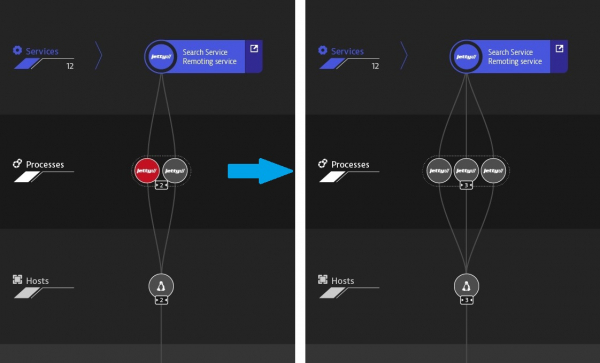 Skalning efter incidenten
3. Ingen lagringsutrymme på hårddisken – rensa disken
Jag tror att många redan har automatiserat dessa processer. Med hjälp av APM kan man också övervaka det lediga utrymmet på lagersystemet. Vid brist på utrymme eller långsam diskarbete kan vi köra ett skript för att rensa eller lägga till mer utrymme.
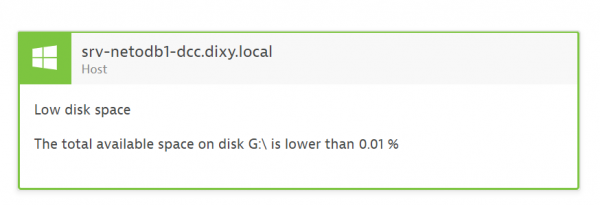
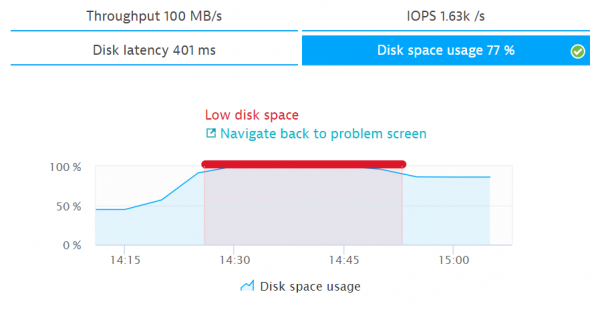 Diskanvändning 100%
4. Låg användaraktivitet eller låg konvertering – växling mellan blå och grön gren
Jag stöter ofta på kunder som använder två konturer (blue-green deploy) för applikationer i produktionsmiljö. Detta gör det möjligt att snabbt växla mellan grenarna vid leverans av nya versioner. Ofta kan det inträffa drastiska förändringar efter en deployment som inte omedelbart märks. Under tiden kan degradering av prestanda och tillgänglighet vara oobserverad. För att snabbt kunna reagera på sådana förändringar är det bättre att använda olika metriker som reflekterar användarbeteende (antal sessioner och användaråtgärder, konvertering, bounce rate). På nästa bild visas ett exempel där växling mellan programvarugrenar sker vid en minskning av konverteringen.
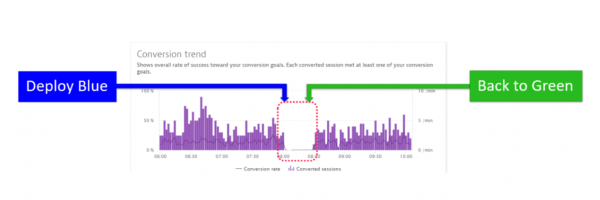 En minskning av konverteringen efter växling mellan programvarugrenar.
Automatiska mekanismer för att identifiera problem
I slutet ger jag ytterligare ett exempel på vad jag gillar mest med Dynatrace.
I delen av min berättelse om automatisering av kvalitetskontroll av byggen i testmiljö definierade vi alla tröskelvärden manuellt. För testmiljö är detta normalt, testaren definierar själv indikatorer före varje kontroll beroende på belastning. I produktionsmiljö är det önskvärt att problem upptäcks automatiskt med beaktande av olika baslinjemekanismer.
Dynatrace har intressanta inbyggda verktyg för artificiell intelligens som, baserat på mekanismer för att identifiera anomalier (baselining) och bygga en interaktionskarta mellan alla komponenter, jämför och korrelerar händelser, identifierar anomalier i din tjänsts arbete och ger detaljerad information om varje problem och rotorsak.
Genom automatisk analys av beroenden mellan komponenter identifierar Dynatrace inte bara om den problematiska tjänsten är den primära orsaken, utan också dess beroende av andra tjänster. I exemplet nedan övervakar och utvärderar Dynatrace automatiskt prestandan hos varje tjänst under transaktioner och identifierar Golang-tjänsten som huvudorsaken.
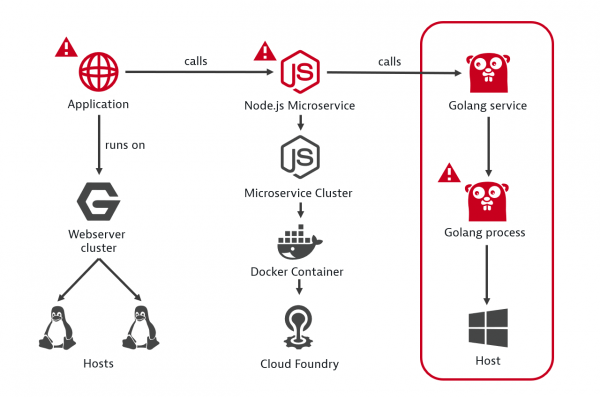 Exempel på identifiering av rotorsaken till ett fel.
I bilden nedan visas processen för att övervaka problem med din applikation från början av incidenten.
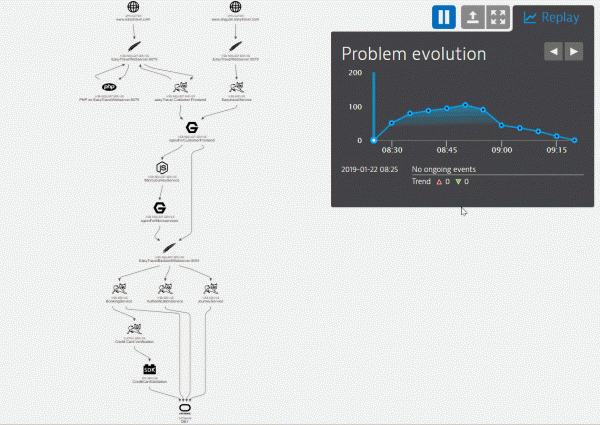 Visualisering av det uppkomna problemet med visning av alla komponenter och händelser kring dem
Övervakningssystemet har samlat en komplett tidslinje över händelser för det uppkomna problemet. I fönstret under tidslinjen ser vi alla nyckelhändelser för varje komponent. Baserat på dessa händelser kan du ställa in rutiner för automatisk reparation i form av kodscenarier.
Jag rekommenderar även att integrera övervakningssystemet med Service Desk eller buggrapporteringssystem. Vid problem får utvecklarna snabbt all information för analys på kodenivå i produktionsmiljön.
Slutsats
Resultatet blev en CI/CD-pipeline med inbyggda automatiserade kvalitetskontroller i pipeline. Vi minimerar antalet dåliga versioner, ökar systemets tillförlitlighet som helhet, och om systemets funktionalitet ändå påverkas, aktiverar vi mekanismer för att återställa den.
Att automatisera övervakningen av mjukvarukvalitet är definitivt värt ansträngningen, det är inte alltid en snabb process, men med tiden ger det sina resultat. Jag rekommenderar att efter att ha löst en ny incident i produktionsmiljön, direkt tänka på vilka övervakningar som kan läggas till för tester i testmiljön för att förhindra att en dålig version går till produktion, samt att utarbeta ett skript för automatisk reparation av dessa problem.
Jag hoppas att mina exempel kommer att hjälpa dig i dina strävanden. Jag skulle också vara intresserad av att se dina exempel på använda metrik för att implementera självåterställning av systemens funktionalitet.
Källa: habr.com
