

Obs. övers.: Den här lärorika historien från Omio – den europeiska resesamlaren – för andra läsare från grundläggande teori till spännande praktiska detaljer i konfigureringen av Kubernetes. Att bekanta sig med sådana fall hjälper inte bara till att bredda perspektiven, utan även att förebygga komplexa problem.
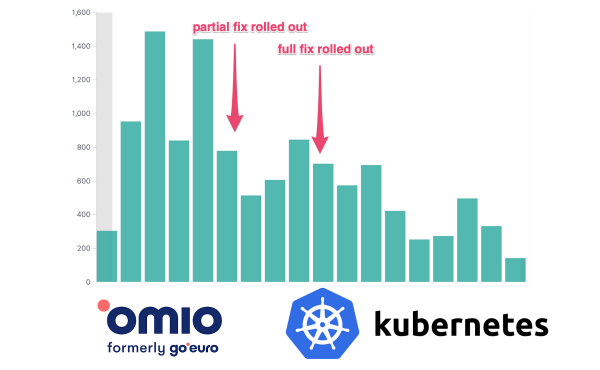
Har du någonsin stött på att en applikation "stannade upp", slutade svara på statuskontroller (health check) och du inte kunde förstå orsaken till detta beteende? En av de möjliga förklaringarna är relaterad till kvotgränser för CPU-resurser. Det är vad denna artikel handlar om.
TL;DR:
Vi rekommenderar starkt att avstå från CPU-gränser i Kubernetes (eller stänga av CFS-kvoter i Kubelet) om en version av Linux-kärnan med CFS-kvotsfel används. I kärnan finns en allvarlig och bugg som leder till överdriven throttling och fördröjningar..
I Omio hanteras all infrastruktur av Kubernetes.Alla våra stateful- och stateless-laster körs uteslutande på Kubernetes (vi använder Google Kubernetes Engine). Under de senaste sex månaderna har vi observerat slumpmässiga fördröjningar. Applikationer fryser eller slutar svara på health checks, tappar nätverksanslutning och så vidare. Ett sådant beteende har länge ställt oss inför svårigheter, och till slut bestämde vi oss för att ta itu med problemet på allvar.
Sammanfattning av artikeln:
- Några ord om containrar och Kubernetes;
- Hur CPU-begärningar och gränser är implementerade;
- Hur CPU-gränser fungerar i miljöer med flera kärnor;
- Hur man övervakar CPU-throttling;
- Lösning av problemet och dess nyanser.
Några ord om containrar och Kubernetes
Kubernetes är i grunden den moderna standarden inom infrastrukturvärlden. D dess huvudsakliga uppgift är orkestrering av containrar.
Containrar
Tidigare var vi tvungna att skapa artefakter som Java JAR/WAR-filer, Python Egg-filer eller exekverbara filer för senare körning på servrar. Men för att få dem att fungera var vi tvungna att göra extra arbete: installera körmiljön (Java/Python), placera nödvändiga filer på rätt ställen, säkerställa kompatibilitet med en specifik version av operativsystemet, etc. Med andra ord var vi tvungna att noggrant hantera konfigurationerna (vilket ofta orsakade konflikter mellan utvecklare och systemadministratörer).
Containrar har förändrat allt. Nu är artefakten en containerbild. Den kan ses som en utvidgad körbar fil som innehåller inte bara programmet utan också en fullständig körmiljö (Java/Python/...), samt nödvändiga filer/paket som är förinstallerade och redo att användas. Containrar kan distribueras och köras på olika servrar utan några ytterligare åtgärder.
Dessutom arbetar containrar i sin egen sandbox-miljö. De har sin egen virtuella nätverksadapter, ett filsystem med begränsad tillgång, sin egen processhierarki, samt begränsningar för CPU och minne etc. Allt detta realiseras tack vare en särskild del av Linux-kärnan — namespaces.
Kubernetes
Som nämnts tidigare är Kubernetes en containerorkestrator. Den fungerar så här: du ger den en pool av maskiner och säger: "Hej, Kubernetes, kör tio instanser av min container med 2 processorer och 3 GB minne vardera, och håll dem i drift!" Kubernetes tar hand om resten. Den hittar lediga resurser, startar containrarna och kommer att starta om dem vid behov, uppdatera vid versionförändringar osv. I grunden låter Kubernetes dig abstrahera från hårdvarukomponenter och gör alla olika system lämpliga för distribution och drift av applikationer.
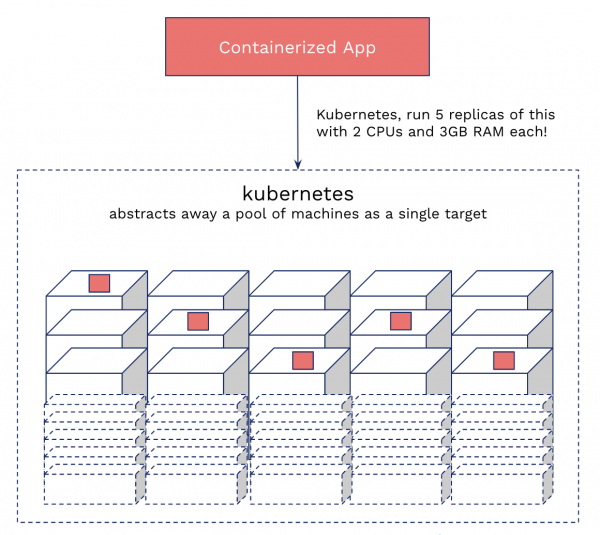
Kubernetes ur en enkel persons perspektiv
Vad är request:er och limit:er i Kubernetes
Okej, vi har förstått containrar och Kubernetes. Vi vet också att flera containrar kan finnas på en och samma maskin.
Vi kan dra en parallell med en delad lägenhet. Man tar ett rymligt rum (maskiner/noder) och hyr ut det till flera hyresgäster (containrar). Kubernetes fungerar som mäklare. Frågan uppstår, hur kan vi förhindra att hyresgästerna kommer i konflikt med varandra? Vad händer om en av dem, säg, bestämmer sig för att ta över badrummet i ett halvt dygn?
Här kommer request:er och limit:er in i bilden. CPU Begäran behövs uteslutande för planering. Det är något av en "önskelista" för containern, och används för att välja den mest lämpliga noden. Samtidigt kan CPU Begränsa jämföras med hyresavtalet — så snart vi hittar en nod för containern, kan den inte överskrida de angivna gränserna. Och här uppstår problemet…
Hur requests och limits implementeras i Kubernetes
Kubernetes använder en inbyggd kärnfunktion för throttling (taktbegränsning) för att genomföra CPU-limits. Om en applikation överskrider gränsen aktiveras throttling (d.v.s. den får färre CPU-taktscykler). Requests och limits för minne organiseras på ett annat sätt, vilket gör dem lättare att upptäcka. Det räcker att kontrollera den senaste omstartstatusen för podden: om den inte är "OOMKilled". Med CPU-throttling är det inte så enkelt, eftersom K8s endast gör användningsmetrik tillgänglig, inte per cgroups.
CPU-begäran
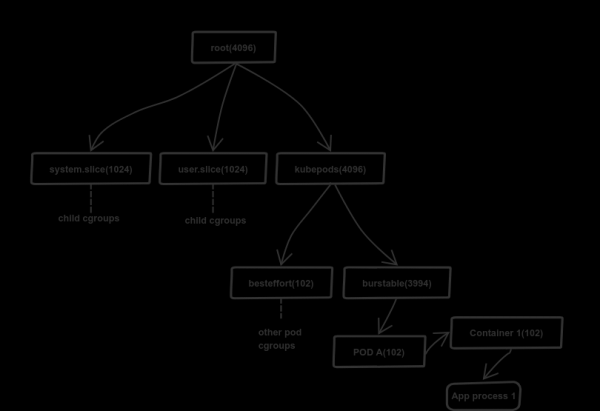
Hur CPU-begäran implementeras
För enkelhetens skull ska vi betrakta processen utifrån en maskin med 4 kärnor.
K8s använder mekanismen cgroups (kontrollgrupper) för att hantera resursfördelning (minne och CPU). För detta finns en hierarkisk modell: barn ärver limits från föräldragruppen. Detaljer om fördelningen lagras i det virtuella filsystemet (/sys/fs/cgroup). När det gäller CPU är detta /sys/fs/cgroup/cpu,cpuacct/*.
K8s använder filen cpu.share för att fördela CPU-resurser. I vårt fall får rotkontrollgruppen 4096 andelar av CPU-resurser — 100% av den tillgängliga CPU-kapaciteten (1 kärna = 1024; detta är ett fast värde). Rotgruppen fördelar resurser proportionellt beroende på andelarna av dess barn, som specificeras i cpu.share, och de i sin tur gör likadant med sina barn, och så vidare. I en typisk Kubernetes-nod har rotkontrollgruppen tre barn: system.slice, user.slice och kubepods. De två första undergrupperna används för att fördela resurser mellan kritiska systemlaster och användarprogram utanför K8s. Den sista — kubepods — skapas av Kubernetes för att fördela resurser mellan poddar.
I bilden ovan kan man se att den första och andra undergruppen fick 1024 andelar, medan undergruppen kubepod tilldelades 4096 andelar. Hur är detta möjligt: rotgruppen har ju bara tillgång till 4096 andelar, medan summan av dess barnandelar betydligt överstiger detta nummer (6144)? Anledningen är att värdet har logisk betydelse, så Linux-schemaläggaren (CFS) använder det för proportional resursfördelning av CPU. I vårt fall får de första två grupperna 680 verkliga andelar (16,6% av 4096), medan kubepod erhåller de återstående 2736 andelarna. Vid stillestånd kommer de första två grupperna inte att använda sina tilldelade resurser.
Lyckligtvis finns det en mekanism i schemaläggaren som förhindrar förlust av oanvända CPU-resurser. Den överför "idle" kapacitet till en global pool, från vilken de fördelas till grupper som behöver extra processorkraft (överföringen sker i partier för att undvika förluster vid avrundning). En liknande metod tillämpas även på alla efterkommande noder.
Denna mekanism säkerställer rättvis fördelning av processorkraft och ser till att ingen process "stjäl" resurser från andra.
CPU Limit
Trots att konfigurationerna för limit och begäran i K8s ser likadana ut, skiljer sig deras implementering avsevärt: det är den mest missledande och minst dokumenterade delen.
K8s använder för att genomföra begränsningar. Deras inställningar anges i filerna cfs_period_us och cfs_quota_us i cgroup-katalogen (där ligger också filen cpu.share).
Till skillnad från cpu.share, är kvoten baserad på tidsperioden, inte på tillgänglig processorkraft. cfs_period_us anger varaktigheten för perioden (epoken) — detta är alltid 100000 µs (100 ms). I K8s finns det möjlighet att ändra detta värde, men det är för närvarande endast tillgängligt i alpha-versionen. Schemaläggaren använder epoken för att återstarta använda kvoter. Den andra filen, cfs_quota_us, anger den tillgängliga tiden (kvoten) i varje epok. Observera att den också anges i mikrosekunder. Kvoten kan överstiga varaktigheten av epoken; med andra ord kan den vara större än 100 ms.
Låt oss titta på två scenarier på 16-kärniga maskiner (den vanligaste typen av datorer hos oss på Omio):
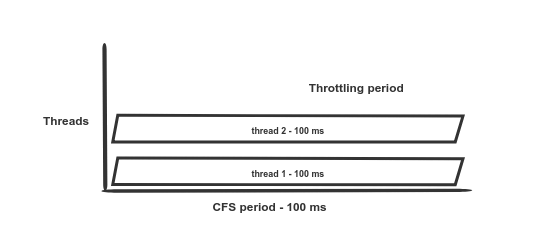
Scenario 1: 2 trådar och en gräns på 200 ms. Ingen throttling.
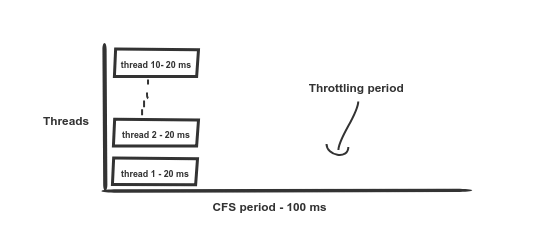
Scenario 2: 10 trådar och en gräns på 200 ms. Throttling börjar efter 20 ms, tillgången till processorkraft återupptas ytterligare efter 80 ms.
Anta att du har ställt in CPU-limit på 2 kärnor; Kubernetes översätter detta värde till 200 ms. Det betyder att containern kan använda högst 200 ms processor-tid utan throttling.
Och här börjar det intressanta. Som nämnts ovan är den tillgängliga kvoten 200 ms. Om du har tio trådar på en 12-kärnig maskin (se illustrationen för scenario 2), medan alla andra poddar är inaktiva, kommer kvoten att ta slut efter endast 20 ms (eftersom 10 * 20 ms = 200 ms), och alla trådar i denna podd kommer att "frysas" (throttle) (hastighetsbegränsning) ökar situationen som redan nämnts , som orsakar överdriven throttle och containern kan inte ens nå den existerande kvoten.
Hur mäter man throttling i poddar?
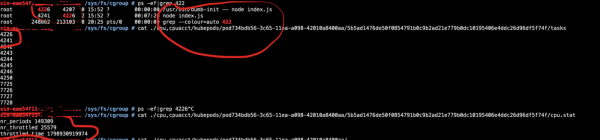
Logga bara in i podden och kör cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— det totala antalet schemaläggningsperioder; -
nr_throttled— antalet throttled-periodes inr_periods; -
throttled_time— den totala throttled-tiden i nanosekunder.
Vad händer egentligen?
Resultatet är hög throttling i alla applikationer. Ibland är det 1,5 gånger starkare än beräknat!
Detta leder till olika fel — misslyckanden i beredskapskontroller (readiness), frysta containrar, nätverksavbrott, timeouts inom tjänsteanrop. I slutändan yttrar detta sig i ökad fördröjning och fler fel.
Lösning och konsekvenser
Här är det enkelt. Vi tog bort CPU-gränserna och uppdaterade operativsystemkärnan i våra kluster till den senaste versionen där felet var fixat. Antalet fel (HTTP 5xx) i våra tjänster minskade genast avsevärt:
HTTP 5xx-fel
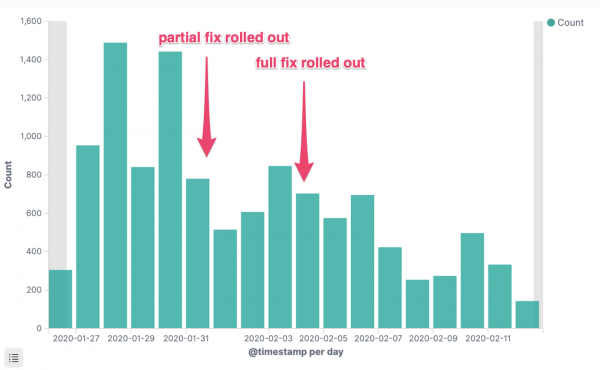
HTTP 5xx-fel från en kritiskt viktig tjänst
p95 svarstid
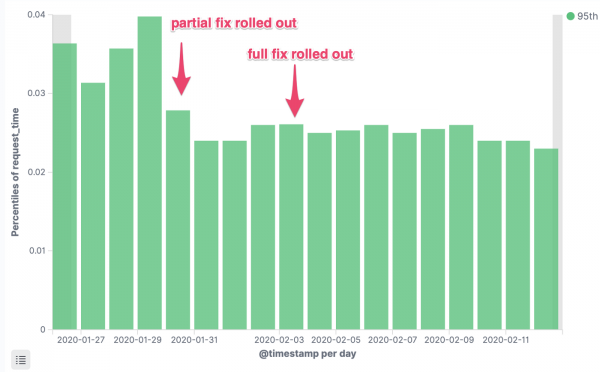
Fördröjning av förfrågningar från en kritiskt viktig tjänst, 95:e percentilen
Driftskostnader
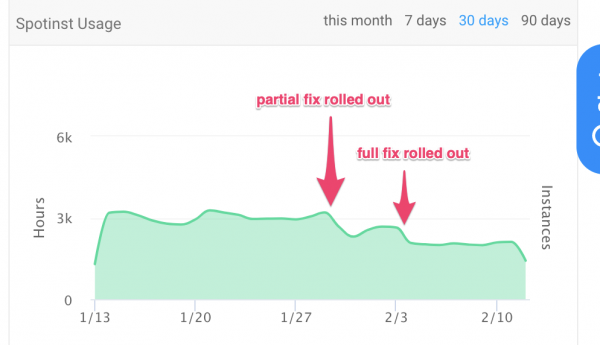
Antalet förbrukade instans-timmar
Vad är fällan?
Som nämnts i början av artikeln:
Man kan dra en parallell med en kollektivlägenhet… Kubernetes fungerar som hyresvärd. Men hur håller man hyresgästerna från konflikter sinsemellan? Vad händer om en av dem, säg, beslutar att ta över badrummet i ett halvt dygn?
Det är här fällan ligger. En oansvarig container kan ta över alla tillgängliga processorr resurser på maskinen. Om du har en bra applikationsstack (t.ex. korrekt konfigurerade JVM, Go, Node VM), då är det inga problem: man kan arbeta under sådana förhållanden under en längre tid. Men om applikationerna är dåligt optimerade eller helt ooptimerade (FROM java:latest), kan situationen gå ur kontroll. Vi på Omio har automatiserade grundläggande Dockerfiles med rimliga standardinställningar för storen av grundspråk, så vi har inte stött på sådana problem.
Vi rekommenderar att övervaka metrik (användning, mättnad och fel), API-fördröjningar och felfrekvens. Se till att resultaten motsvarar förväntningarna.
Länkar
Så här är vår historia. Följande material har kraftigt bidragit till att förstå vad som händer:
- ;
- ;
- ;
- ;
- — sök efter "cpu throttling".
Felrapporter för Kubernetes:
- ;
- ;
- .
Har du stött på liknande problem i din erfarenhet eller har du erfarenhet relaterad till throttling i containeriserade produktionsmiljöer? Dela med dig av din historia i kommentarsfältet!
P.S. från översättaren
Läs även i vår blogg:
- «»;
- «»;
- «».
Källa: habr.com
