

Det var just sådana klagomål jag hörde från våra utvecklare. Det intressanta var att det visade sig vara sant, vilket inledde en långvarig utredning. Det handlar om SQL-servrar som körs på vår VMware.
För att faktiskt få produktionsservern att vara hopplöst efter bärbara datorer är enkelt. Exekvera (inte på tempdb och inte på databasen med aktiverad Delayed Durability) koden:
set nocount on
create table _t (v varchar(100))
declare @n int=300000
while @n>0 begin
  insert into _t select 'Vilken långsam typ!'
  delete from _t
  set @n=@n-1
  end
GO
drop table _t
På min stationära dator körs den på 5 sekunder, men på produktionsservern — 28 sekunder. För SQL måste vänta på den fysiska avslutningen av skrivningen i transaktionsloggen, och här gör vi mycket korta transaktioner. För att sätta det på ett grovt sätt, vi har kört en stor kraftfull lastbil i stadstrafiken, och ser hur pizzaleveransarna på skotrar snabbt kör om den — här spelar inte genomströmning någon roll, bara latens. Ingen nätverkslagring, oavsett hur många nollor den har i priset, kan vinna på latens mot en lokal SSD.
(i kommentarerna visade det sig att jag ljög — jag hade delayed durability på båda ställena. Utan delayed durability blir det:
Desktop — 39 sekunder, 15K tr/sec, 0.065ms /io roundtrip
PROD — 360 sekunder, 1600 tr/sec, 0.6ms
Jag borde ha uppmärksammat att det var alltför snabbt)
Men i det här fallet har vi att göra med triviala nollor av zeta-funktionen av Riemann med ett trivialt exempel. I det exempel jag fick från utvecklarna fanns det något annat. Jag försäkrade mig om att de hade rätt och började rensa bort all deras specifika affärslogik. Vid ett tillfälle insåg jag att jag helt kunde kasta bort deras kod och skriva min egen — som demonstrerar samma problem — på produktion körs den 3-4 gånger långsammare:
create function dbo.isPrime (@n bigint)
returns int
as
  begin
  if @n = 1 return 0
  if @n = 2 return 1
  if @n = 3 return 1
  if @n % 2 = 0 return 0
  declare @sq int
  set @sq = sqrt(@n)+1 -- check odds up to sqrt
  declare @dv int = 1
  while @dv < @sq
    begin
	set @dv=@dv+2
	if @n % @dv = 0 return 0
	end
  return 1
  end
GO
declare @dt datetime set @dt=getdate()
select dbo.isPrime(1000000000000037)
select datediff(ms,@dt,getdate()) as ms
GO
Om allt går bra, kommer kontrollen av primtalet att ta 6-7-8 sekunder. Så var det i flera fall. servrarMen på vissa tog det 25-40 sekunder. Det intressanta var att det inte fanns servrar där körningen tog, säg, 14 sekunder — koden fungerade antingen mycket snabbt eller helt långsamt, så att säga, problemet var svart eller vitt.
Vad gjorde jag? Jag kollade VMware-metrik. Allt såg bra ut — resurserna var i överflöd, Ready time = 0, allt räckte, under testet hade både snabba och långsamma servrar CPU=100 på en vCPU. Jag tog ett test för beräkning av Pi — testet visade samma resultat på alla servrar. Det luktade mer och mer av svart magi.
När jag kom ut på DEV-farmen började jag leka med servrarna. Det visade sig att vMotion mellan värdar kan "läka" en server, men kan också tvärtom, förvandla en "snabb" server till en "långsam". Det verkar som om vissa värdar har problem... men... nej. Någon slags virtuell maskin bromsade ner på värden, låt oss säga, A men fungerade snabbt på värd B. Och en annan virtuell maskin å sin sida, fungerade snabbt på A och bromsade ner på B! På värden körde ofta både "snabba" och "långsamma" maskiner!
Från och med nu började det tydligt lukta svavel i luften. För problemet kunde inte tillskrivas någon virtuell maskin (windows patches, till exempel) — eftersom den blev "snabb" vid vMotion. Men problemet kunde inte heller tillskrivas värden — eftersom det kunde finnas både "snabba" och "långsamma" maskiner där. Det var inte heller relaterat till belastningen — jag lyckades få en "långsam" maskin på en värd där det förutom den inte fanns något annat.
I desperation startade jag Process Explorer från Sysinternals och kollade SQL-stacken. På de långsamma maskinerna såg jag genast en rad:
ntoskrnl.exe!KeSynchronizeExecution+0x5bf6
ntoskrnl.exe!KeWaitForMultipleObjects+0x109d
ntoskrnl.exe!KeWaitForMultipleObjects+0xb3f
ntoskrnl.exe!KeWaitForSingleObject+0x377
ntoskrnl.exe!KeQuerySystemTimePrecise+0x881 < — !!!
ntoskrnl.exe!ObDereferenceObjectDeferDelete+0x28a
ntoskrnl.exe!KeSynchronizeExecution+0x2de2
sqllang.dll!CDiagThreadSafe::PxlvlReplace+0x1a20
… hoppade över
sqldk.dll!SystemThread::MakeMiniSOSThread+0xa54
KERNEL32.DLL!BaseThreadInitThunk+0x14
ntdll.dll!RtlUserThreadStart+0x21
Det här var redan något. Ett program hade skrivits:
    class Program
    {
        [DllImport("kernel32.dll")]
        static extern void GetSystemTimePreciseAsFileTime(out FILE_TIME lpSystemTimeAsFileTime);

        [StructLayout(LayoutKind.Sequential)]
        struct FILE_TIME
        {
            public int ftTimeLow;
            public int ftTimeHigh;
        }

        static void Main(string[] args)
        {
            for (int i = 0; i < 16; i++)
            {
                int counter = 0;

                var stopwatch = Stopwatch.StartNew();

                while (stopwatch.ElapsedMilliseconds  0)
                {
                    Console.WriteLine("{0}", counter);
                }
            }
        }
    }
Det här programmet visade en ännu mer märkbar nedgång — på "snabba" maskiner visar den 16-18 miljoner cykler per sekund, medan på långsamma maskiner är det en och en halv miljon, eller till och med 700 tusen. Det vill säga, skillnaden är 10-20 gånger (!!!). Detta var redan en liten seger: åtminstone fanns det ingen risk att fastna mellan Microsoft och VMware-supporten så att de skyllde på varandra.
Sedan stannade framsteget — semester, viktiga saker, virushysteri och plötsligt ökad belastning. Jag nämnde ofta det magiska problemet för mina kollegor, men ibland verkade det som om de inte alltid trodde mig — det verkade för osannolikt att VMware skulle sakta ner koden med 10-20 gånger.
Jag försökte själv gräva fram vad som saktade ner. Ibland tycktes det som om jag hade hittat en lösning — att aktivera och avaktivera Hot plugs, att ändra mängden minne eller antal processorer gjorde ofta maskinen "snabb". Men inte för alltid. Men vad som visade sig vara sant är att det räcker med att gå ut och knacka på hjulet — det vill säga att ändra någon parameter för virtuell maskin
Till slut upptäckte mina amerikanska kollegor plötsligt rotorsaken.
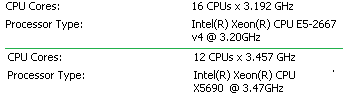
Värdarna skiljde sig i frekvens!
- Som regel är det inte farligt. Men: när du flyttar från en 'inhemsk' värd till en värd med 'annan' frekvens, måste VMware justera resultatet av GetTimePrecise.
- Som regel är det inte farligt, om det inte visar sig att det är applikationer som begär exakt tid miljontals gånger per sekund, som SQL-servern.
- Men det är inte heller farligt, eftersom SQL-servern inte gör detta hela tiden (se Slutsats)
Men det finns fall där dessa fallgropar kan göra ont. Och ja, genom att knacka på hjulet (ändra något i VM-inställningarna) fick jag VMware att 'omberäkna' konfigurationen, och den aktuella värdens frekvens blev 'inhemsk' frekvens för maskinen.
Lösning
När du inaktiverar virtualisering av TSC, återger läsning av TSC från den virtuella maskinen det fysiska maskinens TSC-värde, och skrivning till TSC från den virtuella maskinen har ingen effekt. Migrera den virtuella maskinen till en annan värd, återuppta den från knappat läge, eller återgå till en ögonblicksbild orsakar en diskontinuerlig hopp i TSC. Vissa gästoperativsystem kan misslyckas med att starta, eller visa andra tidsmätningproblem, när TSC-virtualisering är inaktiverad. Tidigare har denna funktion ibland rekommenderats för att förbättra prestandan hos applikationer som ofta läser TSC., men prestandan för den virtuella TSC har förbättrats avsevärt i nuvarande produkter. Funktionen har också rekommenderats för användning vid mätningar som kräver en precis källa till realtid i den virtuella maskinen.
För att sammanfatta, måste parametern läggas till
monitor_control.virtual_rdtsc = FALSE
Slutsats
Du har säkert undrat: varför anropas GetTimePrecise så ofta i SQL?
Jag har inte källkoden för SQL-servern, men logiken säger detta. SQL är nästan ett operativsystem med kooperativ samtidighet, där varje tråd måste ibland "ge vika". Och vart är det bäst att göra det? Där det finns ett naturligt väntande — lås eller IO. Okej, men vad händer om vi snurrar räkneslingor? Då är det uppenbara och nästan enda stället — i tolkaren (det är inte riktigt en tolk), efter att ha utfört den senaste kommandot.
Som regel används SQL-servern inte för att spika in rena beräkningar och det är inget problem. Men slingor som arbetar med alla möjliga tillfälliga tabeller (som sedan cachas) gör koden till en sekvens av mycket snabbt utförda kommandon.
Förresten, om du kapslar in funktionen i NATIVELY COMPILED, slutar den att begära tid, och dess hastighet ökar tio gånger. Men hur är det med kooperativ multitasking? Jo, för natively compiled code var det just därför SQL behövde göra PREEMPTIVE MULTITASKING.
Källa: habr.com
