

Vilka principer bygger det perfekta datalagret på?
Fokus på affärsvärde och analys utan boilerplate-kod. Hantering av DWH som en kodbas: versionering, granskning, automatiserad testning och CI. Modularitet, skalbarhet, öppen källkod och gemenskap. Användarvänlig dokumentation och visualisering av beroenden (Data Lineage).
Mer om allt detta och DBT:s roll i ekosystemet för Big Data & Analytics — välkommen under kåpan.
Hej alla
Artemiy Kozyr här. Jag har arbetat med datalager i över 5 år, jobbat med byggen av ETL/ELT, samt dataanalys och visualisering. Jag är för närvarande verksam på , undervisar på OTUS i kursen , och idag vill jag dela med mig av en artikel som jag skrev inför starten av ett nytt urval för kursen.
Kort översikt
DBT-ramverket handlar om bokstaven T i akronymen ELT (Extract — Transform — Load).
Med framväxten av kraftfulla och skalbara analytiska databaser som BigQuery, Redshift, Snowflake, har det förlorat sin mening att utföra transformationer utanför datalagret.
DBT laddar inte ner data från källor, men ger enorma möjligheter att arbeta med de data som redan laddats in i lagret (i Internal eller External Storage).
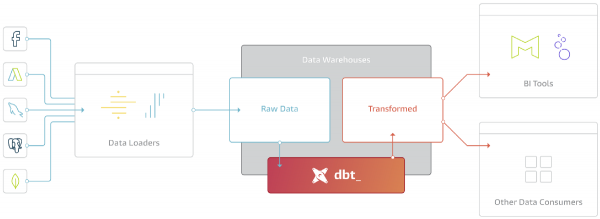
DBT:s huvudsakliga syfte är att ta koden, kompilera den till SQL och köra kommandona i rätt ordning i lagret.
Strukturen för DBT-projektet
Projektet består av två typer av kataloger och filer:
- Modell (.sql) — en transformationsenhet uttryckt som en SELECT-fråga
- Konfigurationsfil (.yml) — parametrar, inställningar, tester, dokumentation
På grundläggande nivå byggs arbetet upp på följande sätt:
- Användaren förbereder kodmodeller i valfri bekväm IDE
- Modellerna startas med hjälp av CLI, DBT kompilerar kodmodellerna till SQL
- Den kompilera SQL-koden körs i lagret i angiven sekvens (graf)
Så här kan en start se ut från CLI:
Allt är SELECT
Det här är en killer-funktion i Data Build Tool-ramverket. Med andra ord, DBT abstraherar all kod relaterad till materialisering av dina frågor i lagret (varianter av kommandona CREATE, INSERT, UPDATE, DELETE ALTER, GRANT, …).
Varje modell innebär att skriva en SELECT-fråga som definierar det resulterande datasaet.
Samtidigt kan logiken för transformationerna vara flervånings och konsolidera data från flera andra modeller. Ett exempel på en modell som bygger en beställningsvisning (f_orders):
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Vad intressant kan vi se här?
För det första: CTE:er (Common Table Expressions) används - för att organisera och förstå koden, som innehåller många transformationer och affärslogik
För det andra: Modellkoden är en blandning av SQL och (mallspråk).
I exemplet används en slinga for för att beräkna summan för varje betalningsmetod som anges i uttrycket set. Dessutom används funktionen ref — en möjlighet att referera inom koden till andra modeller:
- Vid kompilering ref kommer det att omvandlas till en riktad pekare mot tabellen eller vyerna i lagret
- ref möjliggör att bygga en graf av beroenden för modeller
Det är just som ger DBT nästan obegränsade möjligheter. De mest använda av dem är:
- If / else-satser - grenkoder
- For-loopar - loopar
- Variabler - variabler
- Makro - skapa makron
Materialisering: Table, View, Incremental
Materialiseringsstrategi - en metod där den resulterande datamängden från modellen kommer att sparas i lagret.
Ett grundläggande sätt att se på detta är:
- Table - en fysisk tabell i lagret
- View - en vy, en virtuell tabell i lagret
Det finns också mer komplexa materialiseringsstrategier:
- Incremental - inkrementell inläsning (av stora faktatabeller); nya rader läggs till, ändrade uppdateras, borttagna tas bort
- Ephemeral - modellen materialiseras inte direkt, men deltar som CTE i andra modeller
- Andra strategier som du kan lägga till själv
Utöver materialiseringsstrategier öppnas möjligheter för optimering för specifika lagringssystem, till exempel:
- Snowflake: Transient tables, Merge behavior, Table clustering, Copying grants, Secure views
- Redshift: Distkey, Sortkey (interleaved, compound), Late Binding Views
- BigQuery: Table partitioning & clustering, Merge behavior, KMS Encryption, Labels & Tags
- Spark: Filformat (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, incremental_strategy
För närvarande stöds följande lagringslösningar:
- Postgres
- Redshift
- BigQuery
- Snowflake
- Presto (delvis)
- Spark (delvis)
- Microsoft SQL Server (community-adapter)
Låt oss förbättra vår modell:
- Gör dess innehåll inkrementellt (Incremental)
- Lägg till segmenterings- och sorteringsnycklar för Redshift
-- Modellkonfiguration:
-- Inkrementellt innehåll, unik nyckel för uppdatering av poster (unique_key)
-- Segmenteringsnyckel (dist), sorteringsnyckel (sort)
{{
  config(
           materialized='incremental',
           unique_key='order_id',
           dist="customer_id",
           sort="order_date"
       )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Denna filter kommer att tillämpas endast för inkrementell körning
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Modellernas beroendegraf
Det kallas även beroendeträd. Det är också en DAG (Directed Acyclic Graph — Riktad Acyklisk Graf).
DBT bygger grafen baserat på konfigurationen av alla projektmodeller, mer specifikt referenserna ref() inom modellerna till andra modeller. Att ha en graf möjliggör följande:
- Körning av modeller i korrekt sekvens
- Parallellisering av skapande av datalager
- Körning av en godtycklig undergraf
Ett exempel på grafvisualisering:
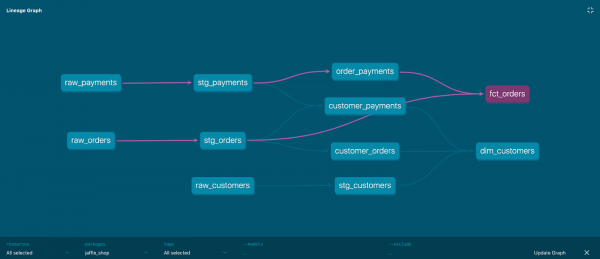
Varje nod i grafen är en modell, kanterna i grafen bestäms av uttrycket ref.
Datakvalitet och Dokumentation
Förutom att skapa själva modellerna, låter DBT oss testa en rad antaganden (assertions) om den resulterande datamängden, såsom:
- Not Null
- Unique
- Referensintegritet — referensintegritet (till exempel, customer_id i tabellen orders motsvarar id i tabellen customers)
- Överensstämmelse med en lista över tillåtna värden
Det går att lägga till egna tester (custom data tests), som exempelvis % avvikelse i intäkterna med siffror från igår, förra veckan, eller förra månaden. Varje antagande, formulerat som en SQL-fråga, kan bli ett test.
På så sätt kan oönskade avvikelser och fel i data spåras i datalager.
När det gäller dokumentation tillhandahåller DBT mekanismer för att lägga till, versionera och distribuera metadata och kommentarer på modellnivå och till och med på attributnivå.
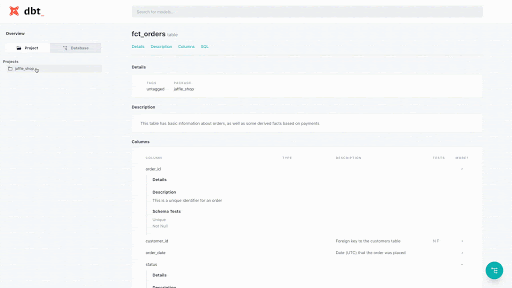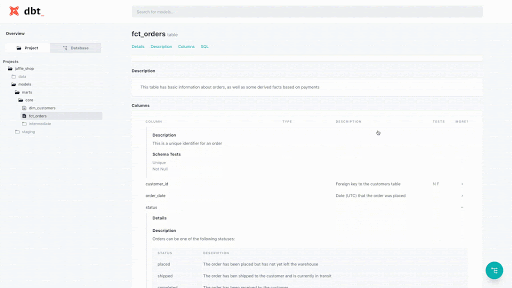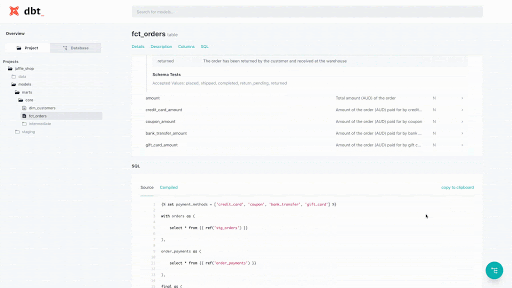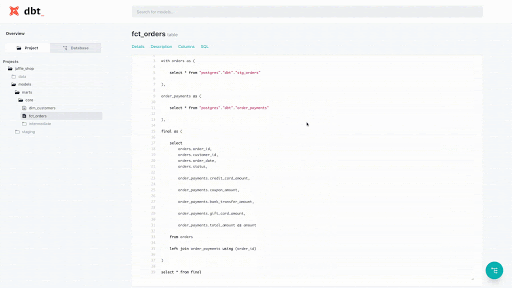
Så här ser det ut att lägga till tester och dokumentation på konfigurationsfilnivå:
 - name: fct_orders
   description: Denna tabell har grundläggande information om beställningar, samt några härledda fakta baserade på betalningar
   columns:
     - name: order_id
       tests:
         - unique # kontroll av unika värden
         - not_null # kontroll av null
       description: Detta är en unik identifierare för en beställning
     - name: customer_id
       description: Utlandsskydd till tabellen för kunder
       tests:
         - not_null
         - relationships: # kontroll av referentiell integritet
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: Datum (UTC) då beställningen gjordes
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # kontroll av giltiga värden
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
Så här ser denna dokumentation ut när den redan är på den genererade webbplatsen:
Makron och Moduler
Syftet med DBT är inte så mycket att vara en uppsättning SQL-skript, utan att ge användarna kraftfulla och rika verktyg för att bygga sina egna transformationer och distribuera dessa moduler.
Makron är en uppsättning konstruktioner och uttryck som kan anropas som funktioner inom modeller. Makron gör det möjligt att återanvända SQL mellan modeller och projekt i enlighet med ingenjörsprincipen DRY (Don’t Repeat Yourself).
Exempel på makro:
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike  '%osx%' then 'osx'
 when {{ column_name }} ilike  '%android%' then 'android'
 when {{ column_name }} ilike  '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
Och dess användning:
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- anrop av makro
from my_table
DBT levereras med en paketchef (packages) som låter användare publicera och återanvända individuella moduler och makron.
Det betyder möjlighet att ladda ner och använda sådana bibliotek som:
- : arbete med Datum/Tid, Surrogatnycklar, Schema-tester, Pivot/Unpivot och annat
- Färdiga mallar för datalager som och
- Bibliotek för specifika datalager, till exempel
- — Modul för loggning av DBT:s aktivitet
Den fullständiga listan över paket kan ses på .
Ännu fler möjligheter
Här beskriver jag några andra intressanta funktioner och implementeringar som jag och teamet använder för att bygga ett datalager i .
Delning av körmiljöer DEV — TEST — PROD
Även inom en och samma DWH-kluster (inom olika scheman). Till exempel med hjälp av följande uttryck:
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Denna kod säger bokstavligen: för miljöerna dev, test, ci ta endast med data från de senaste 3 dagarna och inte mer. Det vill säga att körningar i dessa miljöer kommer att gå mycket snabbare och kräva färre resurser. När den körs i miljön prod kommer filtervillkoret att ignoreras.
Materialisering med alternativ kolumnkodning
Redshift är en kolumnorienterad DBMS som möjliggör att ange komprimeringsalgoritmer för varje enskild kolumn. Valet av optimala algoritmer kan minska den upptagna lagringen med 20–50%.
Makro kommer att köra kommandot ANALYZE COMPRESSION, skapa en ny tabell med rekommenderade kolumnkodningsalgoritmer, angivna segmenteringsnycklar (dist_key) och sorteringsnycklar (sort_key), överföra data till den, och om nödvändigt ta bort den gamla kopian.
Makrosignatur:
{{ compress_table(schema, table,
                 drop_backup=False,
                 comprows=none|Integer,
                 sort_style=none|compound|interleaved,
                 sort_keys=none|List,
                 dist_style=none|all|even,
                 dist_key=none|String) }}
Loggning av modellkörningar
För varje körning av en modell kan man anhänga hooks (hooks) som utförs innan starten eller omedelbart efter avslutningen av modells skapande:
   pre-hook: "{{ logging.log_model_start_event() }}"
   post-hook: "{{ logging.log_model_end_event() }}"
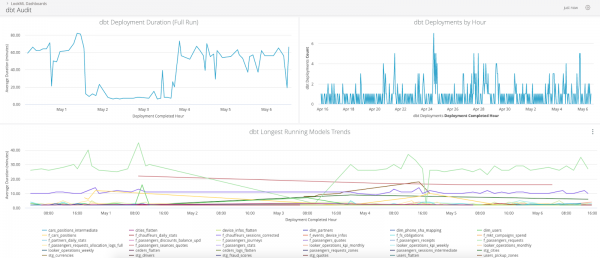
Loggningsmodulen gör det möjligt att registrera all nödvändig metadata i en separat tabell, som senare kan användas för att utföra revision och analys av problemområden (bottlenecks).
Så här ser instrumentpanelen ut på loggningsdata i Looker:
Automatisering av underhåll av datalagret
Om du använder några funktionalitetsförlängningar i det använda datalagret, såsom UDF (User Defined Functions), är versionshantering av dessa funktioner, hantering av åtkomster, och automatiserad utrullning av nya versioner mycket bekvämt att genomföra i DBT.
Vi använder UDF i Python för att beräkna hash-värden, domäner av e-postadresser, och avkoda bitmasker (bitmask).
Exempel på ett makro som skapar UDF i vilken körningsmiljö som helst (dev, test, prod):
{% macro create_udf() -%}

 {% set sql %}
 CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
 RETURNS varchar
 LANGUAGE plpythonu
 STABLE
 AS $$
 import hashlib
 return hashlib.sha256(mes).hexdigest()
 $$
 ;
 {% endset %}

 {% set table = run_query(sql) %}

{%- endmacro %}
På Wheely använder vi Amazon Redshift, som är baserat på PostgreSQL. För Redshift är det viktigt att regelbundet samla in statistik om tabeller och frigöra diskutrymme — kommandona ANALYZE och VACUUM, respektive.
För detta körs kommandona från makrot redshift_maintenance varje natt:
{% macro redshift_maintenance() %}

 {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

 {% for row in vacuumable_tables %}
 {% set message_prefix=loop.index ~ " of " ~ loop.length %}

 {%- set relation_to_vacuum = adapter.get_relation(
 database=row['table_database'],
 schema=row['table_schema'],
 identifier=row['table_name']
 ) -%}
 {% do run_query("commit") %}

 {% if relation_to_vacuum %}
 {% set start=modules.datetime.datetime.now() %}
 {{ dbt_utils.log_info(message_prefix ~ " Vacuuming " ~ relation_to_vacuum) }}
 {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
 {{ dbt_utils.log_info(message_prefix ~ " Analyzing " ~ relation_to_vacuum) }}
 {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
 {% set end=modules.datetime.datetime.now() %}
 {% set total_seconds = (end - start).total_seconds() | round(2)  %}
 {{ dbt_utils.log_info(message_prefix ~ " Finished " ~ relation_to_vacuum ~ " in " ~ total_seconds ~ "s") }}
 {% else %}
 {{ dbt_utils.log_info(message_prefix ~ ' Skipping relation "' ~ row.values() | join ('"."') ~ '" as it does not exist') }}
 {% endif %}

 {% endfor %}

{% endmacro %}
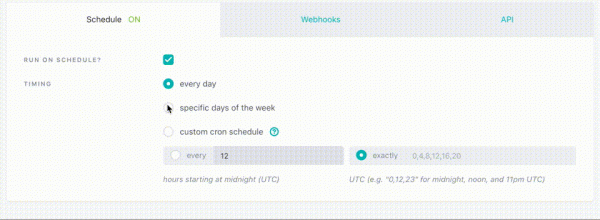
DBT Cloud
Det finns möjlighet att använda DBT som en tjänst (Managed Service). I paketet ingår:
- Web IDE för utveckling av projekt och modeller
- Konfiguration av jobb och schemaläggning
- Enkel och smidig åtkomst till loggar
- Webbplats med dokumentationen för ditt projekt
- Anslutning av CI (Continuous Integration)
Slutsats
Att förbereda och använda DWH blir lika trevligt och givande som att dricka smoothies. DBT består av Jinja, användardefinierade tillägg (moduler), en kompilator, en motor (executor) och en paketförvaltare. Genom att sammanföra dessa element får du en komplett arbetsmiljö för ditt datalager. Det finns knappast idag ett bättre sätt att hantera transformationer inom DWH.
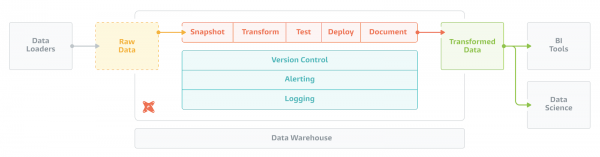
De övertygelser som DBT-utvecklarna följde formuleras så här:
- Kod, inte GUI, är den bästa abstraktionen för att uttrycka komplex analytisk logik.
- Arbete med data bör anpassa de bästa metoderna inom programvaruutveckling (Software Engineering).
- Den viktigaste infrastrukturen för databehandling bör kontrolleras av användarsamhället som programvara med öppen källkod.
- Inte bara analytiska verktyg, utan även kod kommer alltmer att bli en del av Open Source-gemenskapen.
Dessa grundläggande övertygelser har skapat en produkt som idag används av mer än 850 företag, och de utgör grunden för många intressanta utvidgningar som kommer att skapas i framtiden.
För de som är intresserade finns det en videoinspelning av en öppen lektion som jag höll för några månader sedan som en del av en öppen lektion på OTUS — .
Förutom DBT och datalagerdäck, håller jag och mina kollegor föreläsningar om en rad andra aktuella och moderna ämnen inom Data Engineer-kursen på OTUS:
- Arkitekturella koncept för Big Data-applikationer.
- Praktik med Spark och Spark Streaming.
- Att lära sig sätt och verktyg för att ladda datakällor.
- Bygga analytiska visningar i DWH.
- NoSQL-koncept: HBase, Cassandra, ElasticSearch.
- Principer för organisering av övervakning och orkestrering.
- Slutprojekt: sammanfoga alla färdigheter med mentorsupport.
Länkar:
- — Officiell dokumentation.
- — Översikt av en av författarna till DBT.
- — YouTube, inspelning av öppen lektion OTUS.
- — Nästa öppna lektion den 15 maj 2020.
- — OTUS.
- — En blick mot framtiden för databehandling och analys.
- — Utvecklingen av analys och påverkan av Open Source.
- — Principer för att bygga CI med DBT.
- — Praktik, steg-för-steg-instruktioner för självständigt arbete.
- — Github, kod för utbildningsprojekt
Källa: habr.com
