

Yrkena Data Scientist och Data Engineer blandas ofta ihop. Varje företag har sin egen specifika databehandlingspraxis, olika mål för analysen och olika uppfattningar om vem som ansvarar för vilken del av arbetet, och därför ställer varje företag sina egna krav.
Vi undersöker skillnaderna mellan dessa specialister, vilka affärsproblem de löser, vilka färdigheter de har och hur mycket de tjänar. Eftersom materialet blev stort, har vi delat upp det i två publikationer.
I den första artikeln berättar Elena Gerasimova, avdelningschef för "" vid Netology, om skillnaderna mellan Data Scientist och Data Engineer samt vilka verktyg de arbetar med.
Hur rollerna för ingenjörer och vetenskapsmän skiljer sig åt
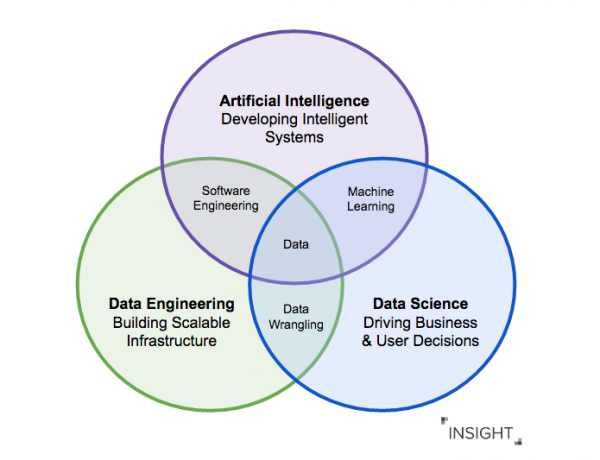
Dataingenjören är en specialist som, å ena sidan, utvecklar, testar och underhåller infrastrukturen för databehandling: databaser, datalagringar och system för massbearbetning. Å andra sidan är det den som rengör och "stylar" data för användning av analytiker och data scientists, vilket innebär att skapa databehandlingspipelines.
Data Scientist skapar och tränar prediktiva (och andra) modeller med hjälp av maskininlärningsalgoritmer och neurala nätverk, vilket hjälper företag att hitta dolda mönster, förutsäga händelseutveckling och optimera viktiga affärsprocesser.
Den största skillnaden mellan Data Scientist och Data Engineer ligger i att de vanligtvis har olika mål. Båda arbetar för att säkerställa att data är tillgängliga och av hög kvalitet. Men Data Scientist söker svar på sina frågor och tester hypoteser i datorsystemets ekosystem (till exempel på en Hadoop-plattform), medan Data Engineer skapar pipeline för att underhålla maskininlärningsalgoritmen skriven av data scientist i ett Spark-kluster inom samma ekosystem.
Dataingenjören tillför värde till verksamheten genom att arbeta i team. Hans uppgift är att fungera som en viktig länk mellan olika deltagare: från utvecklare till affärsanvändare av rapportering, och öka produktiviteten hos analytiker – från marknads- och produktanalytiker till BI.
Data Scientist å sin sida deltar aktivt i företagets strategi och utvinning av insikter, beslutsfattande, införande av automatiseringsalgoritmer, modellering och värdeskapande från data.
Arbete med data följer principen GIGO (garbage in — garbage out): om analytiker och data scientists hanterar oinformerade och potentiellt felaktiga data, kommer resultaten, även med de mest sofistikerade analysalgoritmerna, att vara felaktiga.
Data engineers löser detta problem genom att bygga processlinjer för bearbetning, rengöring och transformation av data, vilket gör att data scientists kan arbeta med kvalitetssäkrade data.
På marknaden finns det många verktyg för datahantering som täcker varje steg: från datauppkomsten till presentation på instrumentpanelen för styrelsen. Det är viktigt att beslutet om deras användning fattas av ingenjören — inte för att det är trendigt, utan för att det verkligen hjälper andra deltagare i processen.
Villkorligt: om företaget behöver integrera BI och ETL — dataladdning och uppdatering av rapporter, här är en typisk legacy-struktur som Data Engineer kommer att behöva hantera (det är bra om det också finns en arkitekt i teamet).
Ansvarsområden för Data Engineer
- Utveckling, byggande och underhåll av infrastrukturen för datahantering.
- Felhantering och skapande av pålitliga databearbetningsströmmar.
- Omvandling av ostrukturerade data från olika dynamiska källor till en form som är användbar för analytiker.
- Ge rekommendationer för att förbättra konsekvens och kvalitet på data.
- Säkerställande och stöd för den dataarkitektur som används av data scientists och analytiker.
- Bearbetning och lagring av data på ett konsekvent och effektivt sätt i ett distribuerat kluster med dussintals eller hundratals servrar.
- Utvärdering av tekniska kompromisser i verktyg för att skapa enkla men pålitliga arkitekturer som kan stå emot störningar.
- Övervakning och stöd för datastreamar och relaterade system (inställning av övervakning och larm).
Det finns en annan specialisering inom Data Engineer-banvagnen — ML engineer. Kort sagt, dessa ingenjörer specialiserar sig på att ta modeller för maskininlärning från utvecklingsstadiet till praktisk användning. Ofta är modellen som kommer från data scientist en del av en studie och kanske inte fungerar i praktiken.
Ansvarsområden för Data Scientist
- Utdragning av funktioner från data för tillämpning av maskininlärningsalgoritmer.
- Användning av olika verktyg för maskininlärning för att förutsäga och klassificera mönster i data.
- Ökning av prestanda och noggrannhet hos algoritmer för maskininlärning genom finjustering och optimering av algoritmer.
- Formulering av "starka" hypoteser i enlighet med företagets strategi som måste testas.
Både Data Engineer och Data Scientist förenas av ett påtagligt bidrag till utvecklingen av en datakultur, genom vilken företaget kan få extra intäkter eller minska kostnader.
Vilka språk och verktyg arbetar ingenjörer och dataforskare med?
Idag har förväntningar på databehandlingsspecialister förändrats. Tidigare samlade ingenjörer stora SQL-frågor, skrev MapReduce manuellt och bearbetade data med hjälp av verktyg som Informatica ETL, Pentaho ETL, Talend.
År 2020 är det nödvändigt för specialister att behärska Python och moderna verktyg för beräkningar (t.ex. Airflow), samt förstå principerna för arbete med molnplattformar (använda dem för att spara på "hårdvara", samtidigt som säkerhetsprinciper bevaras).
SAP, Oracle, MySQL, Redis — det är traditionella verktyg för dataingenjörer i stora företag. De är bra, men kostnaden för licenser är så hög att det bara är meningsfullt att lära sig arbeta med dem i industriella projekt. Det finns dock ett gratis alternativ i form av Postgres — det är gratis och passar inte bara för utbildning.
Historiskt sett är det ofta efterfrågat att kunna Java och Scala, även om dessa språk, i takt med teknikens och metodernas utveckling, hamnar i bakgrunden.
Trots detta är hardcore BigData: Hadoop, Spark och resten av djurparken inte längre ett krav för dataingenjörer, utan en sorts verktyg för att lösa uppgifter som inte kan hanteras med traditionell ETL.
Trenden är tjänster för att använda verktyg utan att behöva veta språket de är skrivna i (t.ex. Hadoop utan kunskap om Java), samt tillhandahållande av färdiga tjänster för bearbetning av strömmande data (igenkänning av röst eller bilder på video).
Industriella lösningar från SAS och SPSS är populära, samtidigt som Tableau, Rapidminer, Stata och Julia också används av dataforskare för lokala uppgifter.
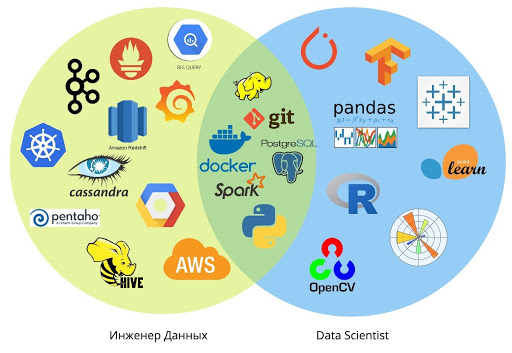
Möjligheten att själva bygga pipeline började för analytiker och data scientists för bara ett par år sedan: till exempel kan man nu, med hjälp av relativt enkla skript, styra data till lagring baserad på PostgreSQL.
Vanligtvis ligger användningen av pipelines och integrerade datakonstruktioner under dataingenjörernas ansvar. Men idag är trenden för T-formade specialister starkare än någonsin — med breda kompetenser inom angränsande områden, eftersom verktygen ständigt förenklas.
Varför Data Engineer och Data Scientist ska arbeta tillsammans
Genom att arbeta nära ingenjörerna kan Data Scientists fokusera på den forskningsbaserade delen, och skapa färdiga algoritmer för maskininlärning.
Ingenjörerna kan istället fokusera på skalbarhet, återanvändning av data och säkerställa att in- och utdata-pipelines för varje projekt överensstämmer med den globala arkitekturen.
Detta ansvarsfördelning säkerställer att det finns en överensstämmelse i åtgärderna mellan grupper av specialister som arbetar med olika maskininlärningsprojekt.
Samarbete hjälper till att effektivt skapa nya produkter. Hastighet och kvalitet uppnås tack vare balansen mellan att skapa en tjänst för alla (global lagring eller integration av dashboards) och att genomföra varje specifik behov eller projekt (nischad pipeline, koppla externa källor).
Tätt samarbete med data scientists och analytiker hjälper ingenjörerna att utveckla analytiska och forskningsfärdigheter för att skriva mer högkvalitativ kod. Utbytet av kunskap mellan användare av lagringssystem och dataläger förbättras, vilket gör projekten mer flexibla och säkerställer mer hållbara långsiktiga resultat.
I företag som har som mål att utveckla en datainriktad arbetskultur och bygga affärsprocesser baserade på data kompletterar Data Scientists och Data Engineers varandra och skapar ett heltäckande system för dataanalys.
I nästa artikel kommer vi att berätta vilken utbildning som behövs för Data Engineers och Data Scientists, vilka färdigheter de behöver utveckla och hur marknaden ser ut.
Från redaktionen på Netology
Om du funderar på en karriär som Data Engineer eller Data Scientist, inbjuder vi dig att utforska utbildningsprogrammen i våra kurser:
- Yrket “».
- Yrket “».
Källa: habr.com
