

Hej, Habr! Vi på Dodo Pizza Engineering älskar verkligen data (vem gör inte det nuförtiden?). Här kommer en historia om hur man samlar in all data i Dodo Pizza-världen och ger varje anställd på företaget enkel tillgång till den massiva datamängden. Uppdraget med stjärna: att bevara teamet Data Engineerings nerver.
Som riktiga Pljushkin samlar vi all möjlig information om driften av våra pizzerior:
- vi minns alla användares beställningar;
- vi vet hur lång tid det tog att göra den allra första pizzan i Syktyvkar;
- vi ser hur länge en pizza kyls ner på värmehyllan i Voronezh just nu;
- vi lagrar data om avskrivning av produkter;
- och mycket, mycket mer.
Flera team ansvarar för datan på Dodo Pizza just nu, ett av dem är teamet Data Engineering. Just nu står vi (det vill säga vi) inför uppgiften: att ge varje anställd i företaget enkel tillgång till denna massiva datamängd.
När vi började tänka på hur vi skulle göra detta och började diskutera uppgiften, hittade vi en mycket intressant metod för datastyrning – (i länken hittar du en fantastisk och omfattande artikel). Deras idéer passade mycket väl in i vår syn på hur vi vill bygga vårt system. Här i artikeln kommer vår nytänkning av metoden och hur vi ser dess implementering i Dodo Pizza Engineering.
Vad menar vi med "data"
Först och främst låt oss definiera vad vi menar med data på Dodo Pizza Engineering:
- Händelser som skickas av tjänster (vi har en gemensam buss byggd med RabbitMQ);
- Poster i databasen (för oss är det MySQL och CosmosDB);
- Clickstream från mobilapplikationen och webbplatsen.
För att Dodo Pizza ska kunna använda denna data och lita på den är det viktigt att följande villkor uppfylls:
- De måste vara hela. Vi måste vara säkra på att vi inte ändrar datan under dess bearbetning, lagring och visning. Om verksamheten inte kan lita på vår data, kommer den inte att vara till någon nytta.
- De måste ha tidsstämplar och får inte skrivas över. Det betyder att vi alltid vill ha möjlighet att gå tillbaka och se datan från den tidpunkten. Till exempel, att få veta hur många pizzor som såldes den 8 juli 2018.
- De måste vara pålitliga. Under data collection and storage, we must not only maintain integrity but also reliability. We cannot afford to lose data, time slices, because with them we lose the trust of our clients (both external and internal).
- They must have a stable scheme – we write queries for this data. We would really prefer that with changes to the application code, during refactoring, they do not change so much that our queries cease to work. Those who write queries will never know that you made a refactor until everything breaks down completely. We wouldn’t want to find out about this from clients.
Considering all these requirements, we concluded that data in Dodo is a product. Just like the public API of the service. Accordingly, the same team that owns the service should own the data. Additionally, changes to the data schema must always be backward-compatible.
The traditional approach is Data Lake.
To address the challenges of reliable storage and processing of big data, there is a traditional approach adopted by many companies that deal with such a pool of information – Data Lake. Within this approach, data engineers collect information from all system components and store it in one large repository (this could be, for instance, Hadoop, Azure Kusto, Apache Cassandra, or even a MySQL replica if the data fits in it).
Then these very engineers write queries against such a repository. The implementation of this approach at Dodo Pizza Engineering implies that the Data Engineering team will own the data schema in the analytical repository.
In this scenario, the team becomes very sad kittens, and here's why:
- They must keep track of changes in ALL services within the company. And there are many of them, and changes occur quite frequently (on average, we merge ~100 pull requests per week, and many services do not make pull requests at all).
- When the data schema changes, the product owner and the team changing the data schema must wait for the Data Engineering to write the necessary code to support the changes. At the same time, it's been quite a while since we have been implementing features, and the situation where one team waits for another is quite rare. We do not want this to become a 'normal' part of the development process.
- They must be immersed in EVERY Företagets affär. En pizzakedja kan verka som en enkel verksamhet, men så är det bara till synes. Det är mycket svårt att samla tillräckliga kompetenser i ett och samma team för att bygga en adekvat datamodell för hela företaget.
- Den utgör en enskild felpunkt. Varje gång det behövs ändra de data som tjänsten returnerar eller skriva en förfrågan, hamnar dessa uppgifter på Data Engineering-teamet. Resultatet blir att teamet har en överbelastad backlogg.
Det visar sig att teamet befinner sig i skärningspunkten av ett stort antal behov och knappast kan tillfredsställa dem. Samtidigt kommer de att vara i ständig tidsnöd och stress. Det vill vi verkligen undvika. Därför måste vi tänka på hur vi kan lösa dessa problem och samtidigt få möjlighet att analysera data.
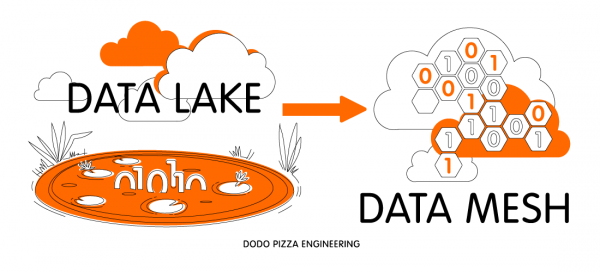
Från Data Lake till Data Mesh
Som tur är har inte bara vi ställt denna fråga. Faktum är att denna typ av problem redan har lösts inom industrin (halleluja!). Men inom ett annat område: distribution av applikationer. Ja, jag pratar om DevOps-ansatsen, där teamet bestämmer hur produkten som de skapar ska distribueras.
En liknande ansats för att lösa Data Lake-problem föreslogs av Zhamak Dehghani, konsult på ThoughtWorks. Genom att observera hur liknande problem hanteras av Netflix och Spotify skrev hon en fantastisk artikel (länken till den var i början av artikeln). Huvudidéerna som vi tog med oss från den är:
- Dela upp den stora Data Lake i datadomäner, vilka liknar domäner inom domain-driven design. Varje domän är en liten bounded context.
- Feature Team som ansvarar för DDD-domäner ansvarar också för motsvarande datadomäner. De lagrar strukturen, gör ändringar i den, laddar upp data i den. De vet också hur man ändrar datainläsningen utan att något går sönder när applikationen ändras. Kunskapen försvinner inte. För att öppna data behöver de inte gå någonstans. Teamet har hela utvecklingscykeln, från att ändra operationella data till att tillhandahålla analytiska data till tredje part. Ett team har fullt ansvar för allt som rör domänen (både affärsdomänen och datadomänerna).
- Data Engineer – en roll inom Feature Team. Det behöver inte vara en separat person, men det är absolut nödvändigt att teamet har denna kompetens.
Under tiden arbetar Data Engineering-teamet ...
Om vi tänker oss att allt detta kan genomföras med ett fingerknäpp, kvarstår det att besvara två frågor:
Vad kommer Data Engineering-teamet att syssla med nu? Inom Dodo Pizza Engineering finns det redan ett plattforms-/SRE-team. Deras uppgift är att ge utvecklarna verktyg för enkel distribution av tjänster. Data Engineering-teamet kommer att ha en liknande roll, men för data.
Att omvandla operativa data till analytiska är en komplex process. Att göra de analytiska data tillgängliga för hela företaget är ännu svårare. Det är dessa problem som Data Engineering-teamet kommer att fokusera på.
Vi planerar att ge Feature Team ett bekvämt verktygspaket och metoder, så att de kan publicera data från sina tjänster till resten av företaget. Vi kommer också att vara ansvariga för de gemensamma infrastrukturella delarna av data-pipeline (köer, pålitlig lagring, kluster för datatransformationer).
Hur kommer Data Engineer-kunskaper att uppstå inom Feature Team? Det är mer komplicerat med Feature Team. Självklart skulle vi kunna försöka anställa en Data Engineer i varje team. Men det är väldigt svårt. Att hitta någon med en bra bakgrund inom databehandling och övertyga dem att arbeta i produktteam är en utmaning.
En stor fördel med Dodo är att vi älskar intern utbildning. Så nu är vår plan denna: Data Engineering-teamet börjar publicera data från vissa tjänster, de gråter, sticks, men fortsätter att äta kaktusen. Så snart vi förstår att vi har en färdig process för publicering kommer vi att börja berätta om den för Feature Team.
Vi har flera sätt att göra detta:
- , där vi kommer att berätta hur den process vi har skapat ser ut, vilka verktyg som finns och hur de kan användas mest effektivt.
- Att tala på DevForum kommer att hjälpa oss att samla in feedback från produktutvecklare. Efter detta kan vi gå med i produktteam och hjälpa dem att lösa problem med datpublicering, organisera träning för team.
Konsumtion av data
Just nu har jag pratat mycket om publicering av data. Men det finns också konsumtion. Vad har vi för information om det?
Vi har ett fantastiskt BI-team som skriver mycket komplexa rapporter för förvaltningsbolaget. Inom Dodo IS finns det många rapporter för våra partner som hjälper dem att styra pizzerior. I vår nya modell ser vi dem som datakonsumenter, som har sina egna datadomäner. Det är faktiskt konsumenterna som kommer att ansvara för sina egna domäner. Ibland kan konsumentens domän beskrivas med en enda fråga i analyslagret – och det är bra. Men vi förstår att detta inte alltid kommer att fungera. Därför vill vi att den plattform vi skapar för produktteam också ska kunna användas av datakonsumenter (eftersom det i fallet med rapporterna inom Dodo IS – kommer att vara samma team).
Så här ser vi på arbete med data inom Dodo Pizza Engineering. Vi ser fram emot att läsa era tankar om detta i kommentarerna.
Källa: habr.com
