

DataHub med öppen källkod: en plattform för sökning och upptäckte av metadata från LinkedIn
Snabb sökning av viktiga data är avgörande för företag som förlitar sig på stora mängder data för att fatta datadrivna beslut. Detta påverkar inte bara produktiviteten hos dataanvändare (inklusive analytiker, maskininlärningsutvecklare, dataförädlare och dataingenjörer), utan har också en direkt inverkan på de slutprodukter som är beroende av en kvalitativ maskininlärnings pipeline. Dessutom väcker trenden att införa eller bygga maskininlärningsplattformar naturligt frågan: vad är er metod för intern upptäckte av funktioner, modeller, statistik, datamängder osv.
I den här artikeln kommer vi att berätta om hur vi publicerade datakällan under en öppen licens på vår plattform för sökning och upptäckte av metadata, som började från projektets tidiga dagar . LinkedIn underhåller en egen version av DataHub separat från den öppna källkodsversionen. Vi börjar med att förklara varför vi behöver två separata utvecklingsmiljöer, följt av en diskussion om de första tillvägagångssätten för att använda WhereHows med öppen källkod och en jämförelse av vår interna (produktions)version av DataHub med versionen på . Vi kommer också att dela detaljer om vår nya automatiserade lösning för att skicka och ta emot uppdateringar med öppen källkod för att synkronisera båda lagren. Slutligen kommer vi att ge instruktioner om hur man börjar använda DataHub med öppen källkod, och kort diskutera dess arkitektur.
WhereHows är nu DataHub!
LinkedIns metadata team presenterade tidigare (efterträdare till WhereHows), LinkedIns plattform för sökning och upptäckte av metadata, och delade sina planer för att öppna den. Kort efter detta meddelande släppte vi en alfa-version av DataHub och delade den med samhället. Sedan dess har vi ständigt bidragit till förrådet och samarbetat med intresserade användare för att lägga till de mest efterfrågade funktionerna och lösa problem. Nu är vi glada att meddela den officiella lanseringen av .
Tillvägagångssätt med öppen källkod
WhereHows, den ursprungliga LinkedIn-portalen för att hitta data och dess ursprung, startade som ett internt projekt; metadata-teamet skapade det. . Sedan dess har teamet alltid upprätthållit två olika kodbaser – en för öppen källkod och en för intern användning av LinkedIn, eftersom inte alla produktfunktioner som utvecklades för LinkedIn-implementationer var allmänt tillämpliga. Dessutom har WhereHows vissa interna beroenden (infrastruktur, bibliotek osv.) vars källkod inte är offentlig. Under de kommande åren har WhereHows genomgått många iterationer och utvecklingscykler, vilket har gjort synkroniseringen av de två kodbaserna till en stor utmaning. Metadata-teamet har under många år försökt använda olika metoder för att försöka synkronisera intern och öppen utveckling.
Första försöket: "Öppen källkod först".
Ursprungligen följde vi en "öppen källkod först"-utvecklingsmodell där huvudutvecklingen sker i det öppna källkodsförrådet, och ändringarna görs för intern distribution. Problemet med denna strategi är att koden alltid först skickas till GitHub innan den är helt granskad internt. Före nya interna distributioner upptäcker vi inga produktionsproblem förrän ändringar till genomförs i det öppna källkodsförrådet. Vid dålig distribution var det också mycket svårt att identifiera syndaren, eftersom ändringarna gjordes i partier.
Dessutom minskade denna modell teamets produktivitet vid utvecklingen av nya funktioner som krävde snabba iterationer, eftersom den tvingade alla ändringar att först placeras i det öppna källkodsförrådet och sedan överföras till det interna förrådet. För att minska den bearbetningstid som krävdes kunde nödvändiga korrigeringar eller ändringar först göras i det interna förrådet, men det blev en stor utmaning när det kom till att sammanslå dessa förändringar tillbaka till det öppna källkodsförrådet, eftersom de två förråden blev osynkroniserade.
Den här modellen är mycket enklare att implementera för gemensamma plattformar, bibliotek eller infrastrukturprojekt än för fullt fungerande användarwebbapplikationer. Dessutom passar modellen perfekt för projekt som börjar med öppen källkod från dag ett, men WhereHows utvecklades som en helt intern webbapplikation. Det var verkligen svårt att helt abstrahera från alla interna beroenden, så vi behövde behålla den interna grenen. Men att behålla den interna grenen och utveckla mestadels med öppen källkod fungerade inte riktigt.
Andra försöket: "Internt först"
** Som det andra försöket övergick vi till en utvecklingsmodell "internt först", där huvuddelen av utvecklingen sker inom företaget och ändringar görs till den öppna källkoden regelbundet. Även om denna modell passar vår användning bäst, har den sina problem. Att direkt skicka alla skillnader till det öppna källkodsarkivet och sedan försöka lösa sammanslagningskonflikter senare är ett alternativ, men det tar mycket tid. Utvecklare försöker vanligtvis undvika detta vid varje kodgranskning. Resultatet blir att det görs mycket mer sällan, i partier, vilket gör det svårare att lösa sammanslagningskonflikterna senare.
Tredje gången gillt!
De två ovan nämnda misslyckade försöken ledde till att WhereHows GitHub-repositoriet förblev föråldrat under lång tid. Teamet fortsatte att förbättra funktioner och produktarkitektur, så den interna versionen av WhereHows för LinkedIn blev allt mer avancerad än den öppna källkoden. Den fick till och med ett nytt namn — DataHub. Baserat på de tidigare misslyckade försök beslutade teamet att utveckla en skalbar långsiktig lösning.
För varje nytt projekt med öppen källkod rådgiver och stöder LinkedIns öppna källkodsteamsmodell för utveckling, där projektmoduler helt utvecklas med öppen källkod. Versionsstödda artefakter distribueras i ett offentligt repository och återförs sedan till det interna artefakten av LinkedIn med hjälp av Att följa denna utvecklingsmodell är inte bara bra för dem som använder öppen källkod, utan leder också till en mer modulär, skalbar och ansluten arkitektur.
Men för att uppnå detta tillstånd för en mogen intern applikation som DataHub kommer det att krävas betydande tid. Detta utesluter också möjligheten till en fullt fungerande öppen källkod-implementering innan alla interna beroenden helt har abstraherats. Därför har vi utvecklat verktyg som hjälper oss att bidra till öppen källkod snabbare och med mycket mindre besvär. Denna lösning är fördelaktig både för metadata-teamet (DataHub-utvecklare) och för open source-gemenskapen. Den nya metoden kommer att diskuteras i följande avsnitt.
Automatisering av publicering med öppen källkod
Metadata-gruppens senaste angreppssätt för DataHub med öppen källkod handlar om att utveckla ett verktyg som automatiskt synkroniserar den interna kodbasen med det öppna källkod-repositoriet. Huvudfunktionerna i detta verktyg inkluderar:
- Synkronisering av LinkedIns kod till/från öppen källkod, liknande .
- Generering av licenshuvud, liknande .
- Automatisk skapande av commit-loggar med öppen källkod från interna commit-loggar.
- Förhindra interna ändringar som bryter bygget med öppen källkod genom .
De ovan nämnda funktionerna kommer att diskuteras detaljerat i följande avsnitt, som har intressanta utmaningar.
Synkronisering av källkod
Till skillnad från versionen av DataHub med öppen källkod, som är en enda GitHub-repositorium, är versionen av DataHub för LinkedIn en kombination av flera repositorier (inom företaget kallade ). DataHub-gränssnittet, metadata-modellbiblioteket, metadata-lagringstjänsten och strömmande jobb finns i olika repositorier på LinkedIn. Men för att underlätta för användare av öppen källkod har vi ett enda repositorium för versionen av DataHub med öppen källkod.
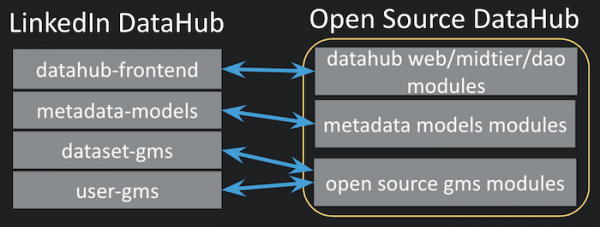
Figur 1: Synkronisering mellan repositorier LinkedIn DataHub och ett enda repositorium DataHub med öppen källkod
För att stödja automatiserade arbetsflöden för byggande, överföring och extrahering skapar vårt nya verktyg automatiskt en filnivåsmatchning som motsvarar varje ursprungsfil. Men verktyget kräver en första konfiguration och användarna måste tillhandahålla en hög nivå av modulkartläggning, som visas nedan.
{
  "datahub-dao": [
    "${datahub-frontend}/datahub-dao"
  ],
  "gms/impl": [
    "${dataset-gms}/impl",
    "${user-gms}/impl"
  ],
  "metadata-dao": [
    "${metadata-models}/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}/metadata-builders"
  ]
}
Modulnivåsmatchning är en enkel JSON-nyckel där nycklarna är målenheter i det öppna kodförrådet och värdena är listor över ursprungliga moduler i LinkedIn-repositorier. Varje målmodul i det öppna kodförrådet kan matas med ett valfritt antal ursprungliga moduler. Inre namn på förråd i ursprungsmoduler anges med i Bash-stil. Genom att använda modulnivåsmatchningsfilen skapar verktygen en filnivåsmatchning genom att skanna alla filer i de relaterade katalogerna.
{
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Foo.java":
"metadata-builders/src/main/java/com/linkedin/Foo.java",
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Bar.java":
"metadata-builders/src/main/java/com/linkedin/Bar.java",
  "${metadata-models}/metadata-builders/build.gradle": null,
}
Filnivåsmatchningen skapas automatiskt av verktygen; den kan dock även uppdateras av användaren manuellt. Denna matchning är 1:1 av en LinkedIn-ursprungsfil med en fil i det öppna kodförrådet. Det finns flera regler kopplade till denna automatiska skapelse av filmatchning:
- I händelse av flera ursprungsmoduler för en målmodul i det öppna koden kan det uppstå konflikter, till exempel en och samma , som finns mer än en gång i flera ursprungliga moduler. Som en strategi för att lösa konflikter använder våra verktyg som standard alternativet 'senaste vinner'.
- "null" betyder att ursprungsfilen inte är en del av det öppna kodförrådet.
- Efter varje inlämning eller extraktion från öppen källkod uppdateras denna mappning automatiskt och ett ögonblicksbild skapas. Detta är nödvändigt för att identifiera tillägg och borttagningar av källkod sedan senaste åtgärd.
Skapa commit-loggar
Commit-loggar för commits med öppen källkod skapas också automatiskt genom att kombinera commit-loggar från interna repository. Nedan visas ett exempel på en commit-logg för att visa strukturen av en commit-logg som skapats av vårt verktyg. Committen anger tydligt vilka versioner av källrepositorier som packas i denna commit och ger en sammanfattning av commit-loggen. Kontrollera detta med ett verkligt exempel på en commit-logg skapad av vårt verktyg.
metadata-models 29.0.0 -> 30.0.0
    Lade till aspektmodell foo
    Fixade problem bar

dataset-gms 2.3.0 -> 2.3.4
    Lade till rest.li API för att tjänstgöra foo-aspekt

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Testa beroenden
LinkedIn har , som hjälper till att säkerställa att förändringar i interna multiprodukter inte bryter byggen av beroende multiprodukter. DataHub-repositoriet med öppen källkod är inte multiproduktbaserat och kan inte vara ett direkt beroende av någon multiprodukt, men med hjälp av en multiproduktwrapper som extraherar koden från DataHub med öppen källkod kan vi fortfarande använda detta system för testning av beroenden. Således utlöser varje förändring (som kan bli offentlig senare) i något av multiprodukterna som matar DataHub-repositoriet med öppen källkod, ett bygghändelse i multiproduktomslaget. Följaktligen passerar inga förändringar som inte möjliggör byggnation av multiproduktomslaget testerna före commit av den ursprungliga multiprodukten och återgår.
Detta är en användbar mekanism som hjälper till att förhindra alla interna commits som bryter bygget med öppen källkod, och upptäcker det under commit-processen. Utan detta skulle det vara ganska svårt att identifiera vilken intern commit som ledde till att bygget av repositoryt med öppen källkod misslyckades, eftersom vi placerar batch-intern förändringar i DataHub-repositoriet med öppen källkod.
Skillnader mellan den öppna källkodsversionen av DataHub och vår produktionsversion
Tidigare har vi diskuterat vår lösning för att synkronisera de två versionerna av DataHub-repositorierna, men vi har ännu inte gett några anledningar till varför vi faktiskt behöver två olika utvecklingsflöden. I detta avsnitt kommer vi att lista skillnaderna mellan den offentliga versionen av DataHub och produktionsversionen på LinkedIns servrar, samt förklara orsakerna till dessa skillnader.
En av källorna till avvikelserna härstammar från det faktum att vår produktionsversion har beroenden till kod med ännu inte öppen källkod, såsom LinkedIns Offspring (den interna strukturen för hantering av beroenden på LinkedIn). Offspring används i stor utsträckning i den interna kodbasen eftersom det är den föredragna metoden för att hantera dynamisk konfiguration. Men detta är inte öppen källkod; därför behövde vi hitta öppna källkodsalternativ för DataHub med öppen källkod.
Det finns också andra skäl. När vi skapar metadata-modeller för LinkedIns behov är dessa utvidgningar vanligtvis mycket specifika för LinkedIn och kan därför inte tillämpas direkt i andra miljöer. Till exempel har vi mycket specifika etiketter för identifierare av deltagare och andra typer av metadataöverensstämmelse. Således har vi för närvarande uteslutit dessa utvidgningar från den öppna källkodsmodellen av DataHub. Allt eftersom vi interagerar med gemenskapen och förstår deras behov, kommer vi att arbeta med gemensamma versioner av dessa utvidgningar med öppen källkod där det är nödvändigt.
Användarvänlighet och lättare anpassning för öppna källkodsgemenskapen har också inspirerat vissa skillnader mellan de två versionerna av DataHub. Skillnader i infrastruktur för strömmande bearbetning är ett bra exempel. Även om vår interna version använder en hanterad strömmande bearbetningsinfrastruktur, beslutade vi att använda inbyggd (fristående) strömmande bearbetning för den öppna källkodsversionen, eftersom det möjliggör att undvika att skapa ännu ett infrastrukturberoende.
En annan exempel på skillnaden är närvaron av en GMS (Generalized Metadata Store) i implementationen med öppen källkod, snarare än flera GMS. GMA (Generalized Metadata Architecture) är namnet på den interna arkitekturen för DataHub, medan GMS är lagret för metadata i kontexten av GMA. GMA är en mycket flexibel arkitektur som gör att du kan distribuera varje datakonstruktion (till exempel dataset, användare osv.) till ett eget metadata-lager eller lagra flera datakonstruktioner i ett enda metadata-lager så länge som registret, som innehåller avbildningen av datakonfigurationen i GMS, uppdateras. För att underlätta användningen har vi valt en instans av GMS som lagrar alla olika datakonstruktioner i DataHub med öppen källkod.
Den fullständiga listan över skillnader mellan de två implementationerna anges i tabellen nedan.
Produktfunktioner
LinkedIn DataHub
Öppen källkod DataHub
Stödda datakonstruktioner
1) Dataset 2) Användare 3) Metriker 4) ML-funktioner 5) Diagram 6) Instrumentpaneler
1) Dataset 2) Användare
Stödda metadata-källor för dataset
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Strömbehandling
Hanterad
Inbäddad (självständig)
Dependency Injection & Dynamisk konfiguration
LinkedIn Offspring
Byggverktyg
Ligradle (LinkedIns interna Gradle-wrapper)
CI/CD
CRT (LinkedIns interna CI/CD)
och
Metadata-lager
Distribuerade flera GMS: 1) Dataset GMS 2) Användar GMS 3) Metrik GMS 4) Funktion GMS 5) Diagram/Instrumentspanel GMS
Enkel GMS för: 1) Dataset 2) Användare
Mikrotjänster i Docker-containrar
förenklar distribution och spridning av applikationer genom . Varje del av tjänsten i DataHub med öppen källkod, inklusive infrastrukturella komponenter som Kafka, , och , har sin egen Docker-avbild. För orkestrering av Docker-containrar har vi använt .
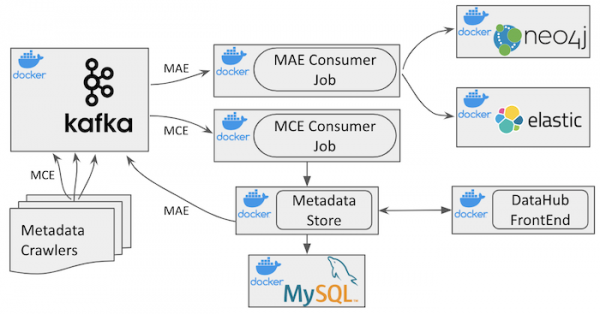
Bild 2: Arkitektur DataHub *med öppen källkod*
Du kan se den övergripande arkitekturen för DataHub på bilden ovan. Förutom infrastrukturella komponenter har den fyra olika Docker-containrar:
datahub-gms: metadata-lagringstjänst
datahub-frontend: applikation , som tillhandahåller DataHub-gränssnittet.
datahub-mce-consumer: applikation , som använder strömmen av metadataändringshändelser (MCE) och uppdaterar metadata-lagringen.
datahub-mae-consumer: applikation , som använder strömmen av metadata-audithändelser (MAE) och skapar en sökindex- och grafdatabas.
Dokumentation för det öppna källkodsförrådet och innehåller mer detaljerad information om funktionerna i olika tjänster.
CI / CD i DataHub med öppen källkod
DataHub-förrådet med öppen källkod använder för kontinuerlig integrering och för kontinuerlig distribution. Båda har bra integration med GitHub och är enkla att konfigurera. För största delen av infrastrukturen med öppen källkod, utvecklad av gemenskapen eller privata företag (till exempel, ), har Docker-bilder skapats och de distribueras på Docker Hub för att underlätta användningen i gemenskapen. Varje Docker-bild som hittas på Docker Hub kan enkelt användas med ett enkelt kommando .
Vid varje commit i DataHubs öppna källkodsförråd skapas och distribueras alla Docker-bilder automatiskt till Docker Hub med taggen 'latest'. Om det finns någon , så släpps alla taggar i det öppna källkodsförrådet också med motsvarande taggnamn på Docker Hub.
Användning av DataHub
är väldigt enkel och består av tre enkla steg:
- Klona det öppna källkodsförrådet och starta alla Docker-containrar med hjälp av docker-compose med hjälp av det medföljande docker-compose-skriptet för snabb start.
- Ladda ner exempeldata, presenterade i förrådet, med hjälp av kommandoradsverktyget som också tillhandahålls.
- Titta på DataHub i din webbläsare.
Aktivt övervakad är också inställt för snabba frågor. Användare kan också skapa problem direkt i GitHub-förrådet. Viktigast av allt, vi välkomnar och uppskattar all feedback och förslag!
Framtidsplaner
För närvarande är varje infrastruktur eller mikrotjänst för DataHub med öppen källkod byggd som en Docker-container och hela systemet orkestreras med . Med tanke på populariteten och den breda spridningen , skulle vi också vilja tillhandahålla en Kubernetes-baserad lösning inom en snar framtid.
Vi planerar också att erbjuda en färdig lösning för att distribuera DataHub i en offentlig molntjänst, såsom , eller . Med tanke på det senaste tillkännagivandet om LinkedIns migrering till Azure, kommer detta att överensstämma med interna prioriteringar för metadata-gruppen.
Och sist men inte minst: tack till alla de första användarna av DataHub i samhällen med öppen källkod som har värderat alpha-versionerna av DataHub och hjälpt oss att identifiera problem och förbättra dokumentationen.
Källa: habr.com
