

Hur förstår en backend-utvecklare att en SQL-fråga kommer att fungera bra på "prod"? I stora eller snabbt växande företag har inte alla tillgång till "prod". Dessutom kan inte alla frågor testas smärtfritt med tillgång, och att skapa en databasåterkoppling kan ofta ta timmar. För att lösa dessa problem har vi skapat en artificiell DBA - Joe. Han har redan framgångsrikt implementerats i flera företag och hjälper ett tiotal utvecklare.
Video:
Hej alla! Jag heter Anatolij Stansler. Jag arbetar på företaget . Vi fokuserar på att påskynda utvecklingsprocessen genom att eliminera de fördröjningar som utvecklare, DBA och QA upplever när de arbetar med Postgres.
Vi har fantastiska kunder, och idag kommer en del av presentationen att ägnas åt fallstudier som vi har stött på i vårt arbete med dem. Jag kommer att berätta om hur vi hjälpte dem att lösa ganska allvarliga problem.
När vi bedriver utveckling och genomför komplexa migreringar ställer vi oss frågan: "Kommer den här migreringen att lyckas?" Vi använder recensioner, vi utnyttjar kunskapen från mer erfarna kollegor och DBA-experter. De kan säga om det kommer att lyckas eller inte.
Men kanske vore det bättre om vi själva kunde testa detta på fullstora kopior. Och idag kommer vi just att diskutera de nuvarande metoderna för testning och hur detta kan göras bättre med hjälp av vilka verktyg. Vi kommer också att diskutera vilka fördelar och nackdelar det finns med dessa metoder och vad vi kan förbättra här.
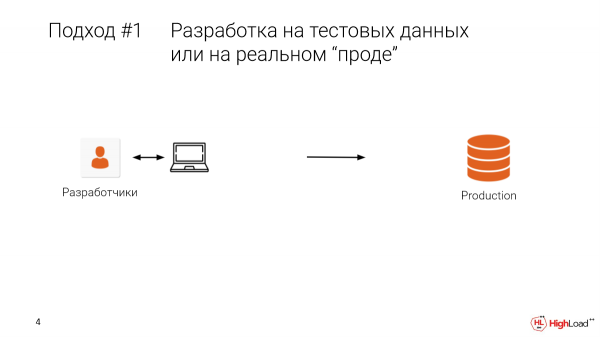
Har någon någonsin gjort index eller några andra ändringar direkt på prod? Många har det. Och hos de som har gjort det ledde det till att data gick förlorade eller till driftstopp? Då känner du till den smärtan. Tack och lov finns det backup.
Den första metoden är testning i prod. Eller när utvecklaren sitter med sin lokala maskin, har testdata, finns en begränsad urval. Och vi rullar ut på prod och får en sådan situation.
Det är smärtsamt, det är dyrt. Kanske är det bättre att inte göra så.
Hur kan vi göra det bättre?
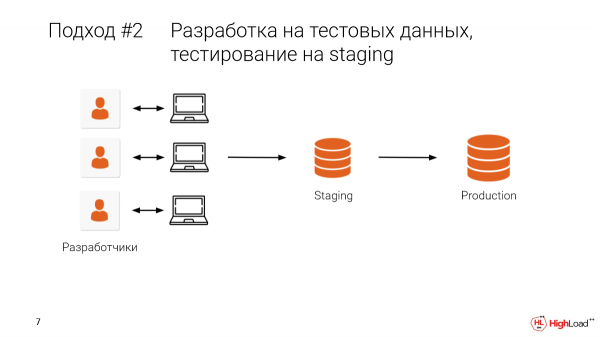
Låt oss ta staging och avsätta en del av prod där. Eller i bästa fall ta verklig prod, alla data. Och efter att vi har utvecklat lokalt, ska vi också kontrollera på staging.
Detta kommer att hjälpa oss att eliminera vissa fel, d.v.s. förhindra dem på prod.
Vilka problem finns det?
- Problemet är att vi delar denna staging med kollegor. Och det händer ofta att man gör någon ändring, boom – och inga data finns kvar, allt arbete förgäves. Staging var flera terabyte stort. Och man måste vänta länge innan det är uppe igen. Vi beslutar oss för att göra detta imorgon. Nu har vi stopp i utvecklingen.
- Och självklart har vi många kollegor som arbetar där, många team. Och det måste godkännas manuellt. Det är mycket opraktiskt.
Och det är värt att nämna att vi endast har ett försök, en chans, om vi vill göra några ändringar i databasen, röra vid datan, ändra strukturen. Och om något går fel, om det uppstår ett fel i migreringen, så kan vi inte snabbt gå tillbaka.
Detta är bättre än det föregående tillvägagångssättet, men det finns fortfarande en stor risk att något fel går till produktion.
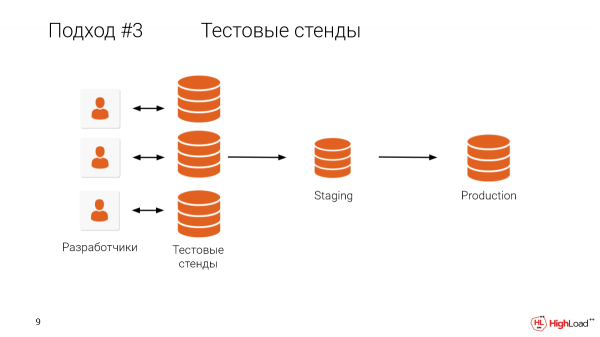
Vad hindrar oss från att ge varje utvecklare en testmiljö, en fullständig kopia? Jag tror att det är tydligt vad som hindrar oss.
Vem har en databas som är större än en terabyte? Mer än hälften av salen.
Och det är uppenbart att hålla maskiner för varje utvecklare, när produktionen är så stor, är mycket dyrt, och dessutom tar det lång tid.
Vi har kunder som har insett att det är mycket viktigt att testa alla ändringar på fullständiga kopior, men de har databaser som är mindre än en terabyte, och de har inte resurser för att hålla en testmiljö för varje utvecklare. Därför tvingas de ladda ner dumpfiler lokalt på sin maskin och testa på det sättet. Det tar massor av tid.
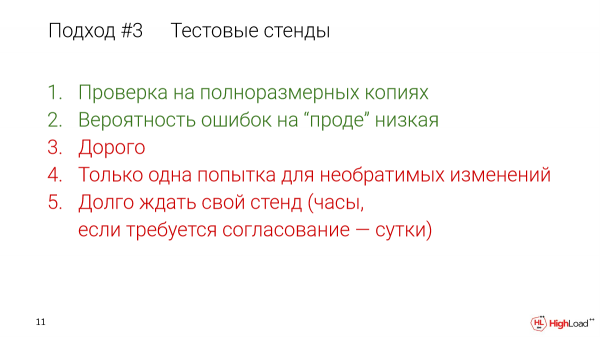
Även om du gör detta inom infrastrukturen, att ladda ner en terabyte data på en timme – det är redan väldigt bra. Men de använder logiska dumpfiler, de laddar ner lokalt från molnet. För dem är hastigheten omkring 200 gigabyte i timmen. Och man behöver också tid för att återställa från den logiska dumpen, applicera index, osv.
Men de använder detta tillvägagångssätt eftersom det gör att de kan hålla produktionen pålitlig.
Vad kan vi göra här? Låt oss se till att testmiljöerna är billiga och ge varje utvecklare sin egen testmiljö.
Och det är möjligt.
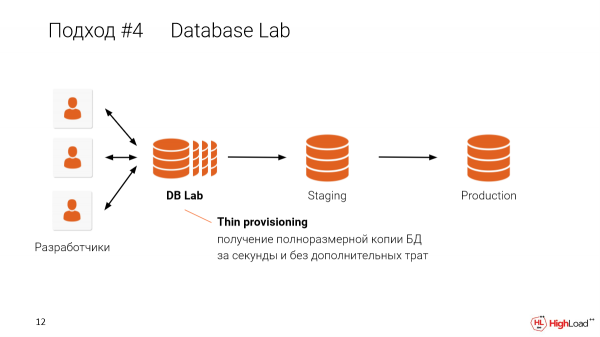
Och i detta tillvägagångssätt, när vi skapar tunna kloner för varje utvecklare, kan vi dela detta på en maskin. Till exempel, om du har en fyra terabyte stor databas och vill ge den till 10 utvecklare, behöver du inte ha 10 x fyraterabyte databaser. Det räcker med en maskin för att göra tunna isolerade kopior för varje utvecklare, med hjälp av en maskin. Jag kommer att berätta hur det fungerar lite senare.
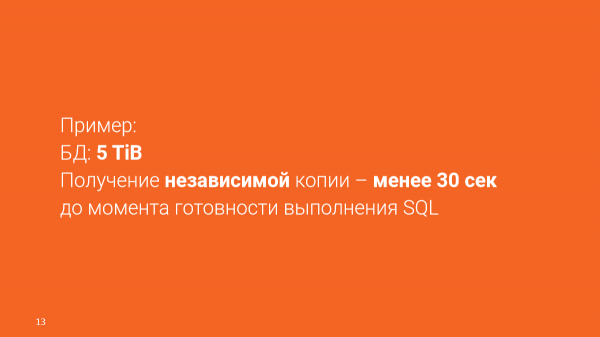
Ett verkligt exempel:
DB – 4,5 terabyte.
Vi kan få oberoende kopior på 30 sekunder.
Du behöver inte vänta på en testmiljö och vara beroende av hur stor den är. Du kan få den på sekunder. Det kommer att vara helt isolerade miljöer, men som delar data mellan varandra.
Det är riktigt häftigt. Här pratar vi om magi och parallella universum.
I vårt fall fungerar detta med hjälp av systemet OpenZFS.
OpenZFS är ett copy-on-write filsystem som från början stödjer snapshots och kloner. Det är pålitligt och skalbart. Det är mycket enkelt att hantera. Du kan bokstavligt talat ställa in det med två kommandon.
Det finns andra alternativ:
LVM,
SAN (till exempel Pure Storage).
Database Lab, som jag pratar om, är modulärt. Det kan implementeras med sådana alternativ. Men hittills har vi fokuserat på OpenZFS eftersom vi specifikt har haft problem med LVM.
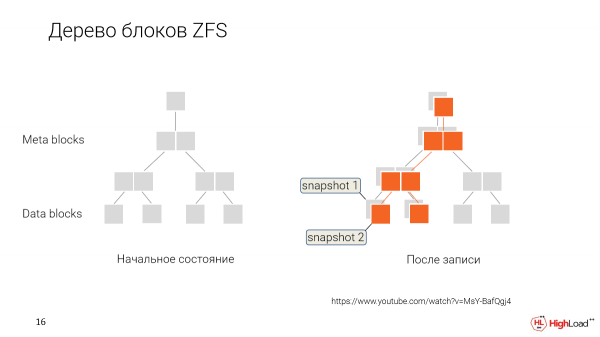
Hur fungerar detta? Istället för att skriva om data varje gång vi ändrar dem, sparar vi dem helt enkelt, och markerar att dessa nya data tillhör en ny tidspunkt, en ny snapshot.
Och senare, när vi vill återgå eller skapa en ny klon från en äldre version, säger vi bara: "Okej, ge oss dessa datablokkar som är markerade på det här sättet."
Och den här användaren kommer att arbeta med detta dataset. Han kommer gradvis att ändra dem och göra sina snapshots.
Och vi kommer att få förgrening. Varje utvecklare kommer i vårt fall att ha möjlighet att ha sin egen klon som han redigerar, medan de gemensamma data kommer att delas mellan alla.
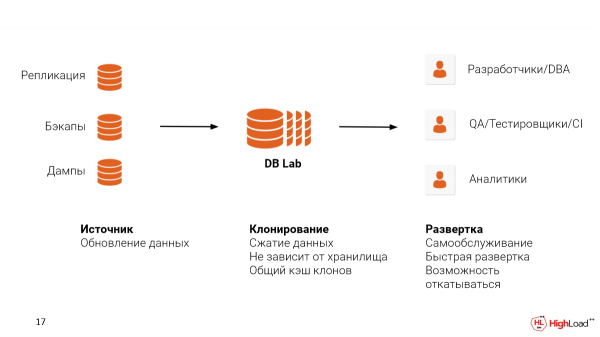
För att ställa in ett sådant system på din egen sida måste du lösa två problem:
Det första är datakällan därifrån du kommer att hämta dem. Du kan ställa in replikering från produktion. Du kan använda redan befintliga säkerhetskopior som du har ställt in, hoppas jag. WAL-E, WAL-G eller Barman. Och även om du använder någon form av molnlösning, som RDS eller Cloud SQL, kan du använda logiska dumpningar. Men vi rekommenderar fortfarande att du använder säkerhetskopior, eftersom denna metod också bevarar den fysiska filstrukturen, vilket gör att du kommer ännu närmare de mått som du skulle se i produktion för att fånga de problem som finns.
Det andra är platsen där du vill hosta Database Lab. Det kan vara i molnet, det kan vara på plats. Här är det viktigt att nämna att ZFS stöder datakomprimering. Och det gör det ganska bra.
Tänk dig att varje sådan klon, beroende på de operationer vi gör med databasen, kommer att öka i storlek. För den utvecklingen behövs också plats. Men eftersom vi har tagit en databas på 4,5 terabyte, kommer ZFS att komprimera den till 3,5 terabyte. Beroende på inställningarna kan detta varieras. Och vi får fortfarande plats för utvecklingen.
Ett sådant system kan användas för olika fall.
Det här är utvecklare, DBA för att kontrollera frågor och för optimering.
Detta kan användas i QA-testning för att kontrollera en specifik migrering innan vi rullar ut den i produktion. Vi kan också skapa speciella miljöer för QA med verkliga data, där de kan testa ny funktionalitet. Och detta kommer att ta sekunder istället för att vänta timmar, kanske till och med dagar i vissa andra fall där tunna kopior inte används.
Och ännu ett separat fall. Om företaget inte har ett analyssystem kan vi avsätta en tunn klon av produktdatabasen för långa frågor eller för speciella index som kan användas i analys.
Med detta tillvägagångssätt:
Låg sannolikhet för fel i "produktionen", eftersom vi har testat alla ändringar på fullstora data.
Vi får en testningskultur, eftersom vi nu inte behöver vänta i timmar på att få egen miljö.
Och det finns inga hinder, ingen väntan mellan tester. Du kan verkligen gå och kontrollera. Och det kommer bli bättre, eftersom vi påskyndar utvecklingen.
Det kommer att bli mindre refaktorering. Färre buggar kommer att hamna i produktion. Vi kommer att refaktorisera dem mindre senare.
Vi kan hantera oåterkalleliga förändringar. Detta finns inte i standardmetoder.
- Detta är fördelaktigt eftersom vi delar resurserna för testmiljöer.
Det är redan bra, men vad mer kan vi snabba upp?
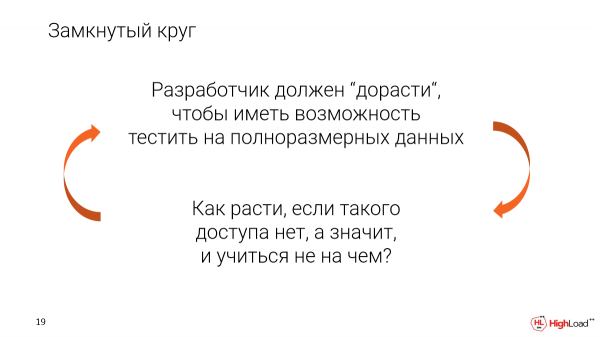
Tack vare ett sådant system kan vi kraftigt sänka tröskeln för att komma in i denna typ av testning.
Det finns idag en ond cirkel där utvecklaren måste bli expert för att få tillgång till verklig fullstor data. De måste få förtroende för denna åtkomst.
Men hur kan vi växa om det inte finns? Och vad händer om du bara har tillgång till en mycket liten uppsättning testdata? Då får du ingen verklig erfarenhet.
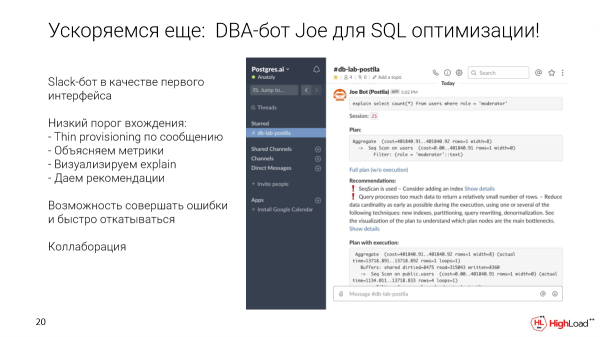
Hur tar vi oss ur denna cirkel? Som första gränssnitt, bekvämt för utvecklare på alla nivåer, har vi valt en Slack-bot. Men det kan vara vilket annat gränssnitt som helst.
Vad tillåter det oss att göra? Man kan ta en specifik förfrågan och skicka den till en speciell kanal för databasen. Vi kommer automatiskt att på några sekunder ställa upp en tunn klon. Köra denna förfrågan. Samla in mätvärden och rekommendationer. Visa visualisering. Och denna klon kommer att finnas kvar så att denna förfrågan kan optimeras, lägga till index, etc.
Och dessutom ger Slack oss möjligheter för samarbeten direkt ur lådan. Eftersom det bara är en kanal kan man direkt där i tråden för den förfrågan börja diskutera den, pingar sina kollegor, DBA:er som finns inom företaget.
Men det finns förstås även problem. Eftersom detta är den verkliga världen, och vi använder en server där vi hostar många kloner, måste vi komprimera mängden minne och processorkraft som klonerna har tillgång till.
Men för att dessa tester ska vara trovärdiga, måste vi på något sätt lösa detta problem.
Det är klart att en viktig aspekt är att ha samma data. Men det har vi redan. Och vi vill uppnå en enhetlig konfiguration. Och vi kan ge en praktiskt taget identisk konfiguration.
Det skulle vara fantastiskt att ha samma hårdvara som i produktion, men den kan skilja sig.
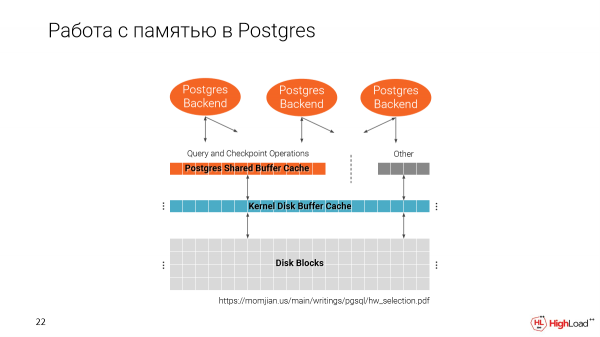
Låt oss komma ihåg hur Postgres arbetar med minne. Vi har två cacheminnen. Ett från filsystemet och ett från Postgres, det vill säga Shared Buffer Cache.
Det är viktigt att notera att Shared Buffer Cache allokeras vid starten av Postgres beroende på den storlek du anger i konfigurationen.
Och den andra cachen använder allt tillgängligt utrymme.
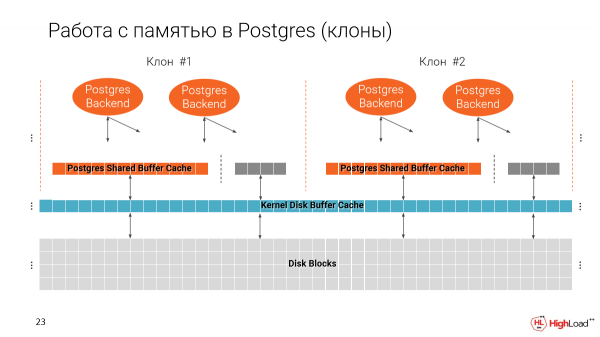
Och när vi gör flera kloner på en och samma maskin, visar det sig att vi gradvis fyller minnet. Och i bästa fall är Shared Buffer Cache 25 % av den totala mängden minne som finns tillgängligt på maskinen.
Och det visar sig att om vi inte ändrar den här parametern kan vi bara köra 4 instanser på en maskin, dvs. totalt 4 sådana tunna kloner. Och det är förstås dåligt, eftersom vi vill ha betydligt fler.
Men å andra sidan används Buffer Cache för att utföra förfrågningar, för index, dvs. planeringen beror på storleken på våra cacher. Och om vi bara tar och minskar den här parametern, kan våra planer förändras mycket.
Till exempel, om vi har en stor cache på prod, kommer Postgres att föredra att använda index. Men om inte, kommer det att bli SeqScan. Och vad skulle det finnas för mening i att våra planer inte matchade?
Men här kommer vi fram till den slutsatsen att planen i Postgres faktiskt inte beror på den specifika storleken på Shared Buffer som har angivits, utan på effective_cache_size.
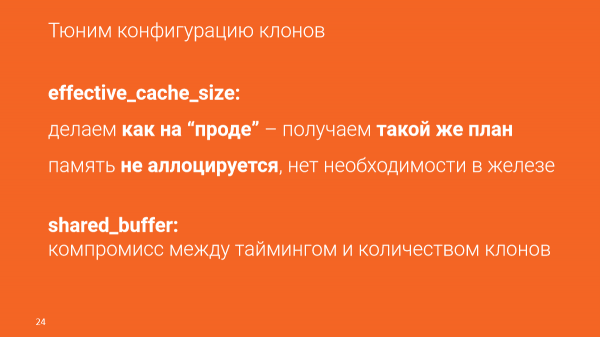
Effective_cache_size är den förväntade mängden cache som vi har tillgång till, dvs. summan av Buffer Cache och filsystemets cache. Detta anges i konfigurationen. Och det här minnet allokeras inte.
Och genom den här parametern kan vi lura Postgres och säga att vi faktiskt har mycket data tillgänglig, även om vi inte har den datan. Och på så sätt kommer planerna att helt överensstämma med produktionen.
Men det kan påverka tidsaspekten. Och vi optimerar förfrågningar efter tid, men det är viktigt att tidsaspekten beror på många faktorer:
Det beror på den belastning som just nu finns på prod.
Det beror på specifikationerna för själva maskinen.
Och detta är en indirekt parameter, men egentligen kan vi optimera precis efter mängden data som denna förfrågan kommer att läsa för att få resultat.
Och om vi vill att tidpunkten ska närma sig det vi ser i produktion, måste vi använda så liknande hårdvara som möjligt och kanske till och med mer för att alla kloner ska få plats. Men det är en kompromiss, dvs. du får samma planer, du kommer att se hur mycket data en specifik fråga läser och kan dra slutsatsen – är denna fråga bra (eller migrering) eller dålig, den behöver fortfarande optimeras.
Låt oss titta på hur optimeringen faktiskt sker med Joe.
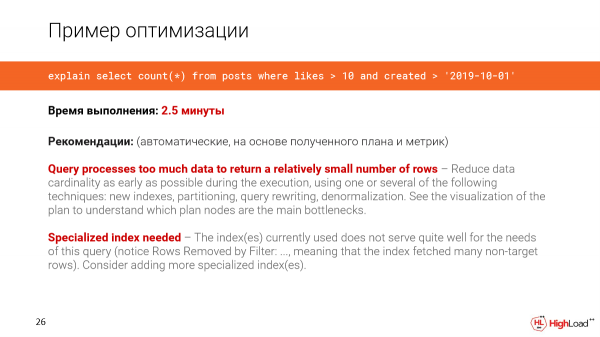
Låt oss ta en fråga från ett verkligt system. I detta fall är databasen 1 terabyte. Och vi vill räkna antalet nya inlägg som har fått mer än 10 gillningar.
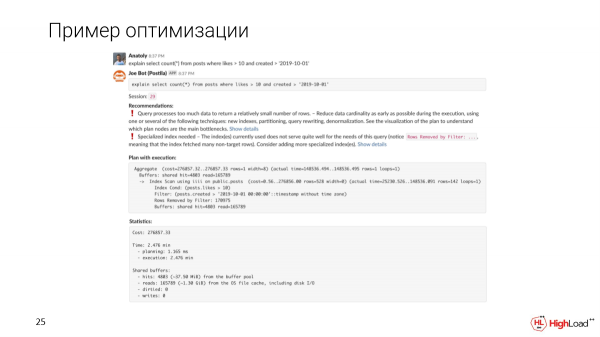
Vi skriver ett meddelande i kanalen, en klon har skapats för oss. Och vi kommer att se att en sådan fråga kommer att köras på 2,5 minuter. Det är det första vi kommer att märka.
B Joe kommer att visa automatiska rekommendationer baserade på planen och mätvärdena.
Vi kommer att se att frågan bearbetar för mycket data för att få ett relativt litet antal rader. Och vi behöver en speciell index, eftersom vi har märkt att det finns för många filtrerade rader i frågan.
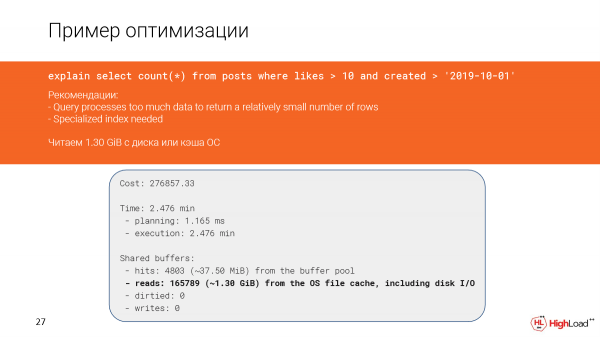
Låt oss titta närmare på vad som hände. Faktiskt ser vi att vi har läst nästan en och en halv gigabyte data från filcachen eller till och med från disken. Och det är inte bra, eftersom vi bara fick 142 rader.
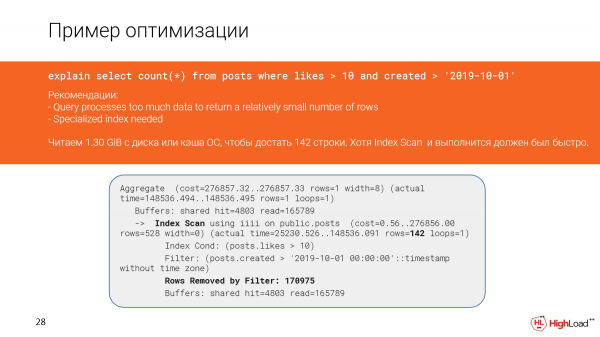
Och, som det verkar, har vi här en indexskanning och det borde ha gått snabbt, men eftersom vi filtrerade bort för många rader (vi var tvungna att räkna dem), så gick frågan långsamt.
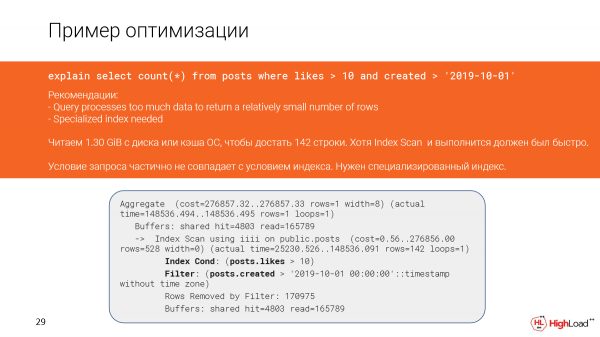
Och detta hände i planen eftersom villkoren i frågan och villkoren i indexet delvis inte stämmer överens.
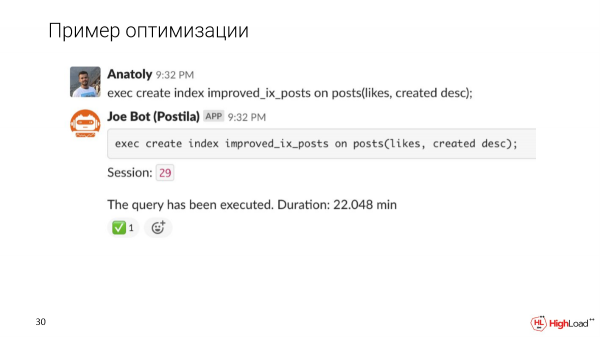
Låt oss försöka göra indexet mer exakt och se hur frågans körning förändras efter det.
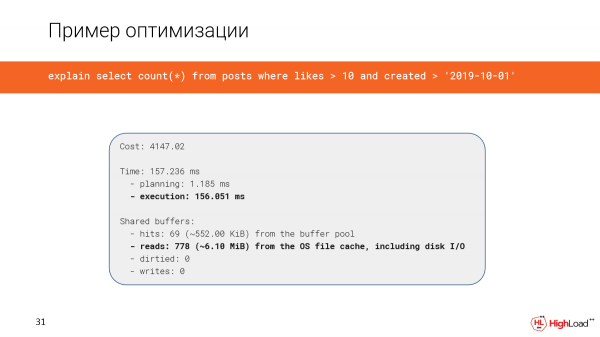
Att skapa indexet tog ganska lång tid, men nu kontrollerar vi frågan och ser att tiden istället för 2,5 minuter nu bara är 156 millisekunder, vilket är riktigt bra. Och vi läser bara 6 megabyte data.
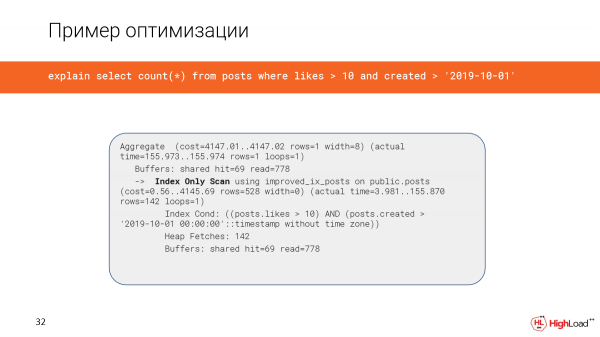
Och nu använder vi index only scan.
En annan viktig sak är att vi vill presentera planen på ett mer förståeligt sätt. Vi har implementerat visualisering med hjälp av Flame Graphs.
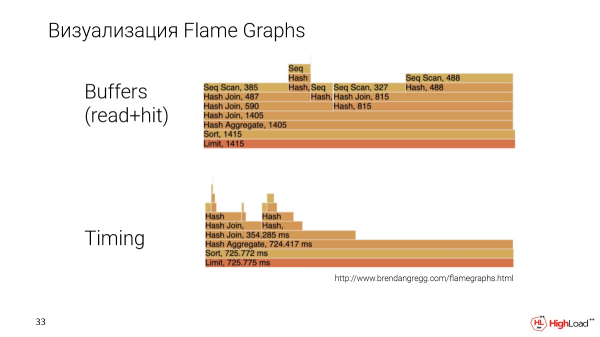
Detta är en annan fråga, mer komplex. Och vi bygger Flame Graphs baserat på två parametrar: det är mängden data som en specifik nod i planen har läst och tidpunkten, dvs. nödens utförandetid.
Här kan vi jämföra specifikt noder med varandra. Det blir tydligt vilken som tar mer eller mindre utrymme, vilket ofta är svårt att göra med andra visualiseringsmetoder.
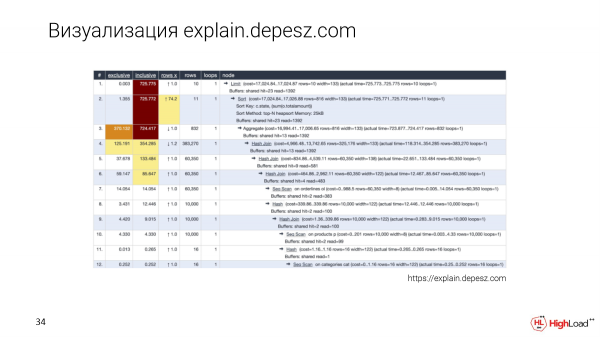
Självklart känner alla till explain.depesz.com. En bra funktion med den här visualiseringen är att vi sparar den textbaserade planen och också lyfter fram några huvudparametrar i en tabell, så att de kan sorteras.
Och utvecklare som ännu inte har dykt djupt ner i det här ämnet använder också explain.depesz.com, eftersom det är enklare för dem att förstå vilka mätvärden som är viktiga och vilka som inte är det.
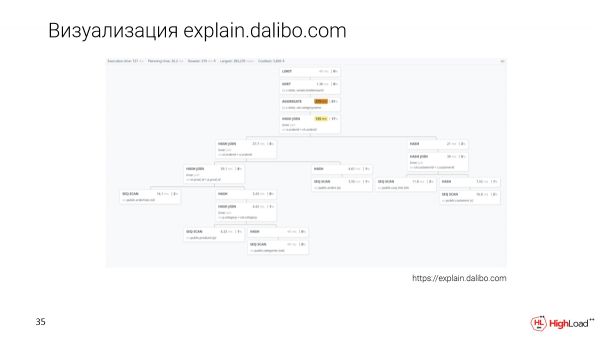
Det finns en ny metod för visualisering – explain.dalibo.com. De gör en trädbaserad visualisering, men här är det väldigt svårt att jämföra noder med varandra. Här kan man förstå strukturen ganska bra, men om det är en stor fråga måste man scrolla fram och tillbaka, men det är också ett alternativ.
Samarbete
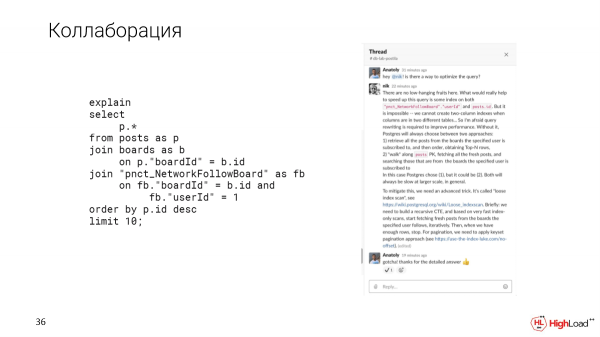
Och som jag redan har sagt ger Slack oss möjlighet till samarbete. Till exempel, om vi stöter på en komplicerad fråga som vi inte vet hur vi ska optimera, kan vi klargöra denna fråga i en tråd i Slack med våra kollegor.
Vi tycker att det är viktigt att testa med fullstora data. För detta har vi skapat verktyget Update Database Lab, som är tillgängligt som öppen källkod. Du kan också använda boten Joe. Du kan hämta den just nu och implementera den. Alla guider finns tillgängliga.
Det är också viktigt att notera att själva lösningen inte är revolutionerande, eftersom det finns Delphix, men det är en företagslösning. Den är helt stängd och kostar mycket. Vi specialiserar oss på Postgres. Dessa är alla produkter med öppen källkod. Kom och joina oss!
Detta avslutar jag. Tack!
Frågor
Hej! Tack för föredraget! Mycket intressant, särskilt för mig, eftersom jag har löst ett liknande problem för en tid sedan. Därför har jag en rad frågor. Jag hoppas att jag får ställa åtminstone några av dem.
Det är intressant, hur beräknar ni utrymmet för denna miljö? Tekniken innebär att under vissa omständigheter kan era kloner växa till maxstorlek. Grovt sagt, om ni har en tio terabyte stor databas och 10 kloner, kan man lätt modellera en situation där varje klon kommer att ha 10 unika data. Hur beräknar ni detta utrymme, det vill säga den delta som ni talade om, där dessa kloner kommer att finnas?
Bra fråga. Här är det viktigt att hålla koll på de specifika klonerna. Om en klon genomgår en för stor förändring och börjar växa, kan vi först ge en varning till användaren om detta, eller direkt stoppa klonen för att undvika en fail-situation.
Ja, jag har en följdfråga. Alltså, hur säkerställer ni livscykeln för dessa moduler? Det är ett problem för oss och en helt egen historia. Hur går det till?
Det finns en specifik ttl för varje klon. I praktiken har vi en fast ttl.
Vilken, om jag får fråga?
1 timme, dvs. inaktiv – 1 timme. Om den inte används, tar vi bort den. Men här är det inget att förvåna sig över, eftersom vi kan återställa en klon på sekunder. Och om den behövs igen, så är det bara att köra.
Jag är också intresserad av valet av teknologier, eftersom vi till exempel parallellt använder flera metoder av olika skäl. Varför valde just ZFS? Varför använde ni inte LVM? Du nämnde att det fanns problem med LVM. Vilka problem var det? Enligt min åsikt är den mest optimala lösningen den med lagringssystem, ur prestandasynvinkel.
Vad är det största problemet med ZFS? Att du måste köra på en och samma värd, dvs. alla instanser kommer att leva inom samma operativsystem. I fallet med lagringssystem kan du ansluta olika hårdvara. Den flaskhalsen är endast de enheter som finns på lagringssystemet. Och frågan om valet av teknologier är intressant. Varför inte LVM?
Vi kan diskutera LVM specifikt på meetuppen. Om lagringssystemet – det är helt enkelt dyrt. ZFS-systemet kan vi implementera var som helst. Du kan rulla ut det på din egen maskin. Du kan helt enkelt ladda ner repositoryn och rulla ut det. ZFS kan installeras nästan överallt, om vi pratar om Linux. Det ger en mycket flexibel lösning. Själva ZFS erbjuder mycket direkt ur lådan. Man kan lagra hur mycket data som helst där, koppla ett stort antal diskar, det finns snapshots. Och som jag redan nämnt, är det enkelt att administrera. Det verkar vara mycket trevligt att använda. Det är testat, har många år bakom sig. Det har en stor och växande community. ZFS är en mycket pålitlig lösning.
Nikolaj Samokhvalov: Får jag kommentera? Jag heter Nikolaj, och jag arbetar tillsammans med Anatolij. Jag håller med om att lagringssystem är fantastiskt. Och vissa av våra kunder har Pure Storage osv.
Anatolij påpekade korrekt att vi siktar på modulär design. I framtiden kan vi implementera ett enda gränssnitt – ta en snapshot, skapa en klon, radera klonen. Det är allt lätt. Och lagringssystemet är fantastiskt, om det finns.
Men ZFS är tillgängligt för alla. Det räcker med DelPhix, de har 300 kunder. Av dem är 50 i Fortune 100, det vill säga de siktar på NASA och så vidare. Det är dags att göra denna teknik tillgänglig för alla. Därför har vi en öppen källkods Core. Vi har en del av gränssnittet som inte är öppen källkod. Det är plattformen som vi kommer att visa. Men vi vill att det ska vara tillgängligt för alla. Vi vill göra en revolution så att alla testare slutar gissa på bärbara datorer. Vi måste skriva SELECT och direkt se att den är långsam. Det är nog att vänta på att DBA ska berätta om det. Det är vårt huvudmål. Och jag tror att vi alla kommer att nå dit. Och den här grejen gör vi för att den ska vara tillgänglig för alla. Så ZFS, eftersom det kommer att vara tillgängligt överallt. Tack till communityn för att ni löser problem och för att det finns en öppen källkodlicens och så vidare.
Hej! Tack för presentationen! Jag heter Maxim. Vi har löst samma problem. Vi har löst det här hemma. Hur delar ni resurser mellan dessa kloner? Varje klon kan alltid hantera sina egna: en testar en sak, en annan testar något annat, någon bygger index, någon har ett jobb som kör tungt. Och om man kan dela upp CPU, hur delar ni upp IO?
Och den andra frågan handlar om olikheterna i miljöerna. Anta att jag här har ZFS och allt är bra, men hos kunden på produktion finns det inte ZFS, utan ext4, till exempel. Hur hanterar ni det?
Frågorna är mycket bra. Jag nämnde lite det här problemet med hur vi delar resurser. Lösningen är följande. Föreställ er att ni testar på staging. Ni kan också ha en situation där någon ger en viss belastning, medan någon annan ger en annan. Och slutligen ser ni oklara metrikvärden. Även samma problem kan uppstå på produktion. När ni vill kontrollera en viss fråga och ser att det är problem med den – att den körs långsamt, är det egentligen inte frågan som är problemet, utan det beror på att det finns en parallell belastning.
Därför är det viktigt att fokusera på vilken plan vi kommer att använda, vilka steg vi ska ta i planen och hur mycket data vi ska hantera. Det faktum att våra diskar, till exempel, kommer att belastas av något kommer att påverka tidpunkten. Men vi kan uppskatta hur krävande denna begäran är baserat på mängden data. Det är inte så viktigt att det samtidigt pågår något annat genomförande.
Jag har två frågor. Det här är riktigt coolt. Har det funnits fall där data som är kritiskt viktiga för produktion, som kreditkortsnummer? Finns det redan något färdigt eller är det en separat uppgift? Och den andra frågan – finns det något liknande för MySQL?
När det gäller data. Vi kommer att göra obfuskering, än så länge gör vi inte det. Men om du implementerar just Joe, och om du inte ger utvecklarna åtkomst, så finns det ingen åtkomst till data. Varför? För att Joe inte visar data. Han visar bara mätvärden, planer och så vidare. Det har gjorts medvetet eftersom det är ett av våra kunders krav. De ville kunna optimera utan att ge alla tillgång.
När det gäller MySQL. Detta system kan användas för vad som helst som lagrar tillstånd på disken. Eftersom vi arbetar med Postgres, fokuserar vi just nu på att automatisera allt för Postgres. Vi vill automatisera dataåterställning från backup. Vi konfigurerar Postgres korrekt. Vi vet hur man får planerna att stämma överens och så vidare.
Men eftersom systemet är utbyggbart kan det också användas för MySQL. Det finns liknande exempel. Det finns något liknande hos Yandex, men de publicerar det ingenstans. De använder det internt i Yandex.Metrika. Och där handlar det om MySQL. Men teknologierna är desamma, ZFS.
Tack för presentationen! Jag har också ett par frågor. Du nämnde att kloning kan användas för analys, till exempel för att bygga extra index. Kan du berätta lite mer om hur det fungerar?
Och jag ställer genast den andra frågan angående likheten mellan miljöerna, likheten i planerna. Planen beror delvis på statistiken som Postgres samlar. Hur löser ni det problemet?
Det finns ingen analys av specifika fall ännu, eftersom vi inte har använt det på det sättet, men det är möjligt. Om vi pratar om index, tänk dig att en fråga körs på en tabell med hundratals miljoner poster och i en kolumn som vanligtvis inte är indexerad i produktion. Och vi vill räkna ut något där. Om denna fråga körs i produktion finns det risk för att det blir stillestånd, eftersom frågan där kan ta en minut att bearbeta.
Okej, låt oss skapa en tunn klon som vi inte är rädda för att pausa i några minuter. För att enklare kunna räkna ut analysen, lägger vi till index på de kolumner där vi är intresserade av data.
Kommer indexet att skapas varje gång?
Vi kan göra så att vi rör vid datan, tar snapshots, och sedan återställer vi oss från denna snapshot och kör nya frågor. Det vill säga, vi kan göra så att vi kan skapa nya kloner med redan angivna index.
När det gäller frågan om statistik, om vi återställer från en säkerhetskopia, om vi gör replikation, så kommer vår statistik att vara exakt densamma. För vi kommer att få med hela den fysiska dataskukturen, det vill säga vi tar med datan som den är med alla statistiska mått.
Här är ett annat problem. Om ni använder en molnlösning, så finns det bara logiska dumpningar tillgängliga, eftersom Google och Amazon inte tillåter att ta en fysisk kopia. Där uppstår ett sådant problem.
Tack för presentationen. Här ställdes två bra frågor om MySQL och om resursfördelning. Men i grunden handlar allt om att det är ett ämne som inte rör specifika DBMS utan snarare filsystemet i stort. Och därmed bör frågorna om resursfördelning också lösas därifrån, inte i slutändan, att det handlar om Postgres, utan i filsystemet, i servern, i instansen.
Min fråga handlar om något annat. Den är mer inriktad på flerskiktstruktur av databasen, där det finns flera lager. Vi har till exempel ställt in uppdateringar av en tioterrabytesbild, vi har replikation igång. Och vi använder denna lösning specifikt för databaser. Replikationen pågår, datan uppdateras. Här arbetar parallellt 100 anställda som ständigt kör dessa olika snapshots. Vad ska vi göra? Hur gör vi så att det inte uppstår konflikter, att de kör en sak och sedan byts filsystemet ut, och dessa snapshots blir trasiga?
De kommer inte åka eftersom det är så ZFS fungerar. Vi kan hålla förändringar av filsystemet separat i en ström, som kommer tack vare replikation. Och vi kan behålla kloner av gamla data versioner, som utvecklarna använder. Och det fungerar för oss, det är inga problem med det.
Så uppdateringen kommer att ske som ett extra lager, och alla nya snapshots kommer att baseras på det lagret, eller hur?
Från de föregående lagren, som kom från tidigare replikationer.
De tidigare lagren kommer att släppas, men de kommer att referera till det gamla lagret, och de nya bilderna kommer att tas från det senaste lagret som fick under uppdateringen?
Rent allmänt, ja.
Då kommer vi, som en följd, att ha massor av lager. Och över tid måste vi komprimera dem?
Ja, det stämmer. Det finns ett fönster för detta. Vi sparar veckovisa snapshots. Det beror på vilka resurser du har. Om du har möjlighet att lagra mycket data kan du spara snapshots under en lång tid. De kommer inte att tas bort automatiskt. Det kommer inte att ske någon dataförlust. Om snapshots verkar vara föråldrade, vilket beror på företagets policy, kan vi helt enkelt ta bort dem och frigöra utrymme.
Hej, tack för presentationen! Angående Jo frågan. Du sa att kunden inte ville ge allmän tillgång till data. Rent tekniskt, om en person har resultatet av Explain Analyze, kan han se data.
Det är så. Till exempel kan vi skriva: "SELECT FROM WHERE email = något." Det vill säga, vi kommer inte att se själva datan, men vi kan se vissa indirekta tecken. Det är viktigt att förstå. Men å andra sidan är allt synligt. Vi har en logg över revisioner, och vi har kontroll över andra kollegor som också ser vad utvecklarna arbetar med. Och om någon försöker göra så, kommer säkerhetstjänsten att besöka dem och ta itu med frågan.
God morgon! Tack för presentationen! Jag har en kort fråga. Om Slack inte används i företaget, finns det någon koppling till det nu eller kan man för utvecklarna sätta upp instanser för att koppla testapplikationen till databaser?
Just nu finns det en koppling till Slack, dvs. det finns inga andra meddelandeappar, men vi skulle verkligen vilja stödja andra meddelandeappar också. Vad kan du göra? Du kan köra en DB Lab utan Joe, använda REST API eller vår plattform för att skapa kloner och ansluta med PSQL. Men det kan göras om du är villig att ge dina utvecklare åtkomst till data, eftersom det inte kommer att finnas något gränssnitt här.
Jag behöver inte det lagret, utan jag behöver den möjligheten.
Då – ja, det kan göras.
Källa: habr.com
