

Avkodning av Aleksey Lesovskiys föredrag från 2015 "En djupdykning i PostgreSQL:s interna statistik"
Ansvarsfriskrivning från föredragets författare: Jag vill påpeka att detta föredrag dateras till november 2015 — det har gått mer än 4 år och mycket har förändrats. Den version som behandlas i föredraget, 9.4, stöds inte längre. Under de senaste 4 åren har 5 nya versioner släppts, som har introducerat många nyheter, förbättringar och förändringar avseende statistik, varav en del material har blivit föråldrat och inte längre aktuellt. Under granskningen försökte jag markera dessa ställen för att inte vilseleda dig, läsare. Jag valde dock att inte skriva om dessa ställen; det finns alldeles för många, vilket skulle resultera i ett helt annat föredrag.
PostgreSQL-databashanteraren är en enorm mekanism, bestående av många delsystem vars samordnade arbete direkt påverkar databashanterarens prestanda. Under användningen samlas statistik och information om komponenternas arbete, vilket gör det möjligt att utvärdera PostgreSQL:s effektivitet och vidta åtgärder för att förbättra prestanda. Men informationen är omfattande och presenteras på ett ganska förenklat sätt. Att bearbeta denna information och tolka den är ibland en komplex uppgift, och "djurdjupet" av verktyg och verktyg kan lätt förvirra även en avancerad DBA.
God dag! Jag heter Aleksey. Som Ilya sa, kommer jag att berätta om statistik för PostgreSQL.
Statistik över PostgreSQL-aktivitet. PostgreSQL har två typer av statistik. Aktivitetstatistik, som kommer att diskuteras, och statistik från schemaläggaren om datadistribution. Jag kommer att fokusera på PostgreSQL:s aktivitetstatistik, som gör att vi kan bedöma prestandan och hur vi kan förbättra den.
Jag kommer att berätta hur man effektivt använder statistik för att lösa olika problem som kan uppstå för er.
Vad kommer inte att tas upp i föredraget? Jag kommer inte att beröra statistik från schemaläggaren, eftersom det är ett separat ämne för ett annat föredrag om hur data lagras i databasen och hur schemaläggaren får en uppfattning om kvalitativa och kvantitativa egenskaper hos dessa data.
Och det kommer inte att finnas några verktygsöversikter; jag kommer inte att jämföra en produkt med en annan. Det kommer inte att finnas någon reklam. Låt oss bortse från det.
Jag vill visa er att använda statistik är viktigt. Det är nödvändigt. Att använda den är inte skrämmande. Vi behöver bara vanlig SQL och grundläggande kunskaper om SQL.
Och vi kommer att prata om vilken statistik man ska välja för att lösa problem.
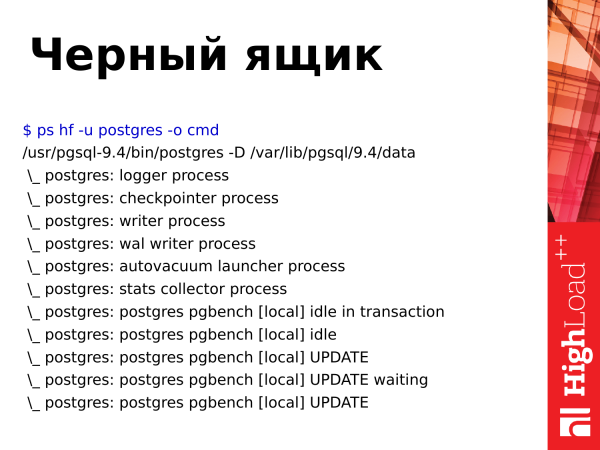
Om vi tittar på PostgreSQL och kör ett kommando i operativsystemet för att visa processer, ser vi en "svart låda". Vi ser några processer som gör något, och av namnet kan vi ungefär förstå vad de gör, vad de sysslar med. Men i grunden är det en svart låda, vi kan inte titta inuti.
Vi kan se belastningen på processorn i top, vi kan se minnesanvändningen med något systemverktyg, men vi kan inte titta in i PostgreSQL. För det behöver vi andra verktyg.
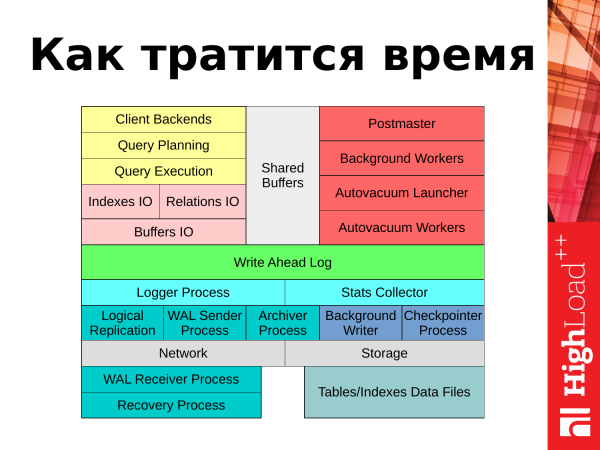
Och fortsätter vi så berättar jag var tiden går. Om vi föreställer oss PostgreSQL som ett schema, kan vi svara på var tiden går. Det handlar om två saker: det är bearbetning av klientförfrågningar från applikationer och bakgrundsuppgifter som PostgreSQL utför för att upprätthålla sin funktionalitet.
Om vi börjar i det övre vänstra hörnet kan vi följa hur klientförfrågningar behandlas. En förfrågan kommer från applikationen och för vidare arbete öppnas en klientsession. Förfrågan skickas till schemaläggaren. Schemaläggaren bygger en förfrågningsplan. Den skickas vidare för utförande. Någon form av blockbaserad in- och utdata med data relaterade till tabeller och index sker. Nödvändiga data läses från diskar till minnet i ett speciellt område "shared buffers". Resultaten av förfrågan, om det handlar om uppdateringar eller raderingar, registreras i transaktionsjournalen i WAL. Viss statistikinformation hamnar i loggen eller i statistikinsamlingsverktyget. Och resultatet av förfrågan ges tillbaka till klienten. Efter det kan klienten upprepa allt med en ny förfrågan.
Vad har vi med bakgrundsuppgifter och bakgrundsprocesser? Vi har flera processer som säkerställer funktionaliteten och håller databasen i normalt arbetsläge. Dessa processer kommer också att beröras i presentationen: autovacuum, checkpointer, processer relaterade till replikering, background writer. Var och en av dem kommer jag att ta upp allt eftersom presentationen framskrider.
Vilka problem finns det med statistiken?
- Det finns mycket information. PostgreSQL 9.4 tillhandahåller 109 metrik för att se statistikdata. Men om det finns många tabeller, scheman eller databaser i databasen, då måste alla dessa metrik multipliceras med motsvarande antal tabeller eller databaser. Det betyder att informationen blir ännu mer omfattande. Det är mycket lätt att drunkna i den.
- Det nästa problemet är att statistiken presenteras i form av räknare. Om vi ser på denna statistik kommer vi att se ständigt växande räknare. Om det har gått mycket lång tid sedan vi nollställde statistiken kommer vi att se miljardvärden. Och de säger oss ingenting.
- Det finns ingen historik. Om du har haft någon form av fel, något som föll för 15-30 minuter sedan, går det inte att använda statistiken för att se vad som hände då. Det är ett problem.
- Avsaknaden av ett inbyggt verktyg i PostgreSQL är ett problem. Kärnans utvecklare tillhandahåller ingen verktygslösning. De har inget sådant. De ger bara statistik i databasen. Använd det, gör en fråga, gör vad du vill.
- Eftersom det inte finns något inbyggt verktyg i PostgreSQL orsakar detta ett annat problem. Många tredjepartsverktyg. Varje företag med mer eller mindre kompetens försöker skriva sina egna program. Och resultatet är att det finns många verktyg i communityn som kan användas för att hantera statistik. Vissa verktyg har vissa funktioner, andra har inte dessa funktioner, eller så finns det nya funktioner. Det uppstår en situation där man behöver använda två, tre eller fyra verktyg som överlappar varandra och har olika funktioner. Det är mycket frustrerande.
Vad följer av detta? Det är viktigt att kunna hämta statistik direkt för att inte vara beroende av programvaror, eller på något sätt förbättra dessa program: lägga till funktioner för att få sin egen nytta.
Och grundläggande kunskaper i SQL är nödvändiga. För att få data från statistiken behöver man skriva SQL-frågor, det vill säga du måste veta hur man skriver select och join.
Statistiken erbjuder oss flera saker. Dessa kan delas upp i kategorier.
- Den första kategorin omfattar händelser som inträffar i databasen. Det är när en händelse inträffar i databasen: en förfrågan, åtkomst till en tabell, autovakuum, commits – allt detta är händelser. De motsvarande räknarna ökar. Vi kan spåra dessa händelser.
- Den andra kategorin avser egenskaper hos objekt som tabeller och databaser. De har egenskaper. Det handlar om storleken på tabellerna. Vi kan spåra tillväxten av tabeller och index. Vi kan se förändringar över tid.
- Den tredje kategorin avser den tid som spenderas på en händelse. En förfrågan är en händelse. Den har en specifik tidsmått. Här startade den, här slutade den. Vi kan spåra detta. Antingen tiden för att läsa en block från disken eller för att skriva. Sådana saker spåras också.
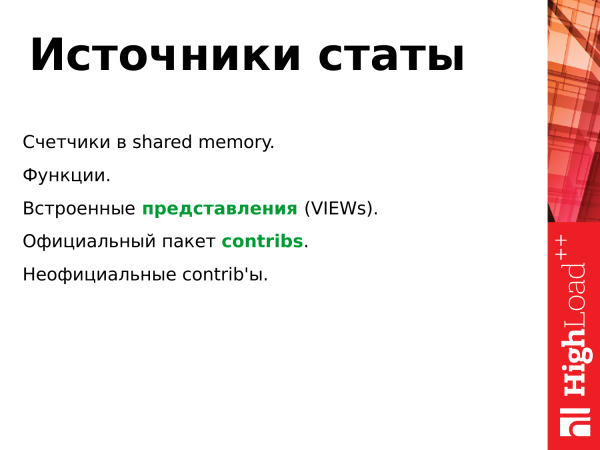
Statistikens källor presenteras på följande sätt:
- I det delade minnet (shared buffers) finns det ett segment för att lagra statiska data, där finns också de räknare som ständigt ökar när olika händelser inträffar, eller när det uppstår specifika situationer i databasens arbete.
- Alla dessa räknare är inte tillgängliga för användaren och inte ens för administratören. Det är lågnivåfunktioner. För att få åtkomst till dem tillhandahåller PostgreSQL ett gränssnitt i form av SQL-funktioner. Vi kan göra SELECT-frågor med hjälp av dessa funktioner och få en viss mätning (eller en uppsättning mätningar).
- Men det är inte alltid bekvämt att använda dessa funktioner, så funktionerna är grunden för vyer (VIEWs). Det är virtuella tabeller som tillhandahåller statistik för ett specifikt delsystem eller en uppsättning händelser i databasen.
- Dessa inbyggda vyer (VIEWs) är det primära användargränssnittet för att arbeta med statistik. De är tillgängliga som standard utan ytterligare konfiguration, du kan använda dem direkt, titta på dem, hämta information därifrån. Det finns också contrib-paket. Contrib-paketen är officiella. Du kan installera paketet postgresql-contrib (till exempel postgresql94-contrib), ladda in den nödvändiga modulen i konfigurationen, ange parametrar för den, starta om PostgreSQL och kan sedan använda det. (Obs. Beroende på distributionen är contrib-paketet i de senaste versionerna en del av huvudpaketet.).
- Det finns oofficiella contrib. De ingår inte i standardpaketet för PostgreSQL. De måste antingen kompileras eller installeras som ett bibliotek. Alternativen kan vara mycket olika, beroende på vad utvecklaren av den oofficiella contrib'en har hittat på.
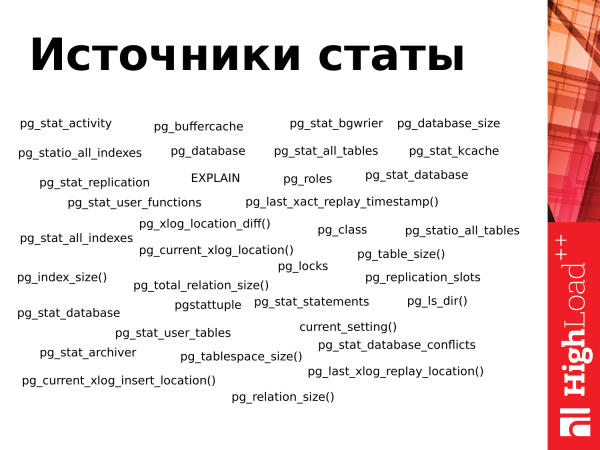
Denna bild visar alla de vyer (VIEWs) och en del av de funktioner som finns tillgängliga i PostgreSQL 9.4. Som vi ser finns det många. Det kan vara ganska lätt att bli förvirrad, om man stöter på detta för första gången.
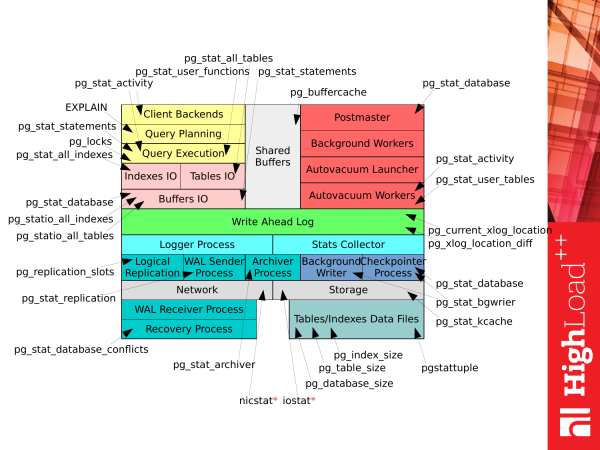
Men om vi tar bilden från tidigare Hur tid spenderas på PostgreSQL och jämför med denna lista, så får vi en sådan bild. Varje vy (VIEWs) eller varje funktion kan vi använda för olika ändamål för att få relevant statistik när PostgreSQL är igång. Och vi kan få viss information om subsystemets arbete.
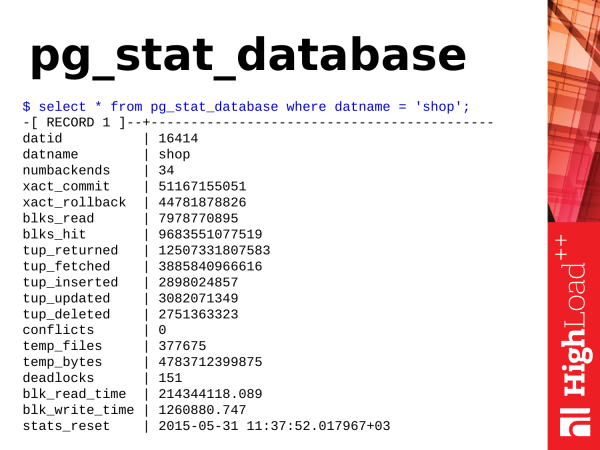
Det första vi kommer att titta på är pg_stat_database. Som vi ser är det en vy. Den innehåller mycket information. Mycket varierad information. Och den ger oss mycket nyttig kunskap om vad som händer i databasen.
Vad kan vi dra nytta av därifrån? Låt oss börja med de enklaste sakerna.
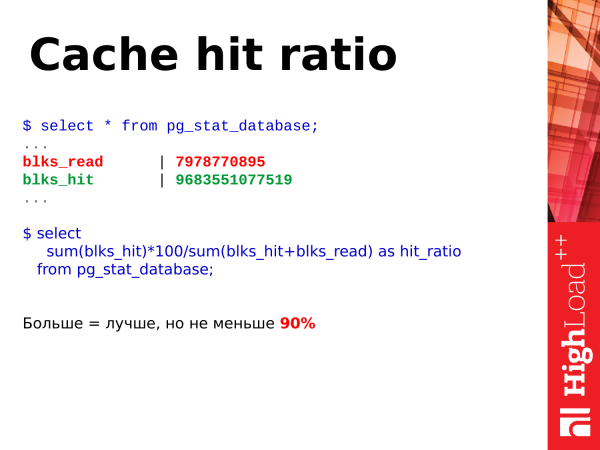
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
Det första vi kan se på är cache-hit-procenten. Cache-hit-procenten är en nyttig mätning. Den gör det möjligt att utvärdera hur mycket data som hämtas från shared buffers och hur mycket som läses från disk.
Det är uppenbart att ju fler träffar vi har i cachen, desto bättre. Vi bedömer denna mätning som en procent. Och till exempel, om vår procentsats för dessa träffar i cachen är över 90 %, så är det bra. Om den sjunker under 90 %, betyder det att vi inte har tillräckligt med minne för att hålla den heta "huvudet" av data i minnet. Och för att använda dessa data måste PostgreSQL vända sig till disken, vilket är långsammare än om data lästes från minnet. Och vi bör redan tänka på att öka minnet: antingen öka shared buffers eller uppgradera RAM.
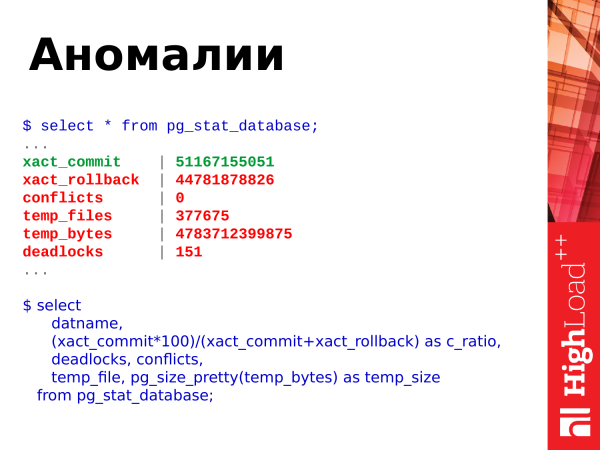
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Vad mer kan vi få från denna vy? Vi kan titta på anomalier som inträffar i databasen. Vad visas här? Här finns commits, rollbacks, skapande av temporära filer, deras storlek, deadlocks och konflikter.
Vi kan använda denna databasfråga. Denna SQL är ganska enkel. Och vi kan titta på dessa data själva.
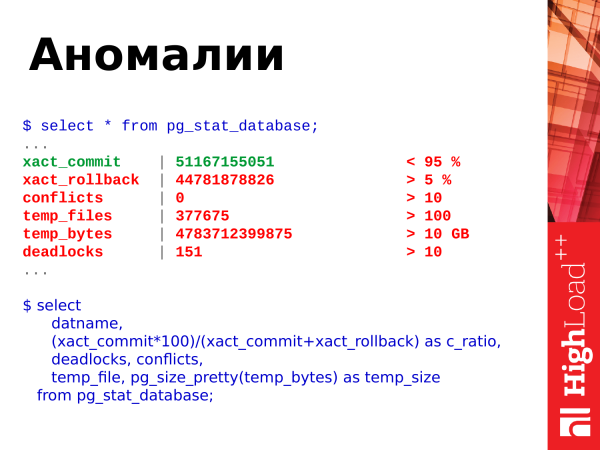
Och här är tröskelvärdena direkt. Vi ser förhållandet mellan commits och rollbacks. Commits – det är en framgångsrik bekräftelse av en transaktion. Rollbacks – det är återställning, dvs. transaktionen utförde något arbete, belastade databasen, beräknade något, och sedan inträffade ett fel och resultaten från transaktionen kasseras. Det vill säga... ett antal rollbacks, som konstant ökar, är dåligt. Och vi bör undvika dem på något sätt och justera koden för att förhindra att det inträffar.
Konflikter (conflicts) är relaterade till replikering. Och de bör också undvikas. Om du har några frågor som körs på en replik och konflikter uppstår, då behöver dessa konflikter hanteras, se vad som händer. Detaljer finns i loggarna. Och åtgärda konfliktsituationer så att applikationens förfrågningar fungerar utan fel.
Deadlocks – detta är också en dålig situation. När förfrågningar kämpar om resurser, en förfrågan tillgångar till en resurs och låser den, den andra förfrågan tillgångar till en annan resurs och låser den också, och sedan båda förfrågningarna tillgångar till varandras resurser och låser sig i väntan på att grannen släpper låset. Detta är också en problematisk situation. De måste lösas genom att omprogrammera applikationer och seriell tillgång till resurser. Och om du ser att dina deadlocks ökar konstant, behöver du titta på detaljerna i loggarna, analysera de uppkomna situationerna och se vad problemet är.
Tillfälliga filer (temp_files) – detta är också dåligt. När en användares förfrågan saknar minne för att lagra temporära data, skapar den en fil på disken. Och alla operationer som den skulle kunna utföra i det temporära minnet, börjar den nu utföra på disken. Detta är långsamt. Det ökar tiden för att utföra förfrågan. Och klienten som skickade förfrågan till PostgreSQL kommer få ett svar något senare. Om alla dessa operationer utfördes i minnet, skulle Postgres svara mycket snabbare och klienten skulle vänta mindre.
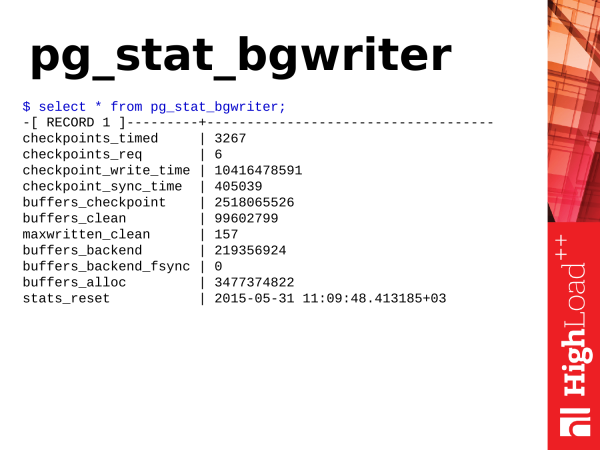
Pg_stat_bgwriter – detta vy beskriver arbetet hos två bakgrundssubsystem i PostgreSQL: det är checkpointer och background writer.
Först kommer vi att gå igenom kontrollpunkterna, så kallade. checkpoints. Vad är checkpoints? En checkpoint är en position i transaktionsloggen som meddelar att alla dataändringar som registrerats i loggen har synkroniserats framgångsrikt med datan på disken. Processen kan, beroende på arbetsbelastning och inställningar, ta tid och innebär främst synkronisering av smutsiga sidor i shared buffers med datarfilerna på disken. Varför är detta nödvändigt? Om PostgreSQL hela tiden skulle gå till disken för att hämta data och skriva data vid varje tillfälle, skulle det vara långsamt. Därför har PostgreSQL en minnessegment vars storlek beror på konfigurationens parametrar. Postgres placerar i detta minne aktiva data för efterföljande bearbetning eller vid behov. Vid dataändringsbegärningar ändras dessa data, och vi får två versioner av data. En version finns i minnet, den andra på disken. Och periodiskt behöver dessa data synkroniseras. Vi behöver synkronisera det som har ändrats i minnet till disken. För detta krävs checkpoint.
Checkpoint går igenom shared buffers, markerar smutsiga sidor som nödvändiga för checkpoint. Den startar sedan en andra genomgång av shared buffers. Och sidorna som är markerade för checkpoint synkroniseras redan. Så här utförs datasykronisering med disken.
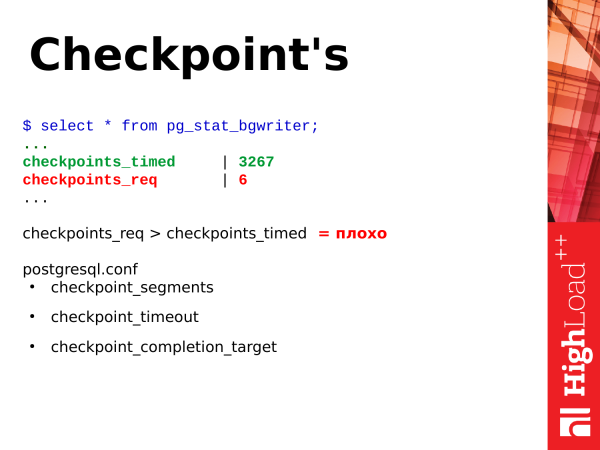
Det finns två typer av checkpoints. En checkpoint utförs vid tidsgräns. Detta är en användbar och bra checkpoint – checkpoint_timed. Och det finns checkpoints på begäran – checkpoint required. En sådan checkpoint inträffar när vi har mycket stora dataskrivningar. Vi har skrivit väldigt många transaktionsloggar. Och PostgreSQL anser att det är nödvändigt att synkronisera allt så snabbt som möjligt, göra en checkpoint och gå vidare.
Och om du har tittat på statistiken pg_stat_bgwriter och sett att du har checkpoint_req mycket fler än checkpoint_timed, så är det dåligt. Varför är det dåligt? Det betyder att PostgreSQL är i en ständig stressituation när det behöver skriva data till disken. Checkpoint vid tidsgräns är mindre stressande och utförs enligt ett internt schema och sprids över tid. PostgreSQL har möjlighet att göra pauser i arbetet och inte belasta lagringssystemet. Detta är bra för PostgreSQL. Och begärningar som utförs under en checkpoint kommer inte att uppleva stress av att lagringssystemet är upptaget.
Och för att justera checkpoint finns det tre parametrar:
checkpoint_segments.checkpoint_timeout.checkpoint_completion_target.
De gör det möjligt att justera arbetet med kontrollpunkter. Men jag kommer inte att gå djupare in på dem. Deras påverkan är ett eget ämne.
Observera: Den version som diskuteras i rapporten, 9.4, är redan föråldrad. I moderna versioner av PostgreSQL ersätts parameter checkpoint_segments med parametrarna min_wal_size och max_wal_size.
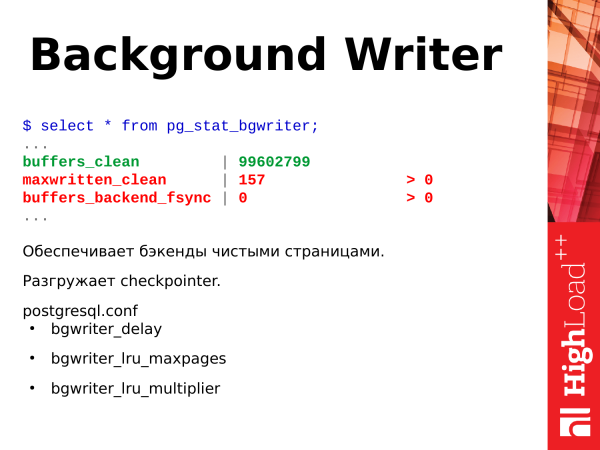
Den nästa delsystemet är bakgrundsskrivaren — background writer. Vad gör den? Den arbetar kontinuerligt i en oändlig slinga. Den skannar sidor i shared buffers och släpper de smutsiga sidor den hittar till disken. På så sätt hjälper den checkpointer:n att utföra mindre arbete under kontrollpunktsprocessen.
Vad behövs den för mer? Den tillhandahåller behovet av rena sidor i shared buffers ifall de skulle behövas (i stor mängd och omedelbart) för att lagra data. Anta att en situation uppstår där det krävs rena sidor för att utföra en förfrågan och de redan finns i shared buffers. Postgres backend tar bara dem och använder dem, den behöver inte städa något själv. Men om sådana sidor plötsligt inte finns, stannar backend arbetet och börjar leta efter sidor som de kan släppa till disken och ta för sina behov — vilket negativt påverkar tiden för den aktuella förfrågan. Om du ser att din parameter maxwritten_clean är stor, betyder det att bakgrundsskrivaren inte klarar av sitt arbete och att parametrarna bgwriter_lru_maxpages, behöver ökas så att den kan göra mer arbete och städa fler sidor under ett cykel.
Och en annan mycket användbar indikator – det är buffers_backend_fsync. Backend gör ingen fsync eftersom det är långsamt. De överför fsync högre upp i IO-stacken till checkpointer:n. Checkpointer:n har sin egen kö, han behandlar fsync periodiskt och synkroniserar sidor i minnet med filer på disken. Om kön är stor för checkpointer:n och fylld, måste backend göra fsync själv och det saktar ner backendens arbete, vilket innebär att klienten får svar senare än den annars skulle ha gjort. Om du ser att detta värde är större än noll, är det redan ett problem och du bör uppmärksamma inställningarna för bakgrundsskriver och även utvärdera prestandan i diskdelssystemet.
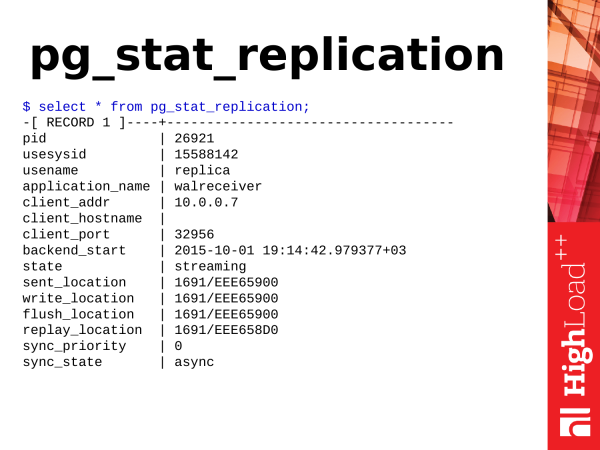
Observera: _Texten nedan beskriver statistiska representationer kopplade till replikering. Största delen av namnen för representationer och funktioner har döpts om i Postgres 10. Kärnan i dessa omdöpningar handlar om att ersätta xlog till wal och plats till lsn i namnen på funktioner/representationer m.m. Ett specifikt exempel är funktionen pg_xlog_location_diff() som har döpts om till pg_wal_lsn_diff()._
Här har vi också mycket, men vi behöver bara punkterna kopplade till plats.
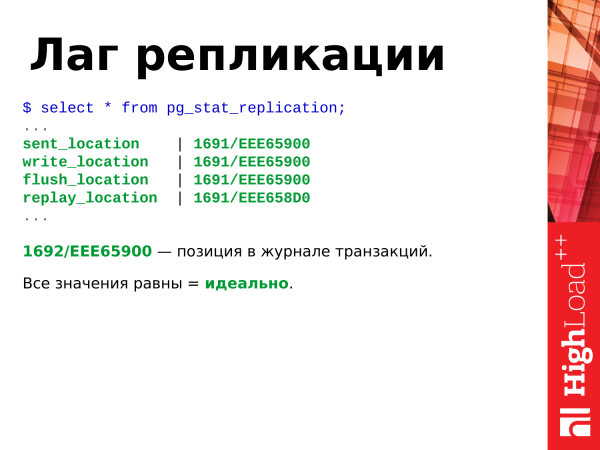
Om vi ser att alla värden är lika, är det en idealisk situation och replikationen ligger inte efter huvudservern.
Denna hexadecimala position är positionen i transaktionsloggen. Den ökar ständigt om det finns någon aktivitet i databasen: insert, delete, etc.
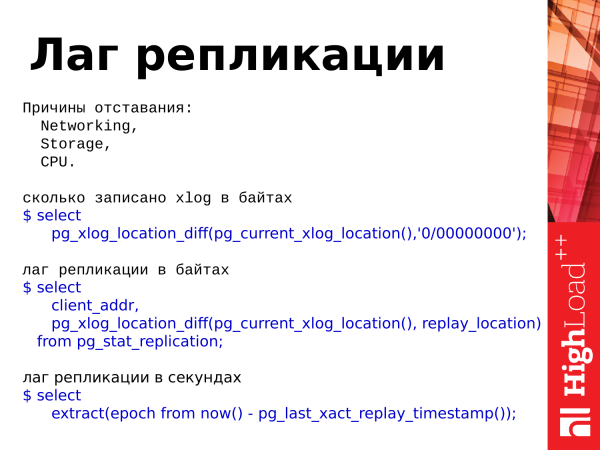
hur mycket xlog som skrivits i byte
$ select
pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000');
replikationslagret i byte
$ select
client_addr,
pg_xlog_location_diff(pg_current_xlog_location(), replay_location)
from pg_stat_replication;
replikationslagret i sekunder
$ select
extract(epoch from now() - pg_last_xact_replay_timestamp());
Om dessa saker skiljer sig åt, finns det en fördröjning. Fördröjningen är en avvikelse mellan replikaten och huvudservern, dvs. data skiljer sig mellan servrarna.
Det finns tre orsaker till avvikelsen:
- Det är diskundersystemet som inte klarar av att skriva synkronisering av filer.
- Det kan vara nätverksproblem, eller överbelastning av nätverket, då data inte hinner fram till replikaten och den inte kan återge dem.
- Och processorn. Processorn är en mycket sällsynt orsak. Jag har sett det två eller tre gånger, men det kan också hända.
Och här är tre frågor som gör att vi kan använda statistiken. Vi kan uppskatta hur mycket som skrivits i transaktionsloggen. Det finns en funktion pg_xlog_location_diff och vi kan uppskatta replikationslagret i byte och sekunder. Det använder vi också värden från denna vy (VIEWs).
Anmärkning: _Istället för pg_xlog_locationdiff() funktionen kan vi använda subtraktionsoperatorn och subtrahera en plats från en annan. Det är bekvämt.
Med fördröjningen i sekunder finns det en sak att notera. Om det inte sker någon aktivitet på huvudservern, och transaktionen var för typ 15 minuter sedan utan aktivitet, och om vi kollar på denna fördröjning på replikatet, så ser vi en fördröjning på 15 minuter. Detta är värt att komma ihåg. Det kan vara förvirrande när du tittar på denna fördröjning.
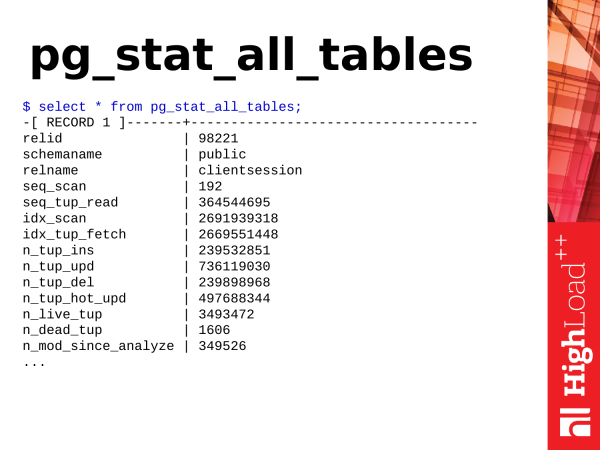
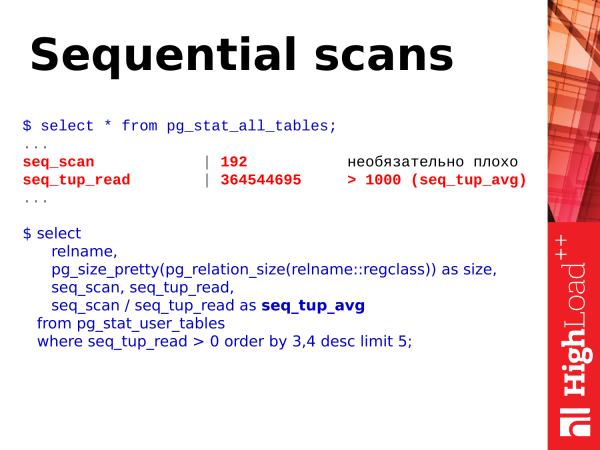
Pg_stat_all_tables – ännu en användbar vy. Den visar statistik över tabeller. När vi har tabeller i databasen, med viss aktivitet eller åtgärder, kan vi få denna information från denna vy.
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
Det första vi kan titta på är sekventiella skanningar av tabellen. Själva siffran efter dessa genomgångar är ännu inte nödvändigtvis dålig och inte en indikation på att vi behöver göra något.
Men det finns en andra metrik – seq_tup_read. Detta är antalet rader som returneras som ett resultat av sekventiell skanning. Om det genomsnittliga antalet överstiger 1 000, 10 000, 50 000 eller 100 000, är det en indikation på att du kanske behöver bygga ett index någonstans för att åtkomster ska gå via indexet, eller kanske optimera de frågor som använder sådana sekventiella skanningar för att undvika detta.
Ett enkelt exempel – låt oss säga att en fråga med stort OFFSET och LIMIT står. Till exempel skannar den 100 000 rader i tabellen och efter det hämtar 50 000 nödvändiga rader, medan de tidigare skannade raderna förkastas. Detta är också ett dåligt fall. Och sådana frågor behöver optimeras. Här är en sådan enkel SQL-fråga där man kan titta på detta och utvärdera de erhållna siffrorna.
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
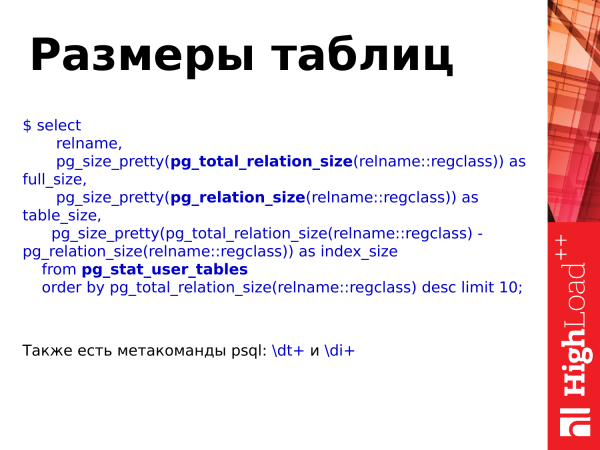
Tabellstorlekar kan också erhållas med hjälp av denna vy och med hjälp av ytterligare funktioner. pg_total_relation_size(), pg_relation_size().
Generellt finns det metakommandon dt och di, som kan användas i PSQL för att också se storlekarna på tabeller och index.
Men att använda funktioner hjälper oss att se tabellstorlekarna med eller utan beaktande av index och redan göra vissa uppskattningar baserat på databastillväxt, det vill säga hur den växer, med vilken intensitet och redan dra slutsatser om storleksoptimering.
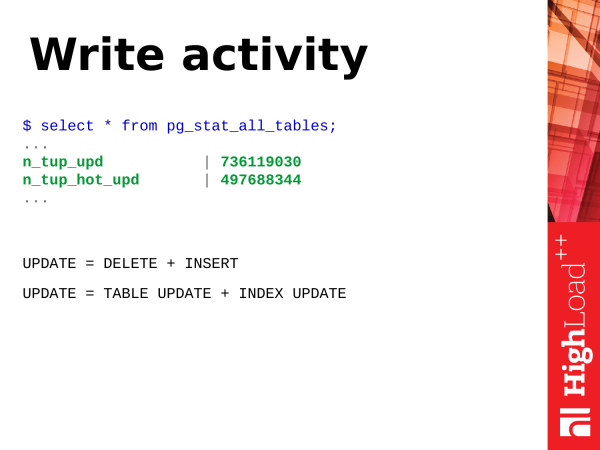
Skrivaktivitet. Vad är skrivning? Låt oss titta på operationen. UPPDATERA – operation update av rader i tabellen. I grund och botten är update två operationer (eller fler). Det handlar om att sätta in en ny version av raden och markera den gamla versionen av raden som föråldrad. Senare kommer autovacuum att rensa dessa föråldrade versioner av raderna och markera detta utrymme som tillgängligt för återanvändning.
Dessutom är update inte bara en uppdatering av tabellen. Det innebär också en uppdatering av index. Om du har många index på tabellen, måste alla index där de uppdaterade fälten ingår också uppdateras vid update. I dessa index kommer det även att finnas föråldrade versioner av raderna som behöver rensas.
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
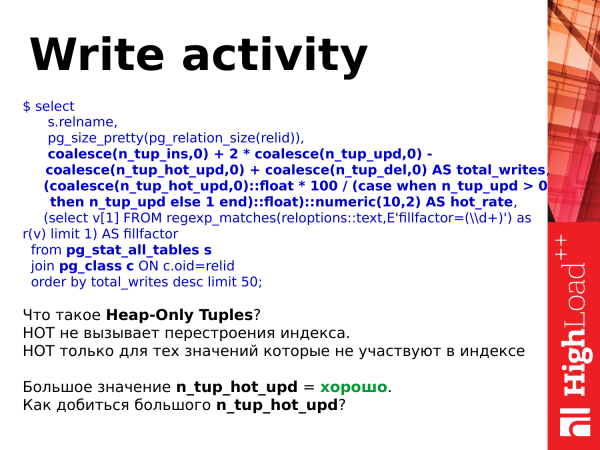
Och på grund av sin design är UPDATE – tunga operationer. Men de kan göras lättare. Det finns hot updates. De introducerades i PostgreSQL version 8.3. Och vad är det? Det är en lättvikts update som inte orsakar ombyggnad av index. D.v.s. vi uppdaterade posten, men endast posten på sidan (som tillhör tabellen) uppdaterades, medan index fortfarande pekar på samma post på sidan. Det finns en intressant logik här, när vacuum kommer, så omorganiserar den dessa kedjor hot och allt fortsätter att fungera utan att indexen uppdateras, vilket sker med mindre resursanvändning.
Och när du har n_tup_hot_upd stort, då är det väldigt bra. Det betyder att lätta uppdateringar dominerar och det blir billigare för oss i resurser och allt fungerar perfekt.
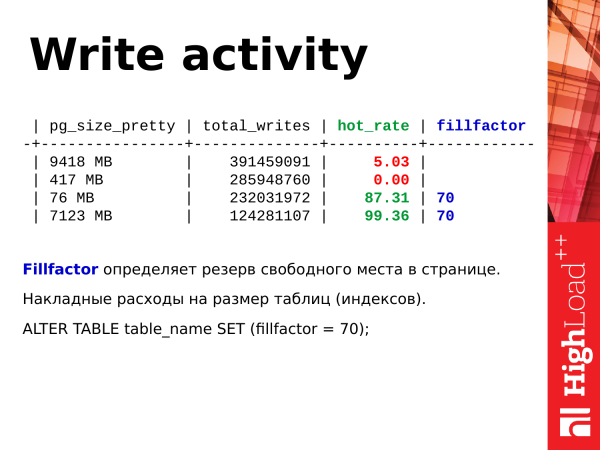
ALTER TABLE table_name SET (fillfactor = 70);Hur ökar vi volymen av hot updates? Vi kan använda fillfactor. Den definierar storleken på det reserverade fria utrymmet när sidan i tabellen fylls med INSERT-ar. När data sätts in i tabellen, fyller de helt sidan utan att lämna något ledigt utrymme. Sedan allokeras en ny sida. Återigen fylls data. Och detta beteende är standard, fillfactor = 100 %.
Vi kan ställa in fillfactor på 70 %. Det vill säga när det görs insert kommer en ny sida att allokeras, men endast 70 % av sidan kommer att fyllas. Och 30 % är kvar som reserv. När vi behöver göra en uppdatering, så kommer den med hög sannolikhet att ske på samma sida, och den nya versionen av raden kommer att placeras på samma sida. En hot_update kommer att göras. På så sätt underlättas skrivningen på tabellerna.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
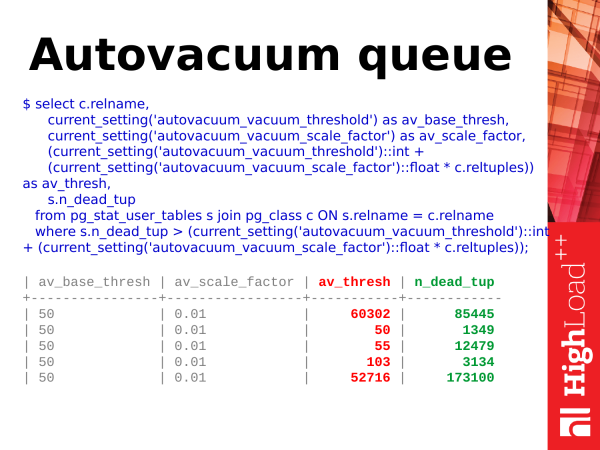
Kö för avhysning. Avhysning är ett system där statistiken i PostgreSQL är mycket begränsad. Vi kan endast se hur länge våra avhysningar pågår just nu i tabellerna pg_stat_activity. Men att förstå hur många tabeller som är i kön är mycket svårt.
Anmärkning: _Sedan version 10 av Postgres har situationen med övervakning av avhysning förbättrats avsevärt — en visning av pg_stat_progress har tillkommit.vacuum, vilket väsentligt förenklar frågan om övervakning av avhysning.
Vi kan använda en förenklad fråga. Och vi kan se när avhysning ska göras. Men hur och när ska avhysningen starta? Det handlar om de utdaterade versionerna av raderna som jag nämnde tidigare. En uppdatering har skett, en ny version av raden har lagts till. En utdaterad version av raden har uppstått. I tabellen pg_stat_user_tables finns det en parameter n_dead_tup. Den visar antalet "döda" rader. Och så snart antalet döda rader överstiger en viss tröskel kommer avhysningen att sättas in.
Och hur beräknas denna tröskel? Det är en helt specifik procentandel av det totala antalet rader i tabellen. Det finns en parameter autovacuum_vacuum_scale_factor. Den definierar procentandelen. Anta att det är 10 % + en extra grundtröskel på 50 rader. Vad händer då? När vi har fler döda rader än "10 % + 50" av alla rader i tabellen, så sätts tabellen på avhysning.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
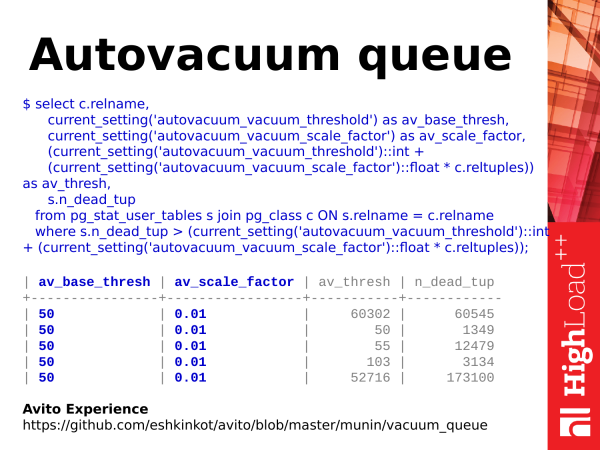
Men här finns en aspekt. Grundtröskeln för parametrarna av_base_thresh och av_scale_factor kan tillsättas individuellt. Och därför kommer tröskeln inte att vara global, utan individuell för tabellen. Därför, för att beräkna, behöver vi använda knep och trix. Och om du är intresserad kan du titta på erfarenheterna från våra kollegor på Avito (länken på bilden är ogiltig och har uppdaterats i texten).
De skrev för , som tar hänsyn till dessa saker. Det finns en lunta på två sidor. Men den räknar korrekt och gör det ganska effektivt möjligt att bedöma var vi har mycket vakuum som behövs för tabeller, där det är lite.
Vad kan vi göra med detta? Om vi har en stor kö och autovacuum inte räcker till, kan vi öka antalet vakuumarbetare, eller helt enkelt göra vakuumet mer aggressivt, så att det triggas tidigare, och bearbetar tabellen i små bitar. Och på så sätt kommer kön att minska. — Det huvudsakliga här är att övervaka belastningen på diskarna, eftersom vakuum är en kostsam åtgärd, även om problemet har blivit mindre märkbar med introduktionen av SSD/NVMe-enheter.
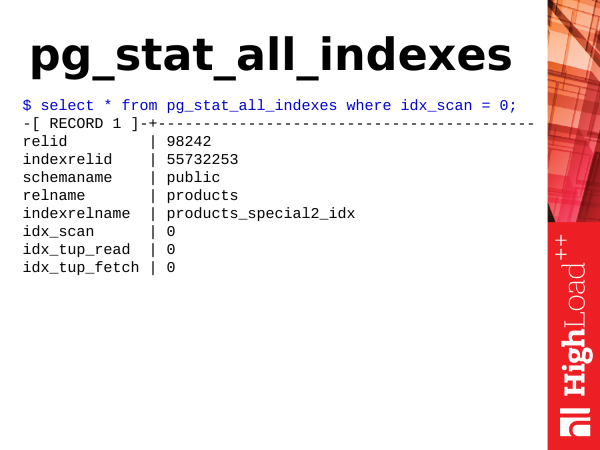
Pg_stat_all_indexes – detta är statistik över index. Den är liten. Och vi kan få information om användningen av index därifrån. Och till exempel kan vi avgöra vilka index som är överflödiga.
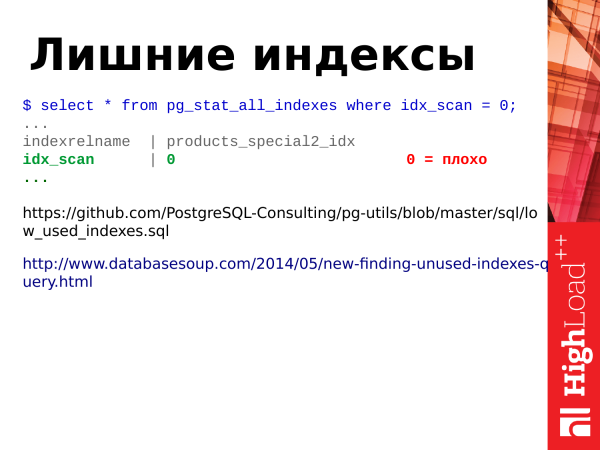
Som jag redan nämnt, uppdatera – det är inte bara en uppdatering av tabeller, utan det handlar också om att uppdatera index. Därför, om vi har många index på tabellen, måste de indexerade fälten också uppdateras när vi uppdaterar rader i tabellen, och om vi har oanvända index som inte har några indexskanningar, så hänger de kvar som ballast. Och vi måste bli av med dem. För detta behöver vi fältet idx_scan. Vi kollar bara antalet indexskanningar. Om indexen har noll skanningar under en relativt lång statistikperiod (minst 2-3 veckor), så är det troligtvis dåliga index och vi behöver bli av med dem.
Anmärkning: Vid sökning efter oanvända index i fallet med kluster av strömreplikering behöver vi kolla alla noder i klustret, eftersom statistiken inte är global, och om ett index inte används på huvudservern, kan det användas på repliker (om det finns belastning där).
Två länkar:
Detta är mer avancerade exempel på frågor för att söka efter oanvända index.
Den andra länken är en ganska intressant förfrågan. Det finns ganska otraditionell logik inbäddad. Jag rekommenderar att du kollar på den.
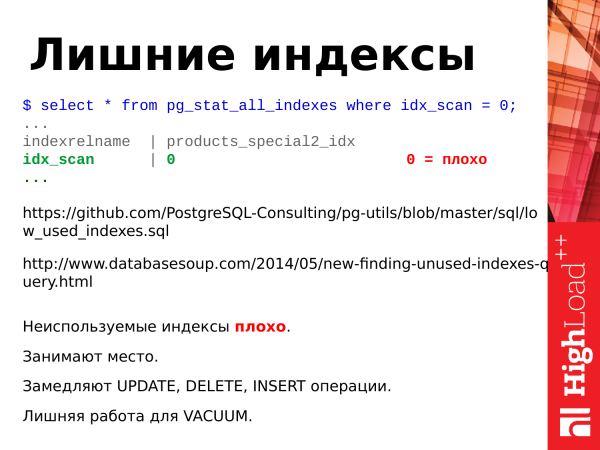
Vad bör vi sammanfatta angående index?
Oanvända index är dåliga.
De tar upp plats.
De saktar ner uppdateringsoperationer.
Det är onödig arbetsbelastning för vacuum.
Om vi tar bort oanvända index gör vi bara databasen bättre.
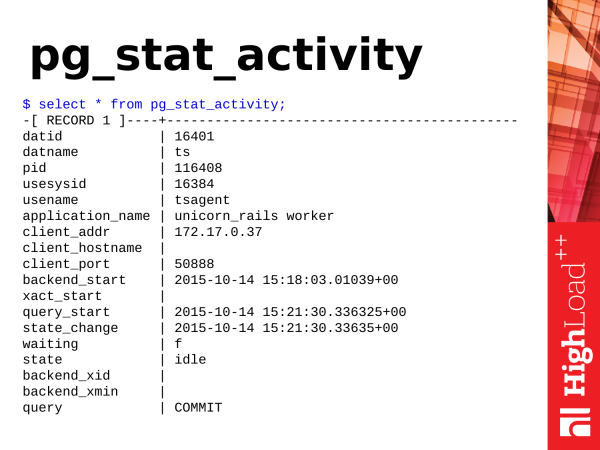
Den nästa visningen är pg_stat_activity. Det är en motsvarighet till verktyget ps, endast i PostgreSQL. Om psdu tittar på processer i operativsystemet, så pg_stat_activity visar det aktiviteten inom PostgreSQL.
Vad kan vi få ut som är användbart därifrån?
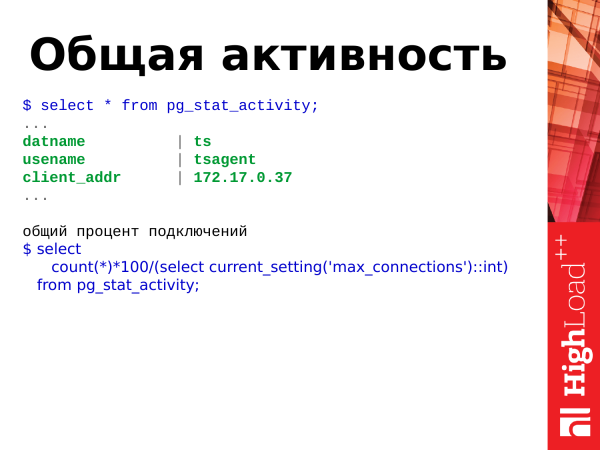
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Vi kan se den totala aktiviteten, vad som händer i databasen. Vi kan göra en ny distribution. Allt har sprängt, nya anslutningar tas inte emot, fel strömmar in i applikationen.
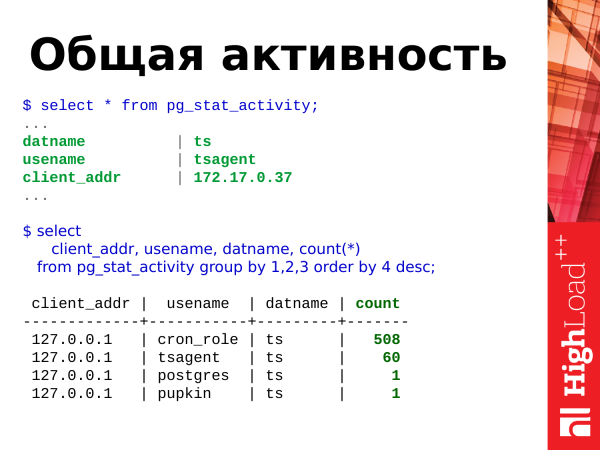
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Vi kan köra en sådan förfrågan och se den totala procentandelen av anslutningar i förhållande till den maximala anslutningsgränsen och se vem som tar upp flest anslutningar. I det här exemplet ser vi att användare cron_role har öppnat 508 anslutningar. Och något har hänt med denne. Vi behöver undersöka det och troligen är det en anomali med antalet anslutningar.
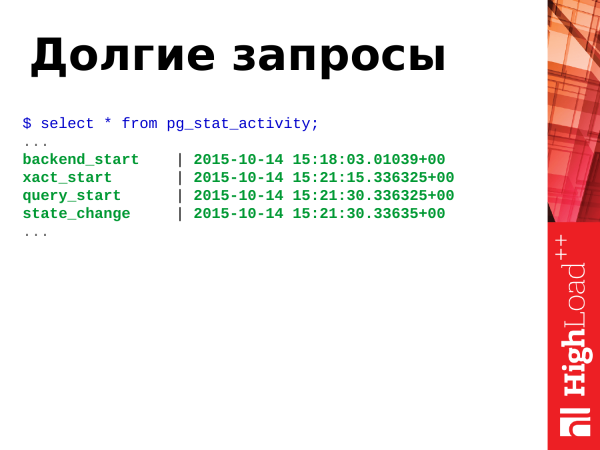
Om vi har OLTP-belastning bör förfrågningarna köras snabbt, mycket snabbt, och det bör inte finnas några långa förfrågningar. Men om det uppstår långa förfrågningar, är det inte så farligt på kort sikt, men på lång sikt skadar långa förfrågningar databasen, de ökar bloat-effekten för tabeller när tabeller fragmenteras. Både bloat och långa förfrågningar bör vi bli av med.
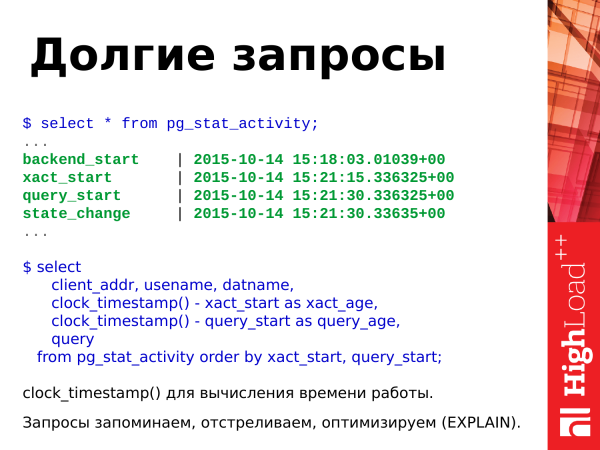
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Observera: med en sådan förfrågan kan vi identifiera långa förfrågningar och transaktioner. Vi använder funktionen clock_timestamp() för att bestämma hur länge de har varit aktiva. De långa förfrågningarna vi hittar kan vi memorera, köra explain, se planerna och optimera på något sätt. De aktuella långa förfrågningarna avbryter vi och fortsätter sedan.
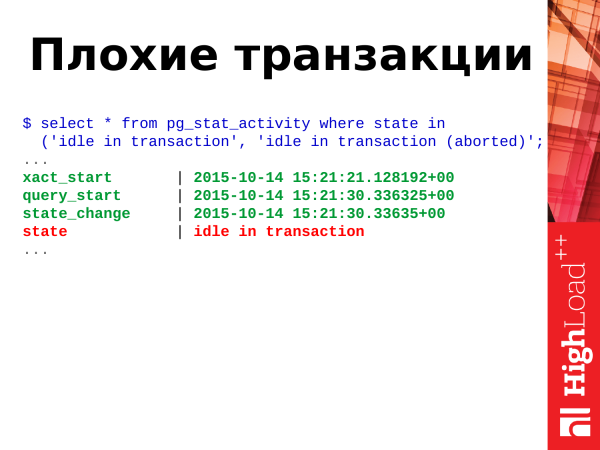
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Dåliga transaktioner är transaktioner i tillståndet idle in transaction och idle in transaction (aborted).
Vad betyder det? Transaktioner har flera tillstånd. Och ett av dessa tillstånd kan tas när som helst. För att bestämma tillstånden finns det ett fält state i denna vy. Och vi använder det för att bestämma tillståndet.
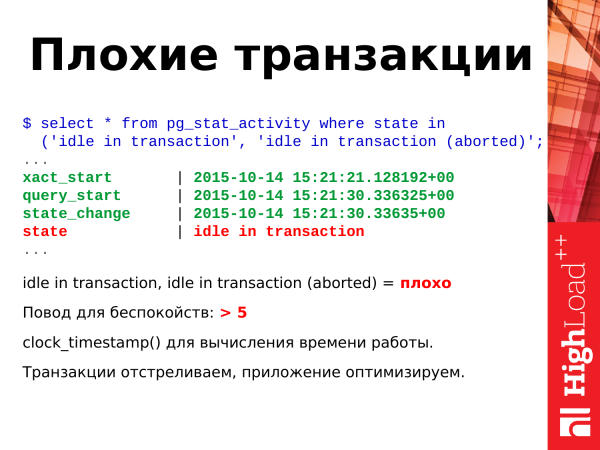
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Och, som jag nämnde ovan, dessa två tillstånd idle in transaction och idle in transaction (aborted) – detta är dåligt. Vad innebär det? Det är när en applikation har öppnat en transaktion, gjort någon åtgärd och sedan gått vidare med sina ärenden. Transaktionen förblir öppen. Den hänger, ingenting händer i den, den tar upp en anslutning, låser de ändrade raderna och potentiellt ökar även bloat hos andra tabeller, på grund av strukturen i transaktionsmotorn Postgres. Och sådana transaktioner bör också avslutas, för de är skadliga under alla omständigheter.
Om du ser att de har blivit fler än 5-10-20 i din databas, är det dags att bli orolig och börja ta itu med dem.
Här använder vi också för beräkningstiden clock_timestamp(). Vi avslutar transaktioner, optimerar applikationen.
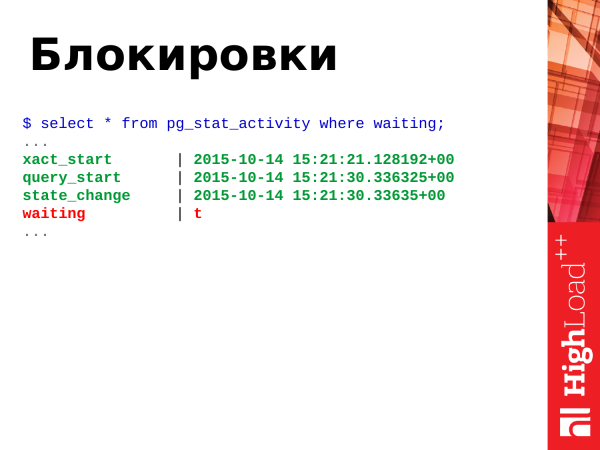
Som jag nämnde tidigare, låsningar – det är när två eller fler transaktioner slåss om en eller flera resurser. För detta har vi fältet waiting med ett booleskt värde true eller false.
True – det betyder att processen är i vänteläge, något måste göras. När processen är i vänteläge, betyder det att klienten som initierade denna process också väntar. Klienten i webbläsaren sitter och väntar.
Observera: _Från och med version Postgres 9.6 har fältet waiting tagits bort och istället har två mer informativa fält lagts till wait_event_type och wait_event._
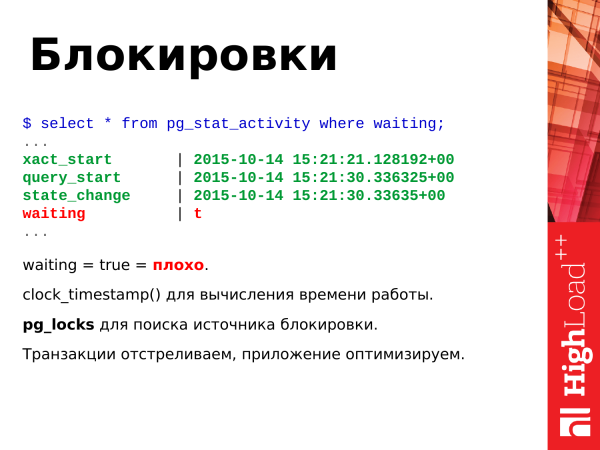
Vad göra? Om du ser true under lång tid, betyder det att sådana förfrågningar måste elimineras. Vi avslutar helt enkelt sådana transaktioner. Vi informerar utvecklarna om att något måste optimeras för att undvika resurskonflikter. Och vidare optimerar utvecklarna applikationen för att sådant inte ska inträffa.
Och det sista, men potentiellt inte fatala fallet – det är uppkomsten av deadlocks. Två transaktioner har uppdaterat två resurser, sedan återkommer de till dessa resurser igen, nu till motsatta resurser. PostgreSQL tar i detta fall och avslutar själv transaktionen, så att den andra kan fortsätta arbeta. Det är en dödläge-situation och den löser sig inte själv. Därför tvingas PostgreSQL vidta extrema åtgärder.
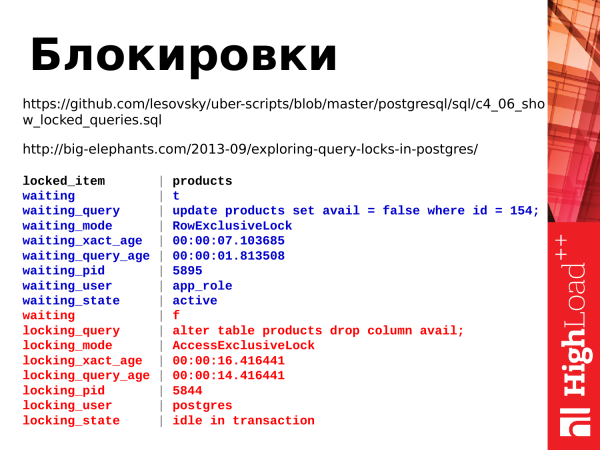
Och här är två frågor som tillåter oss att spåra låsningar. Vi använder vyn pg_locks, som gör det möjligt att spåra tunga lås.
Och den första länken är själva förfrågnings texten. Den är ganska lång.
Och den andra länken är en artikel om lås. Den är bra att läsa, den är mycket intressant.
Så, vad ser vi? Vi ser två förfrågningar. En transaktion med ALTER TABLE – det är en blockerande transaktion. Den har startat men inte avslutats och applikationen som startade denna transaktion håller på med andra saker. Och den andra förfrågan är update. Den väntar på att alter table ska avslutas för att fortsätta sitt arbete.
På det här sättet kan vi ta reda på vem som låser vem, håller och vi kan fortsätta hantera det.
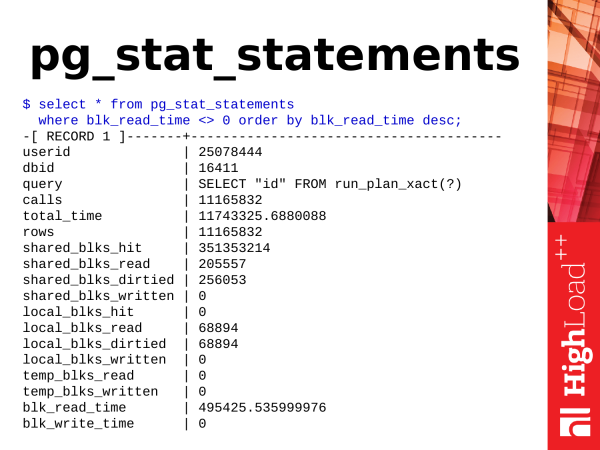
Nästa modul är pg_stat_statements. Som jag redan har sagt, är det en modul. För att använda den måste vi ladda dess bibliotek i konfigurationerna, starta om PostgreSQL, installera modulen (med ett kommando) och därefter får vi en ny vy.
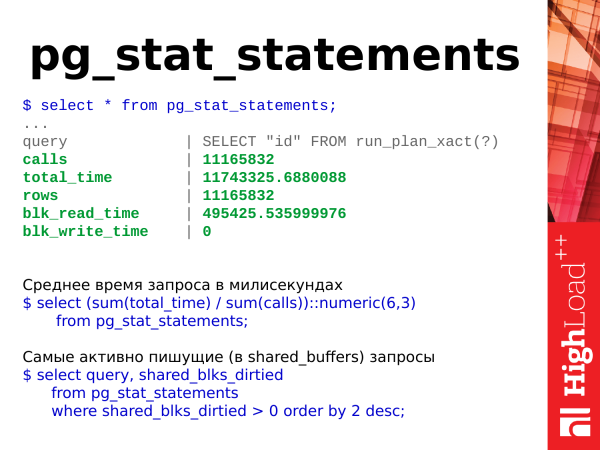
Genomsnittlig förfrågnings tid i millisekunder
$ select (sum(total_time) \/ sum(calls))::numeric(6,3)
from pg_stat_statements;

De mest aktiva skrivförfrågningarna (i shared_buffers)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Vad kan vi få därifrån? Om vi pratar om enkla saker kan vi få den genomsnittliga tiden för genomförande av en förfrågan. Tiden ökar, vilket betyder att vår PostgreSQL svarar långsamt och vi måste vidta åtgärder.
Vi kan titta på de mest aktiva skrivtransaktionerna i databasen som ändrar data i shared buffers. Titta på vem som uppdaterar eller tar bort data.
Och vi kan helt enkelt titta på olika statistik från dessa förfrågningar.
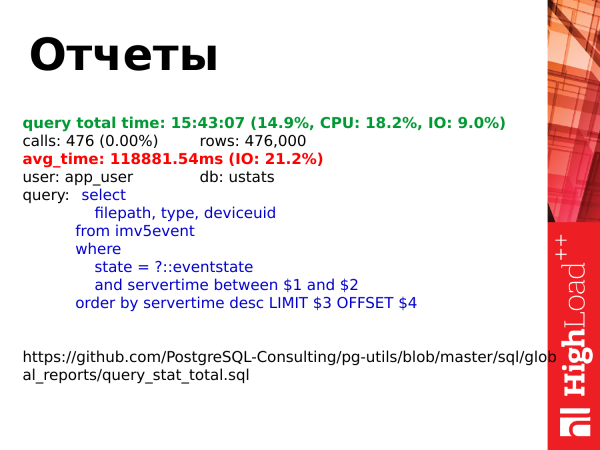
Vi pg_stat_statements använder vi för att skapa rapporter. En gång om dagen nollställer vi statistiken. Vi samlar på oss den. Innan vi nollställer statistiken nästa gång, skapar vi en rapport. Här är länken till rapporten. Du kan titta på den.
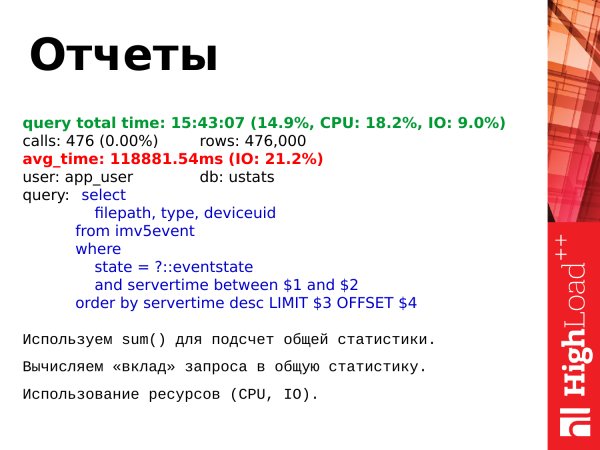
Vad gör vi? Vi räknar den totala statistiken för alla förfrågningar. Sedan beräknar vi varje förfrågnings individuella bidrag till denna totala statistik.
Och vad kan vi titta på? Vi kan se den totala tiden för genomförande av alla förfrågningar av en viss typ jämfört med alla andra förfrågningar. Vi kan se resursanvändning av CPU och in/ut-övergripande bild. Och redan optimera dessa förfrågningar. Vi bygger topplistor baserade på denna rapport och får redan mat för eftertanke om vad som ska optimeras.
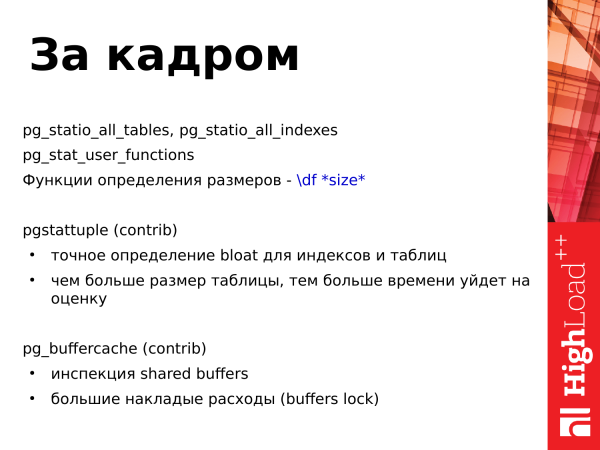
Vad har vi kvar bakom kulisserna? Det finns fortfarande några presentationer kvar som jag inte har tagit upp eftersom tiden är begränsad.
Det finns pgstattuple – det är också en ytterligare modul från standardpaketet contribs. Den gör det möjligt att bedöma bloat tabeller, så kallad tabellfragmentering. Och om fragmenteringen är stor måste vi ta bort den, använda olika verktyg. Och funktionen pgstattuple tar lång tid. Ju fler tabeller, desto längre tid kommer den att ta.
Nästa contrib är pg_buffercache. Den gör det möjligt att inspektera delade buffrar: hur intensivt och under vilka tabeller sidor i buffern utnyttjas. Och den låter helt enkelt titta in i de delade buffrarna och bedöma vad som händer där.
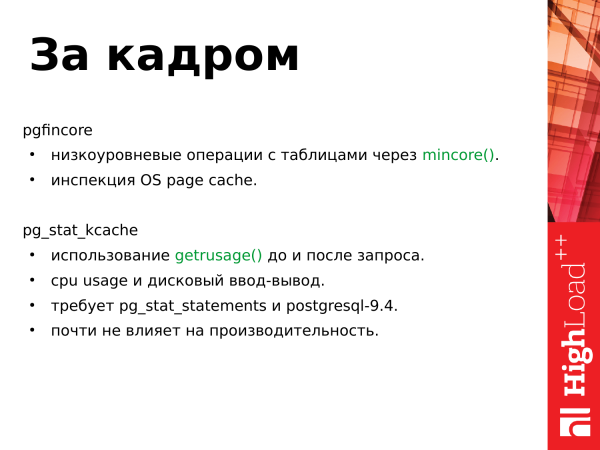
Nästa modul är pgfincore. Den utför lågnivåoperationer med tabeller genom systemanropet mincore(), det vill säga den gör det möjligt att ladda en tabell i delade buffrar eller att avlägsna den. Den tillåter även att inspektera sidcacheminnet i operativsystemet, det vill säga hur mycket utrymme vår tabell tar i page cache, i delade buffrar och låter oss helt enkelt bedöma belastningen på tabellen.
Nästa modul är pg_stat_kcache. Den använder också systemanropet getrusage(). Och utför det före och efter att förfrågan har körts. Och i den resulterande statistiken gör det möjligt att bedöma hur mycket vår förfrågan kostade i disk I/O, det vill säga operationer med filsystemet, och ser på processoranvändningen. Dock är modulen ung (eh-eh) och för sin funktion kräver den PostgreSQL 9.4 och pg_stat_statements, som jag nämnde tidigare.
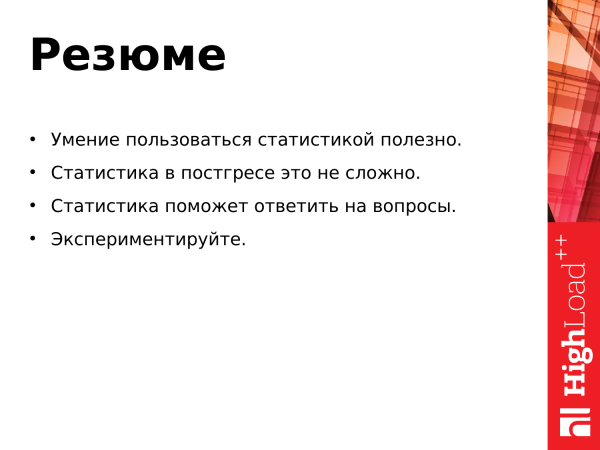
Att kunna använda statistiken är nyttigt. Du behöver inga externa program. Du kan själv kika in, se något, göra något, utföra.
Det är inte svårt att använda statistiken, det är vanlig SQL. Du samlar en förfrågan, formar den, skickar den, tittar.
Statistik hjälper till att besvara frågor. Om du har frågor, vänder du dig till statistiken – kollar, drar slutsatser, analyserar resultaten.
Och experimentera. Det finns många förfrågningar, mycket data. Det går alltid att optimera en redan existerande förfrågan. Du kan göra din egen version av en förfrågan som passar dig bättre än originalet och använda den.
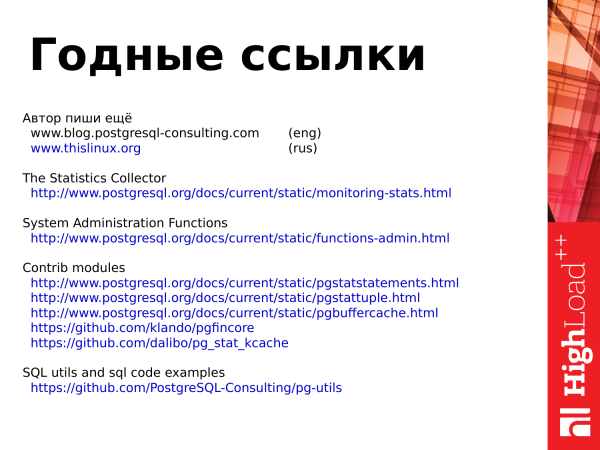
Länkar
Bra länkar som fanns i artikeln som låg till grund för föredraget.
Författaren skriver mer
(eng)
Statistikinsamlaren
Systemadministrationsfunktioner
Contrib-moduler
SQL-verktyg och sql kodexempel
Tack för uppmärksamheten, alla!
Källa: habr.com
