

I föresparingarna inför lanseringen av den nya kursströmmingen har vi förberett en översättning av intressant material.
Översikt
Vi kommer att prata om ett populärt mönster där applikationer använder flera datalager, där varje lager används för specifika ändamål, till exempel för lagring av kanonisk datavy (MySQL osv.), för att möjliggöra avancerad sökning (ElasticSearch osv.), för cachelagring (Memcached osv.) och andra. Vanligtvis fungerar ett datalager som huvudlager medan andra fungerar som underordnade lager. Det enda problemet är hur dessa datalager ska synkroniseras.
Vi har granskat ett antal olika mönster för att lösa problemet med att synkronisera flera lager, såsom dubbelskrivning, distribuerade transaktioner osv. Men dessa angreppssätt har betydande begränsningar när det gäller praktisk användning, tillförlitlighet och underhåll. Förutom datasynkronisering behöver vissa applikationer också berika data genom att anropa externa tjänster.
För att lösa dessa problem utvecklades Delta. Delta är i grunden en sammanhängande, händelsestyrd plattform för synkronisering och berikning av data.
Befintliga lösningar
Dubbelskrivning
För att synkronisera två datalager kan man använda dubbelskrivning, där man gör en skrivning till ett lager och därefter genast skriver till det andra. Den första skrivningen kan upprepas, och den andra kan avbrytas om den första misslyckas efter att antalet försök har nått sin gräns. Problemet är dock att de två datalager kan sluta att synkroniseras om skrivningen till det andra lagret misslyckas. Detta problem löses vanligtvis genom att skapa en återställningsprocedur som periodiskt kan återöverföra data från det första lagret till det andra eller göra det endast om det upptäcks skillnader i data.
Problem:
Utförandet av återställningsproceduren är ett specifikt arbete som inte kan återanvändas. Dessutom förblir data mellan lagringsenheterna osynkroniserade tills återställningsproceduren är genomförd. Problemet förvärras om mer än två datalagringsenheter används. Slutligen kan återställningsproceduren lägga en belastning på den ursprungliga datakällan.
Ändringsloggtabell
När ändringar görs i en tabellsamling (t.ex. insättning, uppdatering och borttagning av poster), läggs ändringsposter till i ändringsloggtabellen som en del av samma transaktion. En annan tråd eller process begär kontinuerligt händelser från ändringsloggtabellen och skriver dem till en eller flera datalagringsenheter, och tar bort händelser från ändringsloggtabellen efter att inskrivningen har bekräftats av alla lagringsenheter.
Problem:
Denna mönster bör implementeras som ett bibliotek och helst utan att ändra koden för den applikation som använder det. I en polyglot-miljö bör en sådan biblioteksimplementation finnas på vilket behövligt språk som helst, men att säkerställa konsekvent funktionalitet och beteende mellan språken är mycket utmanande.
Ett annat problem ligger i att fånga schemaändringar i system som inte stöder transaktionella schemaändringar [1][2], som till exempel MySQL. Därför kommer mönstret för att utföra förändringar (t.ex. schemaändringar) och den transaktionella registreringen av detta i ändringsloggtabellen inte alltid att fungera.
Distribuerade Transaktioner
Distribuerade transaktioner kan användas för att dela upp en transaktion mellan flera heterogena datalagringsenheter så att operationen antingen bekräftas i alla använda lagringsenheter, eller inte bekräftas i någon av dem.
Problem:
Distribuerade transaktioner är ett stort problem för heterogena databaser. De kan per definition endast förlita sig på den minsta gemensamma nämnaren hos de deltagande systemen. Till exempel blockeras XA-transaktioner om det inträffar ett fel i applikationsprocessen under förberedelse. Dessutom erbjuder XA inte dödlägesdetektering och stöder inte optimistiska scheman för parallellhantering. Utöver detta stöder vissa system som ElasticSearch varken XA eller något annat heterogent transaktionssystem. Därmed kvarstår det att säkerställa atomär skrivning i olika datalagringsteknologier som en stor utmaning för applikationer [3].
Delta
Delta utvecklades för att övervinna begränsningarna hos befintliga datasykroniseringlösningar, och det möjliggör även realtidsberikning av data. Vårt mål var att abstrahera alla dessa komplexa aspekter från applikationsutvecklare, så att de kan fokusera helt på att implementera affärsfunktionaliteten. Nedan kommer vi att beskriva "Movie Search", det faktiska användningsfallet för Delta från Netflix.
Netflix använder en mikroservicearkitektur där varje mikroservice vanligtvis hanterar en typ av data. Grundinformationen om filmer hanteras av en mikroservice som kallas Movie Service, medan relaterade data, som information om producenter, skådespelare och leverantörer, hanteras av flera andra mikroservicer (specifikt Deal Service, Talent Service och Vendor Service).
Affärsanvändare på Netflix Studios behöver ofta söka efter filmer baserat på olika kriterier, vilket gör det mycket viktigt för dem att kunna söka i all filmrelaterad data.
Innan Delta behövde filmletarteamet hämta data från flera mikroservicer innan de indexerade filmdata. Dessutom var teamet tvunget att utveckla ett system som periodiskt uppdaterade sökindexet genom att hämta förändringar från andra mikroservicer, även om det inte fanns några förändringar. Detta system blev snabbt komplicerat och blev svårt att underhålla.
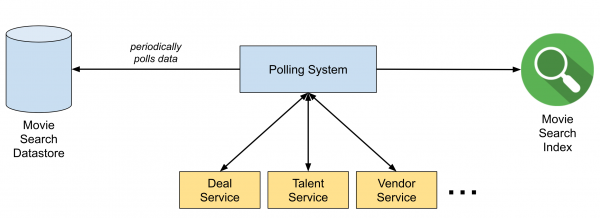
Figur 1. Pollingssystemet före Delta
Efter att ha börjat använda Delta blev systemet förenklat till ett händelsestyrt system, som visas i följande bild. CDC-händelser (Change-Data-Capture) skickas till Keystone Kafka-topiker via Delta-Connector. Delta-appen, byggd med hjälp av Delta Stream Processing Framework (baserat på Flink), tar emot CDC-händelser från topiken, berikar dem genom att anropa andra mikrotjänster och överför slutligen de berikade uppgifterna till sökindexet i Elasticsearch. Hela processen sker nästan i realtid, vilket innebär att så snart förändringar registreras i datalagret uppdateras sökindexen.
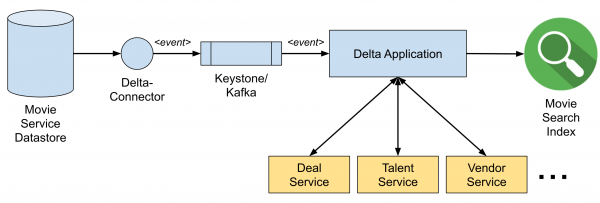
Bild 2. Datapipeline med Delta
I följande avsnitt kommer vi att beskriva hur Delta-Connector fungerar, som kopplar till lagret och publicerar CDC-händelser på transportnivån, som är infrastrukturen för realtidsdataöverföring som dirigerar CDC-händelser till Kafka-topiker. Och i slutet kommer vi att prata om strukturen för Delta-strömbehandling, som apputvecklare kan använda för logik kring databehandling och berikning.
CDC (Change-Data-Capture)
Vi har utvecklat en CDC-tjänst som kallas Delta-Connector, som kan registrera begångna ändringar från datalagret i realtid och skriva dem till en ström. Realtidsändringar hämtas från transaktionsloggen och lagrets dumpningar. Dumpningar används eftersom transaktionsloggar vanligtvis inte lagrar hela historiken av ändringar. Ändringar serielliseras vanligtvis som Delta-händelser, så mottagaren behöver inte oroa sig för varifrån ändringen kommer.
Delta-Connector stöder flera ytterligare funktioner, såsom:
- Möjlighet att skriva till anpassad utdata utanför Kafka.
- Möjlighet att aktivera manuella dumpningar när som helst för alla tabeller, en specifik tabell eller för vissa primära nycklar.
- Dumpningar kan hämtas i block, så det är inte nödvändigt att börja om från början vid fel.
- Det är ingen anledning att sätta lås på tabeller, vilket är mycket viktigt för att skrivtrafiken till databasen aldrig blockeras av vår tjänst.
- Hög tillgänglighet på grund av reservinstanser i AWS Availability Zones.
För närvarande stödjer vi MySQL och Postgres, inklusive distributioner i AWS RDS och Aurora. Vi stöder även Cassandra (multi-master). Mer information om Delta-Connector kan du få i detta .
Kafka och transportlagret
Transportlagret för Delta-händelser är byggt på meddelandetjänsten i plattformen .
Historiskt sett har publicering av meddelanden i Netflix optimerats för att öka tillgängligheten snarare än hållbarheten (se ). Detta har resulterat i en potentiell datainkonsistens mellan olika gränsscenarier. Till exempel, unclean leader election ansvarar för att mottagaren potentiellt duplicerar eller förlorar händelser.
Med Delta ville vi få mer robusta garantier för hållbarhet för att säkerställa leverans av CDC-händelser till avledda lagringslösningar. För detta föreslog vi en specialdesignad Kafka-kluster som ett förstklassigt objekt. Du kan se några inställningar för broker i tabellen nedan:
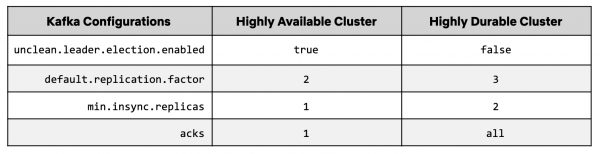
I Keystone Kafka-kluster, unclean leader election är vanligtvis aktiverat för att säkerställa tillgängligheten för publicisten. Detta kan leda till förlust av meddelanden om en osynkroniserad replik väljs som ledare. För ett nytt högre tillförlitligt Kafka-kluster är inställningen unclean leader election avstängd för att förhindra meddelandeförlust.
Vi har också ökat replication factor från 2 till 3 och minimum insync replicas från 1 till 2. Publicister som skriver till detta kluster kräver acks från alla andra, vilket garanterar att 2 av 3 repliker har de mest aktuella meddelandena som skickats av publicisten.
När en broker-instans slutar fungera, ersätter en ny instans den gamla. Den nya brokern måste dock ikapp de osynkroniserade replikarna, vilket kan ta flera timmar. För att förkorta återställningstiden för detta scenario började vi använda blocklagring (Amazon Elastic Block Store) istället för lokala diskar för brokern. När den nya instansen ersätter den avslutade broker-instansen, ansluter den EBS-volymen som den avslutade instansen hade och börjar synka nya meddelanden. Denna process minskar tiden för att eliminera eftersläpning från flera timmar till flera minuter, eftersom den nya instansen inte längre behöver replikera från ett tomt tillstånd. Sammanfattningsvis minskar separata livscykler för lagring och broker avsevärt effekten av bytet av broker.
För att ytterligare öka garantin för dataleverans har vi använt för att upptäcka eventuell förlust av meddelanden under extrema förhållanden (till exempel tidsavvikelser i ledaren för en partition).
Stream Processing Framework
Behandlingsnivån i Delta bygger på Netflix SPaaS-plattformen, som integrerar Apache Flink med Netflix-ekosystemet. Plattformen tillhandahåller ett användargränssnitt för att hantera distributionen av Flink-jobb och orkestreringen av Flink-kluster ovanpå vår containerhanteringsplattform Titus. Gränssnittet hanterar också jobbkonstruktioner och gör det möjligt för användare att dynamiskt ändra konfigurationen utan att behöva recompilera Flink-jobben.
Delta tillhandahåller ett ramverk för strömbehandling baserat på Flink och SPaaS, som använder annotationsbaserad DSL (Domain Specific Language) för att abstrahera tekniska detaljer. Till exempel, för att definiera steget som eventen ska berikas med genom att anropa externa tjänster, måste användarna skriva följande DSL, och ramverket skapar en modell baserat på det som körs av Flink.
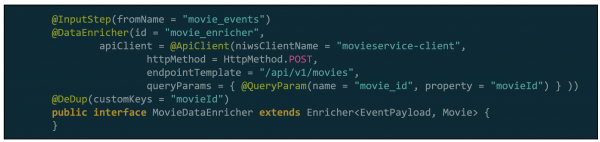
Figur 3. Exempel på berikning med DSL i Delta.
Ramverket för bearbetning förkortar inte bara inlärningskurvan, utan erbjuder också gemensamma funktioner för strömbehandling, såsom deduplicering, schematisk hantering, samt flexibilitet och motståndskraft för att lösa vanliga problem i driften.
Delta Stream Processing Framework består av två nyckelmoduler: DSL & API-modulen och Runtime-modulen. DSL & API-modulen erbjuder DSL och UDF (User-Defined-Function) API så att användare kan skriva sin egen bearbetningslogik (t.ex. filtrering eller transformationer). Runtime-modulen tillhandahåller en implementation av DSL-parsern som bygger en intern representation av bearbetningsstegen i DAG-modeller. Execution-komponenten tolkar DAG-modellerna för att initiera de faktiska Flink-operatörerna och slutligen köra Flink-applikationen. Arkitekturen av ramverket illustreras i följande bild.
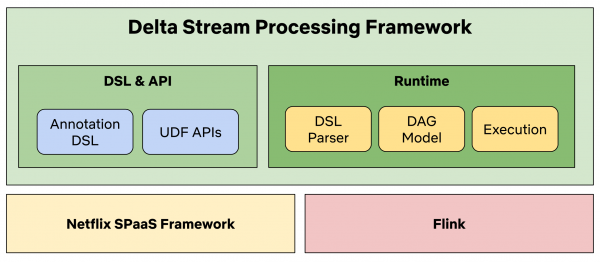
Bild 4. Arkitekturen av Delta Stream Processing Framework
Denna metod har flera fördelar:
- Användare kan fokusera på sin affärslogik utan att behöva gå in på Flink-specifika detaljer eller SPaaS-strukturen.
- Optimering kan göras på ett sätt som är transparent för användarna, och fel kan rättas till utan att det krävs några ändringar i användarens kod (UDF).
- Delta-applikationers arbete har förenklats för användare, eftersom plattformen erbjuder flexibilitet och motståndskraft direkt ur lådan och samlar in detaljerade metrikdata som kan användas för aviseringar.
Användning i produktion
Delta har varit i produktion i över ett år och spelar en nyckelroll i många applikationer på Netflix Studio. Det har hjälpt teamen att implementera användningsfall som sökindexering, datalagring och händelsestyrda arbetsflöden. Nedan följer en översikt av plattformens hög-nivåarkitektur.
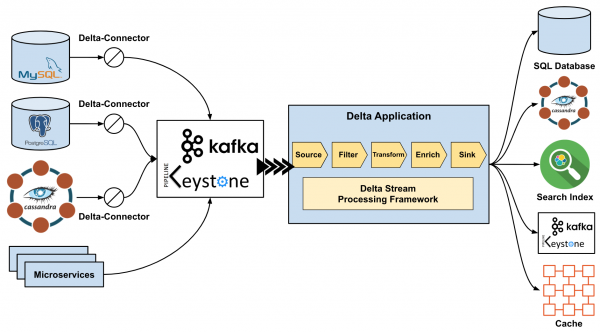
Bild 5. Hög-nivåarkitektur av Delta.
Tack.
Vi vill tacka följande personer som bidragit till skapandet och utvecklingen av Delta på Netflix: Allen Wang, Charles Zhao, Jaebin Yoon, Josh Snyder, Kasturi Chatterjee, Mark Cho, Olof Johansson, Piyush Goyal, Prashanth Ramdas, Raghuram Onti Srinivasan, Sandeep Gupta, Steven Wu, Tharanga Gamaethige, Yun Wang och Zhenzhong Xu.
Källor
- Martin Kleppmann, Alastair R. Beresford, Boerge Svingen: Online-händelsebearbetning. Commun. ACM 62(5): 43–49 (2019). DOI:
: "Data Build Tool för Amazon Redshift-databasen."
Källa: habr.com
