

Hej alla! Jag heter Pavel Agaletsky. Jag arbetar som teamledare i ett team som utvecklar Lamodas leveranssystem. År 2018 talade jag på konferensen HighLoad++, och idag vill jag presentera en transkription av mitt föredrag.
Min ämne handlar om vår företags erfarenhet av att distribuera system och tjänster i olika miljöer. Från våra förhistoriska tider, när vi distribuerade alla system på vanliga virtuella servrar, till den gradvisa övergången från Nomad till distribution i Kubernetes. Jag kommer att berätta om varför vi gjorde detta och vilka problem vi hade under processen.

Distribution av applikationer på VM
Vi börjar med att konstatera att för tre år sedan distribuerades alla företagets system och tjänster på vanliga virtuella servrar. Tekniskt sett organiserades det så att all kod för våra system låg och byggdes via automatiserad byggprocess med hjälp av Jenkins. Med Ansible distribuerades den från vårt versionskontrollsystem till de virtuella servrarna. Varje system som fanns i vårt företag distribuerades på minst två servrar: en av dem var head och den andra var tail. Dessa två system var helt identiska med avseende på alla sina inställningar, kapacitet, konfiguration och så vidare. Skillnaden mellan dem var endast att head tog emot användartjänst, medan tail aldrig fick något användartrafik.
Varför gjorde vi detta?
När vi distribuerade nya versioner av vår applikation ville vi säkerställa att det fanns en sömlös distribution, det vill säga utan märkbara konsekvenser för användarna. Detta uppnåddes genom att den senaste sammanställda versionen med hjälp av Ansible distribuerades till tail. Där kunde de personer som ansvarade för distributionen kontrollera och se till att allt fungerade bra: alla mätvärden, sektioner och applikationer fungerade; nödvändiga skript kördes. Endast efter att de var övertygade om att allt var i ordning, växlades trafiken. Den började gå till den server som tidigare var tail. Och den som tidigare var head förblev utan användartjänst, men hade den tidigare versionen av vår applikation.
Därmed var det sömlöst för användarna. Eftersom växlingen är omedelbar, då det bara handlar om att byta lastbalanserare. Det är mycket enkelt att återgå till en tidigare version genom att helt enkelt byta tillbaka lastbalanseraren. Vi kunde också försäkra oss om applikationens kapabiliteter i produktion innan den fick användartrafik, vilket var ganska bekvämt.
Vilka fördelar såg vi i allt detta?
- Framför allt är det ganska enkelt att få det att fungera. Det är tydligt för alla hur ett sådant distributionsschema fungerar, eftersom de flesta människor har distribuerat på vanliga virtuella servrar någon gång.
- Det är ganska pålitligt, eftersom distributionsmetoden är enkel och har prövats av tusentals företag. Miljoner servrar distribueras på detta sätt. Det är svårt att bryta något.
- Och slutligen kunde vi få atomära distributioner. Distributioner som sker för användarna samtidigt, utan en märkbar övergång mellan den gamla och nya versionen.
Men i allt detta såg vi också några nackdelar:
- Förutom produktionsmiljön och utvecklingsmiljön finns det även andra miljöer. Till exempel QA och preproduktion. Vid det tillfället hade vi många servrar och cirka 60 tjänster. Därför var vi tvungna att bibehålla den aktuella versionen av den virtuella maskinen för varje tjänst. Dessutom, om du vill uppdatera bibliotek eller installera nya beroenden, måste du göra det i alla miljöer. Tidpunkten för när du tänker distribuera den nya versionen av din applikation måste också synkroniseras med tidpunkten då devops utför de nödvändiga konfigurationerna av miljön. I sådana fall är det lätt att hamna i en situation där miljön ser helt olika ut i alla miljöer direkt efter varandra. Till exempel kan det finnas en uppsättning bibliotek i QA-miljön, medan det finns en annan i produktion, vilket kan leda till problem.
- Svårigheten med att uppdatera beroenden av din applikation. Det beror inte på dig, utan på ett annat team. Nämligen devops-teamet, som stöder servrarna. Du måste ge dem en lämplig uppgift och beskriva vad du vill åstadkomma.
- Vid den tiden ville vi också dela upp våra stora monoliter i mindre tjänster, eftersom vi insåg att antalet skulle öka ständigt. Då hade vi redan över 100 sådana. För varje ny tjänst behövde vi skapa en ny virtuell maskin, som också måste underhållas och distribueras. Dessutom behövdes det inte bara en maskin, utan minst två. Dessutom tillkom en QA-miljö. Detta skapar problem och gör det mer komplicerat, kostsamt och tidskrävande att skapa och lansera nya system.
Därför beslutade vi att det skulle vara mer praktiskt att övergå från att distribuera vanliga virtuella maskiner till att köra våra applikationer i Docker-containrar. Med Docker behövs ett system som kan köra applikationen i ett kluster, eftersom man inte bara kan starta en container utan vidare. Vanligtvis vill man hålla koll på hur många containrar som är aktiva, så att de startas automatiskt. Av den anledningen behövde vi välja ett administrationssystem.
Vi funderade länge på vilket av dem som skulle vara lämpligt. Problemet var att vår deployment-stack för vanliga virtuella servrar vid den tiden var något föråldrad, eftersom det fanns inte de senaste versionerna av operativsystemen. Vid något tillfälle hade vi till och med FreeBSD, som var ganska besvärligt att underhålla. Vi insåg att vi behövde migrera till Docker så snart som möjligt. Vårt DevOps-team tittade på sin befintliga erfarenhet av olika lösningar och valde ett system som Nomad.
Övergången till Nomad
Nomad är en produkt från företaget "HashiCorp". De är också kända för sina andra lösningar:
"Consul" — ett verktyg för tjänstedetektering.
"Terraform" — ett system för serverhantering som låter dig konfigurera dem via kod, så kallad infrastructure-as-code.
"Vagrant" möjliggör lokal eller moln-baserad distribution av virtuella maskiner genom specifika konfigurationsfiler.
Nomad verkade vid den tiden vara en ganska enkel lösning att snabbt övergå till utan att ändra hela infrastrukturen. Dessutom är det ganska lätt att lära sig. Därför valde vi just det som vårt filtreringssystem för containrar.
Vad behövs för att överhuvudtaget distribuera ditt system i Nomad?
- Först och främst behövs en docker image din applikation. Den måste byggas och placeras i dockerbildens lagring. I vårt fall är det artifactory — en sådan system som gör det möjligt att pusha olika typer av artefakter. Det kan lagra arkiv, dockerbilder, PHP Composer-paket, NPM-paket och så vidare.
- Det är också nödvändigt konfigurationsfilen, vilket talar om för Nomad vad, var och i vilken mängd du vill distribuera.
När vi pratar om Nomad används HCL som format för informationsfilen, vilket står för HashiCorp Configuration Language. Det är en övermängd av Yaml som låter dig beskriva din tjänst i termer av Nomad.
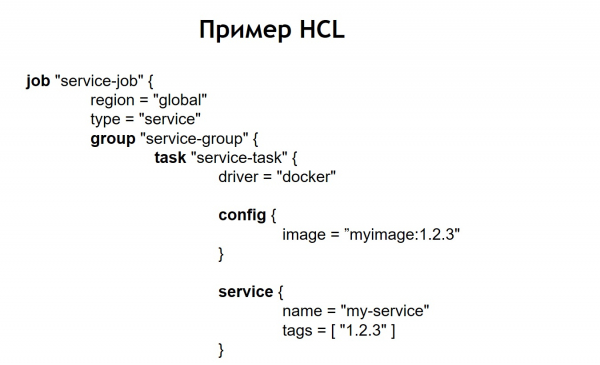
Det tillåter dig att ange hur många containrar du vill distribuera, från vilka bilder, och för att överföra olika parametrar vid distribution. På så sätt matar du in denna fil till Nomad, och den startar containrar i produktion i enlighet med den.
I vårt fall insåg vi att det inte skulle vara praktiskt att skriva helt identiska HCL-filer för varje tjänst, eftersom det finns så många tjänster och ibland vill man uppdatera dem. Det händer att en tjänst distribueras i flera exemplar, inte bara ett. Till exempel har ett av systemen som ligger i produktion över 100 instanser i drift. De körs från samma bilder, men med olika konfigurationsinställningar och konfigurationsfiler.
Därför bestämde vi att det skulle vara praktiskt att lagra alla våra konfigurationsfiler för distribution i ett gemensamt förråd. På så sätt kan de granskas: de är lätta att underhålla och man kan se vilka system vi har. Vid behov är det inte svårt att uppdatera eller ändra något. Att lägga till ett nytt system är heller inget problem — det räcker med att skapa en konfigurationsfil i en ny mapp. Inuti den finns filerna: service.hcl, som innehåller beskrivningen av vår tjänst, och vissa env-filer, som gör att denna tjänst, när den väl är distribuerad i produktion, kan konfigureras.
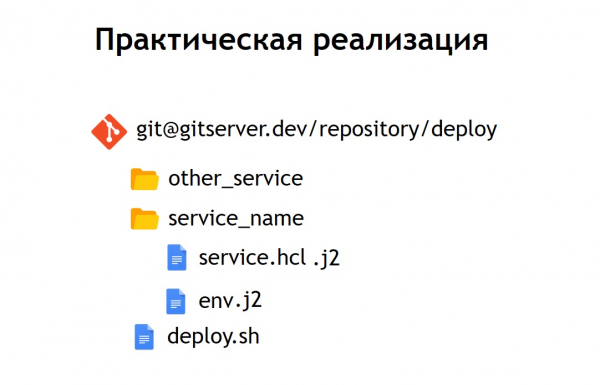
Men några av våra system är inte distribuerade i produktion i ett exemplar utan i flera samtidigt. Därför beslutade vi att det skulle vara bekvämt att lagra inte konfigurerade filer i sin rena form, utan i deras templatiserade form. Som språk för templatisering valde vi jinja 2. I detta format lagras både konfigurationerna för tjänsten och de env-filer som den behöver.
Dessutom har vi inkluderat ett gemensamt skript för distribution i repositoryt för alla projekt, vilket gör att du kan starta och distribuera din tjänst till produktion, i rätt miljö och till rätt mål. När vi omvandlade vår HCL-konfiguration till en mall, såg HCL-filen, som tidigare var en vanlig Nomad-konfiguration, lite annorlunda ut.
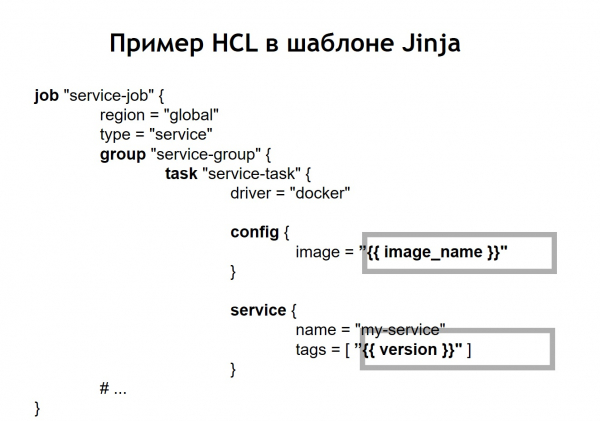
Det vill säga att vi ersatte vissa variabler i konfigurationen med insättningar av variabler som hämtas från env-filer eller andra källor. Dessutom fick vi möjlighet att dynamiskt sammanställa HCL-filer, vilket innebär att vi kan använda mer än bara vanliga variabelinsättningar. Eftersom Jinja stödjer loopar och villkor, kan vi även skapa konfigurationsfiler som ändras beroende på var du faktiskt distribuerar dina applikationer.
Till exempel, om du vill distribuera din tjänst till pre-production och produktion. Anta att du i pre-production inte vill köra cron-skript utan bara vill se tjänsten på en separat domän för att kontrollera att den fungerar. För alla som distribuerar en tjänst ser processen mycket enkel och transparent ut. Det räcker med att köra filen deploy.sh, ange vilken tjänst du vill distribuera och till vilket mål. Till exempel, om du vill distribuera ett visst system till Ryssland, Vitryssland eller Kazakstan. För att göra detta räcker det att bara ändra en av parametrarna, så kommer rätt konfigurationsfil att skapas.
När Nomadtjänsten redan är distribuerad i din kluster ser den ut på följande sätt.
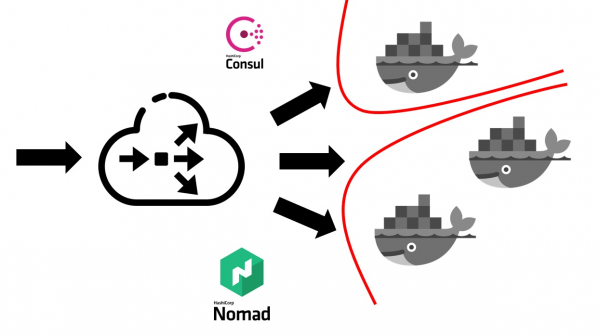
Först behöver du en viss extern lastbalanserare som kommer att ta emot all användartjänsttrafik. Den kommer att arbeta tillsammans med Consul och fråga den var, på vilken nod, med vilken IP-adress den specifika tjänsten som motsvarar det specifika domännamnet finns. Tjänsterna i Consul dyker upp från Nomad själv. Eftersom detta är produkter från samma företag är de väl integrerade. Man kan säga att Nomad direkt stödjer registreringen av alla tjänster som startas i Consul.
När din externa lastbalanserare har fått reda på vilken tjänst den ska skicka trafik till, omdirigerar den trafiken till motsvarande container eller flera containrar som hör till din applikation. Självklart måste man också tänka på säkerheten. Även om alla tjänster körs på samma virtuella maskiner i containrar, krävs det vanligtvis att man förbjuder obehörig tillgång från en tjänst till en annan. Vi åstadkom detta genom segmentering. Varje tjänst kördes i sitt egna virtuella nätverk, där regler för routing och regler för åtkomsttillstånd/blockering till andra system och tjänster var definierade. De kunde befinna sig både inom denna kluster och utanför. Till exempel, om du vill förbjuda en tjänst att koppla upp sig mot en viss databas, kan detta göras genom segmentering på nätverksnivå. Det innebär att du inte av misstag kan koppla upp dig från testmiljön till din produktionsdatabas.
Vad kostade övergångsprocessen i form av personalresurser?
Övergången av hela företaget till Nomad tog ungefär 5-6 månader. Vi genomförde det tjänst för tjänst, men i ett ganska snabbt tempo. Varje team var tvungna att skapa sina egna containrar för sina tjänster.
Vi har antagit en sådan tillvägagångssätt där varje team ansvarar för docker images av sina system själva. DevOps tillhandahåller den gemensamma infrastrukturen som är nödvändig för distribution, det vill säga stöd för själva klustret, stöd för CI-systemet och så vidare. Vid den tiden hade över 60 system flyttat över till Nomad, vilket resulterade i ungefär 2 000 containrar.
DevOps ansvarar för den gemensamma infrastrukturen för allt som rör distribution och servrar. Varje utvecklingsteam ansvarar i sin tur för implementeringen av containrar för sitt specifika system, eftersom det är just teamet som vet vad de behöver i den eller den containern.
Orsaker till att avbryta användningen av Nomad
Vilka fördelar fick vi av att övergå till distribution via Nomad och Docker?
- Vi säkra likvärdiga villkor för alla miljöer. I utveckling, QA-miljöer, förproduktionen och produktionen används samma containerbilder, med samma beroenden. Således har ni knappt någon chans att det som hamnar i produktion är något annat än vad ni tidigare har testat lokalt eller i testmiljön.
- Vi har också upptäckt att det är tillräckligt enkelt att lägga till en ny tjänst. Alla nya system kan enkelt startas upp när det kommer till deployment. Det räcker att gå till det repository som lagrar konfigurationerna, lägga till en ny konfigurationsfil för ert system, och så är ni klara. Ni kan deploya ert system till produktion utan ytterligare ansträngningar från DevOps.
- Alla konfigurationsfiler i ett gemensamt repository visade sig vara överskådliga. I det ögonblicket vi deployade våra system med hjälp av virtuella servrar, använde vi Ansible, där konfigurationerna låg i samma repository. Men för de flesta utvecklare var det lite mer komplicerat att arbeta med detta. Volymen av konfigurationer och kod som ni behöver lägga till för att deploya tjänsten har blivit mycket mindre. Dessutom är det väldigt enkelt för DevOps att justera eller ändra detta. Vid övergångar, till exempel till en ny version av Nomad, kan de enkelt massuppdatera alla operativa filer som ligger på samma ställe.
Men vi stötte också på flera nackdelar:
Det visade sig att vi inte kunde uppnå sömlös deployment i fallet med Nomad. Vid utrullning av containrar från olika miljöer kunde det hända att den blev körd, och Nomad uppfattade den som redo att ta emot trafik. Detta hände innan applikationen inne i den hade tid att starta. På grund av detta började systemet under en kort tid att ge 500-fel, eftersom trafiken började gå till en container som ännu inte var redo att ta emot den.
Vi stötte på några buggarDet mest betydande felet är att Nomad inte hanterar stora kluster särskilt bra om du har många system och containrar. När du vill ta en av servrarna i klustret Nomad ur drift finns det en ganska stor sannolikhet att klustret inte mår särskilt bra och går sönder. Vissa containrar kan till exempel falla och inte starta igen – det kan bli väldigt dyrt för dig senare om alla dina system är i produktion just i klustret som hanteras av Nomad.
Därför bestämde vi oss för att tänka på vad vi skulle göra härnäst. Vid den tidpunkten insåg vi mycket bättre vad vi ville uppnå. Nämligen: vi vill ha pålitlighet, lite fler funktioner än vad Nomad erbjuder, och ett mer moget, stabilt system.
I detta avseende valde vi Kubernetes som den mest populära plattformen för att köra kluster. Särskilt med tanke på att storleken och antalet av våra containrar var ganska stort. För sådana ändamål verkade Kubernetes vara det mest lämpliga systemet av de vi kunde överväga.
Övergång till Kubernetes
Jag ska kort berätta om de grundläggande begreppen i Kubernetes och vad som skiljer dem från Nomad.
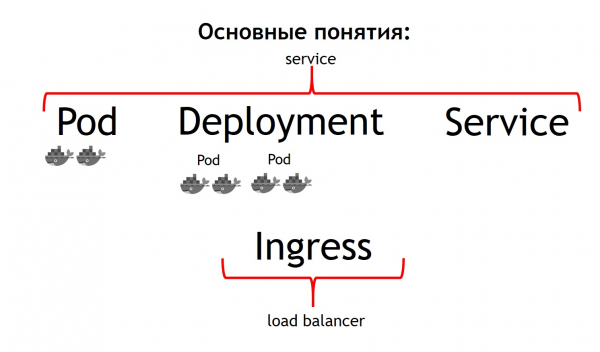
Först och främst är det mest grundläggande begreppet i Kubernetes begreppet pod. Pod är en grupp av en eller flera containrar som alltid körs tillsammans. Och de fungerar som om de alltid strikt finns på en och samma virtuella maskin. De är tillgängliga för varandra via IP-adressen 127.0.0.1 på olika portar.
Anta att du har en PHP-applikation som består av nginx och php-fpm – en klassisk konfiguration. Du kommer sannolikt att vilja att både nginx- och php-fpm-containrar alltid är tillsammans. Kubernetes gör det möjligt att uppnå detta genom att beskriva dem som en gemensam pod. Precis det kunde vi inte få till stånd med hjälp av Nomad.
Det andra begreppet är deployment. Poängen är att pod själv är en flyktig sak, den startar och försvinner. Vill du först döda alla dina tidigare containrar och sedan starta om nya versioner, eller vill du rulla ut dem gradvis – just denna process hanteras av begreppet deployment. Det beskriver hur du distribuerar dina podar, i vilken mängd och hur du uppdaterar dem.
Det tredje begreppet är service. Ditt service är faktiskt ditt system som tar emot viss trafik och sedan dirigerar den till en eller flera poddar som motsvarar ditt service. Det betyder att den låter dig specificera att all inkommande trafik till en sådan tjänst med ett visst namn ska skickas till just dessa poddar. Och samtidigt säkerställer den att du får en lastbalansering. Det innebär att du kan starta två poddar av din applikation, och all inkommande trafik kommer att balanseras jämnt mellan de poddar som tillhör denna tjänst.
Och det fjärde grundläggande begreppet — Ingress. Det är en tjänst som körs i ett Kubernetes-kluster. Den fungerar som en extern lastbalanserare som tar emot alla förfrågningar. Med hjälp av API:n i Kubernetes Ingress kan den avgöra vart dessa förfrågningar ska skickas. Dessutom gör den det väldigt flexibelt. Du kan säga att alla förfrågningar till denna värd och denna URL skickas till denna tjänst. Och dessa förfrågningar som kommer till denna värd och till en annan URL skickas till en annan tjänst.
Det mest fantastiska ur perspektivet för den som utvecklar applikationen — är att du kan hantera allt detta själv. Genom att sätta upp Ingress-konfigurationen kan du skicka all trafik som kommer till en viss API till separata containrar, till exempel skrivna i Go. Och den här trafiken som kommer till samma domän, men till en annan URL, kan skickas till containrar skrivna i PHP, där det finns mycket logik, men som inte är särskilt snabba.
Om man jämför alla dessa begrepp med Nomad kan man säga att de tre första begreppen tillsammans utgör Service. Det sista begreppet finns inte i Nomad. Vi har använt en extern lastbalanserare för detta: det kan vara haproxy, nginx, nginx+ och så vidare. I fallet med Kubernetes behöver du inte införa detta ytterligare begrepp separat. Men om du tittar på Ingress inuti, så är det antingen nginx, haproxy eller traefik, men inbyggt i Kubernetes.
Alla de begrepp jag nämnt är i stort sett resurser som finns inom Kubernetes-klustret. För att beskriva dem i Kubernetes används yaml-format, som är mer läsbart och bekant än HCL-filerna i Nomad. Men strukturellt beskriver de, till exempel för en pod, i princip detsamma. De säger — jag vill distribuera sådana poddar dit, med sådana bilder, i sådant antal.
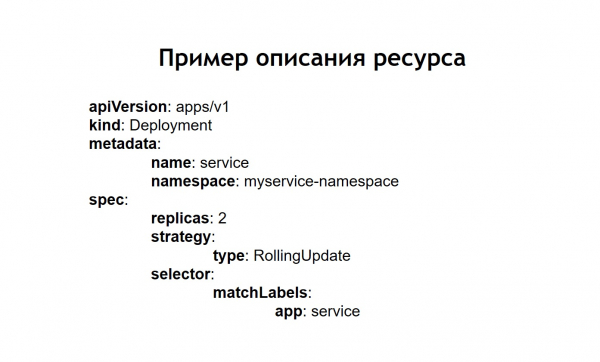
Dessutom insåg vi att vi inte ville skapa varje enskild resurs för hand: deployment, tjänster, Ingress och så vidare. Istället ville vi vid deployment beskriva varje system vi har i termer av Kubernetes, så att vi inte behöver återskapa alla nödvändiga resursberoenden i rätt ordning manuellt. För detta ändamål valde vi Helm som system.
Grundläggande begrepp i Helm
Helm är paketchef för Kubernetes. Det liknar hur paketförvaltare fungerar i programmeringsspråk. De låter dig lagra en tjänst som består av exempelvis en deployment för nginx, en deployment för php-fpm, en konfiguration för Ingress och configmaps (detta är en enhet som låter dig ange env och andra parametrar för ditt system) i form av så kallade charts. Helm fungerar ovanpå Kubernetes. Det är alltså inget system som står vid sidan av, utan bara en annan tjänst som körs inuti klustret. Du interagerar med det via dess API genom kommandoraden. Dess bekvämlighet och fördelar ligger i att även om helm skulle krascha eller du tar bort det från klustret, så försvinner inte dina tjänster, eftersom helm i princip bara tjänar till att starta systemet. Själva Kubernetes ansvarar för tjänsternas funktion och tillstånd.
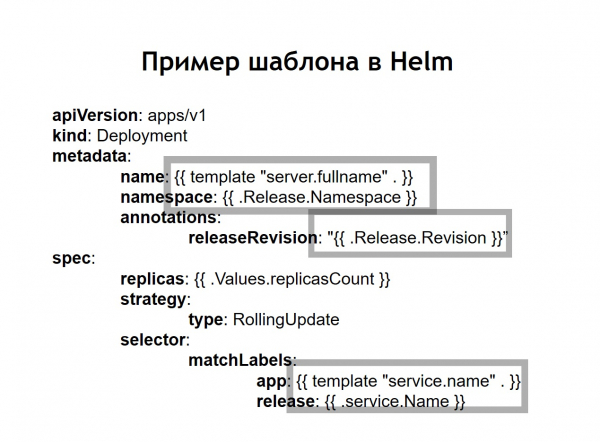
Vi insåg också att mallning, som vi tidigare var tvungna att göra själva genom att införa jinja i våra konfigurationer, är en av de viktigaste funktionerna i helm. Alla konfigurationer du skapar för dina system lagras i helm i form av mallar, liknande jinja, men som egentligen använder mallningsspråket Go, som helm är skrivet på, precis som Kubernetes.
Helm lägger till ett par ytterligare begrepp.
Diagram — detta är en beskrivning av din tjänst. I andra paketförvaltare skulle detta kallas paket, bundle eller något liknande. Här kallas det chart.
Values – det är variabler som du vill använda för att bygga dina konfigurationer från mallar.
ReleaseVarje gång en tjänst som deployas med hjälp av helm får en inkrementell version av releasen. Helm kommer ihåg vilken konfiguration tjänsten hade vid tidigare och föregående releaser. Därför räcker det med att köra kommandot helm callback och ange den tidigare versionen av releasen för att återställa. Även om den motsvarande konfigurationen inte är tillgänglig i ditt repository vid tidpunkten för återställning, kommer helm fortfarande att komma ihåg vilken den var och återställa ditt system till det tillstånd det var i vid den tidigare releasen.
När vi använder helm omvandlas vanliga konfigurationer för Kubernetes också till mallar, där det finns möjlighet att använda variabler, funktioner och tillämpa villkorssatser. På så sätt kan du bygga konfigurationen av din tjänst beroende på miljön.
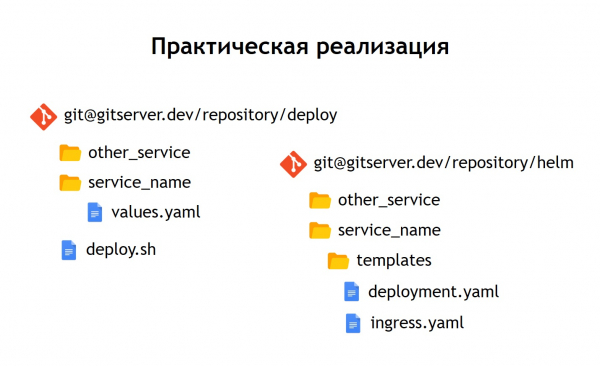
I praktiken har vi valt att göra något annorlunda än vad vi gjorde i fallet med Nomad. Om i Nomad alla konfigurationer för deployment och n-variabler som behövs för att deploya vår tjänst lagrades i ett och samma repository, så har vi här valt att dela upp dem i två separata repositories. I repositoryt 'deploy' lagras endast n-variablerna som behövs för deployment, medan repositoryt 'helm' innehåller konfigurationer eller charts.
Vad gav detta oss?
Trots att vi inte lagrar några verkligt känsliga uppgifter i konfigurationsfilerna, till exempel databasanvändarnamn och lösenord, som lagras som secrets i Kubernetes, finns det ändå särskilda saker dit vi inte vill ge åtkomst för alla. Därför är tillgången till repositoryt 'deploy' mer begränsad, medan repositoryt 'helm' bara innehåller en beskrivning av tjänsten. Av denna anledning kan vi ge tillgång till det på ett säkert sätt till en större krets av personer.
Eftersom vi har inte bara produktionsmiljöer utan även andra miljöer, kan vi tack vare denna uppdelning återanvända våra helm-charts för att deploya tjänster inte bara i produktion, utan även till exempel i QA-miljöer. Även för att driftsätta dem lokalt med hjälp av Minikube — det är en sådan grej för lokal körning av Kubernetes.
Inom varje repository har vi gjort en uppdelning i separata kataloger för varje tjänst. Det betyder att inom varje katalog finns mallar som är relaterade till motsvarande diagram och beskriver de resurser som behöver distribueras för att starta vårt system. I repositoryt "deploy" har vi endast lämnat envars. I detta fall har vi inte använt mallning med jinja, eftersom helm själv erbjuder mallning direkt - det är en av dess grundläggande funktioner.
Vi har lämnat ett skript för distribution - deploy.sh, som förenklar och standardiserar start av distribution med hjälp av helm. Således ser distributionsgränssnittet ut exakt som det gjorde i fallet med distribution via Nomad. Samma deploy.sh, namnet på din tjänst och dit du vill distribuera den. Detta resulterar i att helm körs inuti. Den samlar konfigurationer från mallarna, ersätter dem med nödvändiga values-filer och distribuerar dem i Kubernetes.
Slutsatser
Kubernetes-tjänsten verkar mer komplex än Nomad.
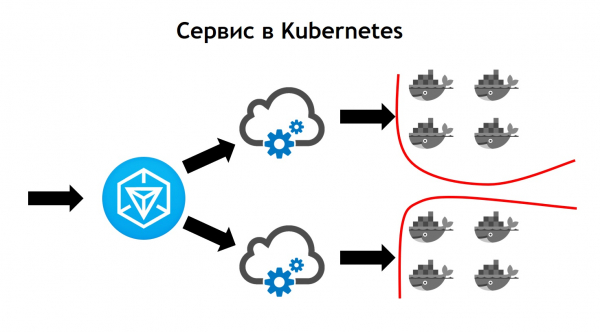
Här kommer utgående trafik in i Ingress. Det är just frontkontrollern som tar emot alla förfrågningar och skickar dem vidare till de tjänster som är relevanta för de aktuella förfrågningarna. Den bestämmer dessa baserat på konfigurationer som är en del av beskrivningen av din applikation i helm och som utvecklarna specificerar själva. Tjänsten skickar förfrågningar till sina pods, det vill säga specifika containrar, och balanserar den inkommande trafiken mellan alla containrar som tillhör den aktuella tjänsten. Och naturligtvis får vi inte glömma att säkerheten på nätverksnivå är avgörande. Därför är det segmentering i Kubernetes-klustret, som baseras på taggning. Alla tjänster har specifika taggar, till vilka rättigheter för tjänsternas tillgång till olika externa/interna resurser inuti eller utanför klustret är kopplade.
När vi genomförde övergången såg vi att Kubernetes har alla funktioner som Nomad, som vi tidigare använde, hade, och dessutom lägger till mycket nytt. Det kan utvidgas genom plugins och faktiskt genom anpassade resurstyper. Det innebär att du inte bara kan använda det som följer med Kubernetes utanför boxen, utan också skapa din egen resurs och tjänst som kommer att läsa din resurs. Detta ger ytterligare möjligheter att utöka ditt system utan att behöva installera om Kubernetes och utan behov av förändringar.
Ett exempel på sådan användning är Prometheus, som körs inom vår Kubernetes-kluster. För att det ska börja samla in metrik från en viss tjänst behöver vi lägga till en extra resurstyp i tjänstbeskrivningen, så kallad servicemonitor. Eftersom Prometheus kan läsa anpassade resurstyper när det körs i Kubernetes, börjar det automatiskt samla in metrik från det nya systemet. Det är ganska praktiskt.
Den första deployment vi gjorde i Kubernetes var i mars 2018. Och under den tiden har vi aldrig haft några problem med det. Det fungerar ganska stabilt utan betydande buggar. Dessutom kan vi vidareutveckla det. Idag räcker de möjligheter som finns i det, och vi gillar verkligen hastigheten på utvecklingen av Kubernetes. För närvarande finns det mer än 3000 containrar i Kubernetes. Klustret består av flera noder. Vidare är det underhållit, stabilt och mycket kontrollerat.
Källa: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish