

Hej alla! Som en del av mitt examensarbete har jag undersökt möjligheterna med en inhemsk molnplattform som . Plattformen erbjuder olika tjänster för att lösa praktiska problem. Men ibland kan det vara nödvändigt att bygga sin egen molnapp baserat på dessa tjänster med en ganska utspridd infrastruktur. I den här artikeln vill jag dela med mig av erfarenheten av att driftsätta en sådan applikation.
Vad vill vi uppnå?
— ett kraftfullt verktyg för att lösa analytiska uppgifter eller för att övervaka olika system. I sin grundversion är detta en virtuell maskin med en Grafana-webbserver och en databas (ClickHouse, InfluxDB, etc.) med dataset, som analytiken kommer att bygga på.
Efter att den virtuella maskinen med webbservern har startats kan man gå in på dess värd och få en snygg användargränssnitt, ange databaser som källor för vidare arbete, skapa instrumentpaneler och diagram.
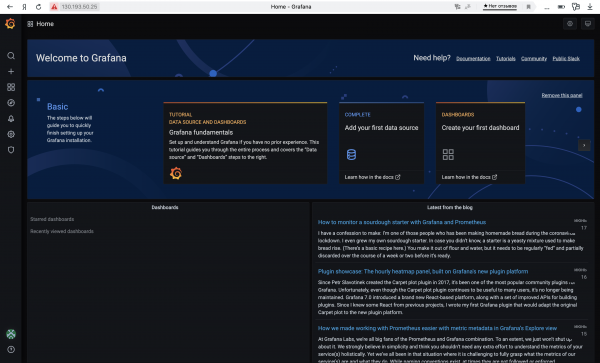
Den grundläggande versionen har en betydande nackdel — den är helt oåterhämtningsbar. Det vill säga, applikationens funktionalitet beror helt på livskraften hos en enda virtuell maskin. Om den misslyckas eller om tio personer öppnar användargränssnittet samtidigt, så uppstår det problem.
De löses enkelt: man behöver bara... driftsätta flera identiska virtuella maskiner med webbservern och placera dem bakom en L3-balancer. Men här är det inte så enkelt. Grafana lagrar användarinställningarna (sökvägar till databaser, instrumentpaneler, diagram etc.) direkt på disken av sin virtuella maskin. Således, om man ändrar några inställningar i användargränssnittet, kommer dessa ändringar endast att återspeglas på den virtuella maskin som balanceraren har skickat oss till. Detta kommer att leda till inkonsekventa inställningar av vår applikation, problem med att starta och använda den.
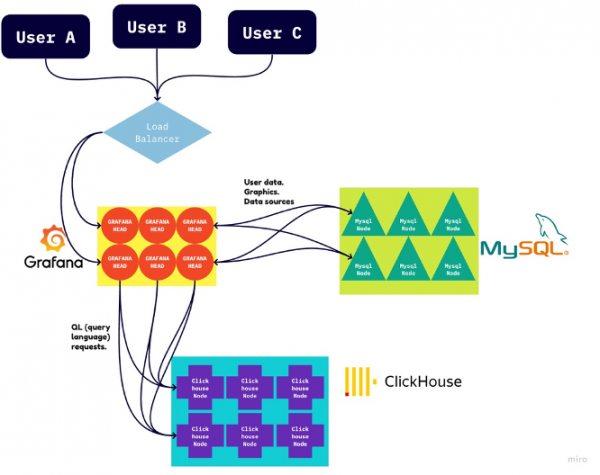
Här kommer en annan databas, till exempel MySQL eller dess motsvarighet, till hjälp. Vi säger till Grafana att den ska lagra användarinställningarna i denna "reserv"-databas. Efter det räcker det med att en gång ange sökvägen till denna databas på varje maskin, och alla andra användarinställningar kan redigeras på någon av de virtuella maskinerna; de kommer att växa ut till de andra.
Här är schemat för den slutliga infrastrukturen hos applikationen:
Lär oss att manuellt lansera
MySQL och ClickHouse
Innan du kan installera en sådan applikation med ett knapptryck, behövde man lära sig att manuellt starta varje komponent och integrera dem med varandra.
Här kan Yandex.Cloud hjälpa oss, som erbjuder L3-lastbalanserare, ClickHouse och MySQL som managed-tjänster. Användaren behöver bara ange parametrar och vänta medan plattformen gör allt redo.
Jag registrerade mig, skapade en molninstans och en betalningskonto. Efter det loggade jag in i molnet och startade MySQL- och ClickHouse-kluster med minimala inställningar. Jag väntade tills de blev aktiva.
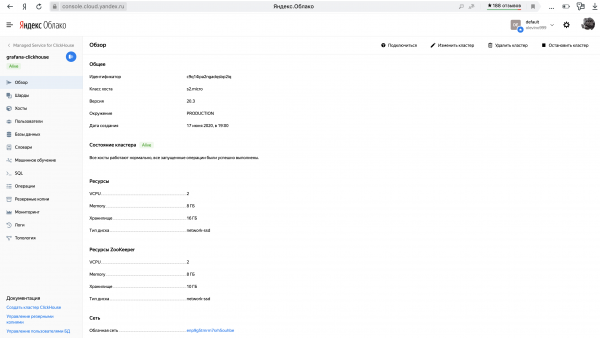
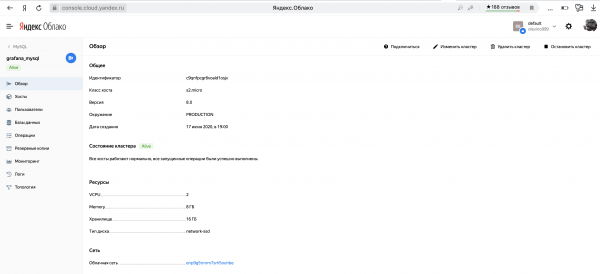
Man får inte glömma att skapa en databas i varje kluster och ställa in åtkomst med användarnamn och lösenord. Jag går inte in på detaljer här – allt är ganska uppenbart i gränssnittet.
En subtil detalj var att dessa databaser har många värdar som säkerställer deras redundans. Men Grafana kräver exakt en värd för varje databas den arbetar med. Cloud:et ledde mig till en lösning. Det visar sig att en värd av typen c-<cluster_id>.rw.mdb.yandexcloud.net mappas till den aktuella aktiva master-värden i klustret med motsvarande ID. Det är den vi kommer att ge till Grafana.
Webbserver
Nu återstår det bara för webbservern. Vi kommer att starta en vanlig virtuell maskin med Linux och manuellt konfigurera Grafana på den.
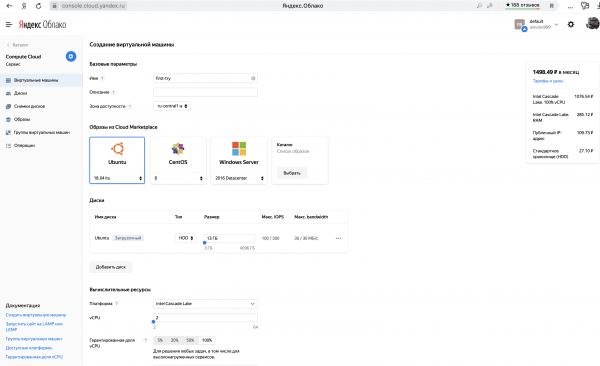
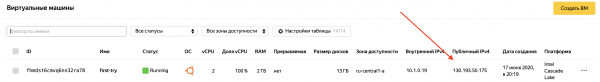
Vi ansluter oss via ssh och installerar nödvändiga paket.
sudo apt-get install -y apt-transport-https software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
Efter det startar vi Grafana via systemctl och installerar pluginet för att arbeta med ClickHouse (ja, det ingår inte i standardkonfigurationen).
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
Allt, efter detta kan vi med ett enkelt kommando
sudo service grafana-server startstarta webbservern. Nu kan vi i webbläsaren ange den externa IP-adressen på den virtuella maskinen, ange port 3000 och se Grafanas vackra gränssnitt.
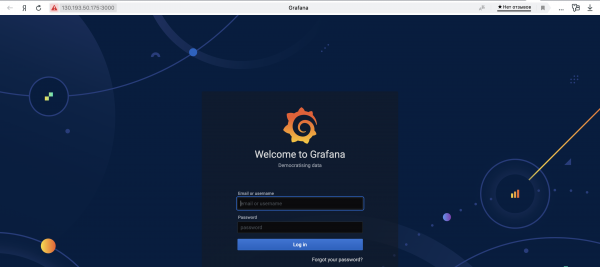
Men skynda dig inte, innan vi konfigurerar Grafana får vi inte glömma att ge den sökvägen till MySQL för att spara inställningarna där.
All konfiguration av Grafanas webbserver ligger i filen /etc/grafana/grafana.ini. Den nödvändiga raden ser ut så här:
;url =Vi ställer in värden för MySQL-klustret. I samma fil finns användarnamn och lösenord för att få åtkomst till Grafana på bilden ovan, som båda är lika med standard. admin.
Du kan använda sed-kommandon:
sudo sed -i "s#.*;url =.*#url = mysql://{MYSQL_USERNAME}:{MYSQL_PASSWORD}@{MYSQL_CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = {GRAFANA_USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = {GRAFANA_PASSWORD}#" /etc/grafana/grafana.ini
Det är dags att starta om webbservern!
sudo service grafana-server restartNu anger vi ClickHouse som datakälla i Grafanas gränssnitt.
Jag fick en fungerande konfiguration med följande inställningar:
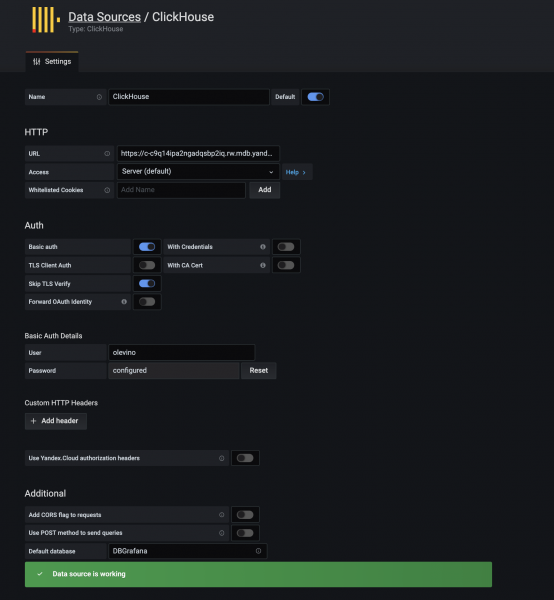
Som URL angav jag https://c-.rw.mdb.yandexcloud.net:8443
Det är klart! Vi har en fungerande virtuell maskin med en webbserver ansluten till CH och MySQL. Du kan redan börja ladda upp dataset till ClickHouse och bygga dashboardar. Men vi har fortfarande inte nått vårt mål och har inte utvecklat en fullständig infrastruktur.
Packer
Yandex.Cloud låter dig skapa en bild av en befintlig virtuell maskin, och på grundval av den kan du skapa hur många identiska maskiner som helst. Det är precis detta vi kommer att använda. För att enkelt samla ihop bilden använder vi verktyget från HashiCorp. Det tar en json-fil som input med instruktioner för att skapa bilden.
Vår json-fil kommer att bestå av två block: builders och provisioners. Den första blocket beskriver parametrar för själva bilden som entity, och den andra ger instruktioner för att fylla den med önskat innehåll.
Builders
{
"builders": [
    {
      "type": "yandex",
      "endpoint": "{{user `endpoint`}}",
      "folder_id": "",
      "subnet_id": "{{user `subnet_id`}}",
      "zone": "{{user `zone`}}",
      "labels": {},
      "use_ipv4_nat": true,
      "use_internal_ip": false,
      "service_account_key_file": "",
      "image_name": "grafana-{{timestamp}}",
      "image_family": "grafana",
      "image_labels": {},
      "image_description": "GRAFANA",
      "source_image_family": "ubuntu-1804-lts",
      "disk_size_gb": 3,
      "disk_type": "network-hdd",
      "ssh_username": "ubuntu"
    }
  ],
...
}
I denna mall måste du ange identifieraren för avsnittet i molnet där du vill skapa bilden, samt vägen till filen med nycklarna för servicekontot som tidigare skapats i detta avsnitt. Du kan läsa mer om hur du skapar servicekonton och nycklar i filformat i den relevanta sektionen. .
Denna konfiguration anger att bilden av disken kommer att byggas på grundval av plattformen ubuntu-1804-lts, placerad i det relevanta avsnittet för användaren i bilden. GRAFANA under namnet grafana-{{timestamp}}.
Provisioners
Nu börjar den intressanta delen av konfigurationen. Här kommer vi att beskriva de steg som måste utföras på den virtuella maskinen innan dess tillstånd fryses i en diskavbildning.
{
...,
"provisioners": [
    {
            "type": "shell",
            "pause_before": "5s",
            "scripts": [
                "prepare-ctg.sh"
            ]
        },
    {
            "type": "file",
            "source": "setup.sh",
            "destination": "\/opt\/grafana\/setup.sh"
        },
        {
            "type": "shell",
        "execute_command": "sudo {{ .Vars }} bash '{{ .Path }}'",
            "pause_before": "5s",
            "scripts": [
                "install-packages.sh",
                "grafana-setup.sh",
                "run-setup-at-reboot.sh"
        ]
        }
  ]
}
Här är alla åtgärder uppdelade i tre steg. I det första steget körs ett enkelt skript som skapar en hjälpmapp.
prepare-ctg.sh:
#!/bin/bash
sudo mkdir -p /opt/grafana
sudo chown -R ubuntu:ubuntu /opt/grafana
I nästa steg placerar vi skriptet i denna mapp som måste köras direkt efter att den virtuella maskinen har startats. Det här skriptet kommer att skriva in användarvariablerna som måste anges i Grafana-konfigurationen och starta om webbservern.
setup.sh:
#!/bin/bash
CLUSTER_ID="<cluster_id>"
USERNAME="<username>"
PASSWORD="<password>"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@c-${CLUSTER_ID}.rw.mdb.yandexcloud.net#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
Efter detta återstår det tre saker:
1) installera paketen
2) aktivera Grafana i systemctl och installera ClickHouse-pluginet
3) ställa in skriptet setup.sh i kö för att köras direkt efter att den virtuella maskinen har startats.
install-packages.sh:
#!/bin/bash
sudo systemd-run --property='After=apt-daily.service apt-daily-upgrade.service' --wait /bin/true
sudo apt-get install -y apt-transport-https
sudo apt-get install -y software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
grafana-setup.sh:
#!/bin/bash
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
run-setup-at-reboot.sh:
#!/bin/bash
chmod +x /opt/grafana/setup.sh
cat > /etc/cron.d/first-boot <<EOF
PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin:/usr/games:/usr/local/games
@reboot root /bin/bash /opt/grafana/setup.sh > /var/log/yc-setup.log 2>&1
EOF
chmod +x /etc/cron.d/first-boot;
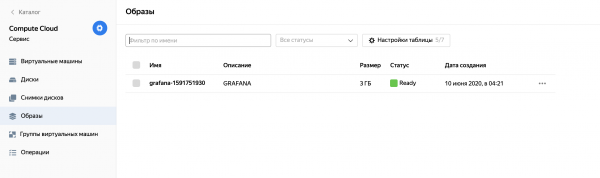
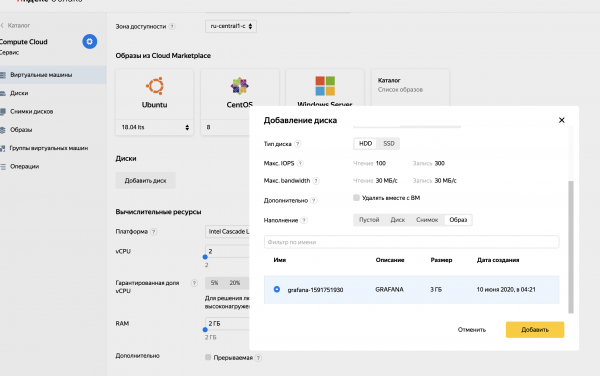
Nu återstår det att köra Packer så att vi får en bild som placeras i den angivna partitionen. Vid skapandet av den virtuella maskinen kan vi välja den som startdisk och vid start få en färdig Grafana-webbserver.
Instansgrupp och lastbalanserare
När en diskavbildning har skapats som gör det möjligt att skapa flera identiska Grafana-webbservrar, kan vi skapa en instansgrupp. På Yandex Cloud kallas denna term för en samling virtuella maskiner med samma egenskaper. Vid skapandet av en instansgrupp konfigureras prototypen för alla maskiner i denna grupp och sedan egenskaperna för själva gruppen (till exempel minimi- och maximalt antal aktiva maskiner). Om det aktuella antalet inte motsvarar dessa kriterier, kommer instansgruppen själv att ta bort onödiga maskiner eller skapa nya i enlighet med förebilden.
I vårt fall kommer vi att skapa en instansgrupp av webbservrar som kommer att genereras från den diskavbildning som skapades tidigare.
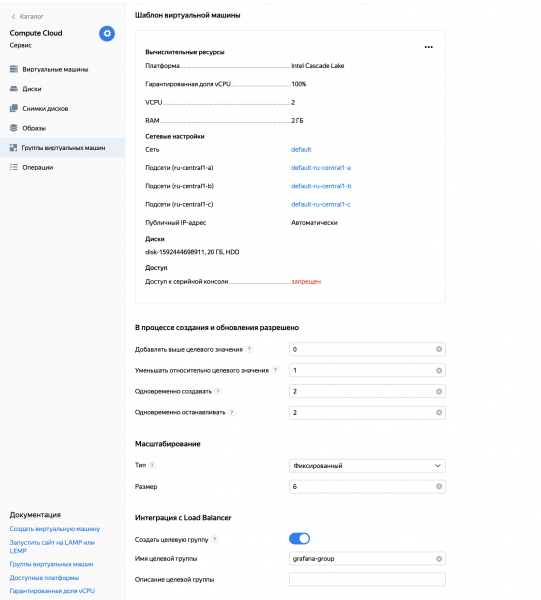
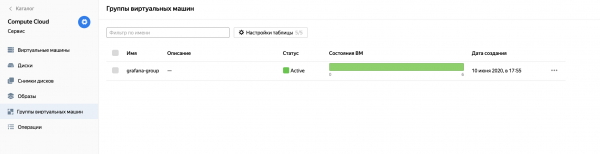
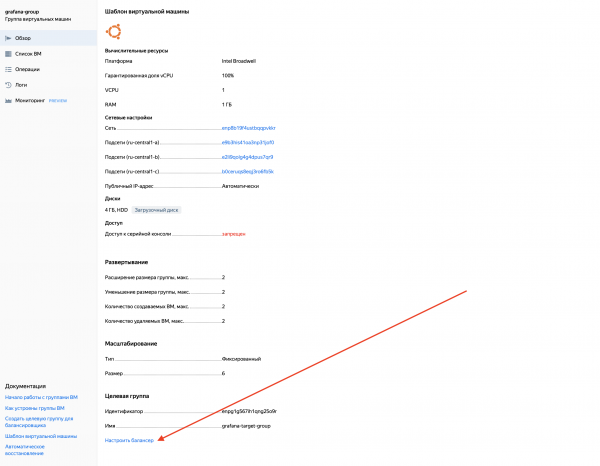
Den senaste inställningen av instansgruppen är verkligen anmärkningsvärd. Målgruppen i integrationen med Load Balancer kommer att hjälpa till att konfigurera L3-balansaren ovanför virtuella maskiner i denna grupp med ett par knapptryckningar.
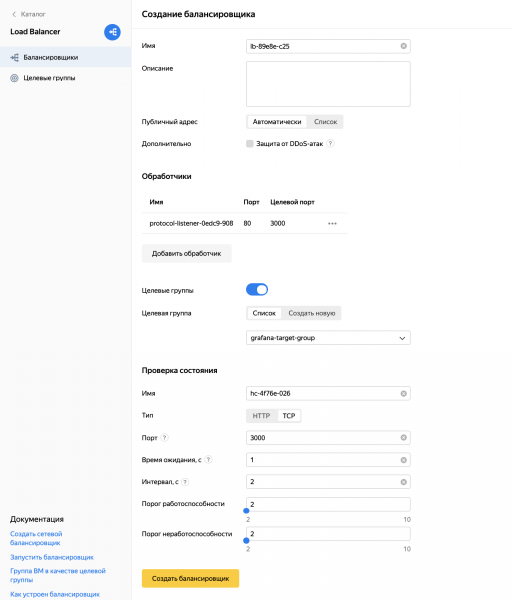
Vid konfigurationen av balansaren genomförde jag två viktiga aspekter:
- Jag gjorde det så att balansaren tar emot användartrafik på port 80, och omdirigerar den till port 3000 på de virtuella maskinerna, där Grafana ligger.
- Jag konfigurerade livskontrollen av maskinerna genom att pinga dem på port 3000.
Mini-sammanfattning
Äntligen lyckades vi manuellt implementera den önskade applikationsinfrastrukturen, och nu har vi en högt tillgänglig Grafana-tjänst. Det krävs bara att veta IP-adressen till balansaren som ingångspunkt för applikationen och värden för ClickHouse-klustret, för att ladda datasetet dit.
Verkar det vara en seger? Ja, det är en seger. Men något känns fortfarande off. Hela processen ovan kräver väldigt många manuella åtgärder och är helt omöjlig att skala, vi vill automatisera den så mycket som möjligt. Det här kommer nästa avsnitt att handla om.
Integration med Terraform
Vi kommer återigen att använda verktyget från företaget HashiCorp som heter . Det kommer att hjälpa oss att med ett knapptryck implementera hela applikationsinfrastrukturen, baserat på några variabler som användaren skickar. Låt oss skriva ett recept som kan köras flera gånger i olika områden för olika användare.
Allt arbete med Terraform handlar om att skriva en konfigurationsfil (*.tf) och att skapa infrastrukturen baserat på den.
Variabler
I början av filen kommer vi att föra ut variabler, från vilka det beror på var och hur den framtida infrastrukturen kommer att implementeras.
variable "oauth_token" {
    type = string
    default = ""
}
variable "cloud_id" {
    type = string
    default = ""
}
variable "folder_id" {
    type = string
    default = ""
}
variable "service_account_id" {
    type = string
    default = ""
}
variable "image_id" {
    type = string
    default = ""
}
variable "username" {
    type = string
    default = ""
}
variable "password" {
    type = string
    default = ""
}
variable "dbname" {
    type = string
    default = ""
}
variable "public_key_path" {
    type = string
    default = ""
}
Hela processen med att implementera applikationen kommer att reduceras till att bygga en diskbild och ställa in dessa variabler. Jag förklarar vad de svarar för:
oauth_token — en token för att få tillgång till molnet. Kan erhållas via .
cloud_id — identifierare för molnet där vi kommer att implementera applikationen
folder_id — identifier för sektionen där vi kommer att distribuera applikationen
service_account_id — identifier för servicekontot i den aktuella sektionen av molnet.
image_id — identifier för diskavbildningen som erhållits med hjälp av Packer
username och password — användarnamn och lösenord för åtkomst till både databaserna och Grafana-webbservern
dbname — namn på databasen inom kluster CH och MySQL
public_key_path — sökväg till filen med din offentliga ssh-nyckel, som kan användas för att ansluta som ubuntu till virtuella maskiner med webbservrar
Leverantörens inställningar
Nu behöver vi konfigurera Terraform-leverantören — i vårt fall Yandex:
provider "yandex" {
  token     = var.oauth_token
  cloud_id  = var.cloud_id
  folder_id = var.folder_id
  zone      = "ru-central1-a"
}
Man kan märka att vi här använder variabler som angivits ovan.
Nätverk och kluster
Nu ska vi skapa ett nätverk där elementen i vår infrastruktur ska kommunicera, tre delnät (ett i varje region) och höja kluster för CH och MySQL.
resource "yandex_vpc_network" "grafana_network" {}

resource "yandex_vpc_subnet" "subnet_a" {
  zone           = "ru-central1-a"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.1.0.0\/24"]
}

resource "yandex_vpc_subnet" "subnet_b" {
  zone           = "ru-central1-b"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.2.0.0\/24"]
}

resource "yandex_vpc_subnet" "subnet_c" {
  zone           = "ru-central1-c"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.3.0.0\/24"]
}

resource "yandex_mdb_clickhouse_cluster" "ch_cluster" {
  name        = "grafana-clickhouse"
  environment = "PRODUCTION"
  network_id  = yandex_vpc_network.grafana_network.id

  clickhouse {
    resources {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 16
    }
  }

  zookeeper {
    resources {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 10
    }
  }

  database {
    name = var.dbname
  }

  user {
    name     = var.username
    password = var.password
    permission {
      database_name = var.dbname
    }
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}

resource "yandex_mdb_mysql_cluster" "mysql_cluster" {
  name        = "grafana_mysql"
  environment = "PRODUCTION"
  network_id  = yandex_vpc_network.grafana_network.id
  version     = "8.0"

  resources {
    resource_preset_id = "s2.micro"
    disk_type_id       = "network-ssd"
    disk_size          = 16
  }

  database {
    name = var.dbname
  }

  user {
    name     = var.username
    password = var.password
    permission {
      database_name = var.dbname
      roles         = ["ALL"]
    }
  }

  host {
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }
  host {
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }
  host {
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}
Som du kan se är varje av de två klustren skapade på ett sätt som gör dem ganska motståndskraftiga genom att de är placerade i tre tillgänglighetszoner.
Webbservrar
Det kan tyckas att jag kunde fortsätta på samma sätt, men jag stötte på en svårighet. Tidigare startade jag först MySQL-klustret och bara efter det, när jag kände till dess ID, samlade jag en diskavbild med den nödvändiga konfigurationen där jag angav värden till klustret. Men nu känner vi inte till kluster-ID:t förrän Terraform har kört, vilket även gäller vid skapandet av avbilden. Därför var jag tvungen att använda följande .
Genom att använda Amazons metadata-tjänst kommer vi att överföra vissa parametrar till den virtuella maskinen som den kommer att acceptera och bearbeta. Vi behöver att efter starten ska maskinen hämta metadata för MySQL-klustret och för användarnamn-lösenord som användaren angav i Terraform-filen. Litet ändrar vi innehållet i filen setup.sh, som körs när den virtuella maskinen slås på.
setup.sh:
#!/bin/bash
CLUSTER_URI="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/mysql_cluster_uri)"
USERNAME="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/username)"
PASSWORD="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/password)"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@${CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
Instansgrupp och lastbalanserare
Genom att återkompilera den nya diskavbilden kan vi äntligen skriva klart vår fil för Terraform.
Vi anger att vi vill använda en befintlig diskavbild:
data "yandex_compute_image" "grafana_image" {
  image_id = var.image_id
}
Nu ska vi skapa en instansgrupp:
resource "yandex_compute_instance_group" "grafana_group" {
  name               = "grafana-group"
  folder_id          = var.folder_id
  service_account_id = var.service_account_id
  instance_template {
    platform_id = "standard-v1"
    resources {
      memory = 1
      cores  = 1
    }
    boot_disk {
      mode = "READ_WRITE"
      initialize_params {
        image_id = data.yandex_compute_image.grafana_image.id
        size     = 4
      }
    }
    network_interface {
      network_id = yandex_vpc_network.grafana_network.id
      subnet_ids = [yandex_vpc_subnet.subnet_a.id, yandex_vpc_subnet.subnet_b.id, yandex_vpc_subnet.subnet_c.id]
      nat = "true"
    }
    metadata = {
      mysql_cluster_uri = "c-${yandex_mdb_mysql_cluster.mysql_cluster.id}.rw.mdb.yandexcloud.net:3306/${var.dbname}"
      username = var.username
      password = var.password
      ssh-keys = "ubuntu:${file("${var.public_key_path}")}"
    }
    network_settings {
      type = "STANDARD"
    }
  }

  scale_policy {
    fixed_scale {
      size = 6
    }
  }

  allocation_policy {
    zones = ["ru-central1-a", "ru-central1-b", "ru-central1-c"]
  }

  deploy_policy {
    max_unavailable = 2
    max_creating    = 2
    max_expansion   = 2
    max_deleting    = 2
  }

  load_balancer {
    target_group_name = "grafana-target-group"
  }
}
Det är värt att notera hur vi överförde till metadata cluster_uri, username och password. Det är just dessa som den virtuella maskinen vid starten kommer att hämta och placera i Grafana-konfigurationen.
Nu är det dags för lastbalanseraren.
resource "yandex_lb_network_load_balancer" "grafana_balancer" {
  name = "grafana-balancer"

  listener {
    name = "grafana-listener"
    port = 80
    target_port = 3000
    external_address_spec {
      ip_version = "ipv4"
    }
  }

  attached_target_group {
    target_group_id = yandex_compute_instance_group.grafana_group.load_balancer.0.target_group_id

    healthcheck {
      name = "healthcheck"
      tcp_options {
        port = 3000
      }
    }
  }
}
Lite socker
Det återstår bara en liten sak. Efter att infrastrukturen har rullats ut måste vi gå till Grafana UI och manuellt lägga till CH-klustret (vars ID vi fortfarande behöver hämta) som datakälla. Men Terraform vet ju redan kluster-ID. Vi får be den att få jobbet gjort.
Vi lägger till en ny leverantör — Grafana, och som värd ger vi den IP-adressen till lastbalanseraren. Alla ändringar som Terraform gör på maskinen, som lastbalanseraren bestämmer, kommer att växa in i MySQL, vilket innebär att de kommer att reflekteras på alla andra maskiner.
provider "grafana" {
  url  = "http://${[for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0}"
  auth = "${var.username}:${var.password}"
}

resource "grafana_data_source" "ch_data_source" {
  type          = "vertamedia-clickhouse-datasource"
  name          = "grafana"
  url           = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
  basic_auth_enabled = "true"
  basic_auth_username = var.username
  basic_auth_password = var.password
  is_default = "true"
  access_mode = "proxy"
}
Kamma
Vi kommer att få fram IP-adressen till lastbalanseraren och värden för ClickHouse-klustret
output "grafana_balancer_ip_address" {
  value = [for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0
}

output "clickhouse_cluster_host" {
  value = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
}
Körning kan börja
Det är klart! Vår konfigurationsfil är redo och vi kan, efter att ha ställt in variablerna, be Terraform att starta allt vi har beskrivit ovan. Hela processen tog mig ungefär 15 minuter.
I slutet kan man se ett fint meddelande:
Apply complete! Resources: 9 added, 0 changed, 0 destroyed.
Outputs:

clickhouse_cluster_host = https://c-c9q14ipa2ngadqsbp2iq.rw.mdb.yandexcloud.net:8443
grafana_balancer_ip_address = 130.193.50.25
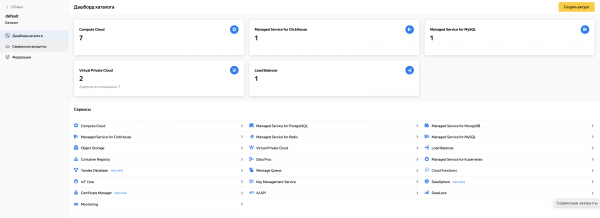
Och i molnet kommer element av den uppsatta infrastrukturen att synas:
Sammanfattningsvis
Nu, med exemplet från Grafana, kan var och en av er lära sig att distribuera applikationer med en rik cloud-arkitektur på Yandex.Cloud-plattformen. Verktyg från HashiCorp som Packer och Terraform kan hjälpa dig med detta. Jag hoppas att denna artikel är till nytta för någon 🙂
P.S. Jag kommer att bifoga en länk till ett förråd där du kan hitta färdiga recept för Packer och Terraform, vars fragment jag refererade till i denna artikel.
Källa: habr.com
