

Hej alla! Vi har fantastiska nyheter, i juni startar OTUS återigen en kurs , därför delar vi traditionellt med oss av användbart material till er.
Om du har stött på hela denna historia med mikrotjänster utan något sammanhang, kan du kanske tycka att den är lite konstig. Att bryta ner en applikation i fragment som är kopplade till varandra via nätverket innebär nödvändigtvis att man måste lägga till komplexa felhanteringsmetoder i det resulterande distribuerade systemet.
Trots att denna metod inkluderar uppdelning i många oberoende tjänster, är det slutgiltiga målet mycket mer än bara att dessa tjänster fungerar på olika maskiner. Det handlar om interaktion med omvärlden, som i sin natur också är distribuerad. Inte i teknisk mening, utan snarare i mening av ett ekosystem som består av många människor, team och program, och varje del måste på sitt sätt utföra sitt arbete.
Företag, till exempel, representerar en uppsättning distribuerade system som tillsammans bidrar till att nå ett visst mål. Vi har ignorerat denna fakta i årtionden, på jakt efter sammanslagning, genom att överföra filer via FTP eller använda företagsintegrationsverktyg, samtidigt som vi har fokuserat på våra egna isolerade mål. Men med tjänsternas ankomst förändrades allt. Tjänster har hjälpt oss att se bortom horisonten och upptäcka en värld av ömsesidigt beroende program som arbetar tillsammans. Men för att lyckas måste vi erkänna och konstruera två helt olika världar: den externa världen, där vi lever i ett ekosystem av många andra tjänster, och vår personliga, interna värld, där vi härskar ensamma.
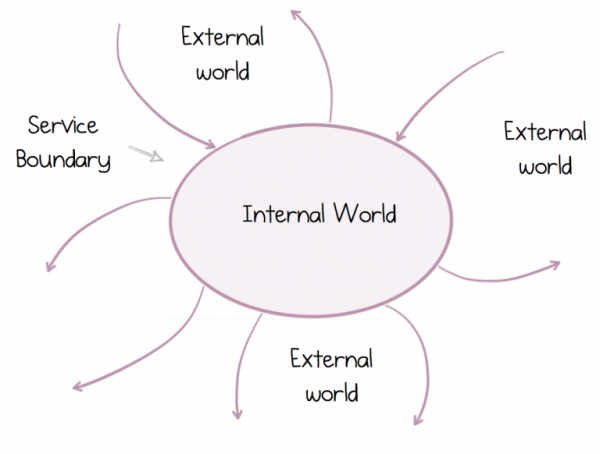
Denna distribuerade värld skiljer sig från den vi växte upp i och är vana vid. Principerna för att bygga traditionell monolitisk arkitektur håller inte för granskning. Därför är en korrekt förståelse av sådana system mer än bara att skapa en snygg skiss på en vit tavla eller ett imponerande bevis på konceptet. Det handlar om att sådana system måste fungera framgångsrikt under lång tid. Lyckligtvis har tjänster funnits ganska länge, även om de ser olika ut. är fortfarande relevanta, även om de är kryddade med Docker, Kubernetes och lite slitna hiptster-skägg.
Så idag ska vi titta på hur reglerna har förändrats, varför vi behöver ompröva vårt tillvägagångssätt till tjänster och den data de utbyter med varandra, och varför vi kommer att behöva helt andra verktyg för detta.
Inkapsling kommer inte alltid vara din vän.
Mikrotjänster kan fungera oberoende av varandra. Just denna egenskap ger dem det största värdet. Denna egenskap möjliggör också att tjänster kan skala och växa. Inte så mycket i termer av att skala till kvadriljoner användare eller petabyte data (även om de kan hjälpa till där också), utan i termer av att skala i fråga om människor, eftersom team och organisationer ständigt växer.
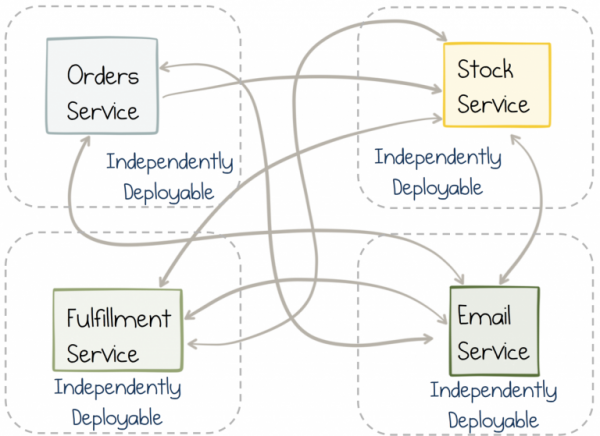
Men oberoende är ett dubbeläggat svärd. Det vill säga, en tjänst kan enkelt och smidigt köras på egen hand. Men om en funktion inom tjänsten kräver att en annan tjänst aktiveras, så måste vi i slutändan göra ändringar i båda tjänsterna nästan samtidigt. I en monolit är det enkelt, man gör bara ändringen och skickar ut den, men i fallet med samordning av oberoende tjänster finns det fler problem. Koordinering mellan team och releasecykler undergräver flexibelheten.
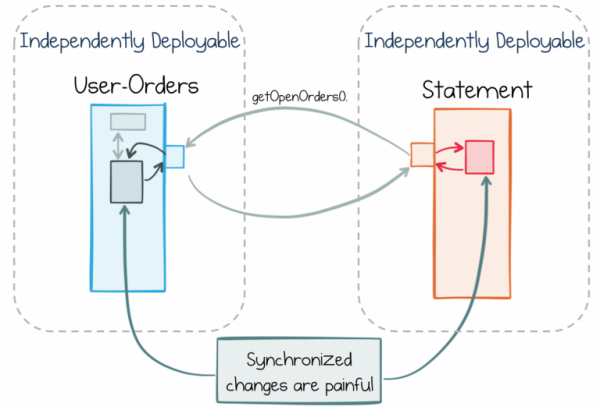
Inom den standardmetoden försöker man helt enkelt undvika frustrerande tvärgående förändringar genom att tydligt separera funktionaliteten mellan tjänsterna. En systemets enhetliga ingångstjänst kan här vara ett bra exempel. Den har en klart definierad roll som särskiljer den från andra tjänster. En sådan tydlig separation innebär att i en värld av snabbt föränderliga krav på kringliggande tjänster, lär systemets enhetliga ingångstjänst sällan att förändras. Den existerar inom en strikt avgränsad kontext.
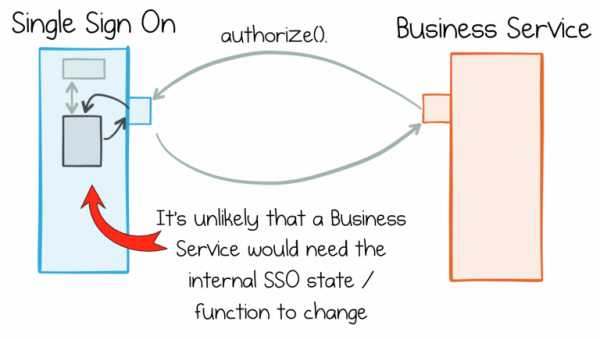
Problemet är att affärstjänster i verkligheten inte kan upprätthålla en konstant tydlig separation av roller. Till exempel arbetar dessa affärstjänster i större utsträckning med data som kommer från andra liknande tjänster. Om du bedriver e-handel kommer hantering av beställningsflöden, produktkataloger eller användarinformation att vara ett krav för många av dina tjänster. Varje tjänst behöver tillgång till dessa data för att fungera.
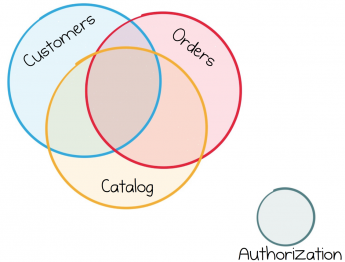
De flesta affärstjänster använder samma datakälla, vilket gör att deras arbete alltid sammanflätas.
Så vi har kommit till en viktig punkt som förtjänar att diskuteras. Medan tjänster fungerar bra för infrastrukturella komponenter som i stor utsträckning är avskilda, visar det sig att de flesta affärstjänster är mycket mer tät sammanflätade.
Datanikomi
Tjänsteorienterade tillvägagångssätt kan redan existera, men det finns fortfarande brist på information om hur man utbyter stora datamängder mellan tjänster.
Huvudproblemet är att data och tjänster är oskiljaktiga. Å ena sidan uppmanar inkapsling oss att dölja data så att tjänster kan separeras från varandra, vilket underlättar deras tillväxt och vidare förändringar. Å andra sidan behöver vi ha möjlighet att fritt dela och förvalta gemensamma data, precis som med alla andra. Det handlar om att kunna börja arbeta genast, lika fritt som i vilket annat informationssystem som helst.
Men informationssystem har lite gemensamt med inkapsling. Faktum är att det är motsatsen. Databaser gör allt de kan för att ge tillgång till de data som lagras i dem. De levereras med ett kraftfullt deklarativt gränssnitt som låter dig modifiera data enligt dina behov. Denna funktionalitet är viktig i forskningsskedet, men inte för att hantera den växande komplexiteten hos en ständigt utvecklande tjänst.
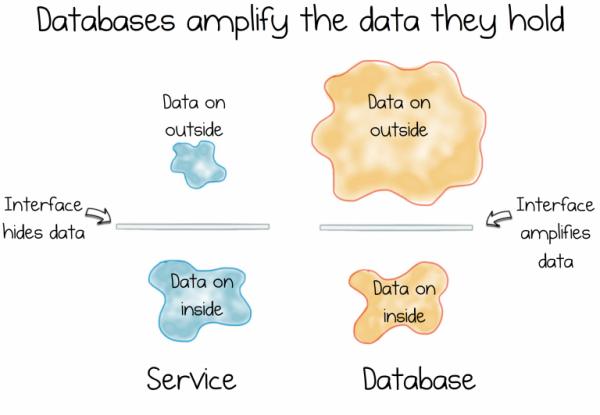
Och här uppstår dilemman. Motsägelser. Dikotomier. För informationssystem handlar det om att tillhandahålla data, medan tjänster handlar om att dölja.
Dessa två krafter är fundamentala. De ligger till grund för det mesta av vårt arbete, ständigt kämpande om överlägsenhet i de system vi skapar.
Allteftersom tjänstesystem växer och utvecklas ser vi olika manifestationer av konsekvenserna av datadichotomier. Antingen kommer tjänstens gränssnitt att växa, erbjuda en alltmer omfattande uppsättning funktioner och börja likna en mycket egenhändigt skapad databas, eller så drabbas vi av besvikelse och måste implementera ett sätt att extrahera eller flytta hela datamängder från tjänst till tjänst.
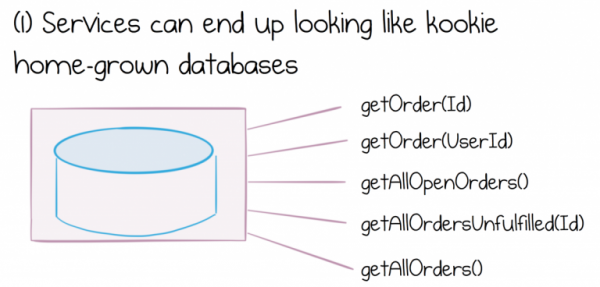
Att skapa något som ser ut som en egenhändigt skapad databas leder i sin tur till en rad problem. Vi går inte in på detaljer om vad som är farligt med shared database, utan säger bara att det medför betydande kostsamma tekniska och operativa för ett företag som försöker använda den.
Värre är att datavolymerna förvärrar problemen med tjänstebehovens gränser. Ju fler gemensamma data som finns inom en tjänst, desto mer komplicerat blir gränssnittet och desto svårare blir det att kombinera datamängder som kommer från olika tjänster.
Ett alternativt tillvägagångssätt för att extrahera och flytta hela datamängder har också sina problem. Den vanligaste metoden ser ut som en enkel extraktion och lagring av datamängden i sin helhet, för att sedan lagra den lokalt i varje mottagande tjänst.
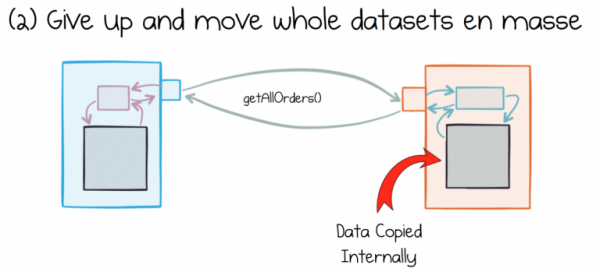
Problemet är att olika tjänster tolkar de data de konsumerar på olika sätt. Dessa data finns alltid tillgängliga. De ändras och bearbetas lokalt. Snart har de inte längre något gemensamt med de data som finns i källan.
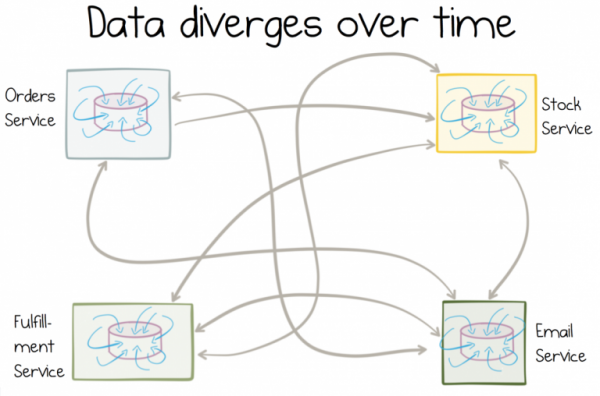
Ju mer muterbara kopiorna blir, desto mer kommer data att avvika med tiden.
Vad som är ännu värre är att sådana data är svåra att korrigera i efterhand ( kan verkligen hjälpa här). Faktum är att vissa av de svåröverblickbara tekniska problem som företag står inför uppstår på grund av heterogena data som multipliceras från applikation till applikation.
För att hitta en lösning på detta problem med gemensamma data måste vi tänka annorlunda. De måste bli förstklassiga objekt i de arkitekturer vi bygger. benämner sådan data som "extern", och det är en mycket viktig egenskap. Vi behöver inkapsling för att inte avslöja den inre strukturen av tjänsten, men vi måste underlätta åtkomsten till delad data för tjänster så att de kan utföra sina uppgifter korrekt.
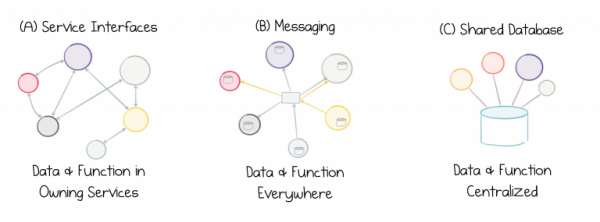
Problemet är att ingen av metoderna idag är relevanta längre, eftersom varken tjänstegränssnitt, meddelandeflöden eller delad databas erbjuder en bra lösning för arbete med externa data. Tjänstegränssnitt passar dåligt för datadelning i någon skala. Meddelandeflöden flyttar data, men lagrar inte deras historia, vilket gör att data blir skadade över tid. Delade databaser fokuserar för mycket på en enda punkt, vilket hindrar utvecklingen av framsteg. Vi hamnar oundvikligen i en cykel av otillräcklighet av data:
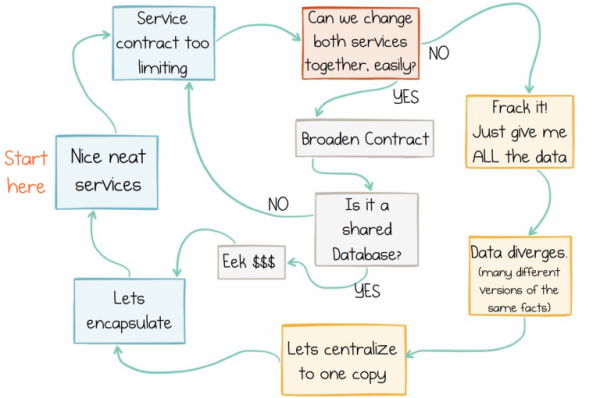
Cykel av otillräcklighet av data
Flöden: en decentraliserad metod för data och tjänster
I idealfallet behöver vi förändra sättet på vilket tjänster arbetar med gemensam data. Just nu står varje metod inför den tidigare nämnda dikotomin, eftersom det inte finns någon magisk lösning som kan strös generöst för att få den att försvinna. Men vi kan omformulera problemet och nå en kompromiss.
Denna kompromiss innebär en viss grad av centralisering. Vi kan dra nytta av mekanismen för distribuerade loggar, eftersom den erbjuder tillförlitliga skalbara flöden. Nu behöver tjänster kunna ansluta och arbeta med dessa gemensamma flöden, men vi vill undvika komplexa centraliserade God Service:er som utför sådan bearbetning. Därför är det bästa alternativet att integrera strömbehandling i varje tjänst-konsument. På så sätt kan tjänster kombinera datamängder från olika källor och arbeta med dem som de behöver.
Ett sätt att nå en sådan metod är att använda en strömmande plattform. Det finns många alternativ, men idag kommer vi att titta på just Kafka, eftersom dess Stateful Stream Processing effektivt löser det presenterade problemet.
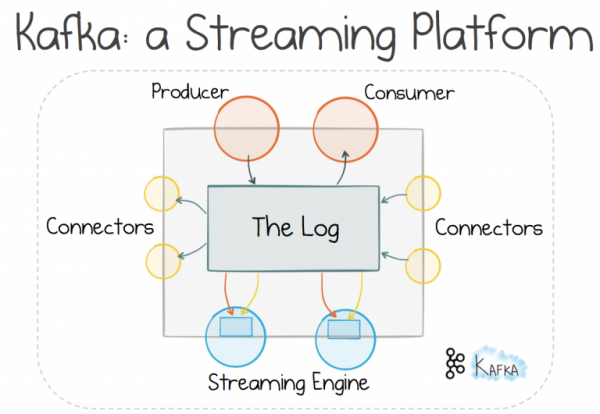
Användningen av mekanismen för distribuerad loggning gör att vi kan gå på den stig som redan har trampats, och använda meddelandeflöden för att arbeta med . Det anses att detta tillvägagångssätt ger bättre skalbarhet och separation än "request-response"-mekanismen, eftersom det ger mottagaren snarare än avsändaren kontroll över flödet. Men för allt i livet får man betala, och här behöver du en broker. Men för stora system är denna kompromiss värd det (vilket inte gäller för dina genomsnittliga webbapplikationer).
Om det distribuerade loggandet hanteras av en broker snarare än ett traditionellt meddelandesystem kan ytterligare funktioner utnyttjas. Transporten kan skalas linjärt nästan lika bra som ett distribuerat filsystem. Data kan lagras i loggar ganska länge, så vi får inte bara meddelandeutbyte utan också lagring av information. Skalbar lagring utan rädsla för att få ett förändrat gemensamt tillstånd.
Därefter kan en stateful stream processing-mekanism (bearbetning av ström med bevarande av tillstånd) användas för att lägga till deklarativa databasverktyg i konsumenttjänster. Detta är en mycket viktig tanke. Så länge data lagras i gemensamma strömmar, som alla tjänster kan få tillgång till, är sammanfogningen och bearbetningen som görs av tjänsten privata. De visar sig vara isolerade inom en strikt begränsad kontext.
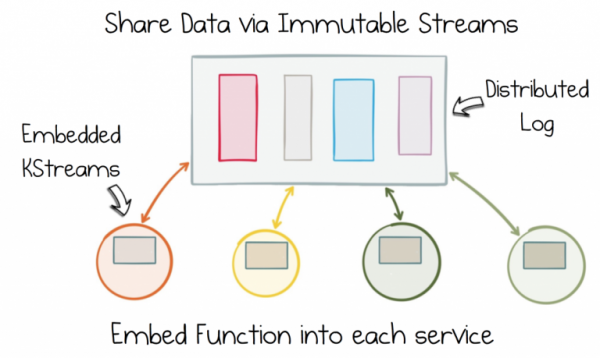
Bli av med dikotomin av data genom att dela upp den immutabla flödet av tillstånd. Lägg sedan till denna funktion i varje tjänst med hjälp av Stateful Stream Processing.
Så om din tjänst måste arbeta med beställningar, produktkataloger, lager, så kommer den att ha full tillgång: endast du bestämmer vilka data som ska sammanfogas, var de ska bearbetas och hur de ska förändras över tid. Trots att data är gemensamma, är arbetet med dem helt decentraliserat. Det utförs inom varje tjänst, i en värld där allt går efter dina regler.
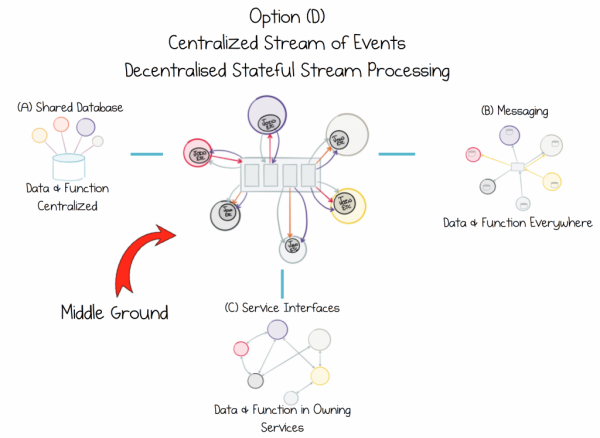
Dela data på ett sätt som inte bryter deras integritet. Kapsla in funktionen, inte källan, i varje tjänst som behöver den.
Det händer att data behöver flyttas i bulk. Ibland kräver tjänsten ett lokalt historiskt dataset i den valda databashanteraren. Nyckeln är att man kan garantera att en kopia kan återställas från källan vid behov genom att använda den distribuerade loggmekanismen. Anslutare i Kafka gör ett utmärkt jobb med denna uppgift.
Så, den metod vi diskuterat idag har flera fördelar:
- Data används i form av gemensamma flöden som kan lagras länge i loggar, och själva mekanismen för att hantera gemensamma data är inbyggd i varje separat kontext, vilket gör att tjänster kan fungera enkelt och snabbt. På detta sätt kan man balansera data-dikotomin.
- Data som kommer från olika tjänster kan enkelt kombineras i dataset. Detta förenklar interaktionen med gemensamma data och eliminerar behovet av att stödja lokala dataset i databasen.
- Stateful Stream Processing cachar bara data, och den sanna källan förblir de gemensamma loggarna, så problemet med dataskador över tid är inte så uttalat.
- I sin kärna styrs tjänster av data, vilket innebär att trots den ständiga ökningen av datavolymer, kan tjänster fortfarande snabbt reagera på affärshändelser.
- Skalbarhetsproblem hamnar på mäklaren, inte på tjänsterna. Detta minskar betydligt komplexiteten i att skriva tjänster, eftersom det inte finns något behov av att tänka på skalbarhet.
- Att lägga till nya tjänster kräver inga ändringar av de gamla, vilket gör att anslutningen av nya tjänster blir enklare.
Som ni ser är detta mer än bara REST. Vi har fått en uppsättning verktyg som möjliggör decentraliserad hantering av gemensamma data.
I dagens artikel har vi inte täckt alla aspekter. Vi behöver fortfarande bestämma hur man balanserar mellan "fråga-svar"-paradigmen och eventdriven paradigm. Men det kommer vi att ta itu med nästa gång. Det finns ämnen som vi behöver bekanta oss bättre med, såsom varför Stateful Stream Processing är så bra. Detta kommer vi att prata om i den tredje artikeln. Dessutom finns det andra kraftfulla konstruktioner som vi kan utnyttja om vi vänder oss till dem, exempelvis, . Det förändrar spelets regler för distribuerade affärssystem, eftersom denna konstruktion säkerställer transaktionsgarantier för i en skalbar form. Detta kommer att diskuteras i den fjärde artikeln. Och slutligen behöver vi gå igenom detaljerna för implementeringen av dessa principer.
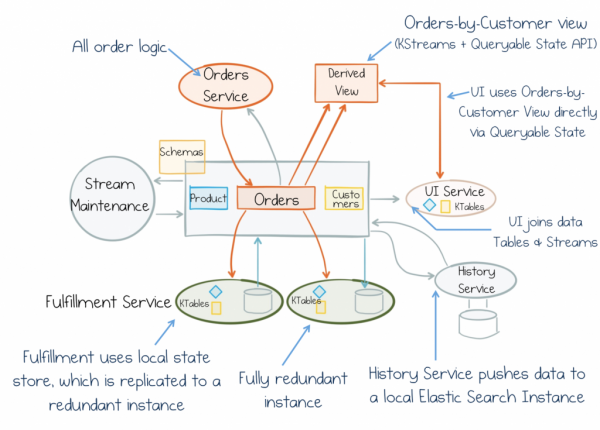
Men kom ihåg detta: datadikotomi är den kraft vi står inför när vi skapar affärstjänster. Och vi måste tänka på det. Fokus är att vända allt upp och ner och börja betrakta gemensamma data som förstklassiga objekt. Stateful Stream Processing erbjuder en unik kompromiss för detta. Det undviker centraliserade "God Components" som begränsar utvecklingens framsteg. Dessutom säkerställer det snabbhet, skalbarhet och felresistens i datastreaming-pipelines och integrerar dem i varje tjänst. Därför kan vi fokusera på det gemensamma medvetandet som vilken tjänst som helst kan ansluta sig till och arbeta med dess data. Så tjänster blir mer skalbara, utbytbara och autonoma. Därför kommer de inte bara att se bra ut på whiteboards och vid hypotesprövningar, utan också fungera och utvecklas i årtionden.
Källa: habr.com
