

Introduktion
Informationssystemet definieras väl ur användarens perspektiv i GOST RV 51987 – "ett automatiserat system vars resultat av dess funktion är presentationen av utdata för vidare användning". Om vi betraktar den interna strukturen så är i grund och botten varje IS ett system av genomförda algoritmer i kod. I en bredare mening av Turing-Churchs tes genomför algoritmen (och därmed IS) en transformation av många ingångsdata till många utgångsdata.
Man kan till och med säga att meningen med en informationssystems existens ligger i transformationen av ingångsdata. Följaktligen definieras värdet av IS och hela komplexet av IS genom värdet av ingående och utgående data.
Baserat på detta bör designen inledas med och ta hänsyn till data, vilket anpassar arkitektur och metoder till datans struktur och betydelse.
Lagrade data
Ett nyckels steg i förberedelserna för design är att erhålla egenskaperna för alla dataset som planeras att behandlas och lagras. Dessa egenskaper inkluderar:
— Datamängd;
— Information om livscykeln för data (tillväxt av nya data, livslängd, behandling av föråldrad data);
— Klassificering av data ur perspektivet av påverkan på företagets huvudverksamhet (de tre hörnstenarna sekretess, integritet, tillgänglighet) tillsammans med finansiella indikatorer (t.ex. kostnaden för dataförlust under den senaste timmen);
— Geografi för databehandling (fysisk plats för behandlingssystem);
— Regelverkskrav för varje dataklass (t.ex. Federal Law-152, PCI DSS).
Informationssystem
Data lagras inte bara, utan bearbetas också (transformeras) av informationssystem. Nästa steg efter att ha fått dataegenskaper är att göra en så fullständig inventering av informationssystemen som möjligt, deras arkitektoniska egenskaper, ömsesidiga beroenden och krav på infrastruktur i enhetliga mått för fyra typer av resurser:
— Processorkraft;
— Mängd RAM;
— Krav på volym och prestanda för lagringssystem;
— Krav på datakommunikationsnät (externa kanaler, kanaler mellan IS-komponenter).
Krav måste finnas för varje tjänst/mikrotjänst inom IS.
Det är särskilt viktigt att notera den information som är nödvändig för korrekt design, som angett i form av kostnaden för driftstopp av IS (i rubel per timme).
Hotmodell
Det måste finnas en formell hotmodell som skyddar data/tjänster. Denna hotmodell omfattar inte bara aspekter av konfidentialitet utan även integritet och tillgänglighet. D.v.s. till exempel:
— Fel på den fysiska servern;
— Fel på top-of-the-rack-switchen;
— Avbrott i den optiska kommunikationskanalen mellan datacenter;
— Fel på den operationella lagringslösningen helt.
I vissa fall skrivs hotmodeller inte bara för infrastrukturella komponenter utan också för specifika IS eller deras komponenter, såsom ett fel i DBMS med logisk förstöring av datakonstruktionen.
Alla beslut inom projektet för att skydda mot odefinierade hot är överflödiga.
Regulatoriska krav
Om de behandlade uppgifterna omfattas av särskilda regler som ställs av regulatorer, behövs nödvändigtvis information om datamängder och regler för behandling/lagring.
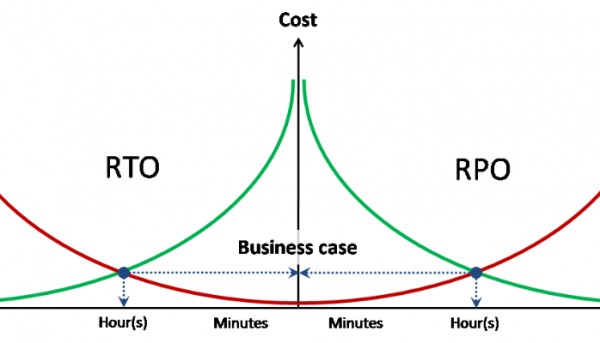
Mål RPO/RTO
Design av alla typer av skydd kräver närvaro av indikatorer för mål för datarförlust och måltid för återställande av tjänsten för varje av de beskrivna hoten.
Idealt sett bör RPO och RTO ha associerade kostnader för datarförlust och driftstopp per tidsenhet.
Delning av resurspooler
Efter att ha samlat in all initial information är det första steget att gruppera uppsättningar av data och IS i pooler, baserat på hotmodeller och regulatoriska krav. Typen av uppdelning av olika pooler bestäms – antingen programvarumässigt på nivå med systemprogramvara eller fysiskt.
Exempel:
— Konturen som behandlar personuppgifter är helt fysiskt åtskild från andra system;
— Säkerhetskopior lagras på en separat lagringslösning.
Poolerna kan emellertid vara med ofullständig självständighet, till exempel definieras två pooler av datorkraft (processorkraft + RAM) som använder en gemensam datalagringspool och en gemensam dataöverföringspool.
Processorkraft
Abstracta behov av processorstyrka i virtualiserade datacenter mäts i antalet virtuella processorer (vCPU) och graden av deras konsolidering på fysiska processorer (pCPU). I detta specifika fall motsvarar 1 pCPU = 1 fysiskt processor kärna (utan att ta hänsyn till Hyper-Threading). Antalet vCPU sammanräknas över alla definierade resurspooler (var och en av dem kan ha sin egen konsolideringsgrad).
Konsolideringsgraden för belastade system erhålls empiriskt, baserat på befintlig infrastruktur, eller vid pilotinstallation och belastningstestning. För icke-belastade system används "best practices". Specifikt anges medelvärdet av VMware som 8:1.
RAM
Det totala behovet av RAM får genom enkel summering. Användning av överskrivning av RAM rekommenderas inte.
Lagringsresurser
Krav på lagringsresurser fås genom att enkelt summera alla pooler efter volym och prestanda.
Prestandakrav uttrycks i IOPS i kombination med det genomsnittliga förhållandet mellan läsning/skrivning och vid behov högsta svarstid.
Specifika krav på kvaliteten av tjänsten (QoS) för specifika pooler eller system måste anges särskilt.
Nätverksresurser
Krav på nätverksresurser fås genom att enkelt summera alla poolers bandbredd.
Specifika krav på kvaliteten av tjänsten (QoS) och latens (RTT) för specifika pooler eller system måste anges särskilt.
Inom kraven på nätverksresurser anges även krav på isolering och/eller kryptering av nätverkstrafik och föredragna mekanismer (802.1q, IPSec etc.).
Val av arkitektur
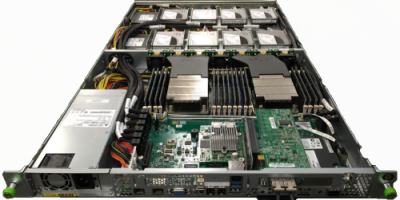
I denna handledning behandlas inget annat val än x86-arkitekturen och 100% virtualisering av servrar. Därför är valet av arkitektur för datorsystemet begränsat till valet av servervirtualiseringsplattform, serverformfaktor och allmänna krav på serverkonfiguration.
En nyckelfaktor vid valet är tydlighet i användningen av den klassiska metoden med uppdelning av funktionerna för bearbetning, lagring och överföring av data eller konvergerande.
Klassisk arkitektur innebär användning av intelligenta externa lagrings- och datatransportsystem, medan servrar endast bidrar med processorkraft och RAM till den gemensamma poolen av fysiska resurser. I extrema fall blir servrar helt anonyma, utan egna diskar eller ens ett systemidentifierare. I sådana fall används en operativsystem- eller hypervisorstart från inbyggda flashmedia eller ett externt lagringssystem (boot from SAN).
Inom klassisk arkitektur görs valet mellan blad (blade) och rack (rack) främst utifrån följande principer:
— Kostnadseffektivitet (i genomsnitt är rackservrar billigare);
— Beräkningsdensitet (blad har högre densitet);
— Energikonsumtion och värmeutveckling (blad har högre specifik värmeutveckling per enhet);
— Skalbarhet och hanterbarhet (blad kräver allmänt mindre arbete vid stora installationer);
— Användning av expansionskort (valet för blad är mycket begränsat).
Konvergent arkitektur (även känd som hyperkonvergent) innebär en kombination av databehandling och lagring, vilket leder till att servrarnas lokala diskar används och därmed avstår från formfaktorn av klassiska blad. För konvergerande system används antingen rackservrar eller klustersystem som kombinerar flera bladservrar och lokala diskar i ett enda chassi.
CPU / Minne
För korrekt beräkning av konfigureringen behöver man förstå typen av belastning för miljön eller varje oberoende kluster.
CPU bound – en miljö som är begränsad av processorkraft. Att lägga till RAM förändrar ingenting när det gäller prestanda (antal VM på servern).
Memory bound – en miljö som är begränsad av RAM-minnet. Mer RAM på servern tillåter att fler VM kan startas.
GB / MHz (GB / pCPU) – det genomsnittliga förhållandet mellan den specifika belastningens minnes- och processorkraft. Kan användas för att beräkna det nödvändiga minnesvolymen vid angiven prestanda och vice versa.
Beräkning av serverkonfiguration
Först måste man identifiera alla typer av belastning och besluta om man ska kombinera eller separera olika beräkningspooler över olika kluster.
Därefter bestäms för varje definierat kluster förhållandet GB / MHz vid känd belastning. Om belastningen inte är känd i förväg, men man har en ungefärlig förståelse av nivåerna för CPU-belastning, kan man använda standardkvoter för vCPU:pCPU för att översätta kraven för pooler till fysiska.
För varje kluster delar vi summan av kraven på vCPU med kvoten:
vCPU_samling / vCPU:pCPU = pCPU_samling – det nödvändiga antalet fysiska kärnor
pCPU_samling / 1.25 = pCPU_ht – antalet kärnor justerat för Hyper-Threading
Anta att vi behöver beräkna ett kluster med 190 kärnor / 3.5 TB RAM. Vi antar här att målet är 50% belastning på CPU och 75% på RAM.
pCPU
190
CPU util
50%
Mem
3500
Mem util
75%
Socket
Core
Srv / CPU
Srv Mem
Srv / Mem
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
I det här fallet använder vi alltid avrundning uppåt till närmaste heltal (=ROUNDUP(A1;0)).
Det framgår tydligt av tabellen att flera serverkonfigurationer är balanserade med tanke på målen:
— 26 servrar 2*6c / 192 GB
— 19 servrar 2*10c / 256 GB
— 10 servrar 2*18c / 512 GB
Valet av dessa konfigurationer måste göras med hänsyn till ytterligare faktorer, såsom värmeutveckling och tillgänglig kylning, redan använda servrar eller kostnader.
Särskildheter vid val av serverkonfiguration
Breda VM. Vid behov av att placera breda VM (jämförbara med 1 NUMA-nod och mer) rekommenderas det att välja en serverkonfiguration som håller dessa VM inom en NUMA-nod så mycket som möjligt. Vid ett stort antal breda VM finns det en risk för fragmentering av klustrets resurser, och i dessa fall väljs servrar som möjliggör att placera breda VM så tätt som möjligt.
Storleken på ett domän för enskilt fel.
Valet av serverstorlek görs också med principen om att minimera domänen för enskilt fel. Till exempel vid valet mellan:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Vid lika villkor bör det andra alternativet väljas, eftersom om en server går ner (eller underhålls) förloras inte 33% av klustrets resurser, utan 17%. På samma sätt minskar antalet VM och ISer som påverkas av en incident med hälften.
Beräkning av klassisk lagringssystem prestanda
Klassisk lagringssystem beräknas alltid utifrån värsta scenariot (worst case scenario), utan att ta hänsyn till den operativa cachen och optimeringen av operationerna.
Som grundläggande prestandaindikatorer tar vi den mekaniska prestandan från disken (IOPSdisk):
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Därefter beräknas antalet diskar i diskpoolen enligt följande formel: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Där:
— TotalIOPS – den totala nödvändiga prestandan i IOPS från diskpoolen
— RW – procentandelen av läsoperationer
— RAIDpen – RAID-straff för den valda RAID-nivån
Mer om RAID-enheter och RAID-straff beskrivs här — och och
Baserat på det beräknade antalet diskar beräknas möjliga alternativ som uppfyller kraven på lagringskapacitet, inklusive alternativ med fler-nivå lagring.
Beräkning av system med SSD som lagringsnivå behandlas separat.
Egenskaper för beräkning av system med Flash Cache
Flash Cache – en allmän benämning på alla proprietära teknologier som använder flashminne som andra nivåns cache. Vid användning av flash-cache beräknas lagringssystem vanligtvis för att hantera den etablerade belastningen från magnetdiskar, medan den maximala belastningen hanteras av cachen.
Vid detta tillfälle är det nödvändigt att förstå belastningsprofilen och graden av lokalisering av åtkomst till lagringens volymblock. Flash-cache är en teknologi för belastningar med hög lokaliseringsgrad av förfrågningar, och är praktiskt taget oanvändbar för jämnt belastade volymer (som till exempel för analytiska system).
Beräkning av hybrida system low-end / mid-range
Hybrida system i låg och medelklass använder fler-nivå lagring med databehandling mellan nivåerna enligt schema. I detta fall är blockstorleken för fler-nivå lagring hos de bästa modellerna 256 MB. Dessa egenskaper gör det omöjligt att betrakta teknologin för fler-nivå lagring som en teknologi för att öka prestanda, som många felaktigt tror. Fler-nivå lagring i låg- och medelklassystem är en teknik för att optimera lagringskostnader för system med uttalad ojämn belastning.
För flernivålagring beräknas först och främst prestandan för den övre nivån, medan den nedre lagringsnivån endast anses bidra med den saknade lagringskapaciteten. För ett hybrid flernivåsystem är det nödvändigt att använda flash cache-teknik för den flernivåpoolen för att kompensera för prestandafallet för data som plötsligt blivit varma från den nedre nivån.
Användning av SSD i flernivådiskpoolen
Användningen av SSD i flernivådiskpoolen har variationer beroende på egenskaperna hos algoritmerna för flash cache från denna tillverkare.
Allmän praxis för lagringspolicy för diskpool med SSD-nivå är SSD först.
Read Only Flash Cache. För flashcache endast för läsning uppstår lagringsnivån på SSD vid betydande lokalisering av skrivoperationer oavsett cachen.
Read / Write Flash Cache. Vid skrivcache fastställs först den maximala cachekapaciteten, och lagringsnivån på SSD uppstår endast vid otillräcklig cachestorlek för att hantera hela den lokalisering belastningen.
Prestandaberäkningen för SSD och cachar görs varje gång baserat på tillverkarens rekommendationer, men alltid för det sämsta fallet.
Källa: habr.com
