

Eftersom ClickHouse är ett specialiserat system är det viktigt att beakta dess arkitekturvid användning. I denna presentation kommer Alexey att tala om exempel på typiska misstag vid användning av ClickHouse som kan leda till ineffektiv drift. Genom praktiska exempel kommer det att visas hur valet av olika databehandlingsscheman kan förändra prestandan avsevärt.
Hej alla! Jag heter Alexey och jag jobbar med ClickHouse.
För det första, jag skyndar mig att glädja er, jag kommer inte att berätta vad ClickHouse är idag. Ärligt talat, jag har tröttnat på att göra det. Varje gång måste jag förklara vad det är. Och jag tror att alla redan vet.
Istället kommer jag att diskutera möjliga fällor, det vill säga hur man kan använda ClickHouse felaktigt. Faktum är att ni inte behöver vara rädda, för vi utvecklar ClickHouse som ett system som är enkelt, användarvänligt och fungerar utan problem. Installera och det är klart, inga problem.
Men ni måste ändå ta hänsyn till att systemet är specialiserat och att det är lätt att stöta på ovanliga användningsscenarier som kan få systemet att kännas obekvämt.
Så vilka fällor finns det? I huvudsak kommer jag att prata om uppenbara saker. Alla förstår allt uppenbart, alla kan glädja sig över att de är så smarta, och de som inte förstår kommer att lära sig något nytt.
Det första och enklaste exemplet, som tyvärr ofta inträffar, är att göra ett stort antal insättningar med små batchar, det vill säga ett stort antal små insättningar.
Om vi ser hur ClickHouse utför insättningar, kan ni skicka upp till en terabyte data i ett enda anrop. Det är inga problem.
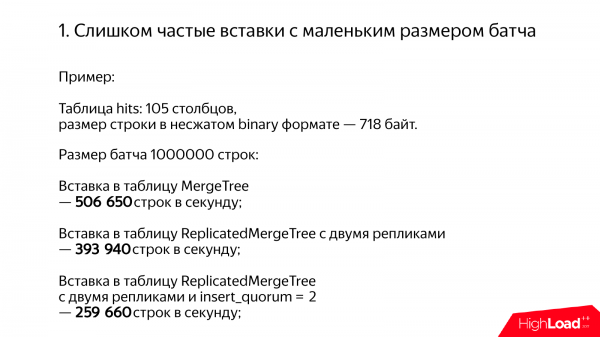
Låt oss titta på vilken typisk prestanda vi kan förvänta oss. Till exempel har vi en tabell med data från Yandex.Metrics. Hits. 105 kolumner. 700 byte i okomprimerad form. Och vi ska göra ordentliga insättningar med en miljon rader per batch.
Vi sätter in i en MergeTree-tabell, vilket ger oss en halv miljon rader per sekund. Utmärkt. I en replikerad tabell blir det lite mindre, cirka 400 000 rader per sekund.
Och om vi aktiverar quorum-insertning får vi lite mindre, men ändå bra prestanda, 250 000 rader per sekund. Quorum-insertningar är en icke-dokumenterad funktion i ClickHouse*.
*från och med 2020, .
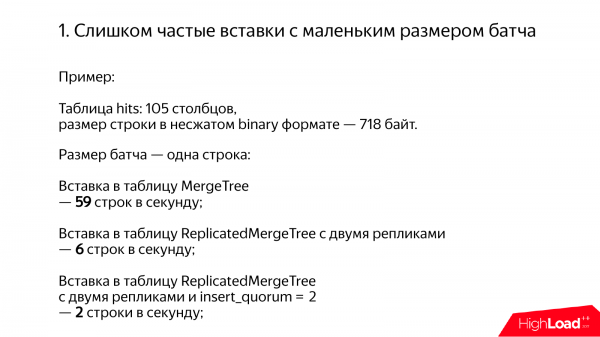
Vad händer om man gör det dåligt? Vi lägger in en rad i tabellen MergeTree och får 59 rader per sekund. Det är 10 000 gånger långsammare. I ReplicatedMergeTree är det 6 rader per sekund. Och om quorum aktiveras får vi bara 2 rader per sekund. I min mening är det en riktig katastrof. Hur kan man fördröja så? Till och med på min t-shirt står det att ClickHouse inte ska vara segt. Men ändå händer det ibland.
I själva verket är det vår brist. Vi skulle helt kunna få allt att fungera smidigt, men vi gjorde det inte. Och vi gjorde det inte för att det inte var nödvändigt för vårt scenario. Vi hade redan batchar. Data kom in i batchar, och det var inga problem. Vi lägger in och allt fungerar som det ska. Men självklart kan olika scenarier uppstå. Till exempel, när ni har massor av servrar som genererar data. Och de lägger in data inte så ofta, men det blir fortfarande frekventa insättningar. Och man måste undvika det på något sätt.
Ur teknisk synvinkel är poängen att när du gör en insert i ClickHouse så hamnar inte datan i någon memtable. Vi har inte ens en äkta log structure MergeTree, utan bara MergeTree, eftersom det varken finns en logg eller en memTable. Vi skriver helt enkelt in data direkt i filsystemet, redan sorterade i kolumner. Och om du har 100 kolumner måste mer än 200 filer skrivas till en separat katalog. Allt detta är ganska klumpigt.
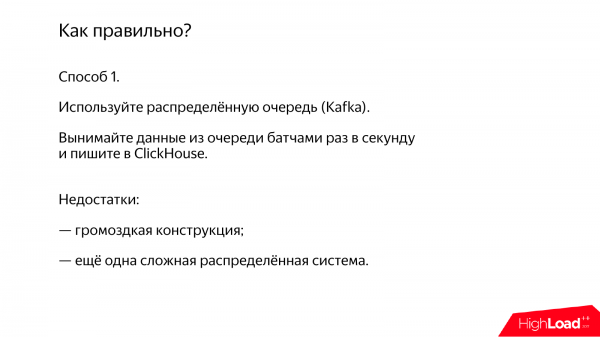
Och frågan uppstår: "Hur gör man det rätt?" Om situationen är sådan att man ändå måste skriva data i ClickHouse.
Metod 1. Det här är det enklaste sättet. Använd en distribuerad kö. Till exempel, Kafka. Du plockar helt enkelt ut data från Kafka, batchar var sekund. Och allt kommer fungera bra, du skriver in, allt fungerar.
Nackdelarna är att Kafka är ännu ett klumpigt distribuerat system. Jag förstår om ni redan har Kafka i ert företag. Det är bra, det är praktiskt. Men om ni inte har det, bör ni tänka er för tre gånger innan ni drar in ännu ett distribuerat system i ert projekt. Och därför bör ni överväga alternativ.
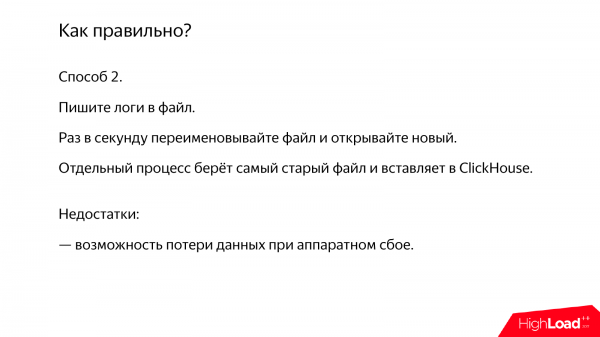
Metod 2. Här är ett gammaldags alternativ som ändå är mycket enkelt. Har du en server som genererar dina loggar? Den skriver helt enkelt dina loggar i en fil. Och en gång per sekund, till exempel, byter vi namn på filen och öppnar en ny. En separat skript, antingen via cron eller någon daemon, tar den äldsta filen och skriver den till ClickHouse. Om loggar skrivs en gång per sekund kommer allt att bli utmärkt.
Men nackdelen med denna metod är att om din server, där loggarna genereras, plötsligt försvinner, så försvinner också datan.
Metod 3. Det finns en annan intressant metod som helt saknar temporära filer. Antag att du har någon slags reklamshub eller en annan intressant daemon som genererar data. Du kan lagra en bunt data direkt i RAM-minnet, i bufferten. När tillräckligt med tid har gått, lägger du denna buffer på sidan, skapar en ny, och i en separat tråd infogar du det som redan har samlats in till ClickHouse.
Å andra sidan försvinner även data om du exekverar kill -9. Om din server kraschar, förlorar du dessa data. Ytterligare ett problem är att om du inte kan skriva till databasen kommer data att samlas kvar i RAM-minnet. Antingen tar RAM-minnet slut, eller så förlorar du bara datan.
Metod 4. Ännu en intressant metod. Du har en serverprocess som kan skicka data till ClickHouse direkt, men gör det i en enda anslutning. Till exempel, du skickar en http-förfrågan med transfer-encoding: chunked med en insert. Och den genererar chunkar inte allt för sällan; du kan skicka varje rad, även om det kommer att finnas overhead för ramverket av dessa data.
Men likväl kommer data i detta fall att skickas till ClickHouse direkt. Och ClickHouse kommer att buffra dem själv.
Men problem uppstår också. Nu kommer du att förlora data, särskilt när din process avslutas, och om ClickHouse-processen dödas, eftersom det kommer att bli en ofullständig insert. I ClickHouse är inserts atomära upp till en viss angiven tröskel av rader. I princip är detta en intressant metod. Kan också användas.
Metod 5. Här är ännu ett intressant sätt. Det är ett community-utvecklat server för databatching. Jag har inte tittat på det själv, så jag kan inget garantera. Dock, inga garantier ges heller för ClickHouse. Detta är också open source, men å andra sidan kan du vara van vid en viss standard av kvalitet som vi försöker tillhandahålla. För denna grej – jag vet inte, gå in på GitHub, kolla koden. Kanske har de skrivit något bra.
* per 2020, bör även beaktas .
Metod 6. Ett annat sätt är att använda buffer-tabeller. Fördelen med detta sätt är att det är väldigt enkelt att börja använda. Du skapar en buffer-tabell och sätter in data i den.
Men nackdelen är att problemet inte löses helt. Om vid insättning av typ MergeTree måste du gruppera data till en batch per sekund, så måste du vid insättning i buffer-tabellen gruppera till åtminstone flera tusen per sekund. Om det överstiger 10 000 per sekund, kommer det fortfarande att bli dåligt. Om du sätter in i batchar, så har du sett att det kan bli hundratusentals rader per sekund. Och det är redan med ganska tunga data.
Och buffer-tabeller har inte heller någon logg. Och om det är något fel med din server, så kommer data att gå förlorade.
Och som en bonus har vi nyligen fått möjligheten att hämta data från Kafka i ClickHouse. Det finns en tabellmotor – Kafka. Du skapar helt enkelt en och kan koppla materialiserade vyer till den. I så fall kommer den själv att hämta data från Kafka och sätta in i de tabeller du behöver.
Och det som gläder mig särskilt med denna funktion är att det inte är vi som har gjort den. Det är en community-funktion. Och när jag säger "community-funktion", säger jag det utan förakt. Vi har läst koden, gjort granskningar, det ska fungera bra.
* per 2020, har liknande stöd tillkommit för .
Vad kan vara obekvämt eller oväntat vid datainmatning? Om du gör en insert values-förfrågan och skriver några beräknade uttryck i values. Till exempel, now() – det är också ett beräknat uttryck. I det fallet måste ClickHouse köra tolkaren för dessa uttryck för varje rad, och prestandan kommer att sjunka drastiskt. Bäst är att undvika detta.
* för tillfället är problemet helt löst, det finns ingen regressionsprestanda vid användning av uttryck i VALUES längre.
Ett annat exempel på när det kan finnas vissa problem är när du har data i en batch som tillhör flera partitioner. Som standard är partitionerna i ClickHouse per månad. Om du infogar en batch med en miljon rader och data sträcker sig över flera år, så kommer du att ha flera tiotals partitioner. Det är likvärdigt med att ha batcher med flera tiotals gånger mindre storlek, eftersom de alltid först bryts ner efter partitionerna.
* nyligen har ClickHouse i experimentellt läge fått stöd för kompakt format av block och block i minnet med en write-ahead log, vilket nästan helt löser problemet.
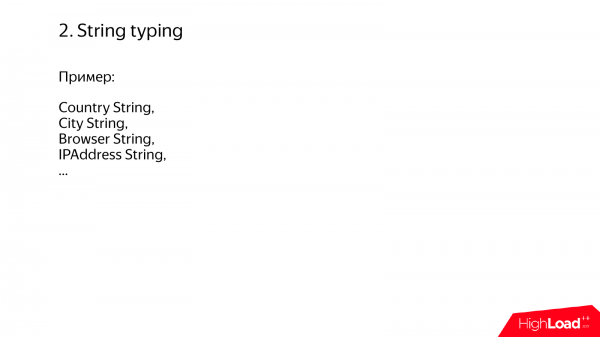
Låt oss nu titta på den andra typen av problem – datatypning.
Datatypning kan vara strikt eller strängtyp. Strängtyp är när du helt enkelt har deklarerat att alla dina fält är av typ string. Det är dåligt. Man ska inte göra så.
Låt oss förstå hur man gör det rätt i situationer där man vill säga att ett visst fält är en sträng och låta ClickHouse själv hantera det, utan att jag behöver oroa mig. Men det är ändå värt att anstränga sig lite.
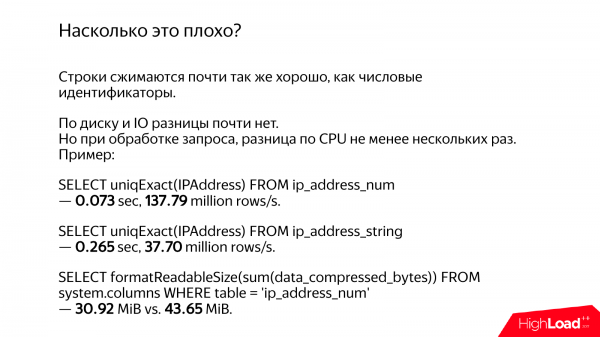
Till exempel har vi en IP-adress. I ett fall har vi sparat den som en sträng, till exempel 192.168.1.1. I det andra fallet kommer det att vara ett tal av typen UInt32*. 32 bitar är tillräckligt för en IPv4-adress.
Först och främst, som inte är överraskande, kommer data att komprimeras ungefär lika mycket. Det kommer att bli skillnader, förstås, men inte så stora. Så det finns inga speciella problem med disk I/O.
Men det finns en betydande skillnad i CPU-tid och frågaexekveringstid.
Låt oss räkna antalet unika IP-adresser om de lagras som tal. Det blir 137 miljoner rader per sekund. Om samma sak görs som strängar, blir det 37 miljoner rader per sekund. Jag vet inte varför sådana överensstämmelser har uppstått. Jag har själv kört dessa frågor. Men ändå är det ungefär fyra gånger långsammare.
Och om vi beräknar skillnaden i lagringsutrymme på disken, finns det också skillnader. Och skillnaden är någonstans runt en fjärdedel, eftersom det finns tillräckligt många unika IP-adresser. Och om det här var strängar med ett litet antal olika värden, skulle de enkelt komprimeras med hjälp av en ordbok till ungefär samma volym.
Och det är en fyrdubbel tidsdifferens på vägen som inte ligger och väntar. Kanske bryr du dig inte, men när jag ser en sådan skillnad blir jag ledsen.
Låt oss titta på olika fall.
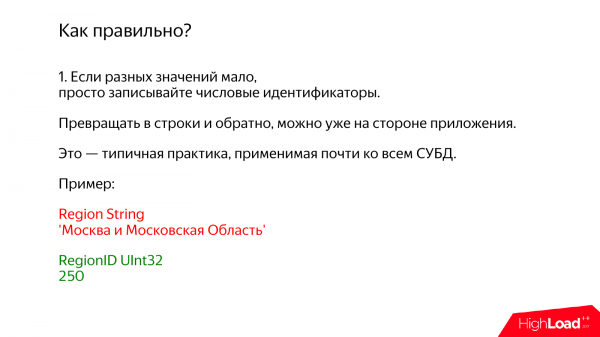
1. Ett fall där ni har ett par unika värden. I det här fallet använder vi en enkel praxis som ni kanske känner till och kan använda för alla databas-system. Det gäller inte bara ClickHouse. Ni skriver helt enkelt in numeriska identifierare i databasen. Att konvertera till strängar och tillbaka kan göras på applikationssidan.
Tills exempel, ni har en region. Och ni försöker spara den som en sträng. Om ni skriver: Moskva och MO. När jag ser att det står "Moskva", är det okej, men när också MO står där, blir det verkligen sorgligt. Det är så många byte.
Istället skriver vi helt enkelt in ett Ulnt32-nummer och 250. Vi har 250 i Yandex, men ni kanske har något annat. För säkerhets skull nämner jag att ClickHouse har inbyggt stöd för geodatabaser. Ni skriver helt enkelt en katalog med regioner, inklusive hierarkiska, det vill säga den kommer att omfatta både Moskva och MO, samt allt annat ni behöver. Och det går att konvertera på frågenivå.
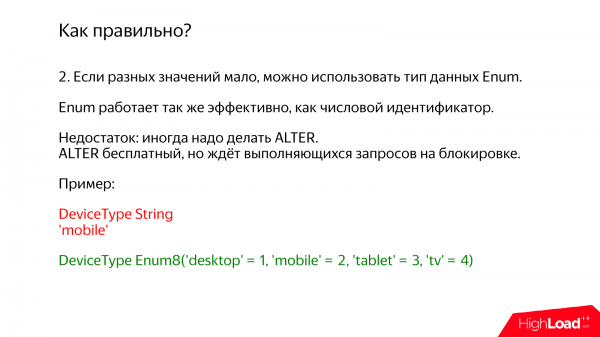
Det andra alternativet är ungefär detsamma, men redan med stöd inuti ClickHouse. Det är datatypen Enum. Inom Enum angiver ni helt enkelt alla nödvändiga värden. Till exempel enhetstypen där ni skriver: dator, mobil, surfplatta, tv. Totalt fyra alternativ.
En nackdel är att man periodvis måste ändra. Man har bara lagt till ett alternativ. Gör en ändring av tabellen. Faktum är att ändringen av tabellen i ClickHouse är kostnadsfri. Särskilt kostnadsfri för Enum, eftersom data på disken inte förändras. Men ändå, ändringen tar blockering* på tabellen och måste vänta tills alla selects utförs. Och först efter det genomförs ändringen, det finns ändå vissa olägenheter.
* I de senaste versionerna av ClickHouse är ALTER helt icke-blockerande.
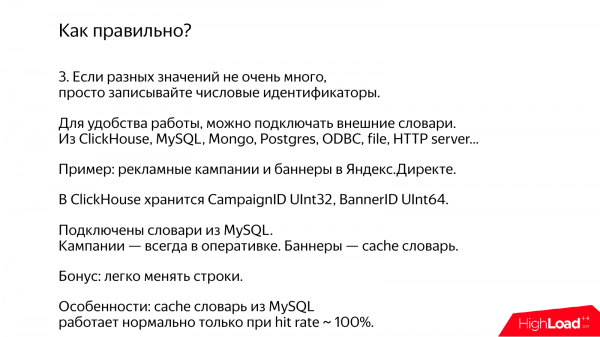
Ett annat alternativ som är ganska unikt för ClickHouse är anslutning av externa ordböcker. Ni kan skriva in siffror i ClickHouse, medan era kataloger kan hållas i vilket system som helst som är bekvämt för er. Till exempel kan ni använda: MySQL, Mongo, Postgres. Ni kan till och med skapa er egen mikrotjänst som via http kommer att tillhandahålla dessa data. Och på ClickHouse-nivån skriver ni en funktion som omvandlar dessa data från siffror till strängar.
Det här är ett specialiserat men mycket effektivt sätt att utföra en join med en utomstående tabell. Det finns dessutom två alternativ. I det ena alternativet kommer dessa data att vara helt cachade, helt närvarande i minnet och uppdateras med viss periodicitet. I det andra alternativet, om dessa data inte får plats i minnet, går det att cachera dem delvis.
Här är ett exempel. Det finns Yandex.Direct. Och där finns det reklamkampanjer och annonser. Det finns nog cirka tio miljoner reklamkampanjer. Och de får plats i minnet. Men det finns miljarder annonser, de får inte plats. Och vi använder en cachad ordbok från MySQL.
Det enda problemet är att den cachade ordboken fungerar normalt om hit rate ligger nära 100 %. Om den är lägre måste vi vid behandling av förfrågningar för varje datamängd faktiskt hämta de saknade nycklarna och hämta data från MySQL. Jag kan fortfarande garantera att ClickHouse inte saktar ner, men jag ska inte prata om andra system.
Som en bonus är ordböcker ett mycket enkelt sätt att uppdatera data i ClickHouse i efterhand. Det vill säga, om du hade en rapport om reklamkampanjer och användaren bara ändrade reklamkampanjen, så skulle även alla tidigare data och rapporter uppdateras. Om du skriver rader direkt i tabellen kommer det att vara omöjligt att uppdatera dem.
Ett annat sätt, när du inte vet hur du ska få identifierare för dina rader, är att helt enkelt hasha. Det enklaste alternativet är att ta en 64-bitars hash.
Det enda problemet är att om hashen är 64-bit är kollisioner nästan garanterade. Eftersom om det finns en miljard rader blir sannolikheten märkbar.
Och det vore inte så bra att hashera namnen på reklamkampanjer på det sättet. Om reklamkampanjer från olika företag blandas ihop kommer det att bli något oklart.
Och det finns ett enkelt knep. Visserligen passar det inte så bra för seriösa data, men om det är något som inte är så allvarligt, så lägg bara till klientens identifierare i nyckeln i ordboken. Då kommer du att ha kollisioner, men bara inom en och samma klient. Den här metoden används för vår länk-karta i Yandex.Metrica. Vi har där URLs, vi lagrar hashar. Och vi vet att det finns kollisioner, självklart. Men när sidan visas, är sannolikheten för att just på en och samma sida en användare har något URL som krockar och att någon verkligen upptäcker det, så kan man bortse från det.
Som en bonus – för många operationer räcker det med bara hashar och själva strängarna behöver inte lagras någonstans.
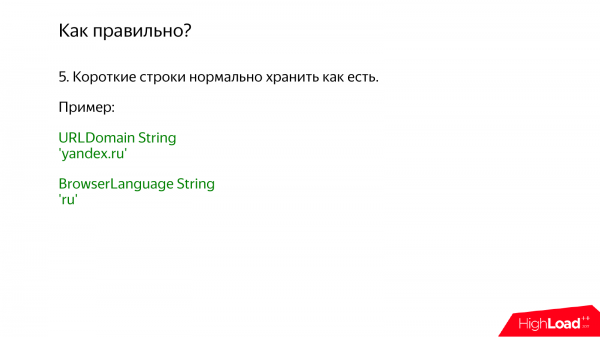
Ett annat exempel är om strängarna är korta, till exempel domännamn. De kan lagras som de är. Eller till exempel språk i webbläsaren ru – 2 byte. Självklart, jag är väldigt rädd om byte, men oroa dig inte, 2 byte gör inget. Snälla, lagra dem som de är, sköt dig inte.
Ett annat tillfälle är när det finns väldigt många strängar och de dessutom innehåller många unika via mängder som potentiellt är oändliga. Ett typiskt exempel är sökord eller URLs. Sökord, bland annat på grund av stavfel. Låt oss se hur många unika sökord det finns per dag. Det visar sig att de nästan utgör hälften av alla händelser. Och i det här fallet skulle du kunna tänka att det behövs normalisering av data, att räkna identifierare och lagra i en separat tabell. Men det behöver du inte göra. Lagra helt enkelt dessa strängar som de är.
Bättre – hitta på inget, för om du lagrar dem separat, så kommer det att krävas join. Och denna join – är i bästa fall en slumpmässig åtkomst i minnet, om det ens kan få plats i minnet. Om det inte får plats, kommer det att bli problem.
Och om data lagras in place, så läses de helt enkelt ut i rätt ordning från filsystemet och allt är bra.
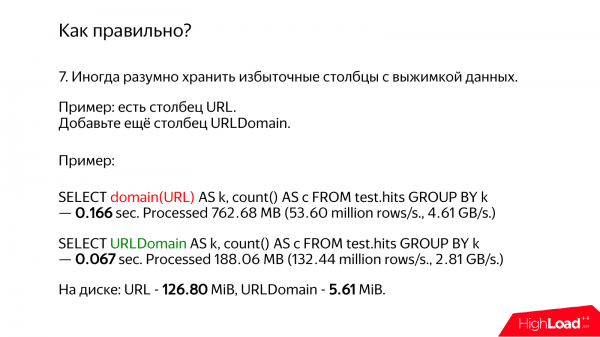
Om du har URLs eller någon annan komplicerad lång sträng, så bör du tänka på att du kanske kan beräkna en sammanfattning i förväg och skriva den i en separat kolumn.
För URLs, till exempel, kan du lagra domänen separat. Och om du verkligen behöver domänen, så använd bara den kolumnen, medan URLs kommer att ligga kvar, och du kommer inte ens röra dem.
Låt oss titta på vilken skillnad det blir. I ClickHouse finns det en specialiserad funktion som beräknar domänen. Den är väldigt snabb, vi har optimerat den. Och ärligt talat, den följer inte ens RFC, men den beräknar allt vi behöver.
Och i det ena fallet kommer vi bara att hämta URL:er och beräkna domänen. Det tar 166 millisekunder. Men om vi tar en färdig domän, blir det bara 67 millisekunder, det vill säga nästan tre gånger snabbare. Dessutom är det inte snabbare för att vi behöver göra några beräkningar, utan för att vi läser mindre data.
Av någon anledning visar det sig att en av förfrågningarna, som är långsammare, har högre hastighet i gigabyte per sekund. Eftersom den läser mer gigabyte. Det är helt onödiga data. Förfrågningen fungerar snabbare, men tar längre tid.
Om vi tittar på datamängden på disken visar det sig att URL:en är 126 megabyte och domänen bara 5 megabyte. Det är 25 gånger mindre. Men ändå utförs förfrågningen bara 4 gånger snabbare. Men det beror på att data är heta. Om de vore kalla skulle det säkert vara 25 gånger snabbare på grund av disk-I/O.
Förresten, om vi bedömer hur mycket mindre domänen är än URL:en, så är det cirka 4 gånger. Men av någon anledning tar data på disken 25 gånger mindre. Varför? På grund av komprimering. Både URL:en och domänen komprimeras. Men ofta innehåller URL:en massor av skräp.
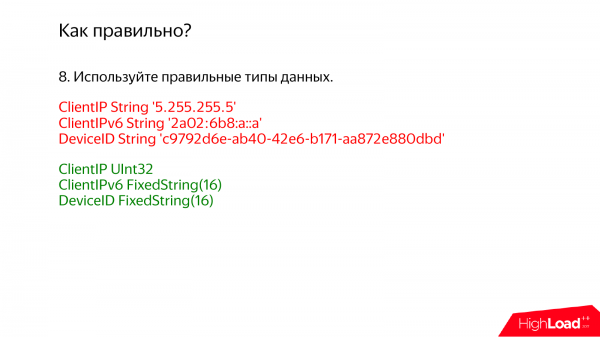
Och självklart är det viktigt att använda rätt datatyper som är specifikt avsedda för de nödvändiga värdena, eller som passar. Om du har IPv4, lagra UInt32*. Om det är IPv6, använd FixedString(16), eftersom IPv6-adressen är 128 bitar, det vill säga lagra den direkt i binärt format.
Vad ska man göra om du ibland har IPv4-adresser och ibland IPv6? Ja, du kan lagra båda. En kolumn för IPv4, en annan för IPv6. Naturligtvis finns det en möjlighet att visa IPv4 i IPv6. Det kommer också att fungera, men om du ofta behöver IPv4-adressen i dina förfrågningar, så är det bra att lägga den i en separat kolumn.
* nu finns det separata datatyper för IPv4 och IPv6 i ClickHouse, som lagrar data lika effektivt som siffror, men presenterar dem på ett bekvämt sätt som strängar.
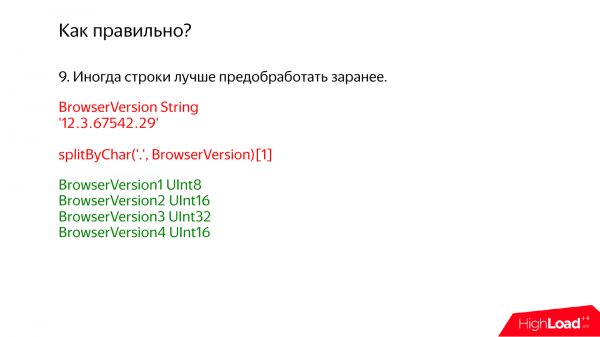
Det är också viktigt att notera att man bör förbehandla data i förväg. Till exempel, om det kommer råa loggar till er. Och kanske bör ni inte bara stoppa in dem i ClickHouse, även om det är frestande att inte göra något och allt kommer att fungera. Men det är ändå värt att utföra de beräkningar som går.
Till exempel, webbläsarversionen. I en viss närliggande avdelning, som jag inte vill peka ut, lagras webbläsarversionen på detta sätt, dvs. som en sträng: 12.3. Sedan, för att göra en rapport, delar de denna sträng på en array, och sedan på det första elementet i arrayen. Givetvis saktar allt ner. Jag frågade dem varför de gör så. De svarade att de inte gillar för tidig optimering. Men jag gillar inte för tidig pessimering.
Så i detta fall är det mer korrekt att dela upp i 4 kolumner. Var inte rädd, eftersom detta är ClickHouse. ClickHouse är en kolumnbaserad databas. Och ju fler noggrant små kolumner, desto bättre. Har ni 5 BrowserVersion, gör 5 kolumner. Det är normalt.
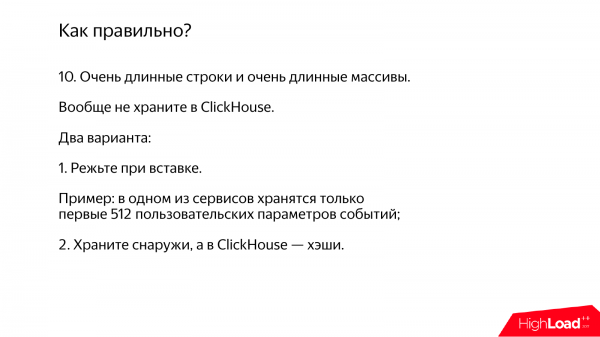
Nu ska vi överväga vad man ska göra om ni har många mycket långa strängar, mycket långa arrayer. Dessa behöver inte lagras i ClickHouse överhuvudtaget. Istället kan ni spara endast något slags identifierare i ClickHouse. Dessa långa strängar kan ni lagra i något annat system.
Till exempel, i en av våra analytiska tjänster finns det vissa händelseparametrar. Och om många parametrar kommer med händelserna, sparar vi bara de första 512 som kommer. Eftersom 512 är inte något att sörja över.
Och om ni inte kan bestämma era datatyper, kan ni också skriva data till ClickHouse, men i en temporär tabell av typen Log, speciellt för temporära data. Efter detta kan ni analysera vilken värdefördelning ni har, vad som överhuvudtaget finns och sammansätta korrekta typer.
* just nu finns det en datatyp i ClickHouse som gör det möjligt att effektivt lagra strängar med mindre arbetsinsats.
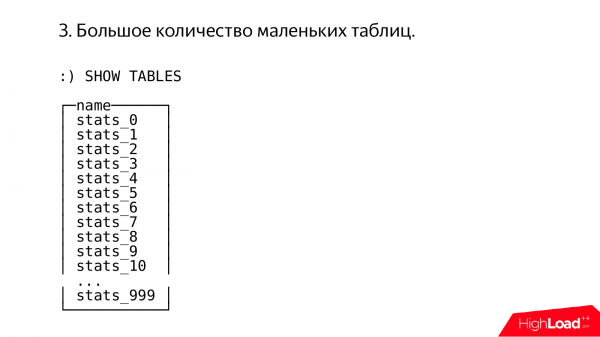
Nu ska vi överväga ett annat intressant fall. Ibland fungerar allt märkligt för folk. Jag går in och ser något som detta. Och det ger omedelbart intrycket att det gjordes av en mycket erfaren, smart administratör med stor erfarenhet av att konfigurera MySQL version 3.23.
Här ser vi tusen tabeller, där var och en lagrar restvärdet av en oklar division på tusen.
I princip respekterar jag andras erfarenheter, inklusive att jag förstår vilka svårigheter som kan ligga bakom dessa erfarenheter.
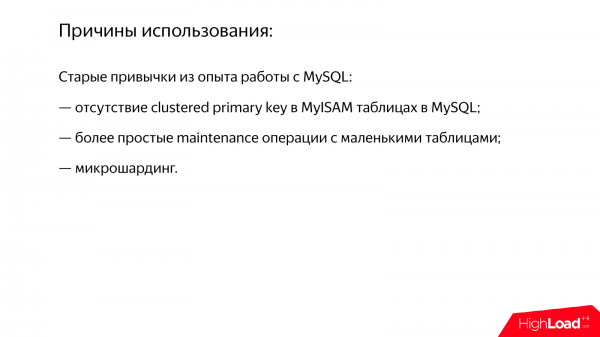
Och orsakerna är mer eller mindre förståeliga. Det handlar om gamla stereotyper som kan ha samlats vid arbete med andra system. Till exempel finns det inget klusterprimärt nyckel i MyISAM-tabeller. Och detta sätt att dela upp data kan vara ett desperat försök att få samma funktionalitet.
En annan orsak är att det är svårt att utföra operationer som alter på stora tabeller. Allt kommer att blockeras. Även om detta problem inte längre är så allvarligt i moderna versioner av MySQL.
Eller till exempel mikroskarding, men det kommer vi tillbaka till senare.
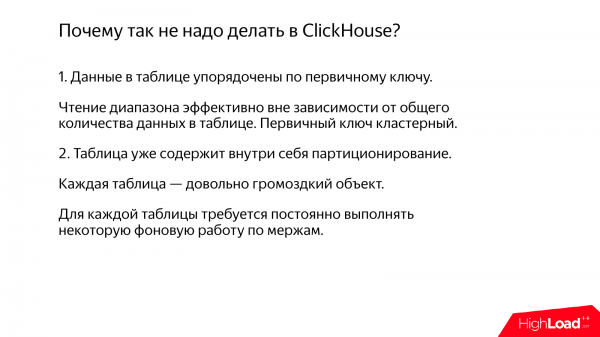
I ClickHouse behöver man inte göra på det sättet, för först och främst är den primära nyckeln klusterbaserad, och data är ordnad efter den primära nyckeln.
Och ibland frågar folk mig: "Hur påverkas prestandan av intervallsökningar i ClickHouse av storleken på tabellen?". Jag säger att det inte påverkas alls. Till exempel, om ni har en tabell med en miljard rader och läser ett intervall på en miljon rader, fungerar det bra. Om tabellen har en triljon rader och ni läser en miljon rader, kommer det att vara nästan samma sak.
Och för det andra behövs inga manövrar som manuella partitioner. Om du går in och tittar på filsystemet, kommer du att se att tabellen är en ganska komplex struktur. Inuti finns det något som liknar partitioner. Det vill säga, ClickHouse gör allt åt dig och du behöver inte lida.
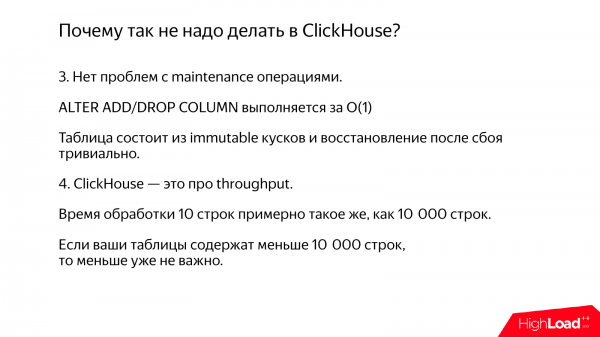
Alter i ClickHouse är gratis, om man gör alter add/drop column.
Och det är inte värt att skapa små tabeller, för om din tabell har 10 rader eller 10 000 rader spelar det ingen roll. ClickHouse är ett system som optimerar genomflödet, inte latensen, så att bearbeta 10 rader är meningslöst.
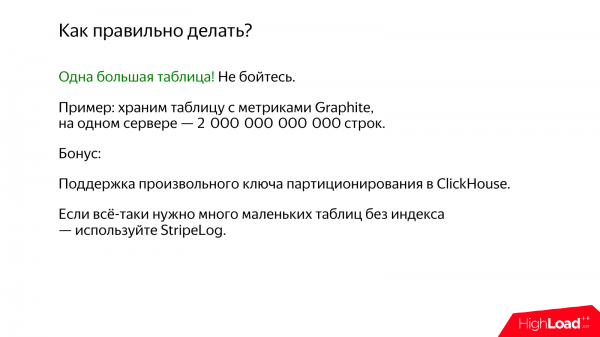
Det är rätt att använda en stor tabell. Släpp de gamla stereotyperna, så blir allt bra.
Som en bonus har vi i den senaste versionen fått möjligheten att skapa godtyckliga partitionsnycklar för att kunna utföra olika underhållsoperationer på individuella partitioner.
Till exempel om du behöver många små tabeller, som när det finns ett behov av att bearbeta vissa mellanliggande data, får du hitta chunkar och du behöver utföra transformationer på dem innan de skrivs till den slutliga tabellen. För detta fall finns det en fantastisk tabellmotor – StripeLog. Det är ungefär som TinyLog, fast bättre.
* just nu finns det även .
En annan antipattern är mikrosplittring. Till exempel, om du behöver shardera data och du har 5 servrar, men imorgon kommer det att vara 6 servrar. Och du undrar hur du ska ombalansera dessa data. Istället för att splittra det i 5 shards, splittrar du det i 1 000 shards. Och sedan mappar du varje av dessa mikrosplitter till en separat server. Och du kan få 200 ClickHouse på en server, till exempel. Separata instanser på olika portar eller separata databaser.
Men i ClickHouse är detta inte särskilt bra. För även en instans av ClickHouse strävar efter att använda alla tillgängliga resurser på servern för att bearbeta en enda fråga. Det vill säga, om du har en server som har 56 processorerkärnor. Du utför en fråga som tar en sekund, och den kommer att använda 56 kärnor. Om du har 200 ClickHouse-instans på en och samma server, kommer det att resultera i att 10 000 trådar startas. Överlag kommer det att gå väldigt dåligt.
En annan anledning är att arbetsfördelningen mellan dessa instanser kommer att vara ojämn. Någon kommer att avsluta tidigare, någon senare. Om allt skulle ske i en enda instans, skulle ClickHouse själv kunna avgöra hur man ska fördela data på rätt sätt mellan trådarna.
Och en ytterligare anledning är att du kommer att ha interprocesskommunikation över TCP. Data måste serialiseras, deserialiseras och det är en enorm mängd mikrosplitter. Det kommer helt enkelt att fungera ineffektivt.
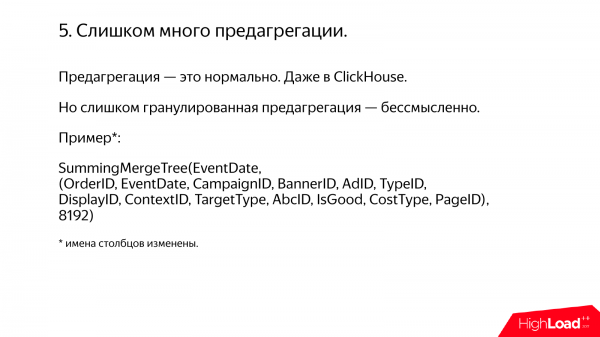
Ännu en antipattern, även om det är svårt att kalla det en antipattern. Det är ett stort antal föraggregat.
Generellt sett är föraggregation bra. Om du hade en miljard rader, aggregara du dem och det blir 1 000 rader, och nu utförs frågan omedelbart. Allt är fantastiskt. Så kan man göra. Och för detta finns det till och med en speciell typ av tabell i ClickHouse, AggregatingMergeTree, som gör inkrementell aggregation medan data sätts in.
Det finns dock fall där man tänker att vi ska aggreggera data på det här sättet och sedan på ett annat. I en viss närliggande avdelning, som jag helst inte vill nämna, använder man SummingMergeTree-tabeller för att summera efter primärnyckeln, och som primärnyckel använder man drygt 20 olika kolumner. Jag har av säkerhetsskäl ändrat namnen på några kolumner för att vara diskret, men i stort sett är det så.
Och då uppstår sådana problem. För det första minskar inte datavolymen särskilt mycket. Till exempel, den minskar med tre gånger. Tre gånger skulle vara ett bra pris för att kunna ha obegränsade möjligheter för analys, vilket är fallet om dina data inte är aggregerade. Om datan är aggregerad får du istället bara usel statistik.
Och vad är särskilt frustrerande? Det är att dessa personer från den närliggande avdelningen kommer och ber om att få lägga till en kolumn i primärnyckeln. Det vill säga, vi har aggreggerat data på det här sättet, men nu vill vi ha lite mer. Men i ClickHouse finns det ingen möjlighet att ändra primärnyckeln. Därför måste man skriva något skript i C++. Och jag gillar inte skript, även om de är i C++.
Och om man ser på varför ClickHouse skapades, så är det just för att hantera icke-aggregerade data – det är det scenario för vilket det är fött. Om du använder ClickHouse för icke-aggregerade data gör du helt rätt. Om du aggregerar är det ibland förlåtligt.
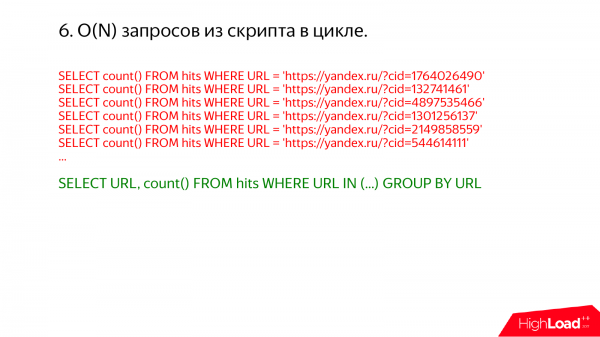
Ett ytterligare intressant fall är frågor i en oändlig loop. Jag går ibland in på någon produktionsserver och kollar på show processlist. Och varje gång upptäcker jag att något hemskt pågår.
Till exempel något av detta slag. Här blir det genast tydligt att man kunde ha genomfört allt med en enda fråga. Skriv bara url in och lista.
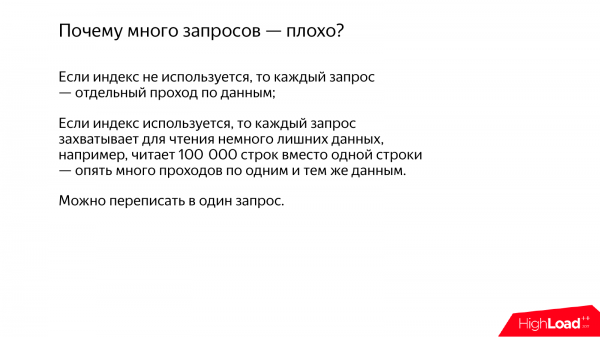
Varför är det dåligt med många sådana frågor i en oändlig loop? Om indexet inte används kommer det att bli många genomgångar av samma data. Men om indexet används, till exempel om du har en primärnyckel på ru och skriver url = något där. Då tror du att det kommer att läsas in exakt ett url från tabellen, och allt kommer att vara bra. Men i själva verket är det inte så. För ClickHouse arbetar alltid med batchar.
När den behöver läsa ett dataintervall läser den lite mer eftersom indexet i ClickHouse är glest. Det här indexet tillåter inte att hitta enskilda rader i tabellen, bara vissa intervall. Och data komprimeras i block. För att läsa en rad måste man hämta ett helt block och dekomprimera det. Om du gör många förfrågningar kommer du att ha många överlappningar, och mycket av arbetet kommer att utföras om och om igen.
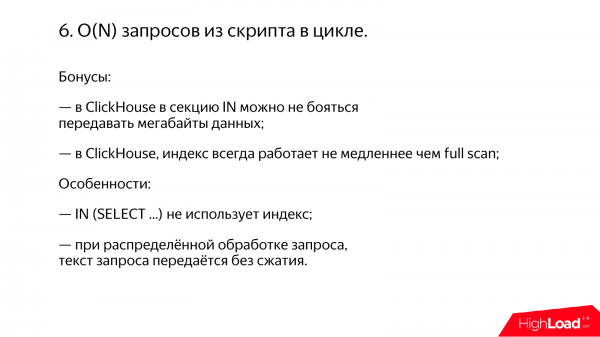
Som en bonus kan man notera att man i ClickHouse inte behöver vara rädd för att skicka även megabyte och till och med hundratals megabyte i IN-sektionen. Jag minns från vår praxis att om vi skickar massor av värden i IN-sektionen i MySQL, till exempel 100 megabyte av vissa nummer, så äter MySQL upp 10 gigabyte minne och sedan händer det inget mer, allt fungerar dåligt.
Det andra är att i ClickHouse, om dina förfrågningar använder index, så är det alltid inte långsammare än en fullständig skanning, det vill säga om nästan hela tabellen måste läsas, kommer den att gå sekventiellt och läsa hela tabellen. I allmänhet hanterar den sig själv.
Men det finns ändå vissa svårigheter. Till exempel används inte indexet med subfrågor i IN. Men det är vårt problem och vi måste åtgärda det. Det finns inget fundamentalt här. Vi kommer att fixa det.
En annan intressant sak är att om du har en mycket lång förfrågning och den distribuerade behandlingen av förfrågningar pågår, så kommer den här mycket långa förfrågningen att skickas till varje server utan komprimering. Till exempel, 100 megabyte och 500 servrar. Och därför kommer 50 gigabyte att överföras över nätverket. Det kommer att skickas och sedan kommer allt att utföras framgångsrikt.
* redan används; allt är fixat, som lovat.
Och det är ganska vanligt att förfrågningar kommer från API. Till exempel har du skapat en egen tjänst. Och om din tjänst behövs av någon, öppnar du ett API och redan bokstavligt talat två dagar senare ser du att något konstigt händer. Allt är överbelastat och det kommer fruktansvärda förfrågningar som aldrig borde ha kommit.
Och lösningen här är enkel. Om du har öppnat ett API, så måste du begränsa det. Till exempel införa kvoter. Det finns inga andra normala alternativ. Annars kommer någon att skriva ett skript och det kommer att bli problem.
I ClickHouse finns det en speciell funktion – kvotberäkning. Du kan även ange din egen kvotnyckel, som till exempel en intern användaridentifikator. Kvoterna räknas oberoende för var och en av dem.
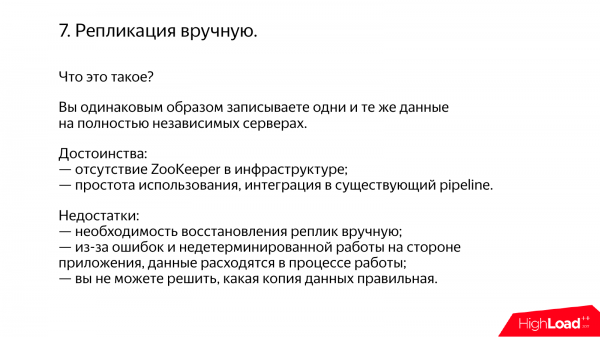
Nu kommer vi till en intressant sak till. Det handlar om manuell replikering.
Jag känner till många fall där, trots att ClickHouse har inbyggt stöd för replikering, människor repeterar ClickHouse manuellt.
Hur fungerar det? Du har en databehandlingspipeline som arbetar oberoende, till exempel i olika datacenter. Du skriver identiska data på ett identiskt sätt till ClickHouse. Men i praktiken visar det sig att data ändå kommer att skingras på grund av vissa egenskaper i din kod, vilket jag hoppas inte gäller för din.
Och du kommer ändå att behöva synkronisera manuellt periodiskt. Till exempel gör administratörer en rsync en gång i månaden.
Det är faktiskt mycket enklare att använda den inbyggda replikeringen i ClickHouse. Men det kan finnas vissa nackdelar, eftersom det kräver att du använder ZooKeeper. Jag tänker inte tala illa om ZooKeeper; i grunden är systemet fungerande, men ibland använder folk det inte på grund av rädslan för Java, eftersom ClickHouse är ett så bra system skrivet i C++ som fungerar utmärkt. Men ZooKeeper är på Java. Och det känns som man helst vill undvika det, men då kan du använda manuell replikation.
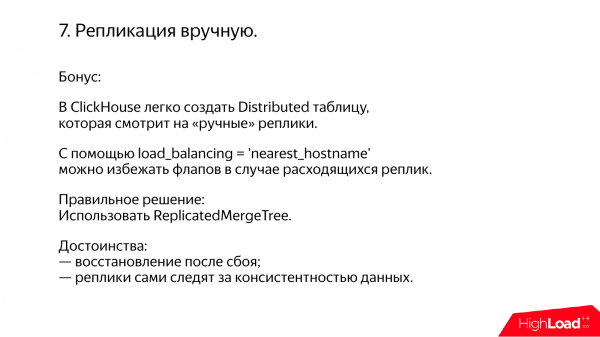
ClickHouse är ett praktiskt system. Det tar hänsyn till dina behov. Om du har manuell replikation kan du skapa en distribuerad tabell som tittar på dina manuella repliker och själv gör failover mellan dem. Det finns till och med ett speciellt alternativ för att undvika flap, även om dina repliker konsekvent skingras.
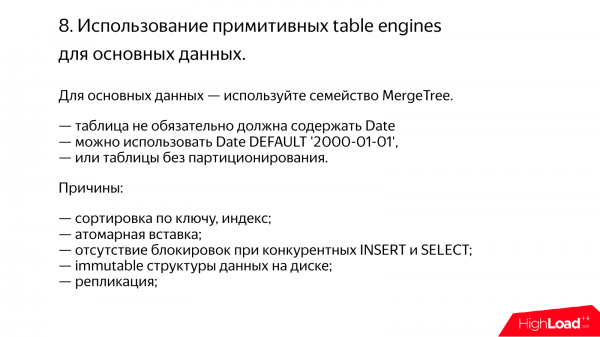
Det kan uppstå problem om du använder primitiva tabellmotorer. ClickHouse är en slags byggsats med massor av olika tabellmotorer. För alla seriösa fall, som beskrivs i dokumentationen, rekommenderas det att använda tabeller från MergeTree-familjen. De andra är mer för speciella fall eller tester.
I MergeTree-tabellen behöver du inte nödvändigtvis ha något datum eller tid. Du kan ändå använda det. Om det inte finns något datum och tid, kan du sätta att standarden är 2000, så kommer det att fungera och inte kräva några resurser.
I den nya versionen av servern kan du även specificera att du vill ha anpassad partitionering utan partitionsnyckel. Det kommer att vara detsamma.
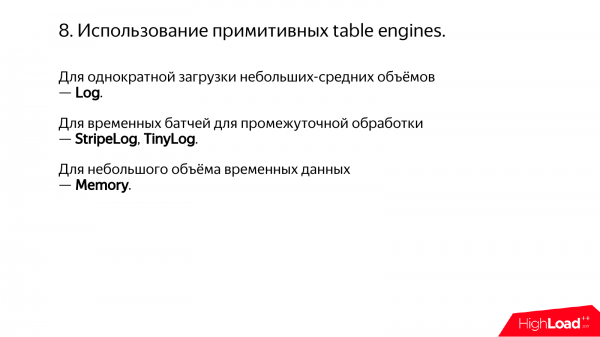
Å andra sidan kan du använda primitiva tabellmotorer. Till exempel kan du ladda data en gång och sedan utforska, manipulera och radera. Du kan använda Log.
Eller lagra små mängder för mellanbearbetning – detta är StripeLog eller TinyLog.
Memory kan användas om datavolymen är liten och du bara vill manipulera något i RAM.
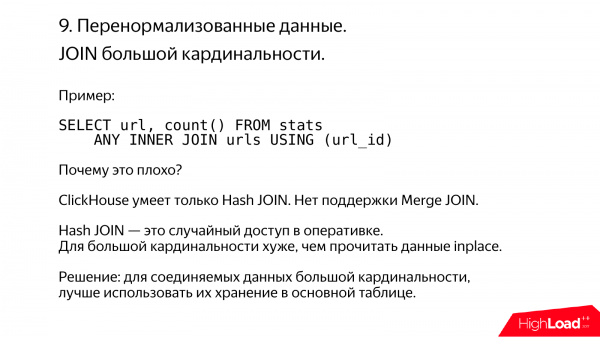
ClickHouse gillar inte övernormaliserade data särskilt mycket.
Här är ett typiskt exempel. Det är en stor mängd URL:er. Du har lagt dem i en närliggande tabell. Och sedan beslutade du att göra en JOIN med dem, men det kommer vanligtvis inte att fungera eftersom ClickHouse endast stöder Hash JOIN. Om det inte finns tillräckligt med RAM för de många data som ska kopplas ihop, kan JOIN inte genomföras.
Om data har hög cardinalitet, slösa inte tid på det, lagra dem i denormaliserad form, URL:er direkt inplace i huvudtabellen.
* Men nu finns det merge join i ClickHouse också, och det fungerar under omständigheter där mellanliggande data inte får plats i RAM. Men det är ineffektivt och rekommendationen kvarstår.
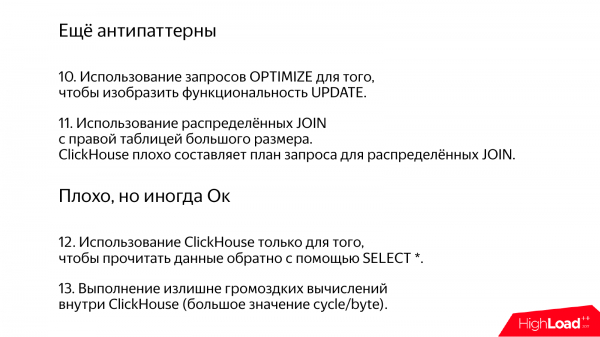
Ytterligare några exempel, men jag börjar tvivla på om de verkligen är antipatroner eller inte.
ClickHouse har en känd nackdel. Den kan inte hantera uppdateringar. På ett sätt är det faktiskt bra. Om du har viktiga data, till exempel bokföring, kommer ingen att kunna skicka dem eftersom det inte finns några uppdateringar.
* Stöd för uppdateringar och borttagningar i batchläge har länge lagts till.
Men det finns vissa speciella metoder som gör att uppdateringar kan ske i bakgrunden. Till exempel tabeller av typen ReplaceMergeTree. De utför uppdateringar under bakgrundsmeldningar. Du kan tvinga detta med hjälp av optimize table. Men gör inte detta för ofta, eftersom det medför en fullständig omskrivning av partitionen.
Distribuerade JOINs i ClickHouse – det hanteras inte bra av frågeplaneraren.
Dåligt, men ibland är det okej.
Att använda ClickHouse endast för att läsa tillbaka data med hjälp av select.
Jag skulle inte rekommendera att använda ClickHouse för tunga beräkningar. Men det är inte helt sant, eftersom vi redan avviker från den rekommendationen. Och vi har nyligen lagt till möjligheten att tillämpa maskininlärningsmodeller i ClickHouse – Catboost. Och det oroar mig, för jag tänker: "Herregud. Hur många cykler per byte blir det här!". Jag hatar verkligen att slösa cykler på bytes.
Men var inte rädd, installera ClickHouse, allt kommer att gå bra. Om det är något, så har vi en gemenskap. Förresten, gemenskapen är ni. Och om ni har några problem kan ni åtminstone gå in i vår chatt, och jag hoppas att ni får hjälp.
Frågor
Tack för presentationen! Vart ska jag klaga på ClickHouse-nedgångar?
Du kan klaga till mig personligen just nu.
Jag började använda ClickHouse nyligen. Föll direkt ner kommandoradsgränssnittet.
Du har tur.
Lite senare kraschade jag servern med en liten select.
Du har talang.
Jag öppnade en bugg på GitHub, men den ignorerades.
Låt oss se.
Alexey lurade mig att delta i presentationen, han lovade att berätta hur ni komprimerar data.
Väldigt enkelt.
Det förstod jag redan igår. Mer konkreta exempel.
Det finns inga hemska knep. Det handlar helt enkelt om blockkomprimering. Som standard används LZ4, men man kan aktivera ZSTD*. Blocken är mellan 64 kilobyte och 1 megabyte.
* det finns också stöd för specialiserade komprimeringskodar som kan användas i kedjor med andra algoritmer.
Är blocken bara rådata?
Inte helt råa. Där finns arrayer. Om du har en numerisk kolumn, så är siffrorna placerade sekventiellt i en array.
Förstått.
Alexey, exemplet med uniqExact över IP-adresser, dvs. att uniqExact tar längre tid att beräkna över strängar än över siffror och så vidare. Och om vi tillämpar en trick och kastar vid läsning? Dvs. ni nämnde att det inte skiljer sig mycket på disken. Om vi läser strängar från disken och kastar, kommer våra aggregat att vara snabbare eller inte? Eller får vi fortfarande en obetydlig vinst här? Jag tycker att ni testade detta, men av någon anledning angav ni inte det i benchmarken.
Jag tror att det kommer att vara långsammare än utan casting. I så fall måste IP-adressen parseras från strängen. Vi har givetvis också optimerad parsing av IP-adresser i ClickHouse. Vi har gjort vårt bästa, men där är ju siffrorna skrivna i tiotusentalsformat. Mycket besvärligt. Å andra sidan kommer uniqExact-funktionen att fungera långsammare på strängar, inte bara för att det är strängar, utan också för att en annan algoritmspecialisering väljs. Strängar bearbetas helt enkelt på ett annat sätt.
Men vad om vi tar en mer primitiv datatyp? Till exempel, vi har skrivit user id, som vi har in, skrivit det som en sträng, och sedan castat, blir det roligare eller inte?
Jag tvivlar. Jag tror att det kommer att bli ännu tristare, eftersom parsing av siffror ändå är ett allvarligt problem. Jag tror att den här kollegan till och med hade en presentation om hur svårt det är att parse siffror i tiotusentalsformat, eller kanske inte.
Alexey, stort tack för presentationen! Och stort tack för ClickHouse! Jag har en fråga om funktionerna. Finns det planer på en funktion för att uppdatera lexikonet delvis?
Det vill säga, partiell omladdning?
Ja, ja. Typ möjligheten att ange ett MySQL-fält där man kan uppdatera efter, så att endast dessa data laddas om lexikonet är väldigt stort.
Mycket intressant funktion. Och jag tycker att någon kille föreslog den i vår chatt. Kanske var det till och med du.
Jag tror inte det.
Utmärkt, nu visar det sig att det är två förfrågningar. Och man kan lugnt börja göra. Men jag vill genast varna er för att den här funktionen är ganska enkel att implementera. Det vill säga, i teorin behöver man bara skriva versionsnumret i tabellen och sedan skriva: version mindre än så här. Och det betyder att vi troligen kommer att föreslå att entusiasterna gör det. Är du en entusiast?
Ja, men tyvärr inte i C++.
Kan dina kollegor skriva i C++?
Jag ska hitta någon.
Utmärkt*.
* möjligheten lades till två månader efter presentationen – den utvecklades av frågeställaren och skickades in. .
Tack!
Hej! Tack för föredraget! Du nämnde att ClickHouse mycket effektivt använder alla tillgängliga resurser. Och talaren intill från Luxoft berättade om sin lösning för PostNord. Han sa att de verkligen gillade ClickHouse, men de använde det inte istället för sin huvudsakliga konkurrent eftersom det tog upp hela processorn. Och de kunde inte få in det i sin arkitektur, i sin ZooKeeper med Docker. Finns det något sätt att begränsa ClickHouse så att det inte utnyttjar allt som blir tillgängligt för det?
Ja, det kan man och det är väldigt enkelt. Om du vill att det ska använda färre kärnor, skriv bara set max_threads = 1. Och allt, det kommer att utföra förfrågan på en kärna. Dessutom kan olika användare ges olika den här inställningen. Så inga problem alls. Och säg till kollegorna från Luxoft att det inte är bra att de inte hittade den här inställningen i dokumentationen.
Alexey, hej! Jag skulle vilja ställa en fråga. Jag har hört flera gånger nu att många börjar använda ClickHouse som lagring för loggar. I föredraget sa du att man inte bör göra så, d.v.s. att man inte behöver lagra långa rader. Vad tycker du om det?
För det första, loggar är oftast inte långa rader. Det finns dock undantag. Till exempel, en tjänst skriven i java kastar ett undantag, det loggas. Och så i en oändlig loop, och det tar slut på utrymme på hårddisken. Lösningen är mycket enkel. Om raderna är väldigt långa, så klipp dem. Men vad betyder långa? Tiotals kilobyte – det är dåligt*.
* i de senaste versionerna av ClickHouse är "adaptiv granuleringsindexering" aktiverat, vilket löser problemet med att lagra långa rader till stor del.
Är en kilobyte okej?
Okej.
Hej! Tack för föredraget! Jag har redan frågat om detta i chatten, men jag kommer inte ihåg om jag fått svar. Planerar ni att på något sätt utöka sektionen WITH i stil med CTE?
Inte för tillfället. Sektionen WITH är lite ofullständig. Den är mer som en liten funktion.
Jag förstår. Tack!
Tack för föredraget! Mycket intressant! En övergripande fråga. Planerar ni att göra, kanske i form av några dummys, en modifiering för att ta bort data?
Absolut. Detta är vår första uppgift i vår kö. Vi har nu aktivt tänkt igenom hur man gör allt rätt. Och det är dags att börja trycka på tangentbordet*.
* tryckte på knapparna på tangentbordet och gjorde allt.
Kommer detta att påverka systemets prestanda på något sätt? Kommer inmatningen att vara lika snabb som den är nu?
Kanske själva deletes och updates blir mycket tunga, men det påverkar inte prestandan för selects och inserts.
Och en liten fråga till. På presentationen talade ni om primary key. Således har vi partitionering som som standard är månadsvis, eller hur? Och när vi ställer in ett dataintervall som faller inom en månad, så läser vi endast den partitionen, eller hur?
Ja.
Så här är en fråga. Om vi inte kan särskilja någon primary key, är det korrekt att göra det baserat på fältet "Datum" för att minimera omstruktureringen av dessa data så att de hålls mer ordnat? Om ni inte har intervallsökningar och inte ens kan välja någon primärnyckel, bör man då sätta datumet i primärnyckeln?
Ja.
Kanske är det meningsfullt att inkludera ett fält i primärnyckeln där data komprimeras bättre om de sorteras på det fältet. Till exempel, användarens identifierare. Användaren besöker kanske samma webbplats. I det här fallet inkluderar ni användarens id och tiden. Då kommer era data att komprimeras bättre. När det gäller datum, om ni verkligen inte har och aldrig har några intervallsökningar baserad på datum, så kan ni kanske låta bli att sätta datumet i primärnyckeln.
Tack så mycket!
Källa: habr.com
