

Sökning av funktionella beroenden i data tillämpas inom olika områden av dataanalys: databasförvaltning, datarensning, reverse engineering av databaser och datautforskning. Vi har redan publicerat om själva beroenden. Anastasia Birillo och Nikita Bobrov. Denna gång delar Anastasia - en nyutexaminerad från Computer Science Center det här året - med sig av utvecklingen av detta arbete inom ramen för sitt forskningsprojekt, som hon försvarade vid centret.
Val av uppgift
Under min utbildning i CS-centret började jag fördjupa mig i databaser, specifikt sökning av funktionella och differentierade beroenden. Det här ämnet var relaterat till min uppsats i universitetet, så under arbetet med uppsatsen började jag läsa artiklar om olika beroenden i databaser. Jag skrev en översikt över detta område - en av mina första. på engelska och skickade den till konferensen SEIM-2017. Jag blev mycket glad när jag fick veta att den hade accepterats, och jag beslutade mig för att fördjupa mig i ämnet. Själva konceptet är inte nytt - det började användas redan på 90-talet, men det tillämpas fortfarande inom många områden.
Under andra terminen av utbildningen i centret började jag ett forskningsprojekt för att förbättra algoritmer för sökning av funktionella beroenden. Jag arbetade med detta tillsammans med doktoranden Nikita Bobrov från SPbGU på basis av JetBrains Research.
Beräkningskomplexiteten för sökningen av funktionella beroenden
Det huvudsakliga problemet är beräkningskomplexiteten. Antalet möjliga minimala och icke-triviala beroenden är begränsat av värdet  , där
 — antalet attribut i tabellen. Algoritmernas körtid beror inte bara på antalet attribut utan också på antalet rader. Under 90-talet kunde algoritmer för sökning av funktionella beroenden på vanliga stationära datorer bearbeta datamängder som innehöll upp till 20 attribut och tiotusentals rader på upp till flera timmar. Moderna algoritmer, som körs på flerkärniga processorer, upptäcker beroenden för datamängder bestående av hundratals attribut (upp till 200) och hundratusentals rader på ungefär samma tid. Ändå är detta otillräckligt: sådan tid är oacceptabel för de flesta verkliga applikationer. Därför har vi utvecklat metoder för att snabba upp befintliga algoritmer.
Cache-scheman för partitioneringsintersektion
I den första delen av arbetet utvecklade vi cache-scheman för en klass av algoritmer som använder metoden för partiell överlappning. En partition för en attribut representerar en uppsättning listor, där varje lista innehåller radnummer med samma värden för det aktuella attributet. Varje sådan lista kallas ett kluster. Många moderna algoritmer använder partitioner för att bestämma om en beroende hålls eller inte, och följer den lemma: Beroende  hålls om
 . Här
 betecknas partitionen och begreppet partitionsstorlek används — antalet kluster i den. Algoritmer som använder partitioner lägger till ytterligare attribut i vänster del av beroendet när beroendet bryts, varefter de räknar om det genom att utföra operationen av partiell överlappning. Denna operation kallas specialisering i artiklar. Men vi har noterat att partitioner för beroenden som kommer att hållas först efter flera omgångar av specialisering kan återanvändas aktivt, vilket kan avsevärt minska algoritmernas körtid, eftersom operationen av partiell överlappning är kostsam.
Därför föreslog vi en heuristik baserad på Shannon-entropi och Gini-osäkerhet, samt vår metrik som vi kallade Invers Entropi. Den är en obetydlig modifiering av Shannon-entropin och ökar i takt med att unikheten av datasetet ökar. Den föreslagna heuristiken ser ut som följer:

Här  — graden av unikhet hos den nyligen beräknade partitionen
 , och
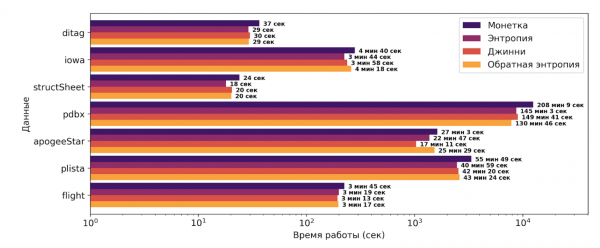
 är medianen av unikhetsgrader för specifika attribut. Som en unikhetsmetrik testades alla tre metoderna som beskrevs ovan. Det kan också noteras att det finns två modifierare i heuristiken. Den första indikerar hur nära den aktuella partitionen är den primära nyckeln och möjliggör mer caching av partitioner som ligger långt från den potentiella nyckeln. Den andra modifieraren tillåter övervakning av cachebelastningen och stimulerar därmed tillägg av fler partitioner i cachen när det finns ledigt utrymme. Att framgångsrikt lösa denna uppgift har möjliggjort en hastighetsökning av algoritmen PYRO med 10-40% beroende på datamängden. Det är värt att notera att algoritmen PYRO är den mest framgångsrika inom detta område.
I diagrammet nedan syns resultaten av tillämpningen av den föreslagna heuristiken jämfört med den grundläggande cachingmetoden, som baserades på att kasta en mynt. X-axeln är logaritmisk.
Alternativt sätt att lagra partitioner
Därefter föreslog vi ett alternativt sätt att lagra partitioner. Partitioner representerar en uppsättning kluster, där var och en lagrar nummer på tuples med samma värden för vissa attribut. Dessa kluster kan innehålla långa sekvenser av tuplesnummer, till exempel om data i tabellen är ordnade. Därför föreslog vi ett komprimeringsschema för lagring av partitioner, nämligen intervalllagring av värden i partitionernas kluster:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Första~intervallet}, underbrace{7, 8}_{Andra~intervallet}, 10}}\ downarrow{Komprimering}\ pi(X) = {{underbrace{$, 1, 5}_{Första~intervallet}, underbrace{7, 8}_{Andra~intervallet}, 10}}$$display$$
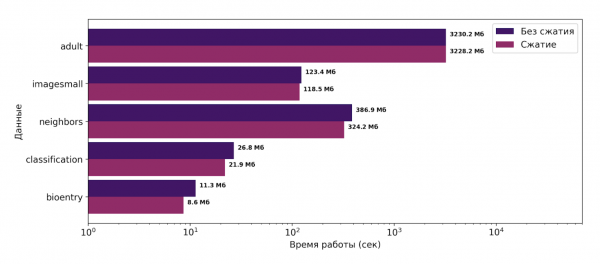
Denna metod lyckades minska minnesförbrukningen vid körningen av algoritmen TANE med 1 till 25%. Algoritmen TANE är en klassisk algoritm för att söka efter funktionella beroenden, och den använder partitioner under sin verksamhet. I praktiken valdes just algoritmen TANE, eftersom det var mycket enklare att implementera intervalllagring i den än i PYRO, för att utvärdera om den föreslagna metoden fungerar. Resultaten som erhölls visas i diagrammet nedan. X-axeln är logaritmisk.
ADBIS-2019-konferensen
Enligt resultaten av studien i september 2019 presenterade jag en artikel Vid konferensen 23rd European Conference on Advances in Databases and Information Systems (ADBIS-2019) berömde Bernhard Thalheim, en framstående person inom databaser, arbetet under presentationen. Resultaten från forskningen låg till grund för min magisteruppsats vid matematikmekaniska institutionen vid SPbGU, där båda de föreslagna metoderna (cache-lagring och komprimering) implementerades i båda algoritmerna: TANE och PYRO. Resultaten visade att de föreslagna metoderna är universella, eftersom båda algoritmerna uppvisade en betydande minskning av minnesanvändningen samt en betydande minskning av algoritmernas körtid.
Källa: habr.com
