

Fortsätter ämnet att spela in stora datastreamar som lyftes , här kommer vi att undersöka sätt att minska den "fysiska" storleken på den lagrade i PostgreSQL, och deras påverkan på serverprestanda.
Vi kommer att prata om TOAST-inställningar och datajustering. "I genomsnitt" kommer dessa metoder att spara inte särskilt mycket resurser, men — helt utan att modifiera applikationskoden.
Dock har vår erfarenhet varit mycket produktiv på detta område, eftersom lagringen av nästan vilken övervakning som helst i sin natur är största delen append-only ur synvinkel av de skrivna data. Och om du är intresserad av hur man kan få databasen att skriva till disk istället för 200MB/s halverat — vänligen läs vidare.
Små hemligheter om stora data
Genom arbetsprofilen , får den regelbundet in från loggarna textpaket.
Och eftersom , vars databaser vi övervakar, — är en flerkomponentprodukt med komplexa datastukturer, så blir även förfrågningarna för att uppnå maximal prestanda ganska . Så även volymen av varje enskild instans av en förfrågan eller den resulterande körplanen i loggen vi får är "i genomsnitt" ganska stor.
Låt oss titta på strukturen av en av tabellerna där vi skriver "rådata" — det vill säga den ursprungliga texten direkt från loggposten:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- sektionens nyckel
    date
, data -- det viktigaste
    text
, PRIMARY KEY(pack, recno)
);
En typisk sådan tabell (redan partitionerad, såklart, därför är detta — en sektionmall), där det viktigaste är文本. Ibland ganska omfattande.
Kom ihåg att den "fysiska" storleken på en post i PG inte kan överstiga en databasida, men den "logiska" storleken — är något helt annat. För att skriva ett stort värde i ett fält (varchar/text/bytea) används :
PostgreSQL använder en fast sidstorlek (vanligtvis 8 KB) och tillåter inte att tupler upptar flera sidor. Därför är det inte möjligt att direkt lagra mycket stora fältvärden. För att övervinna denna begränsning komprimeras och/eller delas stora fältvärden upp i flera fysiska rader. Detta sker osynligt för användaren och påverkar för det mesta serverns kod marginellt. Denna metod kallas TOAST …
Faktiskt, för varje tabell med "potentiellt stora" fält skapas automatiskt av varje "stor" post i segment om 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
Det vill säga om vi behöver skriva en rad med ett "stort" värde data, så kommer den verkliga posten att ske inte bara i den primära tabellen och dess PK, utan även i TOAST och dess PK.
Minska påverkan av TOAST
Men de flesta poster är inte så stora, i 8KB bör de få plats — hur kan vi spara på detta?..
Här kommer hjälp av attributet hos tabellens kolumn:
- EXTENDED tillåter både komprimering och separat lagring. Detta är den standardalternativ för de flesta datatyper som är kompatibla med TOAST. Först görs ett försök att komprimera, sedan - lagras utanför tabellen, om raden fortfarande är för stor.
- MAIN tillåter komprimering men inte separat lagring. (Faktiskt, separat lagring kommer att utföras för sådana kolumner, men endast som en sista åtgärd, när det inte finns något annat sätt att minska raden så att den får plats på sidan.)
Faktiskt är detta precis vad vi behöver för text — komprimera maximalt, och om det verkligen inte går in — flytta till TOAST. Detta kan göras direkt "i farten", med ett kommando:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Hur utvärdera effekten
Eftersom datamängden förändras varje dag kan vi inte jämföra absoluta siffror, men i relativa termer är ju ju mindre andel vi skriver till TOAST — desto bättre. Men här finns en risk – ju mer "fysisk" volym varje enskild post har, desto "bredare" blir indexet, eftersom det måste täcka ett större antal datakoder.
Sektion före ändringar:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Sektion efter ändringar:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
Faktiskt har vi börjat skriva till TOAST dubbelt så sällan, vilket lett till att både disken och CPU:n har blivit avlastade:
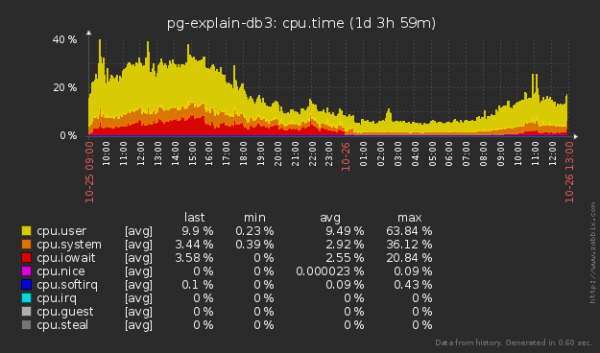
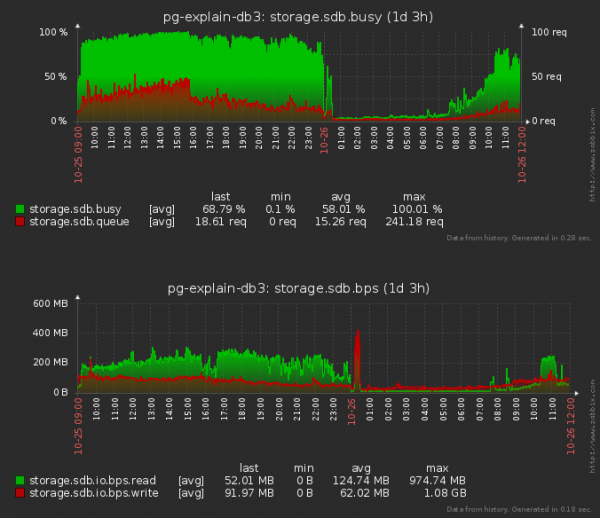
Jag vill påminna om att vi också har börjat "läsa" disken mindre, inte bara "skriva" — eftersom när en post ska infogas i en tabell måste en del av trädet för varje index "läsa" för att bestämma dess framtida position.
Vem mår bra av PostgreSQL 11
Efter uppgraderingen till PG11 beslöt vi att fortsätta "justeringen" av TOAST och noterade att en inställning blev tillgänglig för konfiguration från och med denna version. :
Koden för TOAST-processingen aktiveras endast när storleken på strängvärdet som ska lagras i tabellen överskrider TOAST_TUPLE_THRESHOLD byte (vanligtvis 2 KB). TOAST-koden kommer att komprimera och/eller flytta fältvärden utanför tabellen tills strängvärdet är mindre än TOAST_TUPLE_TARGET byte (en variabel storlek, oftast också 2 KB) eller tills volymreducering inte längre är möjlig.
Vi kom fram till att våra data vanligtvis antingen är "mycket korta" eller "väldigt långa", så vi beslutade att hålla oss till det minimala möjliga värdet:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Låt oss se hur de nya inställningarna påverkade diskbelastningen efter omkonfigureringen:
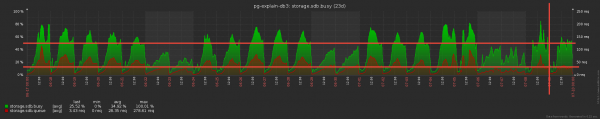
Inte illa! Den genomsnittliga diskköen minskade ungefär med 1,5 gånger, och "beläggningen" på disken minskade med cirka 20%! Men kanske det påverkar CPU:n på något sätt?
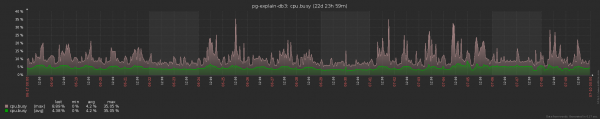
I alla fall blev det definitivt inte sämre. Även om det är svårt att avgöra, eftersom dessa volymer ändå inte kan höja den genomsnittliga CPU-belastningen över 5%.
Byter man platser på summorna... förändras summan!
Som bekant sparar en kåk en rubel, och med våra lagringsvolymer på omkring 10TB/månad kan även en liten optimering ge ganska bra vinster. Därför uppmärksammade vi den fysiska strukturen av våra data — hur exakt "fälten" ligger inom varje post i varje tabell.
Eftersom på grund av detta direkt :
Många arkitekturer förutsätter datajustering vid maskinordningsgränser. Till exempel, på ett 32-bitarssystem x86 kommer heltal (typ integer, som tar 4 byte) att justeras enligt 4-byteordningsgränser, precis som flyttal med dubbel precision (typ double precision, 8 byte). Och på ett 64-bitarssystem kommer double-värden att justeras enligt 8-byteordningsgränser. Det här är ytterligare en orsak till inkompatibilitet.
På grund av justeringen beror storleken på tabellraden på ordningen av fälten. Vanligtvis är denna effekt inte mycket märkbar, men i vissa fall kan den leda till en betydande ökning av storleken. Till exempel, om man blandar fälten av typen char(1) och integer, kommer det vanligtvis att gå förlorade 3 byte mellan dem.
Låt oss börja med syntetiska modeller:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 byte

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 byte
Varifrån kom de extra 2 byten i det första fallet? Det är enkelt — 2-byte smallint justeras till en 4-byte gräns före nästa fält, och när det står sist behöver man inte justera något.
I teorin är allt bra och man kan flytta fälten hur som helst. Låt oss kontrollera på verkliga data som ett exempel från en av tabellerna vars dagliga sektion tar upp 10-15GB.
Den ursprungliga strukturen:
CREATE TABLE public.plan_20190220
(
-- Ärvt från tabell plan:  pack uuid NOT NULL,
-- Ärvt från tabell plan:  recno smallint NOT NULL,
-- Ärvt från tabell plan:  host uuid,
-- Ärvt från tabell plan:  ts timestamp with time zone,
-- Ärvt från tabell plan:  exectime numeric(32,3),
-- Ärvt från tabell plan:  duration numeric(32,3),
-- Ärvt från tabell plan:  bufint bigint,
-- Ärvt från tabell plan:  bufmem bigint,
-- Ärvt från tabell plan:  bufdsk bigint,
-- Ärvt från tabell plan:  apn uuid,
-- Ärvt från tabell plan:  ptr uuid,
-- Ärvt från tabell plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Sektionen efter att kolumnerna har bytt ordning — precis samma fält, bara en annan ordning:
CREATE TABLE public.plan_20190221
(
-- Ärvt från tabell plan:  dt date NOT NULL,
-- Ärvt från tabell plan:  ts timestamp with time zone,
-- Ärvt från tabell plan:  pack uuid NOT NULL,
-- Ärvt från tabell plan:  recno smallint NOT NULL,
-- Ärvt från tabell plan:  host uuid,
-- Ärvt från tabell plan:  apn uuid,
-- Ärvt från tabell plan:  ptr uuid,
-- Ärvt från tabell plan:  bufint bigint,
-- Ärvt från tabell plan:  bufmem bigint,
-- Ärvt från tabell plan:  bufdsk bigint,
-- Ärvt från tabell plan:  exectime numeric(32,3),
-- Ärvt från tabell plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Den totala volymen av sektionen bestäms av antalet "fakta" och beror endast på externa processer, så låt oss dela storleken på heap (pg_relation_size) på antalet poster i den — så vi får den genomsnittliga storleken på en verklig lagrad post:
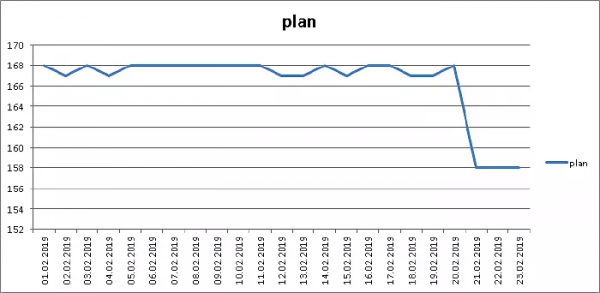
Minus 6% volym, bra!
Men allt är givetvis inte så positivt — för i indexen kan vi inte ändra ordningen på fälten, och därför "i stort" (pg_total_relation_size)…
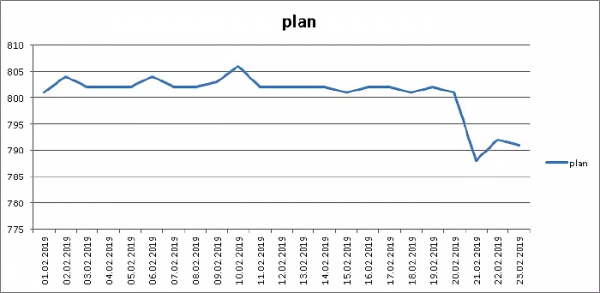
… ändå här sparade vi 1.5%, utan att ändra en enda kodrad. Precis så!
Jag påpekar att den ovanstående arrangemanget av fälten — inte nödvändigtvis den mest optimala. Eftersom vissa fältblock vill man inte "bryta" av estetiska skäl — till exempel paret (pack, recno), som är PK för denna tabell.
I stort sett är definitionen av den "minimala" arrangemanget av fält en ganska enkel "brute force"-uppgift. Så ni kan på era data få resultat till och med bättre än våra — ge det ett försök!
Källa: habr.com
