

Hej alla. Vi utvecklar en produkt för analys av offline-trafik. I projektet finns en uppgift relaterad till statistisk analys av besökares rörelser mellan områden.
Inom ramen för denna uppgift kan användare ställa systemet frågor av följande typ:
- hur många besökare har gått från område "A" till område "B";
- hur många besökare har gått från område "A" till område "B" via område "C", och sedan via område "D";
- hur lång tid det tog för en viss typ av besökare att gå från område "A" till område "B".
och en rad liknande analytiska frågor.
Besökarens rörelse mellan områden representerar en riktad graf. Efter att ha läst på internet upptäckte jag att grafdatabaser också används för analytiska rapporter. Jag fick en önskan att se hur bra grafdatabaser skulle hantera sådana frågor (TL;DR; dåligt).
Jag valde att använda databasen , som en framstående representant för grafdatabaser med öppen källkod, som bygger på en samling mogna teknologier som (enligt min åsikt) borde ge den anständiga prestanda:
- lagringsbackend BerkeleyDB, Apache Cassandra, Scylla;
- komplexa index kan lagras i Lucene, Elasticsearch, Solr.
Författarna till JanusGraph skriver att den passar både för OLTP och OLAP.
Jag har arbetat med BerkeleyDB, Apache Cassandra, Scylla och ES, dessutom används dessa produkter ofta i våra system, så jag såg optimistiskt på testningen av denna grafdatabas. Jag tyckte valet av BerkeleyDB istället för RocksDB verkade märkligt, men det beror antagligen på krav på transaktioner. I vilket fall som helst, för skalbar, produktiv användning föreslås det att använda backend på Cassandra eller Scylla.
Jag övervägde inte Neo4j, eftersom den kommersiella versionen krävs för klustring, vilket innebär att produkten inte är öppen.
Grafdatabaser säger: "Om något ser ut som en graf - behandla det som en graf!" - vackert!
Först ritade jag en graf som verkligen är gjord enligt grafdatabasens kanoner:
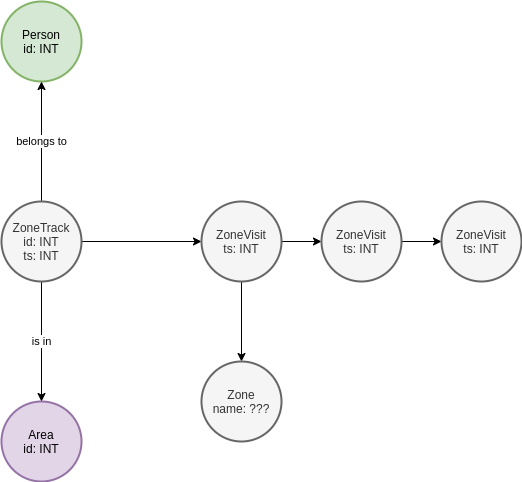
Det finns en entitet Zone, som ansvarar för området. Om ZoneStep tillhör denna Zone, så refererar den till den. Angående entiteten Area, ZoneTrack, Person och ignorera dem, de tillhör domänen och beaktas inte i testet. Så sammanfattningsvis skulle en sökfråga för en sådan grafstruktur se ut som:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
På svenska betyder detta ungefär: hitta Zone med ID=0, ta alla noder som har en kant (ZoneStep) till den, fortsätt utan att backa förrän du hittar sådana ZoneStep som har en kant till Zone med ID=19, räkna antalet sådana kedjor.
Jag påstår inte att jag känner till alla nyanser av graf-sökning, men denna fråga genererades baserat på denna bok ().
Jag laddade upp 50 000 spår med längd från 3 till 20 punkter i grafdatabasen JanusGraph som använder BerkeleyDB som backend, skapade index enligt .
Script för uppladdning i Python:
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
En VM med 4 kärnor och 16 GB RAM på SSD användes. JanusGraph distribuerades med följande kommando:
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestI det här fallet lagras data och index som används för att söka efter exakta matchningar i BerkeleyDB. När jag körde frågan ovan fick jag en tid på några tiotals sekunder.
Genom att köra de 4 ovanstående skripten parallellt lyckades jag omvandla databasen till en pumpa med ett glatt flöde av Java-stacks (och vi älskar alla att läsa Java-stacks) i Docker-loggarna.
Efter att ha funderat bestämde jag mig för att förenkla grafens schema till följande:
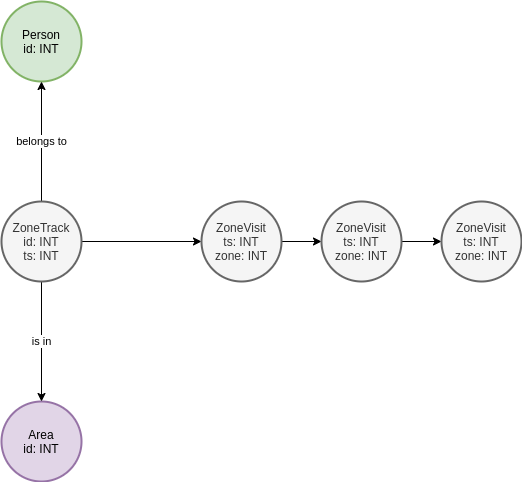
Jag insåg att sökning efter egenskaper hos entiteter skulle gå snabbare än att söka efter kanter. Resultatet blev att min fråga förvandlades till följande:
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()På svenska betyder detta ungefär: hitta ZoneStep med ID=0, fortsätt utan att backa tills du hittar ZoneStep med ID=19, räkna antalet sådana kedjor.
Jag förenklade också skriptet för uppladdning som ovan, för att undvika att skapa onödiga relationer och begränsa mig till attribut.
Förfrågan tog fortfarande några sekunder, vilket var helt oacceptabelt för vår uppgift, eftersom det inte alls passade för AdHoc-förfrågningar av olika slag.
Jag försökte köra JanusGraph med Scylla, som är den snabbaste implementationen av Cassandra, men det ledde inte till några betydande förändringar i prestandan.
Så, trots att "det ser ut som en graf", lyckades jag inte få den grafiska databasen att bearbeta detta snabbt. Jag antog att jag inte visste något och att man kan få JanusGraph att utföra denna sökning på bråkdelen av en sekund, men jag lyckades inte.
Eftersom jag ändå behövde lösa uppgiften började jag tänka på JOINs och pivot-tabeller, vilket inte kändes hoppfullt ur ett elegansperspektiv, men som mycket väl kunde vara en praktisk lösning.
I vårt projekt använder vi redan Apache ClickHouse, så jag beslutade att testa mina undersökningar på denna analytiska databas.
Jag installerade ClickHouse enligt ett enkelt recept:
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
Jag skapade en databas och en tabell av följande typ:
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
Jag fyllde den med data enligt följande skript:
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Eftersom insättningarna görs i batchar, var fyllningen mycket snabbare än för JanusGraph.
Jag konstruerade två förfrågningar med hjälp av JOIN. För att gå från punkt A till punkt B:
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
För att gå genom 3 punkter:
VÄLJ s3.person,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zone,
       s3.when
FRÅN
  (VÄLJ s1.person SOM person,
          s1.zone SOM s1z,
          s1.when SOM s1w,
          s2.zone SOM s2z,
          s2.when SOM s2w
   FRÅN
     (VÄLJ *
      FRÅN steps
      DÄR (area = 0)
        OCH (zone = 0)) SOM s1 ANY INNER JOIN
     (VÄLJ *
      FRÅN steps SOM s2
      DÄR (area = 0)
        OCH (zone = 3)) SOM s2 ANVÄND person
   DÄR s1.when <= s2.when) p ANY INNER JOIN
  (VÄLJ *
   FRÅN steps
   DÄR (area = 0)
     OCH (zone = 19)) SOM s3 ANVÄND person
DÄR p.s2w <= s3.when
Frågorna ser naturligtvis ganska skrämmande ut, för verklig användning krävs det att man gör ett programmeringslager-generator. Men de fungerar och de fungerar snabbt. Både den första och den andra frågan utförs på mindre än 0,1 sek. Här är ett exempel på frågetid för count(*) över 3 punkter:
VÄLJ count(*)
FRÅN
(
    VÄLJ
        s1.person SOM person,
        s1.zone SOM s1z,
        s1.when SOM s1w,
        s2.zone SOM s2z,
        s2.when SOM s2w
    FRÅN
    (
        VÄLJ *
        FRÅN steps
        DÄR (area = 0) OCH (zone = 0)
    ) SOM s1
    ANY INNER JOIN
    (
        VÄLJ *
        FRÅN steps SOM s2
        DÄR (area = 0) OCH (zone = 3)
    ) SOM s2 ANVÄND (person)
    DÄR s1.when <= s2.when
) SOM p
ANY INNER JOIN
(
    VÄLJ *
    FRÅN steps
    DÄR (area = 0) OCH (zone = 19)
) SOM s3 ANVÄND (person)
DÄR p.s2w <= s3.when

┌─count()─┐
│   11592 │
└─────────┘
1 rad i uppsättning. Förfluten tid: 0,068 sek. Bearbetade 250,03 tusen rader, 8,00 MB (3,69 miljoner rader/s, 117,98 MB/s.)Anmärkning om IOPS. Vid datainmatning genererade JanusGraph ett ganska högt antal IOPS (1000-1300 för fyra datainmatningsströmmar), och IOWAIT var ganska hög. Under tiden genererade ClickHouse minimal belastning på diskunderstödsystemet.
Slutsats
Vi beslutade att använda ClickHouse för att hantera frågor av den här typen. Vi kan alltid ytterligare optimera frågorna genom att använda materialiserade vyer och parallellisering, genom att utföra förbehandling av händelseströmmen med Apache Flink innan vi laddar dem i ClickHouse.
Prestandan är så bra att vi troligen inte ens behöver tänka på pivot-tabeller med programvarulösningar. Tidigare var vi tvungna att skapa pivotar av data som extraherades från Vertica genom att exportera till Apache Parquet.
Tyvärr blev ännu ett försök att använda en grafdatabas misslyckat. Jag upptäckte inte att JanusGraph hade en vänlig ekosystem som möjliggör en snabb förståelse av produkten. Dessutom använder konfigurationen av servern den traditionella Java-vägen, vilket får personer som inte är bekanta med Java att gråta blodiga tårar:
värd: 0.0.0.0
port: 8182
trådPoolArbetare: 1
gremlinPool: 8
scriptUtvärderingTimeout: 30000
kanaliserare: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

grafHantera: org.janusgraph.graphdb.management.JanusGraphManager
grafer: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptMotorer: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary är här för att ersätta Gryo och Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo och Graphson, senaste versionerna
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # Äldre serialiseringversioner för bakåtkompatibilitet:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processorer:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
trådPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
Jag råkade "lägga in" BerkeleyDB-versionen av JanusGraph.
Dokumentationen är ganska bristfällig när det kommer till index, eftersom det krävs ganska underliga knep med Groovy för att hantera index. Till exempel måste index skapas genom att skriva kod i Gremlin-konsolen (som för övrigt inte fungerar direkt). Från den officiella dokumentationen för JanusGraph:
graph.tx().rollback() // Skapa aldrig nya index medan en transaktion är aktiv
mgmt = graph.openManagement()
name = mgmt.getPropertyKey('name')
age = mgmt.getPropertyKey('age')
mgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()
mgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()
mgmt.commit()

// Vänta på att indexet ska bli tillgängligt
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()
// Re-indexera den befintliga datan
mgmt = graph.openManagement()
mgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()
mgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()
mgmt.commit()
Epilog
På ett sätt är experimentet ovan en jämförelse mellan äpplen och päron. Om man tänker efter så utför grafikdatabasen andra operationer för att uppnå samma resultat. Under testerna genomförde jag också ett experiment med en förfrågan av typen:
g.V().hasLabel('ZoneStep').has('id',0)
    .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()
som speglar den stegvisa tillgängligheten. Men även med sådan data visade grafikdatabasen resultat som överskred några sekunder... Detta är förstås kopplat till att det fanns vägar som var 0 -> X -> Y ... -> 1, vilka grafikmotorn också kontrollerade.
Även för en förfrågan av typen:
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()kunde jag inte få ett effektivt svar med en behandlingstid under en sekund.
Moralen i sagan är att en vacker idé och paradigmatisk modellering inte leder till önskat resultat, som visar en betydligt högre effektivitet i exemplet med ClickHouse. Användarcaset som presenteras i denna artikel är en uppenbar antipattern för grafikdatabaser, även om det verkar lämpligt för modellering i deras paradigm.
Källa: habr.com
