

Som bekant erbjuder SAP ett fullt utbud av mjukvaror för både hantering av transaktionsdata och bearbetning av dessa data i analys- och rapporteringssystem. Plattformen SAP Business Warehouse (SAP BW) utgör ett verktyg för lagring och analys av data med omfattande tekniska möjligheter. Trots sina objektiva fördelar har SAP BW en betydande nackdel; det är höga kostnader för lagring och bearbetning av data, vilket blir särskilt påtagligt vid användning av molnbaserad SAP BW on HANA.
Vad händer om man i stället börjar använda något non-SAP, och helst OpenSource produkt som lagringssystem? Vi på X5 Retail Group har valt att gå med GreenPlum. Detta löser självklart kostnadsfrågan, men det uppstår omedelbart följdfrågor som nästan automatiskt hanterades vid användningen av SAP BW.
Specifikt, hur man hämtar data från källsystem som för det mesta är SAP-lösningar?
„HR-metrik“ blev det första projektet där denna fråga behövde lösas. Vårt mål var att skapa en HR-datalager och bygga analytisk rapportering för områden som rör medarbetare. Den primära datakällan är den transaktionssystem SAP HCM, där alla personal-, organisations- och löneåtgärder registreras.
Databearbetning
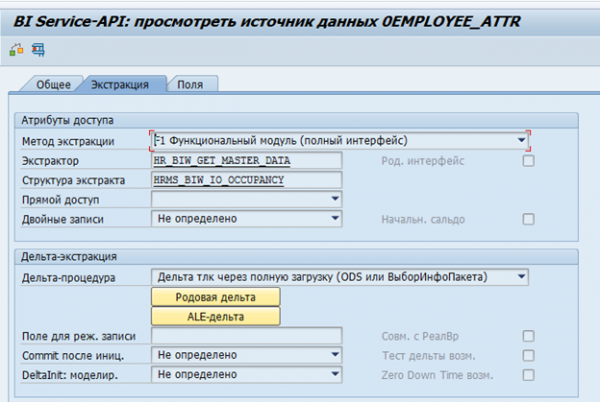
I SAP BW finns det standarddataextraktorer för SAP-system. Dessa extraktorer kan automatiskt samla in nödvändiga data, övervaka deras integritet och bestämma förändringsdelar. Här är till exempel en standarddatakälla för anställdas attribut 0EMPLOYEE_ATTR:
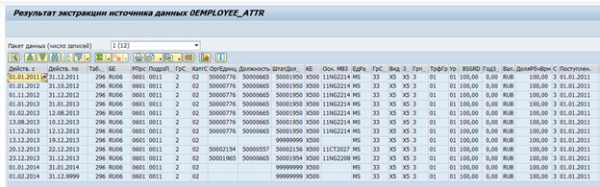
Resultatet av databearbetningen från den för en anställd:
Vid behov kan denna extraktor modifieras enligt egna krav eller så kan en egen extraktor skapas.
Idén om möjligheten att återanvända dem kom först. Tyvärr visade det sig vara en ouppnåelig uppgift. Den största delen av logiken är implementerad på sidan av SAP BW, och det gick inte att smärtfritt separera extraktorn på källan från SAP BW.
Det blev uppenbart att det krävdes utveckling av en egen mekanism för databearbetning från SAP-system.
Databasstruktur för datalagring i SAP HCM
För att förstå kraven på en sådan mekanism är det först nödvändigt att definiera vilka data vi faktiskt behöver.
Majoriteten av datan i SAP HCM lagras i platta SQL-tabeller. Baserat på dessa data visualiserar SAP-applikationer organisationsstrukturer, anställda och annan HR-information för användaren. Så här ser organisationsstrukturen ut i SAP HCM:
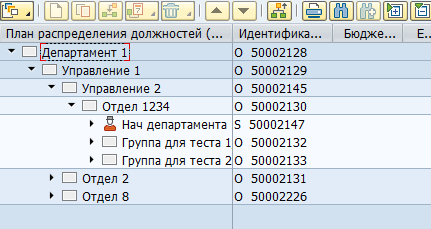
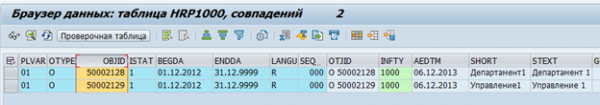
Fysiskt lagras detta träd i två tabeller — i hrp1000 objekt och i hrp1001 relationer mellan dessa objekt.
Objekten "Avdelning 1" och "Ledning 1":
Relationen mellan objekten:
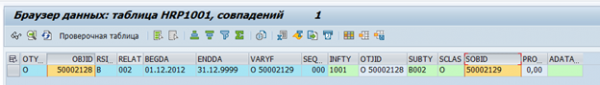
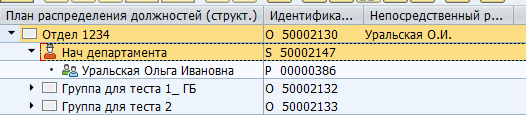
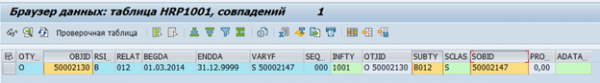
Det kan finnas ett stort antal både objekttyper och relationstyper mellan dem. Det finns både standardrelationer mellan objekt och anpassade för specifika behov. Till exempel anger standardrelationen B012 mellan en organisatorisk enhet och en tjänst chefen för avdelningen.
Visning av chefen i SAP:
Lagring i databasens tabell:
Anställdas data lagras i tabellerna pa*. Till exempel lagras data om personalhändelser för en anställd i tabellen pa0000.
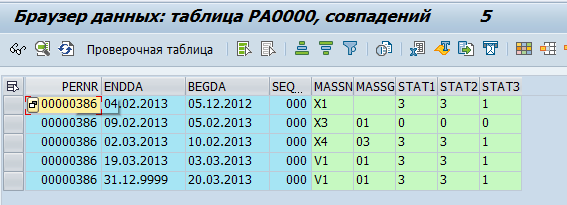
Vi har beslutat att GreenPlum ska hämta "rådata", dvs. bara kopiera dem från SAP-tabeller. Och direkt i GreenPlum kommer de att bearbetas och omvandlas till fysiska objekt (t.ex. Avdelning eller Anställd) och metrik (t.ex. genomsnittlig antal anställda).
Det har identifierats cirka 70 tabeller vars data behöver överföras till GreenPlum. Efter detta började vi arbeta med sättet att överföra dessa data.
SAP erbjuder ett ganska stort antal integrationsmekanismer. Men det enklaste sättet – direkt åtkomst till databasen är förbjudet på grund av licensbegränsningar. Således måste alla integrationsflöden implementeras på nivå servern av applikationer.
Nästa problem var avsaknaden av data om rader som tagits bort i SAP-databasen. Vid borttagning av en rad i databasen tas den bort fysiskt. Det vill säga att det inte var möjligt att bilda en delta av förändringar baserat på tidpunkten för ändringen.
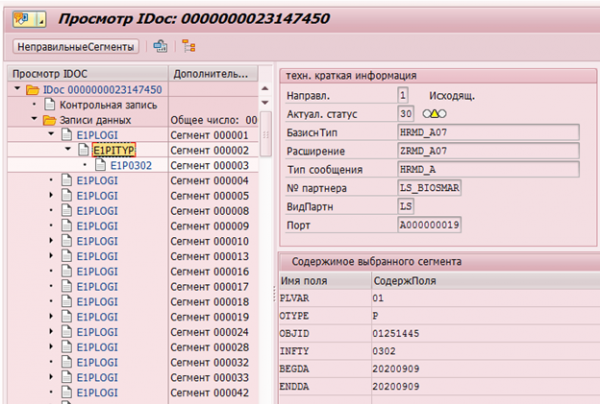
Naturligtvis finns det mekanismer för att registrera ändringar av data i SAP HCM. Till exempel, för efterföljande överföring till mottagarsystem finns förändringspekare (change pointer), som registrerar alla ändringar och baserat på vilka Idoc (objekt för överföring till externa system) skapas.
Exempel på IDoc-ändring av infotyp 0302 för anställd med personnr 1251445:
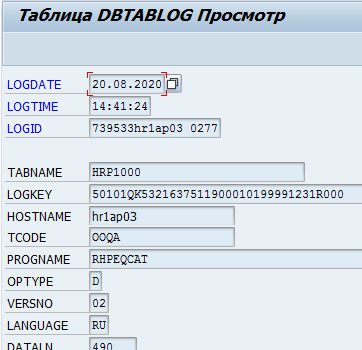
Eller att föra loggar över ändringar av data i tabellen DBTABLOG.
Exempel på logg över borttagning av posten med nyckel QK53216375 från tabellen hrp1000:
Men dessa mekanismer är inte tillgängliga för alla nödvändiga data och deras behandling på applikationsservernivå kan använda ganska mycket resurser. Således kan massaktivering av loggning för alla nödvändiga tabeller leda till märkbar nedgång i systemets prestanda.
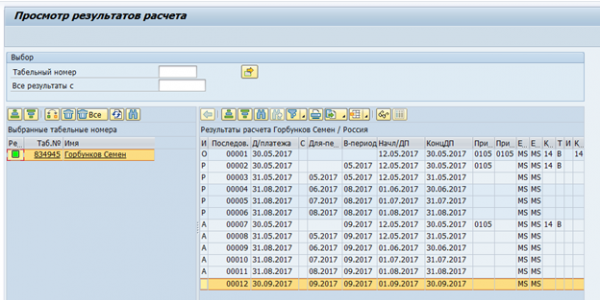
En annan allvarlig fråga var klusterborden. Data för tidsberäkning och löneberäkning i RDBMS-versionen av SAP HCM lagras som en uppsättning logiska tabeller för varje anställd för varje beräkning. Dessa logiska tabeller lagras som binära data i tabellen pcl2.
Löneberäkningskluster:
Data från klusterborden kan inte läsas med en SQL-kommando, utan det krävs användning av SAP HCM makrokommandon eller specialiserade funktionsmoduler. Därmed kommer hastigheten för att läsa sådana tabeller att vara ganska låg. Å andra sidan lagras i sådana kluster data som endast behövs en gång i månaden – slutlig löneberäkning och tidsbedömning. Så hastigheten är i detta fall inte så kritisk.
Vid bedömning av alternativ för att skapa delta av dataändringar beslutade vi även att överväga alternativet med fullständig export. Alternativet att dagligen överföra gigabyte av oförändrad data mellan systemen kan inte se bra ut. Men det har också flera fördelar – ingen nödvändighet för att implementera delta på källsidan samt realisering av inbäddning av detta delta på mottagarsidan. Detta minskar kostnaderna och genomförandetiderna samt ökar pålitligheten i integrationen. Samtidigt bestämdes det att nästan alla ändringar i SAP HR sker inom tre månader före det aktuella datumet. Således fattades beslutet att stanna vid daglig fullständig export av data från SAP HR för N månader före det aktuella datumet och månatlig fullständig export. Parametern N beror på den specifika tabellen
och varierar mellan 1 och 15.
För att extrahera data föreslogs följande schema:
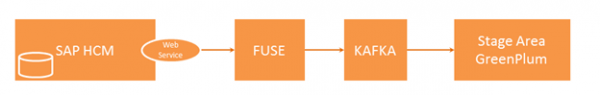
Det externa systemet genererar en begäran och skickar den till SAP HCM, där begäran kontrolleras för datainsamling och behörighet för att få tillgång till tabeller. Om kontrollen är framgångsrik, körs ett program i SAP HCM som samlar de nödvändiga uppgifterna och överför dem till integrationslösningen Fuse. Fuse identifierar nödvändig ämne i Kafka och skickar data dit. Därefter överförs data från Kafka till Stage Area GP.
I denna kedja är vi intresserade av att extrahera data från SAP HCM. Låt oss titta närmare på det.
Interaktionsscheman mellan SAP HCM och FUSE.
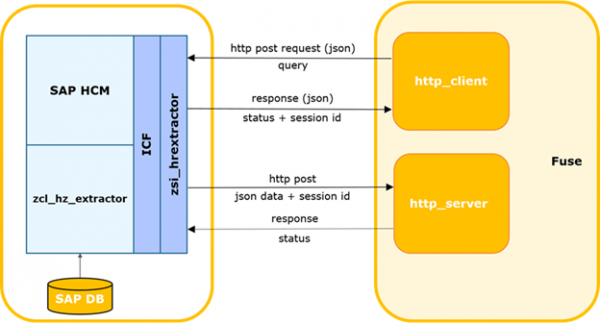
Det externa systemet fastställer tiden för den senaste framgångsrika begäran till SAP.
Processen kan startas av en timer eller annat evenemang; en timeout kan också ställas in för att vänta på ett svar med data från SAP och initiera en ny begäran. Därefter genereras en delta-begäran som skickas till SAP.
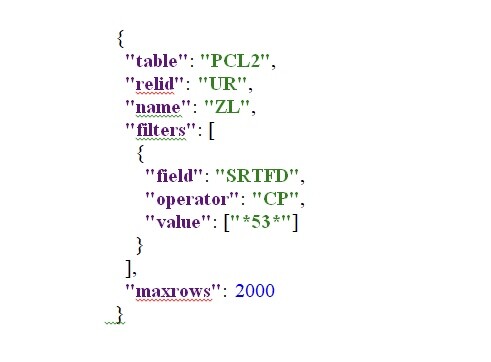
Begärans data överförs i body i json-format.
HTTP-metod: POST.
Exempel på begäran:
SAP-tjänsten genomför kontroll av begäran för fullständighet, överensstämmelse med den aktuella strukturen i SAP och tillgångstillstånd till den begärda tabellen.
Vid fel returnerar tjänsten ett svar med motsvarande kod och beskrivning. Vid en lyckad kontroll skapas en bakgrundsprocess för urvalet, vilket genererar och synkront returnerar ett unikt sessions-id.
Det externa systemet registrerar vid fel, om något, i loggen. Vid en framgångsrik respons överförs sessions-id:t och namnet på tabellen som begäran gjordes på.
Det externa systemet registrerar den aktuella sessionen som öppen. Om andra sessioner finns för denna tabell stängs de med en registrering av en varning i loggen.
SAP:s bakgrundsjobb skapar en cursor enligt angivna parametrar och ett datapaketeringsstorlek. Paketstorleken är det maximala antalet poster som processen läser från databasen. Standard är satt till 2000. Om det finns fler poster i databasen än den använda paketstorleken, skapas nästa block med motsvarande offset och ett inkrementerat paketnummer efter att det första paketet har överförts. Numren ökar med 1 och skickas i strikt följd.
Därefter överför SAP paketet till ingången för webbtjänsten i det externa systemet. Det externa systemet utför kontroller av det inkommande paketet. Det måste finnas en registrerad session i systemet med det angivna id:t som måste befinna sig i öppet status. Om paketnumret är > 1 måste det finnas en registrerad framgångsrik mottagning av det föregående paketet (package_id-1).
Vid framgångsrik kontroll parsar och sparar det externa systemet data från tabellen.
Dessutom, om paketet innehåller flaggan final och serialiseringen har genomförts framgångsrikt, skickas en avisering till integrationsmodulen om att sessionens behandling har avslutats framgångsrikt, och modulen uppdaterar sessionens status.
Vid fel i kontroller/parsing loggas felet och paketen för den aktuella sessionen kommer att avslås av det externa systemet.
Detsamma gäller för motsatta fall, när det externa systemet returnerar ett fel, loggas det och överföringen av paketen avbryts.
För att begära data från SAP HCM har en integrationsservice implementerats. Tjänsten är implementerad på ICF-ramverket (SAP Internet Communication Framework - ). Den möjliggör att begära data från SAP HCM-systemet enligt vissa tabeller. Vid skapandet av dataförfrågan finns det möjlighet att ange specifika fält och filtreringsparametrar för att få de nödvändiga uppgifterna. Implementeringen av tjänsten förutsätter ingen affärslogik. Algoritmer för beräkning av delta, förfrågningsparametrar, integritetskontroll med mera implementeras också på den externa systemets sida.
Denna mekanism gör det möjligt att samla in och överföra alla nödvändiga data på några timmar. Denna hastighet ligger på gränsen till acceptabel, därför betraktas denna lösning av oss som tillfällig, vilket har tillåtit oss att tillfredsställa behovet av ett extraktionsverktyg i projektet.
I den målinriktade bilden för att lösa uppgiften med databasextraktion övervägs alternativ med CDC-system som Oracle Golden Gate eller ETL-verktyg som SAP DS.
Källa: habr.com
