

Inledning
God dag. I över ett halvår har vi haft ett skript (eller snarare en uppsättning skript) som genererar rapporter om statusen för virtuella maskiner (och mer därtill). Jag har beslutat att dela med mig av min erfarenhet av att skapa och själva koden. Jag ser fram emot kritik och hoppas att detta material kan vara till nytta för någon.
Behovets bildande
Vi har många virtuella maskiner (ungefär 1500 VM spridda över 3 vCenter). Nya skapas och gamla tas bort ganska ofta. För att upprätthålla ordningen lade vi till flera anpassade fält i vCenter för att åtskilja VM i subsystem, ange om de är testmaskiner samt vem och när de skapades. Den mänskliga faktorn ledde till att mer än hälften av maskinerna förblev med ofullständiga fält, vilket försvårade arbetet. Var sjätte månad blev någon frustrerad och påbörjade arbetet med att uppdatera dessa uppgifter, men resultatet blev irrelevant redan efter ett par veckor.
Jag vill klargöra att alla förstår att det måste finnas ansökningar för skapande av maskiner, processen för deras skapande, osv. osv. Och att alla följer denna process strikt och allt är i ordning. Tyvärr är det inte så hos oss, men det är inte ämnet för artikeln 🙂
Sammanfattningsvis togs beslutet att automatisera kontrollen av korrekt ifyllande av fälten.
Vi beslutade att ett dagligt mejl med en lista över felaktigt ifyllda maskiner till alla ansvariga ingenjörer och deras chefer skulle vara en bra början.
Vid den här tidpunkten hade en av kollegorna redan implementerat ett PowerShell-skript som dagligen enligt ett schema samlade information om alla maskiner i alla vCenter och skapade 3 csv-dokument (varje för sitt vCenter) som lades på en gemensam enhet. Det beslutades att använda detta skript som grund och komplettera med kontroller med hjälp av R-språket, för vilket det fanns viss erfarenhet.
Under processen av vidareutveckling växte lösningen till att inkludera meddelanden via e-post, en databas med huvudsaklig och historisk tabell (mer om detta senare), samt analys av vSphere-loggar för att hitta de faktiska skaparna av VM och tidpunkten för deras skapande.
För utveckling användes IDE RStudio Desktop och PowerShell ISE.
Skriptet körs från en vanlig Windows virtuell maskin.
Beskrivning av den övergripande logiken.
Den övergripande logiken i skripten blev följande.
- Vi samlar in data om virtuella maskiner med hjälp av ett PowerShell-skript som vi kallar genom R, och resultatet sammanfogas i en csv. Omvänd interaktion mellan språken görs på liknande sätt. (Det hade varit möjligt att skicka data direkt från R till PowerShell som variabler, men det är komplicerat, och med mellanliggande csv-filer är det lättare att debugga och dela med någon mellanliggande resultat).
- Med R formar vi giltiga parametrar för fält vars värden vi kontrollerar. — Vi skapar ett Word-dokument som kommer att innehålla värdena för dessa fält för att klistra in i ett informationsbrev, som kommer att vara svaret på kollegors frågor "Nåväl, hur ska jag fylla i detta?".
- Vi laddar upp data om alla VM från csv med hjälp av R, formar ett dataframe, tar bort onödiga fält och skapar ett informations-xlsx-dokument som kommer att innehålla sammanställning av information om alla VM, som vi lägger ut på en gemensam resurs.
- Till dataframe för alla VM tillämpar vi alla kontroller av korrekt ifyllande av fält och skapar en tabell som endast innehåller VM med felaktigt ifyllda fält (och endast dessa fält).
- Den erhållna listan över VM skickas till ett annat PowerShell-skript som kommer att titta på vCenter-loggarna för händelser relaterade till skapande av VM, vilket gör det möjligt att ange avsedd tid för skapande av VM och avsedd skapare. Detta är i fall ingen vill erkänna vems maskin det är. Detta skript är inte snabbt, särskilt om det finns många loggar, så vi tittar bara på de senaste 2 veckorna, och använder även ett arbetsflöde som gör det möjligt att söka information om flera VM samtidigt. Skriptet innehåller detaljerade kommentarer angående denna mekanism. Resultatet sparar vi i en csv som vi återigen laddar upp i R.
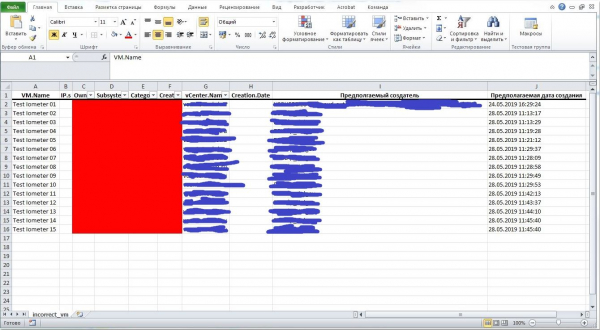
- Vi formar ett vackert formaterat xlsx-dokument där felaktigt ifyllda fält kommer att markeras med röd färg, filtreringar kommer att tillämpas på vissa kolumner, och det kommer också att anges ytterligare kolumner som innehåller avsedda skapare och tid för skapande av VM.
- Vi formar ett e-postmeddelande där vi bifogar ett dokument som beskriver tillåtna värden för fälten samt en tabell med felaktigt ifyllda virtuella maskiner (VM). I texten anger vi det totala antalet felaktigt skapade VMer, en länk till en gemensam resurs och en motiverande bild. Om det inte finns några felaktigt ifyllda VMer skickar vi ett annat meddelande med en gladare motiverande bild.
- Vi registrerar data om alla VMer i SQL Server-databasen med hänsyn till den inbyggda mekanismen för historiska tabeller (en mycket intressant mekanism — om vilken vi kommer att berätta mer senare)
Själva skripten
Huvudfilen med kod på R
# Путь к рабочей директории (нужно для корректной работы через виндовый планировщик заданий)
setwd("C:ScriptsgetVm")
#### Подгружаем необходимые пакеты ####
library(tidyverse)
library(xlsx)
library(mailR)
library(rmarkdown)
##### Определяем пути к исходным файлам и другие переменные #####
source(file = "const.R", local = T, encoding = "utf-8")
# Проверяем существование файла со всеми ВМ и удаляем, если есть.
if (file.exists(filenameVmCreationRules)) {file.remove(filenameVmCreationRules)}
#### Создаём вордовский документ с допустимыми полями
render("VM_name_rules.Rmd",
output_format = word_document(),
output_file = filenameVmCreationRules)
# Проверяем существование файла со всеми ВМ и удаляем, если есть
if (file.exists(allVmXlsxPath)) {file.remove(allVmXlsxPath)}
#### Забираем данные по всем машинам через PowerShell скрипт. На выходе получим csv.
system(paste0("powershell -File ", getVmPsPath))
# Полный df
fullXslx_df <- allVmXlsxPath %>%
read.csv2(stringsAsFactors = FALSE)
# Kontrollerar korrektheten av ifyllda fält
full_df <- fullXslx_df %>%
mutate(
# Först tar vi bort alla onödiga mellanslag och tabb, sedan tar vi hänsyn till kommatecken som avskiljare, och sedan kontrollerar vi om de finns i tillåtna värden,
isSubsystemCorrect = Subsystem %>%
gsub("[[:space:]]", "", .) %>%
str_split(., ",") %>%
map(function(x) (all(x %in% AllowedValues$Subsystem))) %>%
as.logical(),
isOwnerCorrect = Owner %in% AllowedValues$Owner,
isCategoryCorrect = Category %in% AllowedValues$Category,
isCreatorCorrect = (!is.na(Creator) & Creator != ''),
isCreation.DateCorrect = map(Creation.Date, IsDate)
)
# Kontrollerar om filen med alla VM finns och tar bort den om den gör det.
if (file.exists(filenameAll)) {file.remove(filenameAll)}
#### Skapar xslx-fil med rapport ####
# Allmän information på ett separat blad
full_df %>% write.xlsx(file=filenameAll,
sheetName=names[1],
col.names=TRUE,
row.names=FALSE,
append=FALSE)
#### Skapar xslx-fil med felaktigt ifyllda fält ####
# Skapar df
incorrect_df <- full_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Creator,
Category,
Creation.Date,
isOwnerCorrect,
isSubsystemCorrect,
isCategoryCorrect,
isCreatorCorrect,
vCenter.Name) %>%
filter(isSubsystemCorrect == F |
isOwnerCorrect == F |
isCategoryCorrect == F |
isCreatorCorrect == F)
# Kontrollerar om filen med alla VM finns och tar bort den om den gör det.
if (file.exists(filenameIncVM)) {file.remove(filenameIncVM)}
# Sparar lista över VM med ofullständiga fält i csv
incorrect_df %>%
select(VM.Name) %>%
write_csv2(path = filenameIncVM, append = FALSE)
# Filtrerar för att sätta in i e-post
incorrect_df_filtered <- incorrect_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
)
# Räknar antalet rader
numberOfRows <- nrow(incorrect_df)
#### Начало условия ####
# Дальше либо у нас есть неправильно заполненные поля, либо нет.
# Если есть - запускаем ещё один скрипт
if (numberOfRows > 0) {
# Kontrollerar om filen med skapare finns och tar bort den om den gör det.
if (file.exists(creatorsFilePath)) {file.remove(creatorsFilePath)}
# Kör ett PowerShell-skript som kommer att hitta skaparna av de hittade VM. Utdata blir en csv.
system(paste0("powershell -File ", getCreatorsPath))
# Läser filen med skapare
creators_df <- creatorsFilePath %>%
read.csv2(stringsAsFactors = FALSE)
# Filtrerar för att sätta in i e-post, lägger till uppgifter från tabellen med skapare
incorrect_df_filtered <- incorrect_df_filtered %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
) %>%
left_join(creators_df, by = "VM.Name") %>%
rename(`Antagen skapare` = CreatedBy,
`Antagen skapelsedatum` = CreatedOn)
# Skapar meddelandet för e-post
emailBody <- paste0(
'<html>
<h3>God dag, kära kollegor.</h3>
<p>Den fullständiga aktuella informationen om virtuella maskiner kan ses på disk H: här:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Dessutom bifogas en lista över VM med <strong>inkorrekt ifyllda</strong> fält. Totalt antal: <strong>', numberOfRows,'</strong>.</p>
<p>Två ytterligare kolumner har lagts till i tabellen. <strong>Antagen skapare</strong> och <strong>Antagen skapelsedatum</strong>, som hämtas från vCenter-loggarna under de senaste två veckorna</p>
<p>Vi ber skaparna av maskinerna att bekräfta uppgifterna och fylla i fälten korrekt. Regler för ifyllnad av fält finns också i bifogad fil.</p>
<p><img src="data/meme.jpg"></p>
</html>'
)
# Kontrollerar om filen finns
if (file.exists(filenameIncorrect)) {file.remove(filenameIncorrect)}
# Skapar en snygg tabell med format och liknande
source(file = "email.R", local = T, encoding = "utf-8")
#### Skapar ett meddelande om maskiner med dåligt ifyllda fält ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "VM med inkorrekt ifyllda fält",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
attach.files = c(filenameIncorrect, filenameVmCreationRules),
debug = FALSE)
#### Här följer blocket om det inte är några problem med VM ####
} else {
# Skapar meddelandets innehåll
emailBody <- paste0(
'<html>
<h3>God dag, kära kollegor</h3>
<p>Den fullständiga aktuella informationen om virtuella maskiner kan ses på disk H: här:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>För närvarande är alla fält för VM korrekt ifyllda</p>
<p><img src="data/meme_correct.jpg"></p>
</html>'
)
#### Skapar ett meddelande utan dåligt ifyllda VM ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "Sammanfattande information",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
debug = FALSE)
}
####### Sparar data i DB #####
source(file = "DB.R", local = T, encoding = "utf-8")
Skript för att hämta listan över VMer i PowerShell
# Данные для подключения и другие переменные
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"

$filename = "C:ScriptsgetVmdataallvmall-vm-$(get-date -f yyyy-MM-dd).csv"

$destinationSMB = "server.rumyfolder$vm"
$IP0=""
$IP1=""
$IP2=""
$IP3=""
$IP4=""
$IP5=""

# Подключение ко всем vCenter, что содержатся в переменной. Будет работать, если логин и пароль одинаковые (например, доменные)
Connect-VIServer -Server $vCenterNames -User $vCenterUsername -Password $vCenterPassword

write-host ""

# Создаём функцию с циклом по всем vCenter-ам
function Get-VMinventory {

# В этой переменной будет списко всех ВМ, как объектов
$AllVM = Get-VM | Sort Name
$cnt = $AllVM.Count
$count = 1

# Начинаем цикл по всем ВМ и собираем необходимые параметры каждого объекта
   foreach ($vm in $AllVM) {
   $StartTime = $(get-date)

     $IP0 = $vm.Guest.IPAddress[0]
     $IP1 = $vm.Guest.IPAddress[1]
     $IP2 = $vm.Guest.IPAddress[2]
     $IP3 = $vm.Guest.IPAddress[3]
     $IP4 = $vm.Guest.IPAddress[4]
     $IP5 = $vm.Guest.IPAddress[5]

     If ($IP0 -ne $null) {If ($IP0.Contains(":") -ne 0) {$IP0=""}}
     If ($IP1 -ne $null) {If ($IP1.Contains(":") -ne 0) {$IP1=""}}
     If ($IP2 -ne $null) {If ($IP2.Contains(":") -ne 0) {$IP2=""}}
     If ($IP3 -ne $null) {If ($IP3.Contains(":") -ne 0) {$IP3=""}}
     If ($IP4 -ne $null) {If ($IP4.Contains(":") -ne 0) {$IP4=""}}
     If ($IP5 -ne $null) {If ($IP5.Contains(":") -ne 0) {$IP5=""}}

     $cluster = $vm | Get-Cluster | Select-Object -ExpandProperty name
     $Bootime = $vm.ExtensionData.Runtime.BootTime
     $TotalHDDs = $vm.ProvisionedSpaceGB -as [int]
     $CreationDate = $vm.CustomFields.Item("CreationDate") -as [string]
     $Creator = $vm.CustomFields.Item("Creator") -as [string]
     $Category = $vm.CustomFields.Item("Category") -as [string]
     $Owner = $vm.CustomFields.Item("Owner") -as [string]
     $Subsystem = $vm.CustomFields.Item("Subsystem") -as [string]

     $IPS = $vm.CustomFields.Item("IP") -as [string]

     $vCPU = $vm.NumCpu
     $CorePerSocket = $vm.ExtensionData.config.hardware.NumCoresPerSocket
     $Sockets = $vCPU/$CorePerSocket

     $Id = $vm.Id.Split('-')[2] -as [int]

     # Собираем все параметры в один объект
     $Vmresult = New-Object PSObject
     $Vmresult | add-member -MemberType NoteProperty -Name "Id" -Value $Id
     $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
     $Vmresult | add-member -MemberType NoteProperty -Name "Cluster" -Value $cluster
     $Vmresult | add-member -MemberType NoteProperty -Name "Esxi Host" -Value $VM.VMHost
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 1" -Value $IP0
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 2" -Value $IP1
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 3" -Value $IP2
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 4" -Value $IP3
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 5" -Value $IP4
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 6" -Value $IP5
     $Vmresult | add-member -MemberType NoteProperty -Name "vCPU" -Value $vCPU
     $Vmresult | Add-Member -MemberType NoteProperty -Name "CPU Sockets" -Value $Sockets
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Core per Socket" -Value $CorePerSocket
     $Vmresult | add-member -MemberType NoteProperty -Name "RAM (GB)" -Value $vm.MemoryGB
     $Vmresult | add-member -MemberType NoteProperty -Name "Total-HDD (GB)" -Value $TotalHDDs
     $Vmresult | add-member -MemberType NoteProperty -Name "Power State" -Value $vm.PowerState
     $Vmresult | add-member -MemberType NoteProperty -Name "OS" -Value $VM.ExtensionData.summary.config.guestfullname
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Boot Time" -Value $Bootime
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Status" -Value $vm.ExtensionData.Guest.ToolsStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version" -Value $vm.ExtensionData.Guest.ToolsVersion
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version Status" -Value $vm.ExtensionData.Guest.ToolsVersionStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Running Status" -Value $vm.ExtensionData.Guest.ToolsRunningStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "Creation Date" -Value $CreationDate
     $Vmresult | add-member -MemberType NoteProperty -Name "Creator" -Value $Creator
     $Vmresult | add-member -MemberType NoteProperty -Name "Category" -Value $Category
     $Vmresult | add-member -MemberType NoteProperty -Name "Owner" -Value $Owner
     $Vmresult | add-member -MemberType NoteProperty -Name "Subsystem" -Value $Subsystem
     $Vmresult | add-member -MemberType NoteProperty -Name "IP's" -Value $IPS
     $Vmresult | add-member -MemberType NoteProperty -Name "vCenter Name" -Value $vm.Uid.Split('@')[1].Split(':')[0]

# Считаем общее и оставшееся время выполнения и выводим на экран результаты. Использовалось для тестирования, но по факту оказалось очень удобно.
     $elapsedTime = $(get-date) - $StartTime
     $totalTime = "{0:HH:mm:ss}" -f ([datetime]($elapsedTime.Ticks*($cnt - $count)))

     clear-host
     Write-Host "Processing" $count "from" $cnt
     Write-host "Progress:" ([math]::Round($count/$cnt*100, 2)) "%"
     Write-host "You have about " $totalTime "for cofee"
     Write-host ""

     $count++

# Выводим результат, чтобы цикл "знал" что является результатом выполнения одного прохода
     $Vmresult
   }

}

# Вызываем получившуюся функцию и сразу выгружаем результат в csv
$allVm = Get-VMinventory | Export-CSV -Path $filename -NoTypeInformation -UseCulture -Force

# Пытаемся выложить полученный файл в нужное нам место и, в случае ошибки, пишем лог.
try
    {
        Copy-Item $filename -Destination $destinationSMB -Force -ErrorAction SilentlyContinue
    }
catch
    {
        $error | Export-CSV -Path $filename".error" -NoTypeInformation -UseCulture -Force
    }
Skript på PowerShell som extraherar skaparna av de virtuella maskinerna och datumen då de skapades från loggar
# Путь к файлу, из которого будем доставать список VM
$VMfilePath = "C:ScriptsgetVmcreators_VMcreators_VM_$(get-date -f yyyy-MM-dd).csv"
# Путь к файлу, в который будем записывать результат
$filePath = "C:ScriptsgetVmdatacreatorscreators-$(get-date -f yyyy-MM-dd).csv"

# Создаём вокрфлоу
Workflow GetCreators-Wf
{
    # Параметры, которые можно будет передать при вызове скрипта
    param([string[]]$VMfilePath)

# Параметры, которые доступны только внутри workflow
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"
$daysToLook = 14
$start = (get-date).AddDays(-$daysToLook)
$finish = get-date
# Значения, которые будут вписаны в csv для машин, по которым не будет ничего найдено
$UnknownUser = "UNKNOWN"
$UnknownCreatedTime = "0000-00-00"

# Определяем параметры подключения и выводной файл, которые будут доступны во всём скрипте.
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )

# Получаем список VM из csv и загружаем соответствующие объекты
$list = Import-Csv $VMfilePath -UseCulture | select -ExpandProperty VM.Name

# Цикл, который будет выполняться параллельно (по 5 машин за раз)
foreach -parallel ($row in $list)
  {
    # Это скрипт, который видит только свои переменные и те, которые ему переданы через $Using
    InlineScript {

    # Время начала выполнения отдельного блока
        $StartTime = $(get-date)

        Write-Host ""
        Write-Host "Processing $Using:row started at $StartTime"
        Write-Host ""

        # Подключение оборачиваем в переменную, чтобы информация о нём не мешалась в консоли
        $con = Connect-VIServer -Server $Using:vCenterNames -User $Using:vCenterUsername -Password $Using:vCenterPassword

        # Получаем объект vm
        $vm = Get-VM -Name $Using:row

      # Ниже 2 одинаковые команды. Одна с фильтром по времени, вторая - без. Можно пользоваться тем,
      $Event = $vm | Get-VIEvent -Start $Using:start -Finish $Using:finish -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}
      # $Event = $vm | Get-VIEvent -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}

      # Заполняем параметры в зависимости от того, удалось ли в логах найти что-то
      If (($Event | Measure-Object).Count -eq 0){
         $User = $Using:UnknownUser
         $Created = $Using:UnknownCreatedTime
         $CreatedFormat = $Using:UnknownCreatedTime
      } Else {
         If ($Event.Username -eq "" -or $Event.Username -eq $null) {
            $User = $Using:UnknownUser
         } Else {
         $User = $Event.Username
         } # Else
            $CreatedFormat = $Event.CreatedTime
            # Один из коллег отдельно просил, чтобы время было в таком формате, поэтому дублируем его. А в БД пойдёт нормальный формат.
            $Created = $Event.CreatedTime.ToString('yyyy-MM-dd')
         } # Else

      Write-Host "Creator for $vm is $User. Creating object."

      # Создаём объект. Добавляем параметры.
      $Vmresult = New-Object PSObject
      $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedBy" -Value $User
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOn" -Value $CreatedFormat
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOnFormat" -Value $Created
      # Выводим результаты
      $Vmresult

    } # Inline

} # ForEach

}

$Creators = GetCreators-Wf $VMfilePath
# Записываем результат в файл
$Creators | select 'VM Name', CreatedBy, CreatedOn | Export-Csv -Path $filePath -NoTypeInformation -UseCulture -Force

Write-Host "CSV generetion finisghed at $(get-date). PROFIT"
Biblioteket förtjänar särskild uppmärksamhet , vilket gjorde det möjligt att få bilagan i e-postmeddelandet att vara snyggt formaterad (som ledningen gillar) istället för bara en csv-tabell.
Att skapa ett vackert xlsx-dokument med listan över felaktigt ifyllda maskiner
# Создаём новую книгу
# Возможные значения : "xls" и "xlsx"
wb<-createWorkbook(type="xlsx")

# Стили для имён рядов и колонок в таблицах
TABLE_ROWNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE)
TABLE_COLNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE) +
  Alignment(wrapText=TRUE, horizontal="ALIGN_CENTER") +
  Border(color="black", position=c("TOP", "BOTTOM"),
         pen=c("BORDER_THIN", "BORDER_THICK"))

# Создаём новый лист
sheet <- createSheet(wb, sheetName = names[2])

# Добавляем таблицу
addDataFrame(incorrect_df_filtered,
             sheet, startRow=1, startColumn=1,  row.names=FALSE, byrow=FALSE,
             colnamesStyle = TABLE_COLNAMES_STYLE,
             rownamesStyle = TABLE_ROWNAMES_STYLE)

# Меняем ширину, чтобы форматирование было автоматическим
autoSizeColumn(sheet = sheet, colIndex=c(1:ncol(incorrect_df)))

# Добавляем фильтры
addAutoFilter(sheet, cellRange = "C1:G1")

# Определяем стиль
fo2 <- Fill(foregroundColor="red")
cs2 <- CellStyle(wb,
                 fill = fo2,
                 dataFormat = DataFormat("@"))

# Находим ряды с неверно заполненным полем Владельца и применяем к ним определённый стиль
rowsOwner <- getRows(sheet, rowIndex = (which(!incorrect_df$isOwnerCorrect) + 1))
cellsOwner <- getCells(rowsOwner, colIndex = which( colnames(incorrect_df_filtered) == "Owner" ))
lapply(names(cellsOwner), function(x) setCellStyle(cellsOwner[[x]], cs2))

# Находим ряды с неверно заполненным полем Подсистемы и применяем к ним определённый стиль
rowsSubsystem <- getRows(sheet, rowIndex = (which(!incorrect_df$isSubsystemCorrect) + 1))
cellsSubsystem <- getCells(rowsSubsystem, colIndex = which( colnames(incorrect_df_filtered) == "Subsystem" ))
lapply(names(cellsSubsystem), function(x) setCellStyle(cellsSubsystem[[x]], cs2))

# Аналогично по Категории
rowsCategory <- getRows(sheet, rowIndex = (which(!incorrect_df$isCategoryCorrect) + 1))
cellsCategory <- getCells(rowsCategory, colIndex = which( colnames(incorrect_df_filtered) == "Category" ))
lapply(names(cellsCategory), function(x) setCellStyle(cellsCategory[[x]], cs2))

# Создатель
rowsCreator <- getRows(sheet, rowIndex = (which(!incorrect_df$isCreatorCorrect) + 1))
cellsCreator <- getCells(rowsCreator, colIndex = which( colnames(incorrect_df_filtered) == "Creator" ))
lapply(names(cellsCreator), function(x) setCellStyle(cellsCreator[[x]], cs2))

# Сохраняем файл
saveWorkbook(wb, filenameIncorrect)
Resultatet ser ungefär ut så här:
Det fanns också en intressant detalj kring inställningen av Windows-schemaläggaren. Det gick inte att hitta de rätta parameterna för behörigheter och inställningar så att allt kördes som det skulle. Till slut hittades ett R-bibliotek som själv skapar en uppgift för att köra R-skriptet och inte glömmer bort loggfilen. Sedan kan man manuellt justera uppgiften.
En bit kod på R med två exempel som skapar en uppgift i Windows-schemaläggaren
library(taskscheduleR)
myscript <- file.path(getwd(), "all_vm.R")

## kör skriptet om 62 sekunder
taskscheduler_create(taskname = "getAllVm", rscript = myscript,
                     schedule = "ONCE", starttime = format(Sys.time() + 62, "%H:%M"))

## kör skriptet varje dag kl 09:10
taskscheduler_create(taskname = "getAllVmDaily", rscript = myscript,
                     schedule = "WEEKLY",
                     days = c("MON", "TUE", "WED", "THU", "FRI"),
                     starttime = "02:00")

## tar bort uppgifter
taskscheduler_delete(taskname = "getAllVm")
taskscheduler_delete(taskname = "getAllVmDaily")

# Titta på loggarna (de sista 4 raderna)
tail(readLines("all_vm.log"), sep ="n", n = 4)
Speciellt om databasen
Efter att skriptet hade konfigurerats började andra frågor dyka upp. Till exempel ville man hitta datumet när VM:en togs bort, men loggarna i vCenter var redan raderade. Eftersom skriptet lägger filer i en mapp varje dag och inte rensar (vi städar manuellt när vi kommer ihåg), kan man titta på gamla filer och hitta den första fil där den aktuella VM:en inte finns. Men detta är inte så bra.
Jag ville skapa en historisk databas.
Hjälpen kom från funktionaliteten i MS SQL SERVER - system-versionerade temporära tabeller. Det översätts vanligtvis som tidsstämplade (inte tidsmässiga) tabeller.
Man kan läsa mer detaljerat i .
Kort sagt - vi skapar en tabell, säger att den ska vara versionshanterad och SQL Server skapar två ytterligare datetime-kolumner i denna tabell (datum för registreringens skapelse och datum för registreringens livslängd) samt en extra tabell där ändringar kommer att skrivas. Som resultat får vi aktuell information och, genom enkla SQL-frågor, vars exempel ges i dokumentationen, kan vi se antingen livscykeln för en specifik virtuell maskin eller statusen för alla VM vid en given tidpunkt.
Ur prestandasynpunkt - transaktionen för registrering i huvudtabellen avslutas inte förrän transaktionen för registrering i den temporära tabellen är avslutad. D.v.s. för tabeller med många skrivoperationer bör denna funktionalitet implementeras med försiktighet, men i vårt fall är det något som verkligen är coolt.
För att mekanismen skulle fungera korrekt var jag tvungen att skriva ett litet kodstycke i R som jämförde den nya tabellen med data för alla VM mot den som lagras i databasen och endast registrerade de förändrade raderna. Koden är inte särskilt komplicerad, den använder biblioteket compareDF, men jag kommer också att ge den nedan.
Kod i R för att skriva data till databasen
# Подцепляем пакеты
library(odbc)
library(compareDF)

# Формируем коннект
con <- dbConnect(odbc(),
                 Driver = "ODBC Driver 13 for SQL Server",
                 Server = DBParams$server,
                 Database = DBParams$database,
                 UID = DBParams$UID,
                 PWD = DBParams$PWD,
                 Port = 1433)

#### Проверяем есть ли таблица. Если нет - создаём. ####

if (!dbExistsTable(con, DBParams$TblName)) {
  #### Создаём таблицу ####
  create <- dbSendStatement(
    con,
    paste0(
      'CREATE TABLE ',
      DBParams$TblName,
      '(
    [Id] [int] NOT NULL PRIMARY KEY CLUSTERED,
    [VM.Name] [varchar](255) NULL,
    [Cluster] [varchar](255) NULL,
    [Esxi.Host] [varchar](255) NULL,
    [IP.Address.1] [varchar](255) NULL,
    [IP.Address.2] [varchar](255) NULL,
    [IP.Address.3] [varchar](255) NULL,
    [IP.Address.4] [varchar](255) NULL,
    [IP.Address.5] [varchar](255) NULL,
    [IP.Address.6] [varchar](255) NULL,
    [vCPU] [int] NULL,
    [CPU.Sockets] [int] NULL,
    [Core.per.Socket] [int] NULL,
    [RAM..GB.] [int] NULL,
    [Total.HDD..GB.] [int] NULL,
    [Power.State] [varchar](255) NULL,
    [OS] [varchar](255) NULL,
    [Boot.Time] [varchar](255) NULL,
    [VMTools.Status] [varchar](255) NULL,
    [VMTools.Version] [int] NULL,
    [VMTools.Version.Status] [varchar](255) NULL,
    [VMTools.Running.Status] [varchar](255) NULL,
    [Creation.Date] [varchar](255) NULL,
    [Creator] [varchar](255) NULL,
    [Category] [varchar](255) NULL,
    [Owner] [varchar](255) NULL,
    [Subsystem] [varchar](255) NULL,
    [IP.s] [varchar](255) NULL,
    [vCenter.Name] [varchar](255) NULL,
    DateFrom datetime2 GENERATED ALWAYS AS ROW START NOT NULL,
    DateTo datetime2 GENERATED ALWAYS AS ROW END NOT NULL,
    PERIOD FOR SYSTEM_TIME (DateFrom, DateTo)
        ) ON [PRIMARY]
        WITH (SYSTEM_VERSIONING = ON (HISTORY_TABLE = ', DBParams$TblHistName,'));'
    )
  )

  # Отправляем подготовленный запрос
  dbClearResult(create)

} # if

#### Начало работы с таблицей ####

# Обозначаем таблицу, с которой будем работать
allVM_db_con <- tbl(con, DBParams$TblName)

#### Сравниваем таблицы ####

# Собираем данные с таблицы (убираем служебные временные поля)
allVM_db <- allVM_db_con %>%
  select(c(-"DateTo", -"DateFrom")) %>%
  collect()

# Создаём таблицу со сравнением объектов. Сравниваем по Id
# Удалённые объекты там будут помечены через -, созданные через +, изменённые через - и +
ctable_VM <- fullXslx_df %>%
  compare_df(allVM_db,
             c("Id"))

#### Удаление строк ####

# Выдираем Id виртуалок, записи о которых надо удалить
remove_Id <- ctable_VM$comparison_df %>%
  filter(chng_type == "-") %>%
  select(Id)

# Проверяем, что есть записи (если записей нет - и удалять ничего не нужно)
if (remove_Id %>% nrow() > 0) {

  # Конструируем шаблон для запроса на удаление данных
  delete <- dbSendStatement(con,
                        paste0('
                               DELETE
                               FROM ',
                               DBParams$TblName,
                               ' WHERE "Id"=?
                               ') # paste
                        ) # send

  # Создаём запрос на удаление данных
  dbBind(delete, remove_Id)

  # Отправляем подготовленный запрос
  dbClearResult(delete)

} # if

#### Добавление строк ####

# Выделяем таблицу, содержащую строки, которые нужно добавить.
allVM_add <- ctable_VM$comparison_df %>%
  filter(chng_type == "+") %>%
  select(-chng_type)

# Проверяем, есть ли строки, которые нужно добавить и добавляем (если нет - не добавляем)
if (allVM_add %>% nrow() > 0) {
  # Пишем таблицу со всеми необходимыми данными
  dbWriteTable(con,
               DBParams$TblName,
               allVM_add,
               overwrite = FALSE,
               append = TRUE)

} # if

#### Не забываем сделать дисконнект ####
dbDisconnect(con)
Sammanfattningsvis
Som ett resultat av att skriptet implementerades, har ordning upprättats och bibehållits under flera månader. Ibland dyker felaktigt ifyllda VM upp, men skriptet fungerar som en bra påminnelse och sällan hamnar en VM på listan två dagar i rad.
Det har också skapats en grund för analys av historiska data.
Det är uppenbart att mycket av detta kan genomföras med specialiserad programvara istället för "på egen hand", men uppgiften var intressant och kan sägas vara fakultativ.
R har än en gång visat sig vara ett utmärkt universellt språk som inte bara passar för att lösa statistiska problem utan också fungerar som en utmärkt "bro" mellan andra datakällor.
Källa: habr.com
