

På sommaren minskar traditionellt både köpbeteendet och intensiteten i förändringar av infrastruktur för webbprojekt, säger Kapten Upplysning. För att även IT-proffs går på semester då och då. Och CTO:n också. Det gör det svårare för dem som stannar kvar på posten, men det är inte poängen nu: kanske är det just därför sommaren är den bästa tiden för att i lugn och ro överväga den befintliga reservplanen och skapa en plan för dess förbättring. Och i detta kan erfarenheten från Egor Andreev vara till nytta från , som han berättade om på konferensen .
När vi bygger reservanläggningar och hanterar reservtagning finns det flera fällor som man kan hamna i. Att hamna i dem är helt oacceptabelt. Och det som förstör oss här, liksom i mycket annat, är perfektionism och… lathet. Vi försöker göra allt perfekt, men vi behöver inte göra allt perfekt! Vi måste bara göra vissa saker på rätt sätt, genomföra dem fullt ut så att de fungerar ordentligt.
Failover är inte bara något roligt som är bra att ha; det är en funktion som ska göra precis en sak — minska stilleståndstiden, så att tjänsten, företaget, förlorar mindre pengar. Och i alla metoder för reservtäckning föreslår jag att tänka i följande kontext: var ligger pengarna?
Den första fällan: när vi bygger stora pålitliga system och hanterar reservtagning minskar vi antalet avbrott. Detta är en stor missuppfattning. När vi hanterar reservtagning ökar vi sannolikt antalet avbrott. Och om vi gör allt rätt så kommer vi sammanfattningsvis att minska stilleståndstiden. Det kommer att bli fler avbrott, men de kommer att ske med mindre kostnader. Vad är reservtagning? — det är en komplicering av systemet. All komplicering är dåligt: vi får fler skruvar, fler kuggdrev, helt enkelt fler komponenter — och därmed en högre chans för fel. Och de kommer faktiskt att gå sönder. Och de kommer att gå sönder oftare. Ett enkelt exempel: säg att vi har en viss webbplats, med PHP, MySQL. Och den måste snabbt reserveras.
Så, vi tar en andra plattform, bygger ett identiskt system... Svårighetsgraden blir dubbelt så stor — vi har två enheter. Och dessutom lägger vi på en viss logik för att överföra data från en plattform till en annan—det vill säga datarreplication, kopiering av statik och så vidare. Så, logiken för replikering är vanligtvis mycket komplex, och därmed kan den totala svårighetsgraden för systemet vara inte bara 2, utan 3, 5, 10 gånger större.
Den andra fällan: när vi bygger verkligt stora komplexa system, fantiserar vi om vad vi vill uppnå i slutändan. Voilà: vi vill ha ett superpålitligt system som fungerar helt utan driftstopp, växlar på en halv sekund (eller helst omedelbart), och vi börjar förverkliga våra drömmar. Men här finns också en nyans: ju kortare den önskade omställningstiden, desto mer komplex blir logiken i systemet. Ju svårare vi måste göra denna logik, desto oftare kommer systemet att gå sönder. Och man kan hamna i en mycket otrevlig situation: vi försöker med alla medel minska driftstoppets tid, men egentligen gör vi allt mer komplicerat, och när något går fel, kommer driftstoppet i slutändan bli längre. Man fångar ofta sig själv med tanken: tja... det vore bättre att inte reservera. Bättre att det fungerade ensam och med en tydlig driftstoppstid.
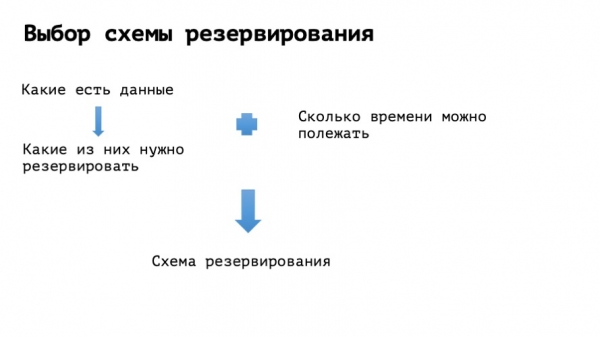
Hur kan man bekämpa detta? Man måste sluta ljuga för sig själv, sluta smickra sig själv med att vi här ska bygga en rymdfarkost, utan istället förstå hur länge projektet kan ta. Och utifrån denna maximala tid väljer vi vilka metoder vi egentligen ska använda för att öka vårt systems pålitlighet.
Det är dags för 'historier från livet'... från livet, såklart.
Exempel nummer ett
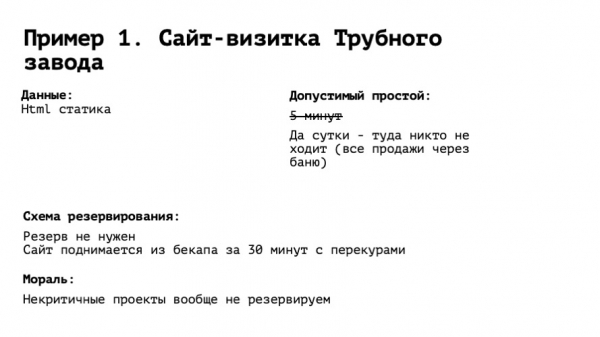
Föreställ dig en visitkortsliknande webbplats för rörproduktionsföretag nr 1 i staden N. På den står med stora bokstäver — RÖRPRODUKTION № 1. Lite längre ner — en slogan: "Våra rör är de mest perfekta rören i N". Och längst ner finns telefonnumret till verkställande direktören och hans namn. Vi förstår att det är viktigt att reservera — det är ju en väldigt viktig grej! Vi börjar förstå vad det handlar om. Html-statik — alltså ett par bilder där chefen, faktiskt, sitter vid bordet i bastun med sin partner och diskuterar något affärsavtal. Vi börjar tänka på stilleståndstiden. Det slår oss: man behöver ligga där i fem minuter, max. Och här kommer frågan: hur många försäljningar har vi haft från denna webbplats? Hur många? Vad betyder "noll"? Det betyder att alla fyra affärer från förra året blev avslutade vid samma bord, med samma personer, som de går till bastun med och sitter vid bordet. Och vi förstår att även om webbplatsen ligger nere en dag — så är det inget som är särskilt farligt.
Med dessa förutsättningar finns det en dag för att lyfta denna historia. Vi börjar tänka på reservschemat. Och vi väljer det mest ideala schemat för reservering för detta exempel: vi använder ingen reservdelning. Den här alltet kan lyftas av vilken administratör som helst på en halvtimme med pauser. Sätta upp webbservern, lägga filerna — klart. Det kommer att fungera. Inget att hålla koll på, inget att ge särskild uppmärksamhet. Så slutsatsen från exempel nummer ett är ganska uppenbar: tjänster som inte behöver reserveras — behöver inte reserveras.
Exempel nummer två
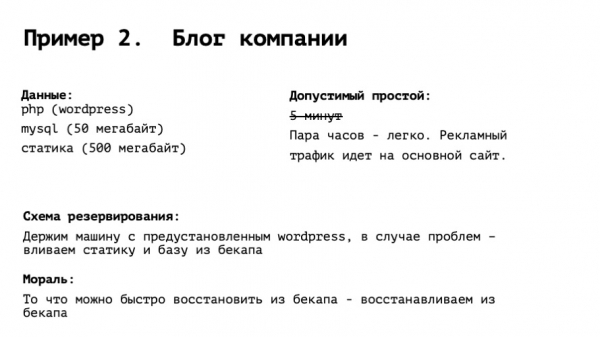
Företagsblogg: specialutbildade skriver nyheter där, som att vi deltog i en viss mässa, och här släppte vi ytterligare en ny produkt och så vidare. Låt oss säga att det är standard PHP med WordPress, en liten databas och lite statisk information. Självklart dyker tanken upp igen, att vi absolut inte kan ligga stilla – "inte mer än fem minuter!", och allt det där. Men låt oss tänka vidare. Vad gör denna blogg? Den får besök från Yandex och Google genom olika sökfrågor, organiskt. Bra. Men hur hänger försäljningen ihop med detta? Insikt: inte särskilt mycket. Annonstrafik går till huvudwebbplatsen, som ligger på en annan server. Vi börjar tänka på reservlösningen för bloggen. Idealiskt sett bör den lyftas inom ett par timmar, och det vore bra att vara förberedd för det. Det är rimligt att ta en annan maskin i ett annat datacenter, installera miljön på den, det vill säga webbserver, PHP, WordPress, MySQL, och låta den ligga inaktiv. I det ögonblick vi inser att något har gått fel, behöver vi göra två saker – återställa en MySQL-dump på 50 megabyte, som går på en minut, och återställa ett visst antal bilder från säkerhetskopian. Detta tar inte heller mycket tid. På så sätt är hela denna lösning uppe på en halvtimme. Inga replikationer, eller förlåt, automatiska failover-processer. Slutsats: det som kan återställas snabbt från backup, behöver inte reserveras.
Exempel nummer tre, lite mer komplicerat
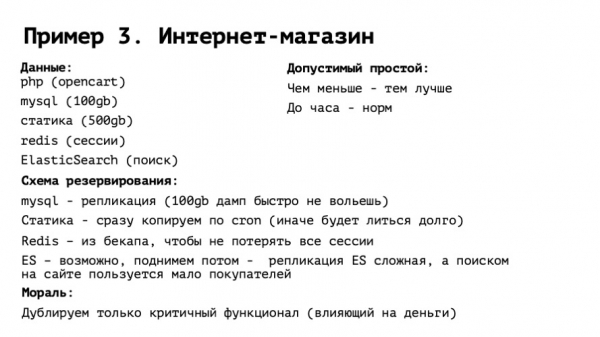
E-handelsbutik. PHP med en något modifierad Open Heart, MySQL med en solid databas. Ganska mycket statisk information (eftersom e-handelsbutiker har vackra HD-bilder och allt det där), Redis för sessioner och Elasticsearch för sök. Vi börjar tänka på stilleståndstid. Och här är det uppenbart att en dag utan problem kan e-handelsbutiken inte ligga nere. Ju längre den är nere, desto mer pengar förlorar vi. Vi måste öka takten. Men hur mycket? Jag tror att om vi ligger nere i en timme, så ger ingen sig till vansinne. Ja, vi kommer att förlora något, men om vi stressar, kommer det bara att bli sämre. Vi definierar schemat för det acceptabla stilleståndet per timme.
Hur kan man boka allt detta? En maskin behövs i vilket fall som helst: en timme är ganska lite. Mysql: här behövs det replikering, levande replikering, eftersom 100 GB inte kommer att rymmas på en timme. Statisk information, bilder: ånyo, 500 GB kanske inte hinner rymmas på en timme. Så det är bäst att kopiera bilderna direkt. Redis: här blir det intressantare. I Redis ligger sessionerna — vi kan inte bara ta bort det. För det skulle inte vara bra: alla användare skulle loggas ut, kundvagnarna skulle tömmas och så vidare. Folk tvingas skriva in sina inloggningsuppgifter på nytt, och många kanske tappar intresset och inte slutför köpet. Återigen, konversionen skulle sjunka. Å andra sidan, Redis är rätt så uppdaterad, med de senast inloggade användarna, kanske det inte heller är nödvändigt. En bra kompromiss är att ta Redis och återställa det från backupen, den från igår eller, om den görs varje timme, den från för en timme sedan. Bra att återställa det från en backup är att kopiera en fil. Och den mest intressanta historien är Elasticsearch. Vem har någonsin satt upp MySQL-replikering? Vem har någonsin satt upp Elasticsearch-replikering? Och vem har den fungerat bra för efteråt? Jag menar: vi ser en viss enhet i vårt system. Det verkar vara användbart — men det är komplicerat.
Svårigheterna ligger i att våra ingenjörskollegor saknar erfarenhet av det. Antingen finns det negativa erfarenheter. Eller så förstår vi att detta fortfarande är en ganska ny teknik med sina nyanser och brister. Vi tänker… Tja, Elastic är också stort, det tar lång tid att återställa från backup, vad ska vi göra? Vi inser att Elastic i det här fallet används för sökning. Men hur säljer vår webbutik? Vi pratar med marknadsförarna och frågar varifrån kunderna kommer. De svarar: "90 % kommer direkt till produktkortet från Yandex Market." Antingen köper de eller så gör de inte det. Därför behövs sökning endast för 10 % av användarna. Att hålla en replikering av Elastic, särskilt mellan olika datacenter i olika zoner, har verkligen många nyanser. Vad är lösningen? Vi tar Elastic på en reserverad plattform och gör inget med det. Om det drar ut på tiden, kan vi kanske starta det senare, men det är inte säkert. Så, slutsatsen är i stort sett densamma: tjänster som inte påverkar intäkterna reserverar vi inte. För att hålla schemat enklare.
Exempel nummer fyra, ännu svårare.
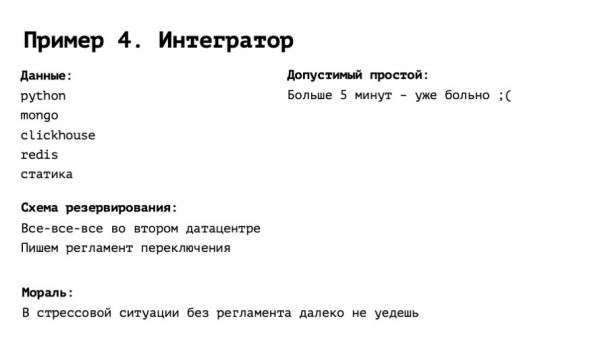
Integratör: försäljning av blommor, beställning av taxi, försäljning av produkter, kort sagt, vad som helst. En seriös lösning som arbetar 24/7 med ett stort antal användare. Med en helhetslösning som har intressanta databaser, lösningar, hög belastning, och framför allt, att ligga nere mer än 5 minuter är problematiskt. Inte bara för att människor inte köper, utan för att de ser att denna tjänst inte fungerar, blir besvikna och kanske inte kommer tillbaka en andra gång.
Okej. Fem minuter. Vad ska vi göra åt detta? I det här fallet bygger vi en riktig reservlösning för alla pengar, med replikering av allt och alla, och kanske automatiserar vi även övergången till denna plattform så mycket som möjligt. Dessutom bör vi inte glömma att göra en viktig sak: faktiskt skriva en övergångsprotokoll. Protokollet, även om allt är automatiserat, kan vara mycket enkelt. I stil med "starta detta Ansible-scenario", "tryck på denna kryssruta i Route 53" osv. – men det måste vara en tydlig lista över åtgärder.
Och allt verkar klart. Att växla replikation är en trivial uppgift, antingen sker det automatiskt eller så gör vi det manuellt. Att skriva om domännamnet i DNS är en liknande uppgift. Problemet är att när ett sådant projekt kraschar, uppstår panik, och även de mest erfarna administratörerna kan bli drabbade. Utan en tydlig instruktion som "öppna terminalen, gå hit, adressen till vår server är fortfarande så här" är det svårt att hantera en tidsram på 5 minuter för återupplivning. Dessutom, när vi följer detta regelverk, är det lätt att dokumentera förändringar i infrastrukturen och justera reglerna därefter.
Men om reservsystemet är mycket komplext och vi gör ett misstag vid något tillfälle, kan vi både krossa och vår reservplats, och dessutom förvandla data till pumpor på båda platserna – det skulle bli riktigt tragiskt.
Exempel nummer fem, ren hardcore
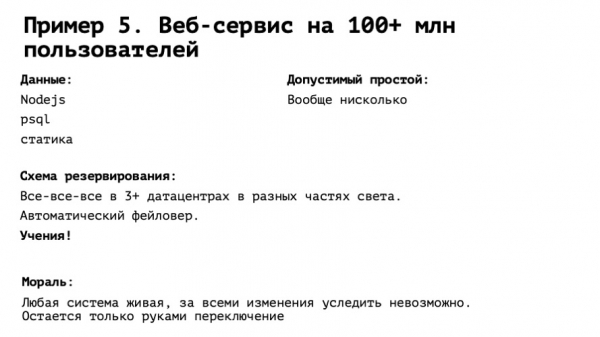
En internationell tjänst med hundratals miljoner användare över hela världen. Alla tidszoner som finns, highload på max, kan inte stoppas överhuvudtaget. En minut – och det blir sorgligt. Vad gör vi? Vi reserverar, igen, på fullskala. Vi har gjort allt som nämnts i föregående exempel och lite till. Den perfekta världen, och vår infrastruktur – den följer alla DevOps-principer för IaaC. Det vill säga, allt finns i git, och du behöver bara trycka på knappen.
Vad saknas? En sak – övningar. Utan dem går det inte. Det verkar som om allt är perfekt, vi har allt under kontroll. Vi trycker på knappen och allt händer. Även om det är så – och vi vet att så är det inte alltid – interagerar vårt system med andra system. Till exempel, DNS från Route 53, S3-lagring, integration med olika API:er. Vi kan inte förutse allt i detta hypotetiska experiment. Och så länge vi inte faktiskt flippar strömbrytaren – kommer vi inte veta om det fungerar eller inte.
Det var nog allt. Var inte lata och överdriv inte. Må uptime vara med er!
Källa: habr.com
