

I dag handlar vi om en intressant teknik implementerad i lagringssystemet Unity/Unity XT – FAST VP. Om du hör om Unity för första gången kan du via länken i slutet av artikeln bekanta dig med systemets egenskaper. Jag har arbetat i projektteamet på Dell EMC med FAST VP i över ett år. Idag vill jag ge en mer detaljerad beskrivning av denna teknik och avslöja vissa detaljer om dess implementation. Självklart endast de som jag får avslöja. Om du är intresserad av effektiva datalagringsfrågor eller bara inte helt har förstått dokumentationen, kommer denna artikel garanterat att vara användbar och intressant.
Låt mig genast klargöra vad materialet inte kommer att innehålla. Det kommer inte att finnas någon konkurrensanalys eller jämförelse med andra. Jag planerar heller inte att prata om liknande teknologier från open source, eftersom nyfikna läsare redan känner till dem. Och självklart tänker jag inte reklamera för något.
Lagringsnivåindelning. Mål och uppgifter för FAST VP
FAST VP står för Fully Automated Storage Tiering for Virtual Pool. Svårt? Ingen fara, vi reder ut det. Nivåindelning är ett sätt att organisera datalagring där det finns flera nivåer (tiers) där dessa data lagras. Varje nivå har sina egna egenskaper. De viktigaste är: prestanda, volym och kostnad för att lagra en enhet information. Självklart finns det ett samband mellan dem.
En viktig egenskap hos nivåindelning är att åtkomst till data tillhandahålls enhetligt oavsett vilken lagringsnivå de för närvarande befinner sig på, och storleken på poolen är summan av storlekarna på de resurser som ingår i den. Här ligger skillnaderna från cachen: storleken på cachen läggs inte till den totala storleken på resurserna (poolen i detta fall), utan cachedata duplicerar en del av data från den primära lagringsenheten (eller kommer att dupliceras om cachedata ännu inte har skrivits). Fördelningen av data över nivåerna är även dold för användaren. Det vill säga, han ser inte vilken data som är placerad på varje nivå, även om han kan påverka detta indirekt genom att ange policyer (mer om dem senare).
Nu ska vi titta på egenskaperna hos implementationen av lagringsnivåindelning i Unity. I Unity finns det tre nivåer, eller tiers:
- Extrem prestanda (SSDs)
- Prestanda (SAS HDD 10k/15k RPM)
- Kapacitet (NL-SAS HDD 7200 RPM)
De presenteras i ordning efter prestanda och pris. I Extreme performance ingår enbart SSD-lagringsenheter. I de två andra nivåerna ingår hårddiskar som skiljer sig åt med avseende på rotationshastighet och därmed prestanda.
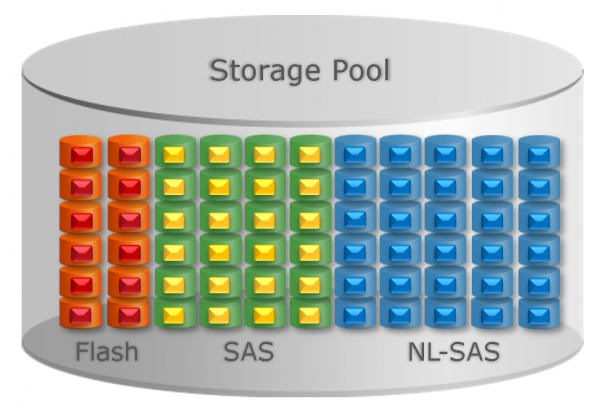
Lagringsenheter från samma nivå och storlek sammanfogas i en RAID-konstruktion, vilket bildar en RAID-grupp (RAID group, förkortat – RG); om tillgängliga och rekommenderade RAID-nivåer kan du läsa i den officiella dokumentationen. Från RAID-grupper med en eller flera nivåer bildas lagringspooler (Storage pool) där den lediga platsen senare fördelas. Och från poolen allokeras utrymme för filsystem och LUN:er.
Vad behöver jag tiering för?
Kort och abstrakt sagt: för att uppnå större resultat med minimiresurser. Mer konkret avses med resultat oftast en samling egenskaper för lagringssystemet – hastighet och åtkomsttid, lagringskostnad, och liknande. Med minimiressurser menas de lägsta kostnaderna: pengar, energi och så vidare. FAST VP implementerar just mekanismer för omfördelning av data över olika nivåer i Unity/Unity XT-lagringssystemet. Om ni tror mig kan ni hoppa över nästa stycke. För andra berättar jag lite mer.
Rätt fördelning av data över lagringsnivåerna gör att man kan spara på den totala kostnaden för lagringssystemet, genom att offra åtkomsthastigheten till viss sällan använd information, och öka prestandan genom att flytta ofta använda data till snabbare enheter. Här kan någon invända att en normal administratör även utan tiering vet var olika data ska placeras, vilka egenskaper lagringssystemet bör ha för hans uppgift och så vidare. Det är utan tvekan sant, men manuell datafördelning har sina nackdelar:
- kräver tid och uppmärksamhet från administratören;
- är det inte alltid möjligt att 'omforma' lagringssystemets resurser efter förändrade förhållanden;
- går en viktig fördel förlorad: enhetlig åtkomst till resurser som befinner sig på olika lagringsnivåer.
För att lagringsadministratörer ska vara mindre bekymrade över jobbsäkerhet, vill jag tillägga att noggrann resursplanering också behövs här. Nu när uppgifterna om tiering kortfattat har skisserats, låt oss se vad vi kan förvänta oss av FAST VP. Här är det dags att återgå till definitionen. De första två orden – Fully Automated – översätts ordagrant som "helt automatiserad" och betyder att fördelningen efter nivåer sker automatiskt. Och Virtual Pool är en databas som består av resurser från olika lagringsnivåer. Så här ser det ut:
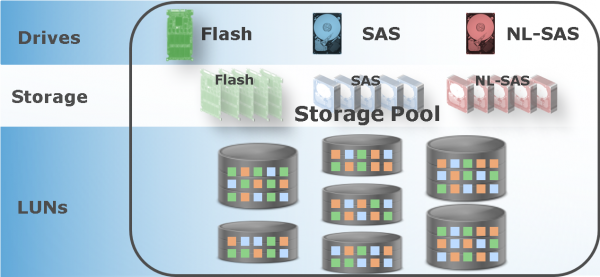
För att gå händelserna i förväg, säger jag att FAST VP endast flyttar data inom en pool, inte mellan flera pooler.
Uppgifter som löses av FAST VP
Låt oss först prata abstrakt. Vi har en pool och en viss mekanism som kan omfördela data inom denna pool. Med tanke på att vårt mål är att uppnå maximal prestanda, ställer vi oss frågan: vilka sätt kan vi nå detta? Det kan finnas flera, och här har FAST VP mycket att erbjuda användaren, eftersom tekniken representerar mer än bara lagrings-tiering. Här är de sätt som FAST VP kan öka prestandan i poolen:
- Fördelning av data över olika typer av diskar, nivåer
- Fördelning av data bland diskar av samma typ
- Fördelning av data vid utvidgning av poolen
Innan vi går igenom hur dessa uppgifter löses, behöver vi veta några viktiga fakta om hur FAST VP fungerar. FAST VP arbetar med block av en viss storlek – 256 megabyte. Det är det minsta kontinuerliga "stycket" data som kan flyttas. I dokumentationen kallas det just: slice. Ur FAST VPs synvinkel består alla RAID-grupper av en uppsättning sådana "bitar". Därför samlas all statistik över in- och utdata för sådana datablock. Varför har just denna blockstorlek valts och kommer den att minskas? Blocket är tillräckligt stort, men det är en avvägning mellan datagranularitet (mindre blockstorlek – mer exakt fördelning) och tillgängliga beräkningsresurser: med nuvarande hårda begränsningar av det tillgängliga minnet och ett stort antal block kan statistiken ta för mycket resurser, och antalet beräkningar kommer att öka proportionellt.
Hur FAST VP placerar data i poolen. Policys
För att hantera datalagringen i en pool med aktiverad FAST VP finns det följande policies:
- Högsta tillgängliga nivå
- Auto-Tier
- Börja högt och sedan Auto-Tier (standard)
- Lägsta tillgängliga nivå
De påverkar både den ursprungliga placeringen av blocket (data som skrivs första gången) och den efterföljande omfördelningen. När data väl har placerats på diskarna kommer omfördelningen att initieras enligt schema eller manuellt.
Högsta tillgängliga nivå försöker placera ett nytt block på den mest prestandakraftiga nivån. Vid brist på utrymme där kommer det att placeras på nästa bästa nivå, men senare kan data flyttas till en mer prestandakraftig nivå (om det finns utrymme eller genom att tränga bort andra data). Auto-Tier placerar nya data på olika nivåer beroende på storleken på det tillgängliga utrymmet, och de omfördelas baserat på efterfrågan och ledigt utrymme. Börja högt och sedan Auto-Tier är standardpolicy och även den rekommenderade. Vid den initiala placeringen fungerar den som Högsta tillgängliga nivå, och därefter flyttas data baserat på deras användningsstatistik. Policyn Lägsta tillgängliga nivå syftar till att placera data på den minst prestandakraftiga nivån.
Dataflyttning sker med låg prioritet för att inte störa den nyttiga driften av lagringssystemet, men det finns en inställning för "Data relocation rate" som ändrar prioriteten. Här finns en speciell egenskap: inte alla datablok har samma prioritering för omfördelning. Till exempel kommer block som är märkta som metadata att flyttas till en snabbare nivå först. Metadata är, om man så vill, "data om data", en slags extra information som inte är användardata, men som lagrar deras beskrivning. Till exempel, information i filsystemet om vilket block en specifik fil finns i. Det betyder att åtkomsthastigheten till data beror på åtkomsthastigheten till metadata. Eftersom metadata vanligtvis är mycket mindre i storlek, förväntas vinsten av deras flytt till mer prestandakraftiga diskar vara större.
Kriterierna som Fast VP använder i sitt arbete
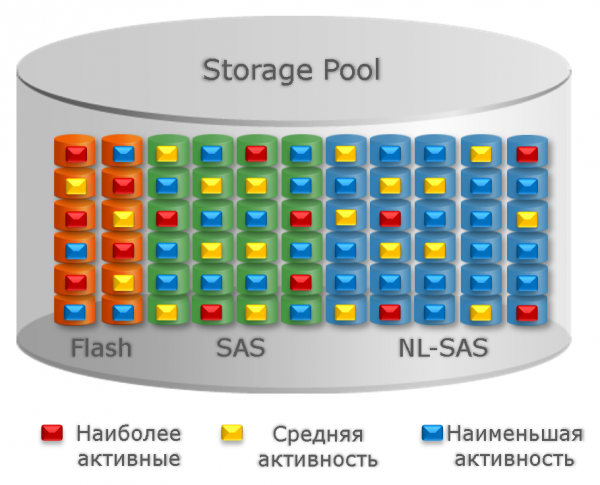
Huvudkriteriet för varje block, grovt sett, är egenskapen "efterfrågan" av data, som beror på antalet läs- och skrivoperationer av datasegmentet. Denna egenskap kallar vi "Temperatur". Det finns efterfrågade (hot) data som är "hetare" än oanvända. Den beräknas periodiskt, som standard med en timmes intervall.
Funktionen för temperaturberäkning har följande egenskaper:
- I avsaknad av in- och utdata "kyls" data över tid.
- Vid mer eller mindre konstant belastning ökar temperaturen först och stabiliseras sedan inom ett visst intervall.
Därefter beaktas de strategier som beskrivits ovan och det lediga utrymmet på varje nivå. För tydlighetens skull tar jag med en bild från dokumentationen. Här betecknas block med hög, medelhög och låg temperatur med röd, gul och blå färg.
Men låt oss återvända till uppgifterna. Så, vi kan börja bryta ner vad som görs för att lösa FAST VP-uppgifterna.
A. Datafördelning över olika typer av diskar, nivåer
Detta är i grund och botten huvuduppgiften för FAST VP. De andra är på ett sätt härledda från den. Beroende på den valda strategin kommer data att fördelas över olika lagringsnivåer. Först och främst beaktas placeringstrategin, sedan blockens temperatur och storlek/prestanda hos RAID-grupper.
För strategierna Högsta/Lägsta tillgängliga nivå är det ganska enkelt. För de andra två ser det ut så här. Data fördelas över olika nivåer med hänsyn till storlek och prestanda hos RAID-grupper: så att förhållandet mellan den totala "temperaturen" av blocken och den "hypotetiska maximala prestandan" hos varje RAID-grupp är ungefär detsamma. På så sätt blir belastningen mer eller mindre jämnt fördelad. Mer efterfrågade data flyttas till snabba lagringsenheter, sällan använda till långsammare. Idealiskt bör fördelningen se ut ungefär så här:
B. Datafördelning bland diskar av samma typ
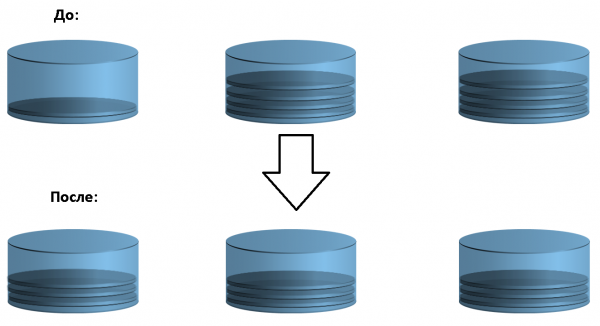
Kom ihåg, i början skrev jag att lagringsenheter från ett eller flera Hur många nivåer sammanfogas till en pool? När det gäller en enda nivå finns det också arbete för FAST VP. För att maximera prestandan på någon nivå är det önskvärt att distribuera data jämnt mellan diskarna. Detta kommer i teorin att ge maximal mängd IOPS. Data inom en RAID-grupp kan betraktas som jämnt fördelade bland diskarna, men mellan RAID-grupper är det långt ifrån alltid så. Vid obalans kommer FAST VP att flytta data mellan RAID-grupper proportionellt mot deras volym och "villkorlig prestanda" (i numerisk form). För tydlighetens skull visar jag en rebalance-schema bland tre RAID-grupper:
B. Datafördelning vid utvidgning av poolen
Detta är ett särskilt fall av föregående och utförs när en RAID-grupp läggs till en pool. För att den nyanl добавен RAID-gruppen inte ska stå oanvänd kommer en del av data att flyttas till den, vilket innebär att belastningen på alla RAID-grupper kommer att omfördelas.
Utjämning av SSD-slitage
Genom att använda utjämning av slitage kan FAST VP förlänga livslängden på SSD:er, även om denna funktion inte direkt relaterar till Storage Tiering. Eftersom vi redan har data om temperaturen och antalet skrivoperationer beaktas, kan vi flytta datablok, så det skulle vara logiskt för FAST VP att också lösa denna uppgift.
Om antalet skrivningar till en RAID-grupp betydligt överstiger antalet skrivningar till en annan, kommer FAST VP att omfördela data i enlighet med antalet skrivoperationer. Å ena sidan minskar detta belastningen och skyddar resurserna hos vissa diskar, å andra sidan ökar det "arbetsbelastningen" för de mindre belastade, vilket ökar den totala prestandan.
Därmed tar FAST VP på sig de traditionella uppgifterna för Storage Tiering och gör även lite mer än så. Allt detta gör att data kan lagras ganska effektivt inom Unity-familjen av lagringssystem.
Några tips
- Försummas inte läsning av dokumentationen. Det finns bästa metoder, och de fungerar ganska bra. Om man följer dem uppstår vanligtvis inga allvarliga problem. Övriga råd upprepar eller kompletterar huvudsakligen dessa.
- Om du har konfigurerat och aktiverat FAST VP, är det bäst att ha det aktiverat. Låt det fördela data under den tid som är avsatt för det, istället för att göra det en gång om året och påverka andra uppgifter negativt. I sådana fall kan datamigreringen ta lång tid.
- Var noga med att välja rätt tid för relokeringen. Även om det är uppenbart, försök att välja en tid med lägst belastning på Unity och avsätt tillräckligt med tid.
- Planera för att utöka lagringssystemet i tid. Det här är en allmän rekommendation som även är viktig för FAST VP. Om mängden ledigt utrymme är mycket liten, kommer dataöverföringen att bli långsammare eller omöjlig. Särskilt om du har åsidosatt punkt 2.
- När du expanderar poolen med aktiverat FAST VP, bör du inte börja med de långsammaste diskarna. Det vill säga, antingen lägger du till alla planerade RAID-grupper på en gång, eller så börjar du först med de snabbaste diskarna. På så sätt kommer dataöverföringen till de nya 'snabba' diskarna att öka den totala hastigheten på poolen. Annars, om du börjar med de 'långsamma' diskarna, kan du hamna i en väldigt obehaglig situation. Först kommer data att överföras till de nya, relativt långsamma diskarna, och sedan, när snabbare läggs till, kommer det att gå i motsatt riktning. Här finns det nyanser kopplade till olika FAST VP-policies, men i allmänhet är en sådan situation möjlig.
Om du överväger denna produkt kan du prova Unity gratis genom att ladda ner Unity VSA virtual appliance.
Avslutningsvis delar jag några användbara länkar:
- Sida
- – en kort beskrivning av funktionen
- , PDF-format
Slutsats
Det finns mycket jag vill skriva om, men jag förstår att inte alla detaljer kommer att intressera läsaren. Till exempel kan man berätta mer om kriterierna som FAST VP använder för att fatta beslut om dataöverföring, samt om processerna för analys av in- och utdata-statistik. Ämnet för interaktionen med , det är nästan en egen artikel. Man kan till och med spekulera kring utvecklingen av denna teknik. Jag hoppas att det inte var tråkigt och att jag inte uttröttade er. Tills nästa gång!
Källa: habr.com
