

Team erbjuder Ingenjör Rahul Bhattia från företaget Clairvoyant diskuterar vilka filformat som finns inom stora data, vilka funktioner av Hadoop-format som är vanligast och vilket format som är bäst att använda.
Varför olika filformat behövs
En allvarlig flaskhals i prestandan hos applikationer som stöder HDFS, såsom MapReduce och Spark, är tiden för att söka, läsa och skriva data. Dessa problem förvärras av svårigheterna att hantera stora datamängder om vi har ett icke-fixerat, utan ett utvecklande schema, eller om det finns vissa lagringsbegränsningar.
Bearbetning av stora data ökar belastningen på lagersystemet – Hadoop lagrar data redundant för att säkerställa driftsäkerhet. Förutom diskarna belastas även CPU, nätverk, in- och utgångssystem med mera. I takt med att datavolymen ökar, ökar också kostnaderna för bearbetning och lagring.
Olika filformat i är utformade för att lösa dessa problem. Att välja rätt filformat kan ge några betydande fördelar:
- Snabbare lästid.
- Snabbare skrivtid.
- Delade filer.
- Stöd för schemabedömning.
- Utökad stöd för komprimering.
Vissa filformat är avsedda för allmänt bruk, medan andra är för mer specifika fall, och vissa är designade med tanke på specifika datakarakteristika. Valet är alltså ganska stort.
Avro-filformatet
För för dataserialisering används brett inom Avro – det är en radbaseradeller strängbaserad lagringsformat i Hadoop. Det lagrar schemat i JSON-format, vilket underlättar för att läsa och tolka av vilket program som helst. Själva datan lagras i ett binärt format, kompakt och effektivt.
Avros serialiseringssystem är språkneutralt. Filer kan hanteras med flera olika språk, för närvarande C, C++, C#, Java, Python och Ruby.
En nyckelfunktion hos Avro är den robusta stödet för dataskematisering, som förändras över tid, det vill säga utvecklas. Avro förstår schemaändringar – borttagning, tillägg eller ändring av fält.
Avro stöder en mängd olika datastrukturer. Till exempel kan man skapa en post som innehåller en array, en uppräkningsbar typ och en underskrivning.
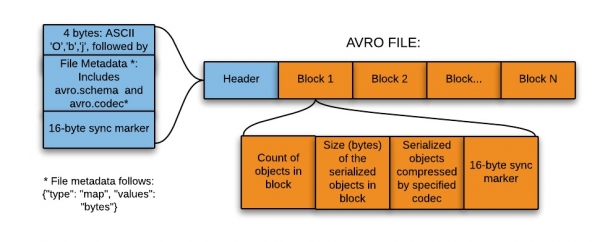
Det här formatet är perfekt för att spela in i landningszonen för datalake (, eller data lake — en samling instanser för lagring av olika datatyper utöver själva datakällorna).
Så, för inspelning i landningszonen för datalake är detta format bäst av följande skäl:
- Data från detta område läses vanligtvis i sin helhet för vidare bearbetning av underliggande system — och string-baserade format är mer effektiva i detta fall.
- Underliggande system kan enkelt extrahera schemas från filer — det behövs ingen separat lagring av scheman i ett externt metadatalager.
- Eventuella förändringar av den ursprungliga schemat hanteras enkelt (schemaevolution).
Parquet-filformatet
Parquet är ett öppet filformat för Hadoop som lagrar inbäddade datastukturer i ett platt kolumnformat..
Jämfört med det traditionella radbaserade tillvägagångssättet är Parquet mer effektivt avseende lagring och prestanda.
Detta är särskilt användbart för frågor som läser specifika kolumner från en bred (med många kolumner) tabell. Tack vare filformatet läses endast de nödvändiga kolumnerna, vilket minimerar in- och utdata.
Ett litet avsnitt-förklaring: för att bättre förstå Parquet-filformatet i Hadoop, låt oss titta på vad som menas med kolumnbaserat — det vill säga kolumnformat. I ett sådant format lagras liknande värden för varje kolumn tillsammans.
, raden inkluderar fälten ID, Name och Department. I detta fall kommer alla värden för kolumnen ID att lagras tillsammans, likaså värdena för kolumnen Name och så vidare. Tabellen kommer att se ut ungefär så här:
ID
Namn
Department
1
emp1
d1
2
emp2
d2
3
emp3
d3
I radformat kommer data att sparas på följande sätt:
1
emp1
d1
2
emp2
d2
3
emp3
d3
I kolumnformat lagras samma data så här:
1
2
3
emp1
emp2
emp3
d1
d2
d3
Kolumnformat är mer effektivt när du behöver fråga flera kolumner från tabellen. Det läser endast de nödvändiga kolumnerna eftersom de ligger nära varandra. Detta minimerar in- och utdata operationer.
Till exempel, om du bara behöver kolumnen NAME. I Varje post i datamängden måste laddas, delas upp i fält och sedan extraheras data NAME. Kolumnformatet gör det möjligt att gå direkt till kolumnen Namn, eftersom alla värden för denna kolumn lagras tillsammans. Det blir inte nödvändigt att skanna hela posten.
Det betyder att kolumnformatet ökar prestandan för frågorna, eftersom mindre tid krävs för att hitta de nödvändiga kolumnerna och antalet in- och utoperationer minskar, då endast de nödvändiga kolumnerna läses.
En av de unika egenskaperna är att det i detta format kan lagra data med inbäddade strukturer.Det betyder att i en Parquet-fil kan även inbäddade fält läsas separat utan att behöva läsa alla fält i den inbäddade strukturen. För att lagra inbäddade strukturer använder Parquet algoritmen shredding and assembly.
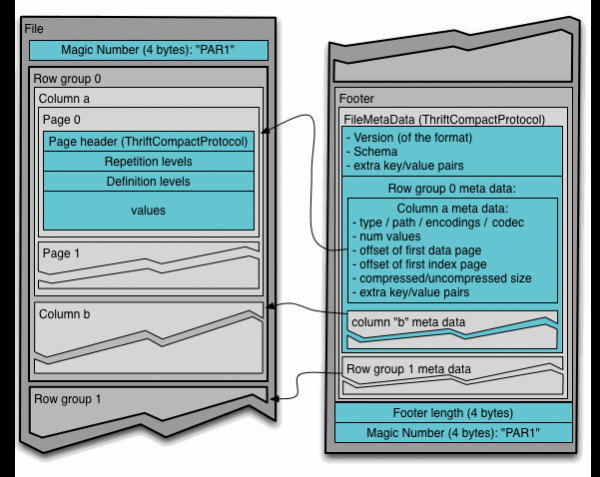
För att förstå Parquet-filformatet i Hadoop måste man känna till följande termer:
- Radgrupp (row group): en logisk horisontell indelning av data i rader. Radgruppen består av ett fragment av varje kolumn i datamängden.
- Kolumnfragment (column chunk): ett fragment av en specifik kolumn. Dessa kolumnfragment finns inom en viss radgrupp och kommer garanterat att vara sammanhängande i filen.
- Sida (page): kolumnfragment delas upp i sidor, som skrivs efter varandra. Sidor har en gemensam header, så att man kan hoppa över onödiga vid läsning.
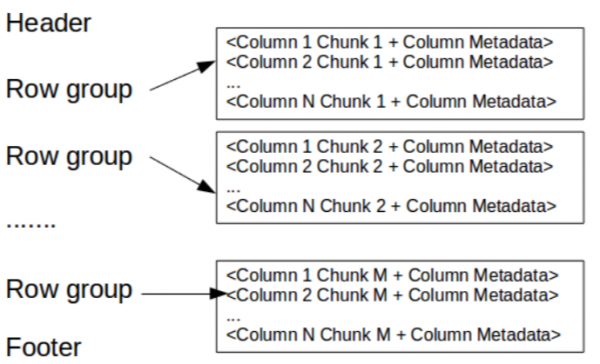
Här innehåller headern helt enkelt ett magiskt nummer PAR1 (4 byte) som identifierar filen som en Parquet-fil.
I foten står följande:
- Metadatan för filen som innehåller startkoordinaterna för metadata i varje kolumn. Vid läsning måste man först läsa filens metadata för att hitta alla intressanta kolumnfragment. Därefter ska kolumnfragmenten läsas sekventiellt. Ytterligare metadata inkluderar formatversion, schema och eventuella ytterligare nyckel-värde-par.
- Längden på metadatan (4 byte).
- Det magiska numret PAR1 (4 byte).
Filformatet ORC
Optimerat rad- och kolumnformat för filer (Optimized Row Columnar, ) erbjuder en mycket effektiv metod för datalagring och har utvecklats för att övervinna begränsningarna i andra format. Lagrar data i en perfekt kompakt form, vilket gör det möjligt att hoppa över onödiga detaljer — vilket samtidigt inte kräver att stora, komplicerade eller manuellt underhållna index byggs.
Fördelarna med ORC-formatet:
- En fil per utgång av varje jobb, vilket minskar belastningen på NameNode.
- Stöd för Hive-datatypen, inklusive DateTime, decimaler och komplexa datatyper (struct, list, map och union).
- Samtidig läsning av samma fil av olika RecordReader-processer.
- Möjlighet att dela filer utan att skanna efter markörer.
- Utvärdering av den maximalt möjliga heap-minnesallokeringen för läs-/skrivprocesser baserat på information i filens footer.
- Metadata sparas i ett binärt format för serialisering med Protocol Buffers, vilket gör det möjligt att lägga till och ta bort fält.
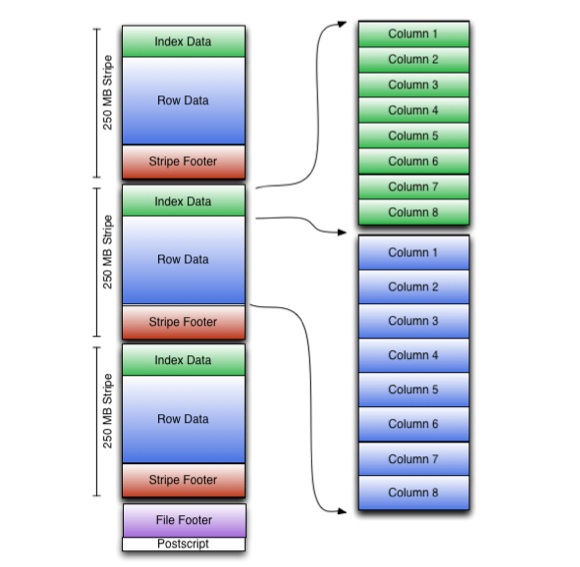
ORC lagrar samlingar av rader i en fil, och inom en samling lagras raddata i kolumnformat.
ORC-filen lagrar grupper av rader som kallas stripes och hjälpinformation i filens footer. Postscript i slutet av filen innehåller komprimeringsparametrar och storleken på den komprimerade footern.
Som standard är storleken på en stripe 250 MB. Med stripes av den storleken utförs läsning från HDFS mer effektivt: i stora, kontinuerliga block.
I filens footer registreras en lista över stripes i filen, antalet rader per stripe och datatypen för varje kolumn. Där registreras också de resulterande värdena count, min, max och sum för varje kolumn.
Footern för stripes innehåller en katalog över flödenas placeringar.
Raddata används vid skanning av tabeller.
Indexdata inkluderar minimala och maximala värden för varje kolumn samt positionerna för rader i varje kolumn. ORC-index används endast för att välja stripes och grupper av rader, inte för att besvara förfrågningar.
Jämförelse av olika filformat
Avro jämfört med Parquet
- Avro är ett rad-baserat lagringsformat, medan Parquet lagrar data kolumnvis.
- Parquet är bättre lämpad för analytiska förfrågningar, det vill säga att läs- och datafrågeoperationer är mycket mer effektiva än skrivningar.
- Skrivaroperationer i Avro utförs mer effektivt än i Parquet.
- Avro fungerar mer moget med schemors evolution. Parquet stöder endast tillägg av schema, medan Avro implementerar multifunktionell evolution, det vill säga tillägg eller ändring av kolumner.
- Parquet är perfekt för att fråga efter en delmängd av kolumner i en flerkolumnstabell. Avro är lämplig för ETL-operationer där vi vill fråga efter alla kolumner.
ORC jämfört med Parquet
- Parquet lagrar inbäddade data bättre.
- ORC är bättre anpassat för predicates pushdown.
- ORC stöder ACID-egenskaper.
- ORC komprimerar data bättre.
Vad mer att läsa om ämnet:
- .
- .
- .
Källa: habr.com
