

Hej, läsare av Habr. Med den här artikeln inleder vi en serie som kommer att berätta om vårt utvecklade hyperkonvergerande system AERODISK vAIR. Vi ville först i denna artikel berätta allt om allt, men systemet är ganska komplext, så vi kommer att äta elefanten bit för bit.
Vi börjar berättelsen med historien om skapandet av systemet, fördjupar oss i filsystemet ARDFS, som är grunden för vAIR, och resonerar lite kring hur denna lösning positioneras på den ryska marknaden.
I kommande artiklar kommer vi att gå mer i detalj på olika arkitekturkomponenter (kluster, hypervisor, lastbalanserare, övervakningssystem osv.), installationsprocessen, ta upp licensieringsfrågor, särskilt visa kraschtester och självklart skriva om belastningstestning och sizing. Vi kommer också att ägna en artikel åt community-versionen av vAIR.
Är AERODISK en historia om lagringssystem? Eller varför började vi överhuvudtaget arbeta med hyperkonvergens?
Till en början kom idén att skapa vår egen hyperkonvergens någon gång runt 2010. Då fanns det varken AERODISK eller liknande lösningar (kommersiella paketlösningar för hyperkonvergens) på marknaden. Vårt mål var följande: från en uppsättning servrar med lokala diskar, sammankopplade med interconnect via Ethernet-protokollet, behövde vi skapa en distribuerad lagring och samtidigt köra virtuella maskiner och ett programnätverk. Allt detta måste realiseras utan lagringssystem (eftersom vi helt enkelt inte hade pengar för lagringssystem och dess tillbehör, och vi hade ännu inte uppfunnit vårt eget lagringssystem).
Vi testade många open source-lösningar och lyckades faktiskt lösa uppgiften, men lösningen var väldigt komplex och svår att återupprepa. Dessutom var det en lösning av typen "Fungerar? Rör inte!". Så efter att ha löst den uppgiften fortsatte vi inte att vidareutveckla idén att förvandla resultatet av vårt arbete till en fullständig produkt.
Efter den händelsen avvek vi från denna idé, men vi kände fortfarande att uppgiften var helt lösbar, och nyttan av en sådan lösning var mer än uppenbar. De HCI-produkter från utländska företag som kom senare bekräftade bara den känslan.
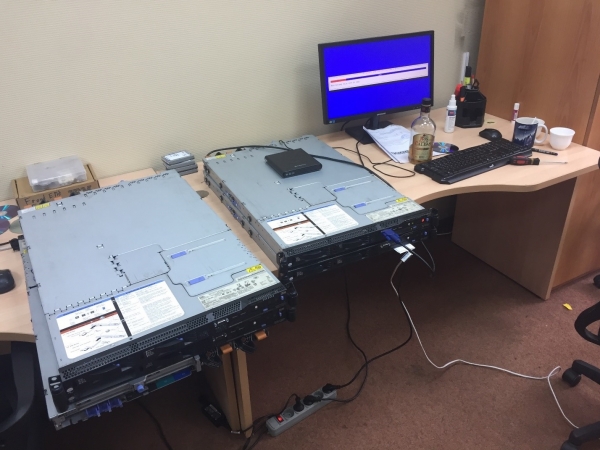
Därför återvände vi i mitten av 2016 till denna uppgift inom ramen för skapandet av en fullt fungerande produkt. Vid den tiden hade vi inga relationer med investerare, så vi var tvungna att köpa utvecklingsställ för våra begränsade pengar. Efter att ha letat på Avito efter begagnade servrar och switchar satte vi igång.
Huvuduppgiften i början var att skapa vårt eget, om än enkla, filsystem som skulle kunna automatiskt och jämnt fördela data i form av virtuella block på ett n-antal noder i klustret, som var anslutna via Ethernet. Samtidigt skulle FS fungera bra och enkelt kunna skalas samt vara oberoende av angränsande system, det vill säga vara separerbart från vAIR i form av "bara ett lagringssystem".
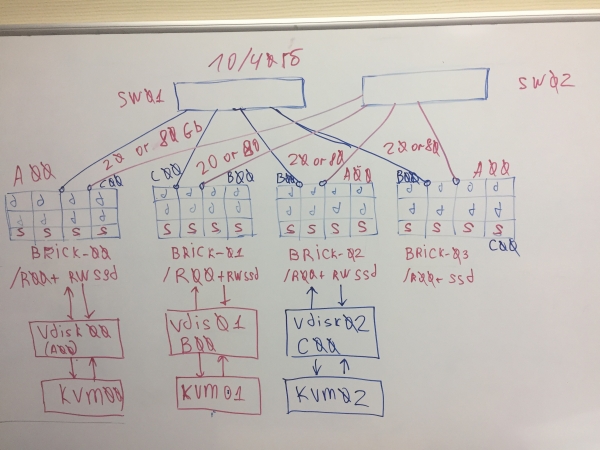
Den första konceptet av vAIR
Vi valde medvetet att avstå från att använda färdiga open source-lösningar för att organisera ett distribuerat lagringssystem (ceph, gluster, lustre och liknande) till förmån för vår egen utveckling, eftersom vi redan hade mycket projektkompetens med dem. Självklart är dessa lösningar utmärkta i sig, och innan vi började arbeta med Aerodisc genomförde vi flera integrationsprojekt med dem. Men det är en sak att lösa en specifik uppgift för en kund, utbilda personalen och möjligen köpa stöd från en stor leverantör, och helt annat att skapa en lätt reproducerbar produkt som kommer att användas för olika uppgifter som vi, som leverantör, kanske till och med inte vet om. För detta ändamål var existerande open source-produkter inte lämpliga, så vi beslutade att utveckla ett distribuerat filsystem själva.
Två år senare nådde vi genom insatserna från flera utvecklare (som kombinerade arbetet med vAIR med arbetet med klassiska lagringssystemet Engine) ett visst resultat.
Till 2018 hade vi skrivit ett enklaste filsystem och kompletterat det med nödvändig kringutrustning. Systemet samlade fysiska (lokala) diskar från olika servrar över intern interconnect i en platt pool och "delade" dem i virtuella block, från vilka blocken skapades blockenheter med en viss grad av felmotstånd, på vilka virtuella maskiner skapades och kördes med hjälp av hypervisor KVM.
Vi lade inte så mycket tid på namnet på filsystemet och kallade det kort och gott ARDFS (gissa vad det står för))
Denna prototyp såg bra ut (inte visuellt, förstås, det fanns ingen visuell design då) och visade goda prestanda och skalbarhet. Efter det första verkliga resultatet gick vi vidare med detta projekt, organiserade en komplett utvecklingsmiljö och ett separat team som bara arbetade med vAIR.
Precis vid den tiden mognade den övergripande arkitekturen av lösningen, som fortfarande inte genomgått några betydande förändringar.
Låt oss dyka ner i filsystemet ARDFS
ARDFS är grunden för vAIR, som erbjuder distribuerad, felfri lagring av data för hela klustret. En av (men inte den enda) utmärkande egenskaperna hos ARDFS är att den inte använder några ytterligare dedikerade servrar under meta och styrning. Detta var ursprungligen tänkt för att förenkla konfigurationen av lösningen och för dess tillförlitlighet.
Lagringsstruktur
Inom alla noder i klustret organiserar ARDFS en logisk pool av hela det tillgängliga diskutrymmet. Det är viktigt att förstå att en pool inte är data eller formaterat utrymme, utan bara en indelning, dvs. alla noder med installerad vAIR som läggs till klustret automatiskt ansluts till den gemensamma ARDFS-poolen och diskinfrastrukturen blir automatiskt gemensam för hela klustret (och tillgänglig för framtida datalagring). Detta tillvägagångssätt gör att noder kan läggas till och tas bort i farten utan att ha något större inflytande på det redan fungerande systemet. Det vill säga, systemet är mycket lätt att skala "sten för sten", genom att lägga till eller ta bort noder i klustret efter behov.
Över ARDFS-poolen läggs virtuella diskar (lagringsobjekt för virtuella maskiner), som byggs upp av virtuella block på 4 megabyte. På de virtuella diskarna lagras data direkt. På nivån av virtuella diskar anges också en schema för fel tolerans.
Som man redan kan gissa, för att uppnå driftssäkerhet i vårt lagringssystem använder vi inte RAID (Redundant array of independent Disks) konceptet utan RAIN (Redundant array of independent Nodes). Det vill säga, driftssäkerheten mäts, automatiseras och hanteras utifrån noder snarare än diskar. Självklart är diskar också en lagringsobjekt, de övervakas liksom allt annat och man kan utföra alla standardoperationer med dem, inklusive att skapa en lokal hårdvaru-RAID, men klustret arbetar med noder.
I en situation där man verkligen vill använda RAID (till exempel, ett scenario som stöder flera fel på små kluster) finns det inget som hindrar att man använder lokala RAID-kontroller och ovanpå bygger ett distribuerat lagringssystem med RAIN-arkitektur. Sådana scenarier är fullt livskraftiga och stödjs av oss, därför kommer vi att berätta om dem i artikeln om typiska användningsscenario för vAIR.
Lagringssystem för driftssäkerhet
Det kan finnas två typer av driftssäkerhetsscheman för virtuella diskar i vAIR:
1) Replikationsfaktor eller helt enkelt replikering – denna metod för driftssäkerhet är enkel "som en pinne och ett rep". Den innebär synkron replikering mellan noder med en faktor av 2 (2 kopior per kluster) eller 3 (3 kopior, respektive). RF-2 gör att den virtuella disken kan klara av ett fel på en nod i klustret, men "äter upp" hälften av det nyttiga utrymmet, medan RF-3 klarar av två noder i klustret, men reserverar redan 2/3 av det nyttiga utrymmet för sina behov. Detta schema påminner mycket om RAID-1, vilket innebär att den virtuella disken konfigurerad i RF-2 är motståndskraftig mot ett fel på vilken som helst av noderna i klustret. I så fall kommer det inte att vara något fel på data och även I/O kommer inte att stoppas. När den felande noden återkommer till drift börjar automatisk återställning/synkronisering av data.
Nedan följer exempel på datadistribution för RF-2 och RF-3 i normalsituationer och vid fel.
Vi har en virtuell maskin med 8 MB unika (användbara) data som körs på 4 noder vAIR. Det är uppenbart att det i verkligheten knappast kommer att vara så lite, men för en skiss som återspeglar logiken av ARDFS är detta exempel mest begripligt. AB – dessa är virtuella block på 4 MB som innehåller unika data från den virtuella maskinen. Vid RF-2 skapas två kopior av dessa block A1+A2 och B1+B2, respektive. Dessa block "distribueras" över noderna, för att undvika överlappning av samma data på en nod, det vill säga att kopian A1 inte kommer att finnas på samma nod som kopia A2. Detsamma gäller för B1 och B2.
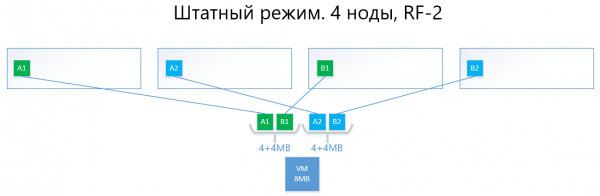
Vid ett avbrott på en av noderna (till exempel nod nr 3 där kopia B1 finns) aktiveras denna kopia automatiskt på den nod där det inte finns en kopia av sin kopia (det vill säga kopia B2).
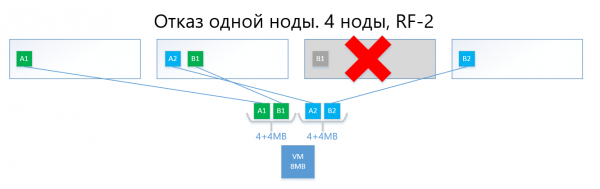
Därmed kommer den virtuella disken (och VM:n, i sin tur) lätt att överleva ett avbrott på en nod i RF-2-systemet.
Replikeringsschemat, trots sin enkelhet och tillförlitlighet, lider av samma problem som RAID1 - lite användbart utrymme.
2) Erasure coding eller raderande kodning (även känt som "överskottskodning", "stärande kodning" eller "redundanskod") finns just för att lösa ovanstående problem. EC – ett överskottsprogram som säkerställer hög datatillgänglighet med lägre kostnad för lagringsutrymme jämfört med replikation. Mekanismen fungerar på liknande sätt som RAID 5, 6, 6P.
Vid kodning delar EC-processen det virtuella blocket (som standard 4 MB) i flera mindre "datafraktioner" beroende på EC-schemat (till exempel delar 2+1-schemat varje 4 MB-block i 2 fraktioner om 2 MB). Därefter genererar processen "paritetsfraktioner" av storlek som inte överstiger en av de tidigare delade delarna. Vid avkodning genererar EC de saknade fraktionerna genom att läsa "överlevande" data i hela klustret.
Till exempel kan en virtuell disk med EC-schema 2+1, implementerad på 4 noder i ett kluster, utan problem hantera ett avbrott på en nod i klustret, precis som RF-2. Här kommer overheaden att vara lägre, särskilt eftersom nyttolasten för RF-2 är 2, medan den för EC 2+1 är 1,5.
För att förklara det enklare handlar det om att det virtuella blocket delas upp i 2-8 (varför från 2 till 8 se nedan) "bitar", och för dessa bitar beräknas "paritetsbitar" av motsvarande storlek.
Som ett resultat fördelas data och paritet jämnt över alla noder i klustret. Precis som vid replikering fördelar ARDFS automatiskt data över noderna så att identiska data (datacopy och dess paritet) inte lagras på samma nod, för att utesluta risken att förlora data på grund av att data och dess paritet plötsligt skulle finnas på en lagringsnod som går sönder.
Nedan ett exempel med samma virtuella maskin på 8 MB och 4 noder, men med EC 2+1.
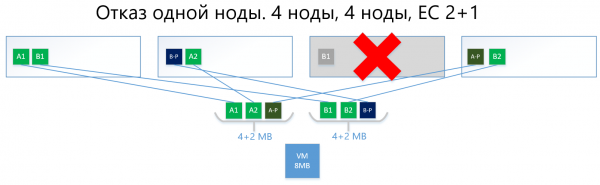
Block A och B delas upp i två bitar vardera på 2 MB (i två eftersom 2+1), det vill säga A1+A2 och B1+B2. Till skillnad från en replik är A1 inte en kopia av A2, utan en virtuell del av block A som delats i två delar, likadant med block B. Totalt får vi två uppsättningar på 4MB, där varje uppsättning innehåller två tvåmegabytes bitar. Sedan beräknas pariteten för varje av dessa uppsättningar med en volym på högst en bit (dvs 2 MB), vilket ger ytterligare + 2 bitar paritet (A-P och B-P). Totalt har vi 4×2 data + 2×2 paritet.
Därefter "sprider" bitarna ut sig över noderna så att data inte överlappar med sin paritet. D.v.s. A1 och A2 kommer inte att finnas på samma nod som A-P.
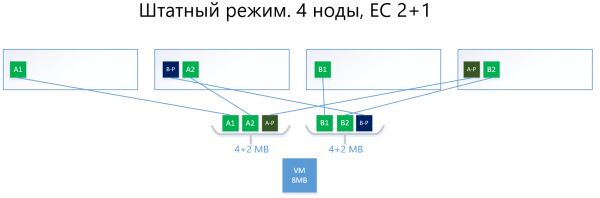
I händelse av att en nod (låtom oss säga den tredje) går ner, kommer den förlorade blocket B1 automatiskt att återställas från pariteten B-P, som lagras på nod nummer 2, och aktiveras på noden där B-pariteten inte finns, dvs delen B-P. I detta exempel är det nod nummer 1.
Jag är säker på att läsaren har en fråga:
"Allt du har beskrivit har länge realiserats av konkurrenter och i open source-lösningar, vad är skillnaden med er implementation av EC i ARDFS?"
Och vidare kommer intressanta funktioner av ARDFS.
Erasure coding med fokus på flexibilitet
Vi har initialt förutsett ett ganska flexibelt EC-schema X+Y, där X är ett tal mellan 2 och 8, och Y är ett tal mellan 1 och 8, men alltid mindre än eller lika med X. Detta schema är avsett för flexibilitet. Ökningen av antalet data bitar (X) som den virtuella blocket delas upp i minskar overheadkostnaderna, det vill säga ökar det användbara utrymmet.
Å andra sidan ökar antalet paritetsbitar (Y) tillförlitligheten av den virtuella disken. Ju högre värde på Y, desto fler noder i klustret kan gå ner. Självklart minskar ökning av paritetsvolymen det användbara lagringsutrymmet, men detta är ett pris för tillförlitlighet.
Prestandan beror nästan direkt på EC-schema: ju fler "bitar", desto lägre prestanda, här krävs en balanserad syn.
Denna metod gör det möjligt för administratörer att konfigurera det distribuerade lagret maximalt flexibelt. Inom ARDFS-poolen kan man använda vilken som helst av redundansscheman och deras kombinationer, vilket vi också tycker är mycket användbart.
Nedan följer en jämförelsetabell mellan flera (inte alla möjliga) RF- och EC-scheman.
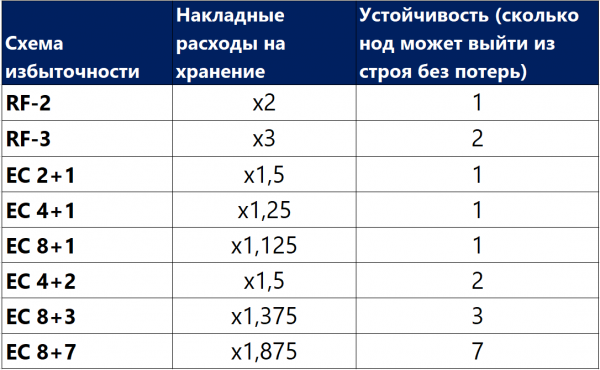
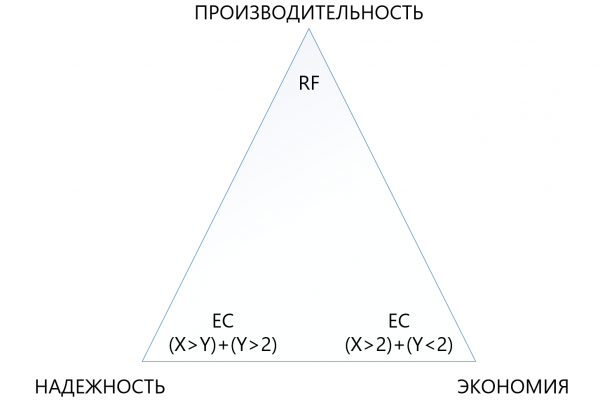
Tabellen visar att även den mest "extrema" kombinationen EC 8+7, som tillåter förlust av upp till 7 noder i klustret samtidigt, "äkrar" mindre användbart utrymme (1,875 mot 2) än standardreplikering, och skyddar sju gånger bättre, vilket gör denna skyddsmekanism, även om den är mer komplex, betydligt mer attraktiv i situationer där maximal tillförlitlighet behöver säkerställas under brist på diskutrymme. Det måste dock förstås att varje "plus" till X eller Y medför en extra prestandakostnad, så i triangel mellan tillförlitlighet, kostnadsbesparing och prestanda måste valet göras mycket noggrant. Av denna anledning kommer vi att ägna en separat artikel åt storlekning av borttagningskodning.
Tillförlitlighet och autonomi i filsystemet
ARDFS körs lokalt på alla noder i klustret och synkroniserar med sina egna medel genom dedikerade Ethernet-gränssnitt. En viktig punkt är att ARDFS själv synkroniserar inte bara data, utan även metadata relaterade till lagring. Under arbetet med ARDFS studerade vi parallellt ett antal befintliga lösningar och upptäckte att många gör synkronisering av metadata i filsystemet med hjälp av en extern distribuerad DBMS, som vi också använder för synkronisering, men endast för konfigurationer, inte metadata i FS (om detta och andra angränsande subsystem i nästa artikel).
Synkronisering av metadata för filsystemet med hjälp av en extern databaslösning är förstås en fungerande metod, men då skulle datakonsistensen som lagras på ARDFS bero på den externa databasen och dess beteende (och den, ska vi säga, är en lite knepig dam), vilket vi anser är dåligt. Varför? Om metadata för filsystemet skulle skadas, skulle även själva data för filsystemet säga "adjö", därför beslutade vi oss för att välja en mer komplex men pålitlig väg.
Vi har själva utvecklat en metadata-synkroniseringssubsystem för ARDFS, och den fungerar helt oberoende av angränsande subsystem. D.v.s. inga andra subsystem kan skada ARDFS-data. Vi anser att detta är den mest pålitliga och korrekta vägen, och om det verkligen är så kommer tiden att visa. Dessutom medför detta tillvägagångssätt en ytterligare fördel. ARDFS kan användas oberoende av vAIR, helt enkelt som en utsträckt lagringslösning, vilket vi utan tvekan kommer att dra nytta av i framtida produkter.
Som ett resultat av att vi har utvecklat ARDFS har vi fått ett flexibelt och pålitligt filsystem som ger möjlighet att spara på kapaciteten eller satsa allt på prestanda, eller att göra lagringslösningen supersäker till ett rimligt pris men med minskade prestandakrav.
Tillsammans med en enkel licenspolicy och en flexibel distributionsmodell (för att förskjuta, licensieras vAIR per nod och levereras antingen som mjukvara eller som en paketlösning) gör detta att man kan skräddarsy lösningen mycket noggrant för olika kundbehov, och sedan lätt upprätthålla denna balans.
Vem behöver detta underverk?
Å ena sidan kan man säga att det redan finns aktörer på marknaden med seriösa lösningar inom hyperkonvergens, och vad är det vi egentligen gör? Det verkar som om detta påstående är sant, MEN...
Å andra sidan, när vi går "ut i fält" och pratar med kunder ser vi, liksom våra partners, att så inte är fallet. Det finns många behov för hyperkonvergens; på vissa ställen visste folk bara inte att sådana lösningar existerade, på andra ställen verkade det dyrt, i vissa fall har alternativlösningar misslyckats, och i andra fall är inköp helt enkelt förbjudna på grund av sanktioner. Det hela visade sig vara en obearbetad mark, så vi beslutade oss för att bryta ny mark))).
När är HCI bättre än SDS?
I arbetet med marknaden får vi ofta frågan om när man bäst bör använda den klassiska modellen med lagringssystem, och när man ska övergå till hyperkonvergerande lösningar? Många företag som tillverkar HCI (särskilt de utan lagringssystem i sitt sortiment) säger: "Lagringssystemets tid är förbi, hyperkonvergerande only!". Detta är ett djärvt uttalande, men det speglar inte helt verkligheten.
Ärligt talat är marknaden för lagringssystem verkligen på väg mot hyperkonvergerade lösningar, men det finns alltid en "men".
För det första kan inte befintliga datacenter och IT-infrastrukturer, som byggts efter den klassiska modellen med lagringssystem, enkelt omstruktureras, så uppgradering och utbyggnad av sådana infrastrukturer är ett arv som kommer att finnas kvar i 5-7 år till.
För det andra byggs de infrastrukturer som skapas just nu (med avseende på Ryssland) mestadels enligt den klassiska modellen med användning av lagringssystem, inte för att människor inte känner till hyperkonvergerande lösningar, utan för att marknaden för hyperkonvergerande lösningar är ny, lösningar och standarder har ännu inte stabiliserats, IT-specialister är fortfarande inte utbildade, erfarenheten är begränsad, och datacenter måste byggas här och nu. Denna trend kommer att bestå i ytterligare 3-5 år (plus ett arv, se punkt 1).
För det tredje finns det rent tekniska begränsningar i form av ytterligare små fördröjningar på 2 millisekunder vid skrivning (utan att ta hänsyn till lokal cache, så klart), som är priset för distribuerad lagring.
Och vi får inte glömma användningen av stora fysiska servrar, som föredrar vertikal skalning av lagringssystemet.
Det finns många viktiga och populära uppgifter där lagringssystem fungerar bättre än HCI. Självklart kommer de tillverkare som inte har lagringssystem i sitt produktutbud inte att hålla med oss, men vi är beredda att argumentera för vår sak. Självklart kommer vi, som utvecklare av båda produkterna, i en av våra framtida publikationer att göra en jämförelse mellan lagringssystem och HCI, där vi tydligt visar vilka förhållanden som är bäst för respektive lösningar.
Och var kommer hyperkonvergerande lösningar att fungera bättre än lagringssystem?
Baserat på de ovanstående teserna kan man dra tre uppenbara slutsatser:
- Där ytterligare 2 millisekunders fördröjning vid skrivning, som stabilt uppstår i alla produktionsmiljöer (nu handlar det inte om syntetiska test, där man kan visa nanosekunder), är icke-kritiska, kan hyperkonvergerande lösningar passa.
- Där belastningen från stora fysiska servrar kan omvandlas till många små virtuella och fördelas över noder, där passar hyperkonvergens bra.
- Där horisontell skalning är mer prioriterad än vertikal, där kommer GKS att fungera utmärkt.
Vilka är dessa lösningar?
- Alla standardinfrastrukturtjänster (katalogtjänst, e-post, DMS, filservrar, små eller medelstora ERP och BI-system, mm). Vi kallar detta "gemensamma beräkningar".
- Infrastrukturen hos molnleverantörer där det är nödvändigt att snabbt och standardiserat skala horisontellt och lätt "skära" ett stort antal virtuella maskiner för kunder.
- Infrastruktur virtuella skrivbord (VDI), där många små användarvirtualer startas och fritt "flyter" inom en enhetlig kluster.
- Filialnätverk där varje filial behöver en standardiserad, redundanta men ändå kostnadseffektiv infrastruktur av 15-20 virtuella maskiner.
- Vilka distributerade beräkningar som helst (såsom big data-tjänster). Där belastningen inte går "nedåt", utan "utåt".
- Testmiljöer där små extra fördröjningar är acceptabla, men det finns budgetbegränsningar eftersom detta är tester.
För tillfället har vi skapat AERODISK vAIR för dessa uppgifter, och vi fokuserar på dem (framgångsrikt hittills). Kanske kommer detta att ändras snart, eftersom världen inte står stilla.
Så…
Den första delen av en stor artikelcykel avslutas här, i nästa artikel kommer vi att berätta om arkitekturen för lösningen och de använda komponenterna.
Vi ser fram emot frågor, förslag och konstruktiva diskussioner.
Källa: habr.com
