

Ämnet om stora olyckor i moderna datacenter väcker frågor som inte besvarades i den första artikeln — vi har beslutat att utveckla detta ämne.
Om man ska tro statistiken från Uptime Institute, så är den största delen av incidenterna i datacenter kopplade till kraftförsörjningsfel — de utgör 39 % av händelserna. På andra plats kommer den mänskliga faktorn — ytterligare 24 % av olyckorna. Tredje mest betydelsefulla orsaken (15 %) var fel på kylsystemet, och på fjärde plats (12 %) kom naturkatastrofer. Den sammanlagda andelen av övriga problem utgör endast 10 %. Utan att ifrågasätta uppgifterna från den respektabla organisationen, låt oss identifiera något gemensamt i de olika olyckorna och försöka förstå om de kunde ha undvikits. Spoiler: i de flesta fall kunde de det.
Vetenskapen om kontakter
Förenklat kan man säga att det finns två problem med elkraft: antingen finns det ingen kontakt där det borde finnas, eller så finns det en kontakt där det inte borde vara någon. Man kan resonera länge om pålitligheten hos moderna system för oavbruten strömförsörjning, men de räddar långt ifrån alltid situationen. Ta till exempel det uppmärksammade fallet med den datacenter som British Airways använde, vilket tillhör moderbolaget International Airlines Group. I närheten av Heathrow flygplats ligger två sådana anläggningar — Boadicea House och Comet House. I det första skedde en oavsiktlig strömavbrott den 27 maj 2017, vilket ledde till överbelastning och fel på UPS-systemet. Resultatet blev att en del IT-utrustning skadades fysiskt, och det tog tre dagar att åtgärda den senaste olyckan.
Flygbolaget tvingades att ställa in eller omplanera mer än tusen flygningar, omkring 75 000 passagerare kunde inte flyga i tid — kostnaden för ersättningarna blev 128 miljoner dollar, utan att räkna med de kostnader som krävdes för att återställa datacenters funktion. Historien om orsakerna till strömavbrottet är otydlig. Om man ska tro resultaten av den interna utredning som delades av VD:n för International Airlines Group, Willie Walsh, berodde det på ett misstag av ingenjörerna. Ändå borde systemet för oavbruten strömförsörjning ha klarat ett sådant avbrott — det är just därför det är installerat. Datacentret leddes av specialister från det outsourcade företaget CBRE Managed Services, så British Airways försökte kräva skadestånd genom Londons domstol.
Eliminering av kraftavbrott sker vanligtvis enligt liknande scenarier: först sker en avstängning på grund av elproducentens fel, ibland på grund av dåligt väder eller interna problem (inklusive personalfel), och sedan klarar inte den oavbrutna strömförsörjningen av belastningen, eller kortvariga sinusavbrott orsakar avbrott i många tjänster, vilket kräver en enorm mängd tid och pengar för att återställa funktionaliteten. Går det att förhindra sådana avbrott? Självklart. Om man utformar systemet korrekt, dock är ingen immun mot misstag, inte ens skaparna av stora datacenter.
Den mänskliga faktorn
När den omedelbara orsaken till en incident är felaktiga handlingar från datacenterpersonal drabbas oftast (men inte alltid) den mjukvarubaserade delen av IT-infrastrukturen. Sådana avbrott inträffar även i stora företag. I februari 2017 stängdes en del servrar hos Amazon Web Services av på grund av felaktigt inmatad kommando av en medlem i den tekniska driftgruppen i ett av datacenter. Felet inträffade under felsökningen av faktureringsprocessen för kunder av Amazons molnlagringstjänst Amazon Simple Storage Service (S3). En anställd försökte ta bort en viss mängd virtuella servrar som användes av faktureringssystemet, men av misstag rörde han ett större kluster.
Som ett resultat av teknikerens misstag raderades servrar som körde viktiga programmoduler av Amazons molnlagringslösning. Först drabbades indexeringssubsystemet, som innehöll information om metadata och platsen för alla S3-objekt i den amerikanska regionen US-EAST-1. Incidenten påverkade också det subsystem som användes för lagring och hantering av tillgänglig lagringskapacitet. Efter att de virtuella maskinerna raderats krävde dessa två subsystem en fullständig omstart, och ingenjörer hos Amazon ställdes inför en överraskning — under en längre tid kunde det offentliga molnlagringssystemet inte hantera kundernas förfrågningar.
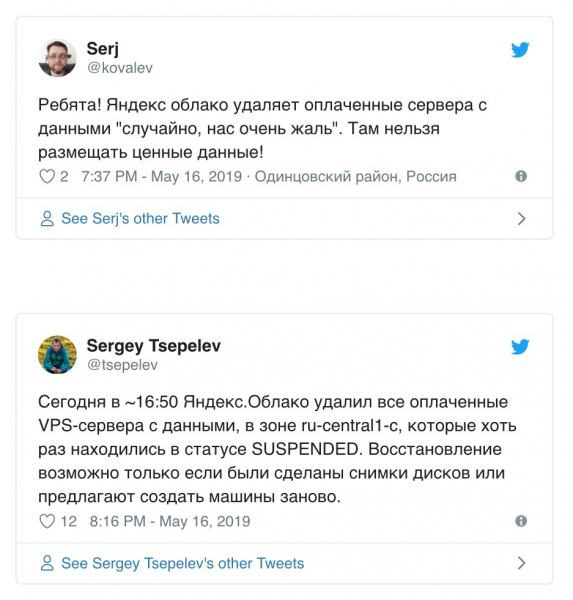
Effekten visade sig vara omfattande, eftersom många stora resurser använder Amazon S3. Driftstörningar drabbade Trello, Coursera, IFTTT och, mest besvärande, tjänster från stora partners till Amazon på S&P 500-listan. Att beräkna skadan i sådana fall är inte enkelt, men den ligger i storleksordningen hundratals miljoner USD. Som ni kan se, för att slå ut en tjänst från den största molnplattformen räcker det med en felaktig kommando. Det är inte en engångsföreteelse; den 16 maj 2019 under underhållsarbete på tjänsten Yandex.Cloud virtuella maskiner för användare i zonen ru-central1-c, som någonsin varit i status SUSPENDED. Här har kunddata redan drabbats, en del av vilken har gått förlorad för alltid. Självklart är människor ofullkomliga, men moderna informationssäkerhetssystem kan redan kontrollera privilegierade användares handlingar innan de utför de kommandon de anger. Om sådana lösningar infördes i Yandex eller Amazon skulle liknande incidenter kunna undvikas.
Frostskadad kylning
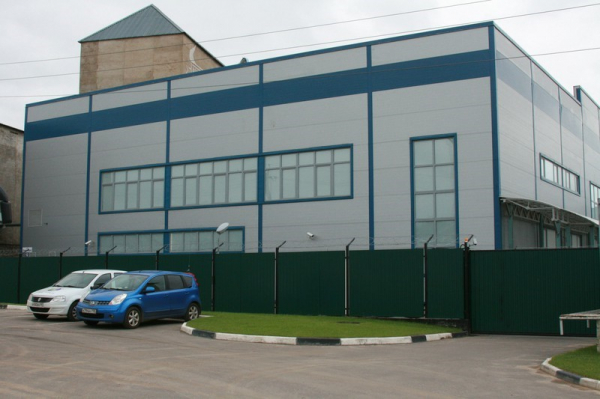
I januari 2017 inträffade en stor olycka i Dmitrov-datanämnden hos företaget "Megafon". Då sjönk temperaturen i Moskva-regionen till -35 °C, vilket ledde till att kylsystemet i anläggningen slutade fungera. Pressavdelningen för operatören var särskilt tyst om orsakerna till incidenten – ryska företag är extremt ovilliga att tala om olyckor på sina anläggningar, rent publikt ligger vi långt efter väst. Det fanns en teori på sociala medier om att kylvätskan frös i rören som förlades i gatan och att etylenglykol läckte ut. Om man ska tro på den, kunde driftavdelningen inte snabbt få 30 ton kylmedel på grund av långa helger och kämpade sig igenom med improviserade lösningar, genom att organisera en tillfällig frikylning med brott mot driftsregler. De akuta kylan försämrade situationen — i januari inträffade plötsligt en vinter i Ryssland, vilket ingen hade förväntat sig. Slutresultatet blev att personalen tvingades stänga av strömmen till delar av serverställena, vilket ledde till att vissa av operatörens tjänster var otillgängliga i två dagar.
Det är troligt att man kan tala om en väderanomalitet här, men sådana köldgrader är inte ovanliga för huvudstadsregionen. Temperaturen på vintern i Moskvaområdet kan falla till ännu lägre nivåer, så datacenter byggs med tanke på att de ska fungera stabilt vid −42°С. Oftast sviker kylsystemen i kylan på grund av otillräcklig koncentration av glykol och överskott av vatten i kylvätskan. Det kan också uppstå problem med rörinstallationer eller med beräkningar i utformningen och testningen av systemet, som ofta är relaterade till besparingsåtgärder. Resultatet blir allvarliga olyckor som man helt klart skulle kunna ha undvikit.
Naturkatastrofer
Oftast stör åskväder och/eller orkaner infrastrukturen i datacentret, vilket leder till stopp i tjänster och/eller fysisk skada på utrustningen. Incidenter orsakade av dåligt väder inträffar ganska ofta. År 2012 drabbades västkusten i USA av orkanen Sandy som medförde kraftigt regn. Det datacenter som ligger i en höghusbyggnad i nedre Manhattan, Peer 1, , efter att saltvatten översvämmade källarutrymmena. Nödgeneratorerna var placerade på 18:e våningen, och bränslelagret för dem var begränsat — regler som infördes i New York efter attackerna den 11 september förbjuder lagring av stora mängder bränsle på högre våningar.
Bränslepumpen fungerade också inte, så personalen fick manuellt bära diesel till generatorerna i flera dagar. Teamets hjältemod räddade datacentret från en allvarlig olycka, men var det verkligen nödvändigt? Vi lever på en planet med en kväve-syrgasatmosfär och mycket vatten. Åskväder och orkaner är ganska vanliga här (särskilt i kustområden). Troligtvis borde ingenjörerna ha beaktat de risker som är förknippade med detta och byggt ett lämpligt system för oavbruten elförsörjning. Eller åtminstone valt en mer lämplig plats för datacentret än en skyskrapa på en ö.
Allt annat
I denna kategori identifierar Uptime Institute en mängd olika incidenter, där det är svårt att välja en typisk. Stöld av kopparkablar, intrång i datacenter, stödpunkter för högspänd elektrisk ledning och transformatorstationer, bilar, bränder som skadar optiska kablar av grävmaskiner, gnagare (råttor, kaniner och till och med vombater, som egentligen tillhör pungdjuren), samt entusiaster som övar på att skjuta på ledningar — menyn är omfattande. Strömavbrott kan även orsakas av el från en olaglig marijuanaodling. I de flesta fall blir enskilda personer ansvariga för incidenten, dvs. vi har återigen att göra med den mänskliga faktorn, där problemet har ett namn och efternamn. Även om olyckan vid första anblick kan verka kopplad till tekniska fel eller naturkatastrofer, kan den undvikas med korrekt design av objektet och rätt användning. Undantag görs endast för fall av kritiska skador på datacenters infrastruktur eller förstörelse av byggnader och anläggningar på grund av naturkatastrofer. Detta är verkligen force majeure, och alla andra problem orsakas av avståndet mellan datorn och stolen — kanske den mest opålitliga delen av ett komplext system.
Källa: habr.com
