

3. Alternativ strukturer vid användning av globala variabler
En sådan struktur som ett ordnat träd har olika specifika fall. Låt oss överväga de som har praktiskt värde vid arbete med globala variabler.
3.1 Specifikt fall 1. En nod utan grenar
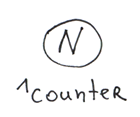 Globala variabler kan användas inte bara som en array, utan även som vanliga variabler. Till exempel som en räknare:
Set ^counter = 0  ; ställa in räknaren
Set id=$Increment(^counter) ;  atomär inkrementering
I det här fallet kan den globala variabeln, förutom värdet, även ha grenar. Det ena utesluter inte det andra.
3.2 Specifikt fall 2. En topp och många grenar
Detta är i allmänhet en klassisk key-value databas. Om vi sparar en tuple av värden som värde, får vi en helt vanlig tabell med en primärnyckel.
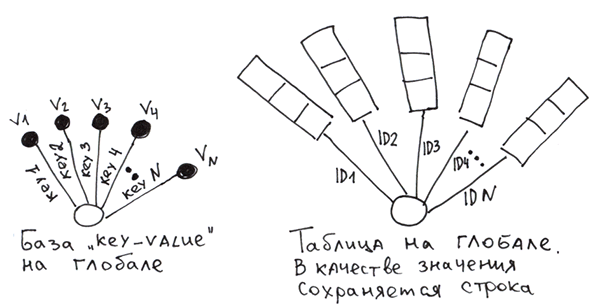
För att implementera en tabell på globala variabler måste vi själva skapa strängar av kolumnernas värden och sedan spara dem i den globala variabeln med primärnyckeln. För att kunna separera strängen tillbaka till kolumner vid läsning kan man använda:
- avgränsande tecken.
Set ^t(id1) = "col11/col21/col31" Set ^t(id2) = "col12/col22/col32" - en strikt schema, där varje fält tar en förutbestämd mängd byte. Precis som det görs i relationella databaser.
- en speciell funktion $LB (finns i Cache) som bildar en sträng av värden.
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^t(id2) = $LB("col12", "col22", "col32")
Intressant nog är det inte svårt att skapa något liknande sekundära index i relationella databaser på globala variabler. Låt oss kalla sådana strukturer indexglobala variabler. En indexglobal variabel är ett hjälpbjälke för snabb sökning baserat på fält som inte är en del av den primära nyckeln för den huvudsakliga globala variabeln. För att fylla och använda den måste man skriva ytterligare kod.
Låt oss skapa en indexglobal variabel baserat på den första kolumnen.
Set ^i("col11", id1) = 1
Set ^i("col12", id2) = 1
Nu, för att snabbt söka efter information i den första kolumnen, behöver vi titta i den globala variabeln ^i och hitta de primära nycklarna (id) som motsvarar det önskade värdet i den första kolumnen.
Vid insättning av värden kan vi omedelbart skapa både värdet och indexglobala variabler för de nödvändiga fälten. Och för tillförlitlighet ska vi omsluta allt i en transaktion.
TSTART
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^i("col11", id1) = 1
TCOMMIT
Detaljer om hur man gör på M , .
Tabeller som dessa kommer att fungera lika snabbt som i traditionella databaser (eller till och med snabbare), om man skriver in-funktioner / uppdaterings- / raderingsfunktioner i COS / M och kompilera dem.Jag har verifierat detta påståendet genom tester av massiva INSERT- och SELECT-operationer i en tvåkolumnig tabell, inklusive användning av kommandon TSTART och TCOMMIT (transaktioner).
Jag har inte testat mer komplexa scenarier med samtidig åtkomst och paralella transaktioner.
Utan att använda transaktioner var hastigheten för insättningar vid en miljon värden 778 361 insättningar / sekund.
Vid 300 miljoner värden — 422 141 insättningar / sekund.
Vid användning av transaktioner — 572 082 insättningar / sekund på 50M insättningar. Alla operationer utfördes från den kompilerade M-koden.
Vanliga hårddiskar, inte SSD. RAID5 med Write-back. Processor Phenom II 1100T.
För liknande test av SQL-databasen behöver man skriva en lagrad procedur som i en loop gör insättningar. Vid testning av MySQL 5.5 (lagring InnoDB) med denna metod fick jag siffror på högst 11K insättningar per sekund.
Ja, implementeringen av tabeller på globala resurser ser mer komplex ut än i relationella databaser. Därför har industriella databaser på globala resurser SQL-åtkomst för att förenkla arbetet med tabulär data.
 Om datamodellen inte kommer att förändras ofta, är insättningshastigheten inte kritisk och hela databasen kan lätt representeras som normaliserade tabeller, är det enklare att arbeta med just SQL, eftersom det ger en högre abstraktionsnivå.
 I detta specifika fall ville jag visa att globala resurser kan fungera som en konstruktor för att skapa andra databaser. Som assembler som man kan skriva andra språk på. Här är exempel på hur man kan skapa analoger på globala resurser
Om man behöver skapa någon icke-standarddatabas med minimal ansträngning, bör man titta mot globala resurser.
3.3 Specifikt fall 3. Tvånivåträd, där varje nod på andra nivån har ett fast antal grenar
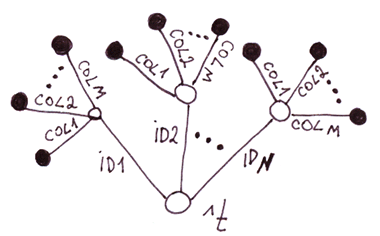 Ni har förmodligen gissat: detta är ett alternativt genomförande av tabeller på globala resurser. Låt oss jämföra detta genomförande med det tidigare.
Tabeller på ett tvånivåträd vs. ett ennivåträd.
Nackdelar
Fördelar
- Långsammare vid insättning, eftersom antalet noder måste ställas in till antalet kolumner.
- Mer diskanvändning. Eftersom globala index (i betydelse som index för arrayer) med kolumnnamn tar upp plats på disken och dupliceras för varje rad.
- Snabbare åtkomst till värden i individuella kolumner, eftersom det inte behövs någon parsing av raden. Enligt mina tester är det snabbare med 11,5% för 2 kolumner och mer med ett större antal kolumner.
- Enklare att ändra dataskeman
- Tydligare kod
Slutsats: även om det är en smaksak. Eftersom hastighet är en av de viktigaste fördelarna med globala index, finns det nästan ingen poäng med att använda denna implementation, eftersom den troligtvis inte kommer att vara snabbare än tabeller i relationsdatabaser.
3.4 Allmänna fall. Träd och ordnade träd
All struktur av data som kan representeras som ett träd passar perfekt för globala index.
3.4.1 Objekt med delobjekt
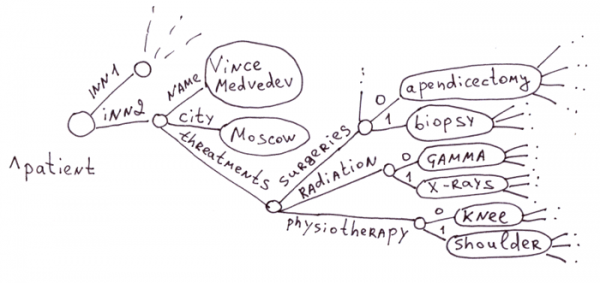
Detta är den traditionella tillämpningsområdet för globala index. Inom sjukvården finns ett stort antal sjukdomar, mediciner, symptom och behandlingsmetoder. Att skapa en tabell för varje patient med en miljon fält är oekonomiskt. Speciellt eftersom 99% av fälten kommer att vara tomma.
Föreställ dig en SQL-databas med tabeller: "patient" ~ 100 000 fält, "medicin" - 100 000 fält, "terapi" - 100 000 fält, "komplikationer" - 100 000 fält osv. Alternativt kan man skapa en databas av tusentals tabeller, var och en för en specifik typ av patient (de kan överlappa!), behandling, medicin, och ytterligare tusentals tabeller för relationer mellan dessa tabeller.
Globala index passar perfekt för medicin, eftersom de gör det möjligt att skapa en noggrann beskrivning av varje patients sjukdomshistorik, olika terapier och läkemedelsverkan, i form av ett träd, utan att slösa onödig diskplats på tomma kolumner, som det skulle vara i ett relationsfall.
 Det är enkelt att skapa databaser med information om människor med globala index, när det är viktigt att samla in och systematisera så mycket olika information som möjligt om klienten. Detta är efterfrågat inom medicin, bankverksamhet, marknadsföring, arkivhantering och andra områden.
.
Självklart kan man också emulera ett träd i SQL med endast några tabeller (, ,,,,,,,,,), men det är mycket mer komplicerat och kommer att fungera långsammare. I själva verket skulle man behöva skriva globala funktioner som fungerar på tabeller och dölja allt arbete med tabeller under ett lager av abstraktion. Det är fel att emulera en lägre nivåsteknologi (globaler) med hjälp av en högre nivåsteknologi (SQL). Oekonomiskt.
Det är ingen hemlighet att ändra databasstrukturen på gigantiska tabeller (ALTER TABLE) kan ta en anständig tid. MySQL, till exempel, gör ALTER TABLE ADD|DROP COLUMN genom att kopiera all information från den gamla till den nya tabellen (jag har testat motorer som MyISAM, InnoDB). Detta kan stänga ner en arbetsdatabas med miljarder poster i dagar, om inte veckor.
 Att ändra databasstrukturen, om vi använder globaler, kostar oss ingenting. När som helst kan vi lägga till alla nödvändiga nya egenskaper till vilket objekt som helst, på vilken nivå av hierarkin som helst. Ändringar som rör omdöpning av grenar kan köras i bakgrunden på en aktiv databas.
Därför är globaler ett utmärkt val när det gäller lagring av objekt med en stor mängd valfria egenskaper.
Och jag påminner om att tillgången till varje egenskap är omedelbar, eftersom alla vägar i globalen representerar ett B-träd.
Databaser i globaler är i allmänhet en typ av dokumentorienterade databaser, med möjlighet till lagring av hierarkisk information. Därför kan dokumentorienterade databaser konkurrera med globaler inom området lagring av medicinska kort. Men det är fortfarande inte riktigt det.Låt oss ta, till exempel, MongoDB som en jämförelse. I detta område förlorar den mot globaler av följande skäl:
- Dokumentets storlek. Lagrenheten är text i JSON-format (eller snarare BSON) med en maximal storlek på cirka 16 MB. Begränsningen är gjord avsiktligt för att JSON-databasen inte ska bli långsam vid parsning, om den lagrar ett stort JSON-dokument och senare kommer att åtkomma det via fält. I detta dokument bör all information om patienten vara koncentrerad. Vi vet alla hur tjocka patientkort kan vara. Den maximala storleken på 16 MB sätter snabbt stopp för patienter vars sjukdomskort innefattar MRT-filer, röntgenbilder och andra studier. I en gren av en global kan man dock ha information på gigabytes och terabytes. I princip skulle man kunna sätta punkt här, men jag fortsätter.
- Tiden för medvetenhet/ändring/borttagning av nya egenskaper i patientkortet. En sådan databas måste ladda hela patientkortet i minnet (vilket är en stor mängd!), analysera BSON, lägga till/ändra/ta bort en ny nod, uppdatera index, packa i BSON och spara på disk. Globalen behöver å sin sida bara referera till en specifik egenskap och utföra manipulationer med den.
- Åtkomsthastighet till individuella egenskaper. Vid många egenskaper i dokumentet och dess flernivåstruktur kommer åtkomsten till individuella egenskaper att vara snabbare eftersom varje väg i globalen är en B-tree. I BSON måste dokumentet analyseras linjärt för att hitta den erforderliga egenskapen.
3.3.2 Associativa arrayer
Associativa arrayer (även med inbäddade arrayer) passar utmärkt för globaler. Till exempel kommer en sådan array från PHP att visas i den första bilden 3.3.1.
$a = array(
  "name" => "Vince Medvedev",
  "city" => "Moscow",
  "threatments" => array(
    "surgeries" => array("apedicectomy", "biopsy"),
    "radiation" => array("gamma", "x-rays"),
    "physiotherapy" => array("knee", "shoulder")
  )
);
3.3.3 Hierarkiska dokument: XML, JSON
Dessa lagras också enkelt i globaler. För lagring kan ordnas på olika sätt.
XML
Det enklaste sättet att ordna XML i globaler är när vi lagrar taggens attribut i noder. Om snabb åtkomst till taggens attribut behövs kan vi lägga ut dem i separata grenar.
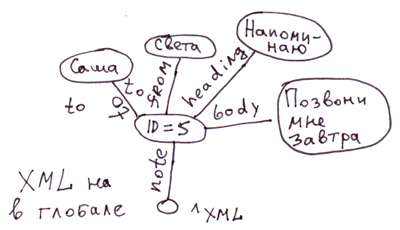
<note id="5">
<to>Vasya</to>
<from>Svetlana</from>
<heading>Påminnelse</heading>
<body>Ring mig imorgon!</body>
</note>
I COS kommer koden att se ut så här:
Set ^xml("note")="id=5"
Set ^xml("note","to")="Sasha"
Set ^xml("note","from")="Sveta"
Set ^xml("note","heading")="Påminnelse"
Set ^xml("note","body")="Ring mig imorgon!"
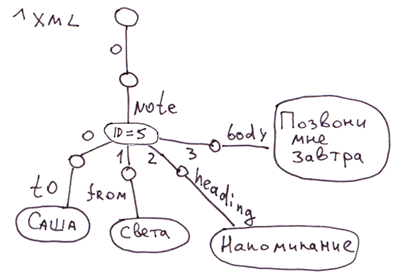
Anmärkning: För XML, JSON, associativa arrayer kan många olika sätt att representera dem i globaler hittas. I detta fall har vi inte återgivit ordningen av inbäddade taggar i taggen note. I globalen ^xml inbäddade taggar kommer att visas i alfabetisk ordning. För att strikt återge ordningen kan ett sådant arrangemang användas:
JSON.
Den första bilden i avsnitt 3.3.1 visar återgivningen av detta JSON-dokument:
var document = {
  "name": "Vince Medvedev",
  "city": "Moscow",
  "treatments": {
    "surgeries": ["apedicectomy", "biopsy"],
    "radiation": ["gamma", "x-rays"],
    "physiotherapy": ["knee", "shoulder"]
  },
};
3.3.4 Liknande strukturer kopplade med hierarkiska relationer
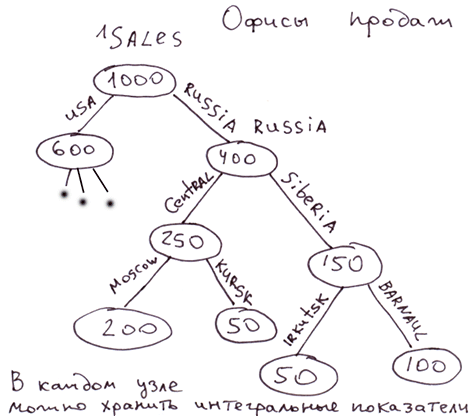
Exempel: struktur av försäljningskontor, positionering av människor i MLM-struktur, databas av schacköppningar.
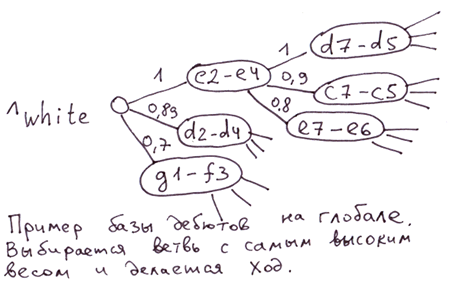
Databas av öppningar. Som man kan använda nodindex för globaler är bedömningen av dragstyrkan. Då räcker det att välja grenen med högst vikt för att välja det starkaste draget. I globalen kommer alla grenar på varje nivå att sorteras efter dragets styrka.
Strukturen för försäljningskontor, strukturen för människor i MLM. I noder kan man lagra vissa cachade värden som reflekterar egenskaperna hos hela underträdet. Till exempel försäljningsvolymen för detta underträd. Vid vilken tidpunkt som helst kan vi få en siffra som visar prestationerna för vilken gren som helst.
4. I vilka fall är det mest lönsamt att använda globaler.
I den första kolumnen presenteras fall där du får betydande vinster i hastighet genom att använda globaler, och i den andra när utvecklingen eller datamodellen förenklas.
Hastighet
Bekvämlighet vid hantering/visning av data.
- Infogning [med automatisk sortering på varje nivå], [indexering efter huvudnyckel].
- Borttagning av underträd.
- Objekt med en mängd inbäddade egenskaper som kräver individuell åtkomst.
- Hierarkisk struktur med möjlighet att traversera dottergrenar från vilken gren som helst, även om den inte existerar.
- Traversering av underträd i djupet.
- Objekt/entiteter med ett enormt antal valfria [och/eller inbäddade] egenskaper/entiteter.
- Schemafria data. När nya egenskaper ofta kan tillkomma och gamla försvinna.
- Det behövs för att skapa en icke-standard databas.
- Stigenät och beslutsträd. När vägar är lämpliga att representera som träd.
- Borttagning av hierarkiska strukturer utan att använda rekursion.
Fortsättning .
Ansvarsfriskrivning: Denna artikel och mina kommentarer till den är min åsikt och har ingen koppling till företagets officiella ställning, InterSystems.
Källa: habr.com
