

Om man använder en tidsseriedatabas (timeseries db, ) som huvudsakligt lagringsutrymme för en webbplats med statistik, kan man istället för att lösa problemet få mycket huvudvärk. Jag arbetar med ett projekt där en sådan databas används, och ibland har InfluxDB, som vi kommer att diskutera, bjudit på helt oväntade överraskningar.
Ansvarsfriskrivning: de angivna problemen gäller version InfluxDB 1.7.4.
Varför tidsserie?
Projektet handlar om att spåra transaktioner i olika blockkedjor och visa statistik. Specifikt — vi ser på emission och bränning av stablecoins (). Baserat på dessa transaktioner måste vi bygga diagram och visa sammanfattningstabeller.
Vid analysen av transaktionerna kom tanken att använda tidsseriedatabasen InfluxDB som huvudsakligt lagringsutrymme. Transaktionerna är punkter i tid och passar väl in i tidsseriemodellen.
Aggregationens funktioner verkade också mycket praktiska — de passar perfekt för att bearbeta diagram över längre perioder. Användaren behöver ett diagram för året, men i databasen finns en dataset med fem minuters tidsram. Att skicka alla hundratusen punkter är meningslöst — förutom den långa behandlingen får det inte ens plats på skärmen. Man kan skriva sin egen implementation för att öka tidsramen, eller använda de inbyggda aggregationsfunktionerna i Influx. Med hjälp av dem kan vi gruppera data per dag och skicka de 365 nödvändiga punkterna.
Det kändes lite förvirrande att sådana databaser vanligtvis används för att samla in mätvärden. Övervakning av servrar, IoT-enheter, allt som "flödar" in miljontals punkter av typen: [<tidsstämpel> — <måttvärde>]. Men om databasen fungerar bra med stora datamängder, varför skulle ett litet antal orsaka problem? Med den tanken tog vi InfluxDB i bruk.
Vad som är mer praktiskt med InfluxDB
Förutom de nämnda aggregationsfunktionerna finns det också en fantastisk sak — kontinuerliga frågor (). Det är en inbyggd schemaläggare i databasen som kan bearbeta data enligt schema. Till exempel kan man gruppera alla poster för dagen var 24:e timme, beräkna medelvärdet och skriva en ny punkt i en annan tabell utan att behöva skriva egna lösningar.
Det finns också bevarande policyer () — inställning för att radera data efter en viss period. Användbart när man till exempel vill lagra CPU-belastningen under en vecka med mätningar varje sekund, men för en tidsperiod på några månader är denna precision inte nödvändig. I en sådan situation kan man göra såhär:
- skapa en kontinuerlig fråga för att aggregera data till en annan tabell;
- för den första tabellen definiera en politik för att radera mätvärden som är äldre än just den veckan.
Och Influx kommer självständigt att minska datastorleken och radera det onödiga.
Om de lagrade data
Det finns inte mycket data: cirka 70 000 transaktioner och ytterligare en miljon punkter med marknadsinformation. Nyinläggning av poster — högst 3000 punkter per dag. Det finns också mätvärden för webbplatsen, men där är datan begränsad och enligt retention-policy lagras de högst en månad.
Problem
Under utvecklingen och efterföljande test av tjänsten uppstod det allt mer kritiska problem med driften av InfluxDB.
1. Raderingsproblem
Det finns en serie data med transaktioner:
SELECT time, amount, block, symbol FROM transactions WHERE symbol='USDT'Resultatet:
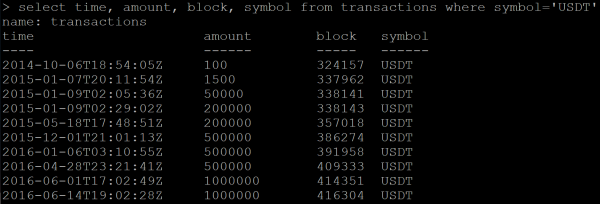
Jag skickar kommandot för att radera data:
DELETE FROM transactions WHERE symbol='USDT'Därefter gör jag en förfrågan för att få tillbaka redan raderade data. Och Influx istället för ett tomt svar returnerar delar av de data som borde ha raderats.
Jag försöker radera hela tabellen:
DROP MEASUREMENT transactionsJag kontrollerar raderingen av tabellen:
SHOW MEASUREMENTSJag ser inte tabellen i listan, men den nya datan returnerar fortfarande samma uppsättning transaktioner.
Problemet uppstod bara en gång för mig, eftersom fallet med radering är unikt. Men detta beteende av databasen passar tydligt inte inom ramen för ”korrekt” drift. Senare hittade jag ett öppet från nästan ett år sedan om detta ämne.
Som ett resultat, hjälpte det att radera och sedan återställa hela databasen.
2. Flyttal
Matematiska beräkningar med inbyggda funktioner i InfluxDB ger noggrannhetsfel. Inte så att det är något ovanligt, men det är obehagligt.
I mitt fall har datan en finansiell komponent och jag skulle vilja bearbeta dem med hög precision. På grund av det överväger jag att överge kontinuerliga frågor.
3. Kontinuerliga frågor kan inte anpassas till olika tidszoner
Tjänsten har en tabell med daglig statistik över transaktioner. För varje dag behöver alla transaktioner för den dagen grupperas. Men dagen börjar vid olika tidpunkter för varje användare, vilket innebär att uppsättningen av transaktioner också är olika. Enligt UTC finns det för förskjutning, för vilka data måste aggregeras.
I InfluxDB kan du vid tidsgruppering dessutom ange en förskjutning, till exempel för Moskvatid (UTC+3):
SELECT MEAN("supply") FROM transactions GROUP BY symbol, time(1d, 3h) fill(previous)Men resultatet av frågan kommer att vara inkorrekt. Av någon anledning börjar de grupperade dagliga data så tidigt som 1677, då InfluxDB officiellt stöder tidsintervallet från det året:
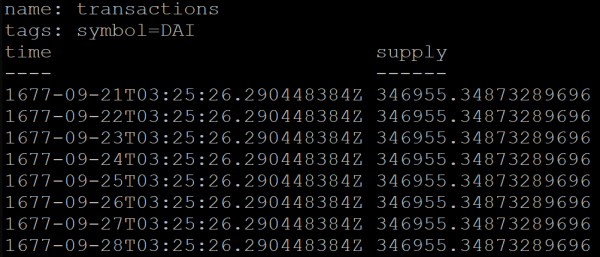
För att kringgå detta problem har tjänsten tillfälligt överfört till UTC+0.
4. Prestanda
Det finns många benchmarktester på nätet som jämför InfluxDB med andra databaser. Vid första ögonkastet verkade de vara marknadsföringsmaterial, men nu anser jag att det finns en del sanning i dem.
Jag berättar om mitt fall.
Tjänsten tillhandahåller en API-metod som returnerar statistik för de senaste 24 timmarna. Vid beräkningarna gör metoden tre anrop till databasen med följande frågor:
SELECT * FROM coins_info WHERE time <= NOW() GROUP BY symbol ORDER BY time DESC LIMIT 1SELECT * FROM dominance_info ORDER BY time DESC LIMIT 1SELECT * FROM transactions WHERE time >= NOW() - 24h ORDER BY time DESCFörklaring:
- I den första frågan får vi de senaste punkterna för varje mynt med marknadsdata. Åtta punkter för åtta mynt i mitt fall.
- Den andra frågan får den senaste punkten.
- Den tredje frågan begär en lista över transaktioner för de senaste 24 timmarna, som kan vara flera hundra.
Jag vill klargöra att i InfluxDB bygger index automatiskt på taggar och tid, vilket snabbar upp frågorna. I den första frågan symbol är en tagg.
Jag genomförde ett stresstest för denna API-metod. För 25 RPS visade servern full belastning på sex CPU:er:
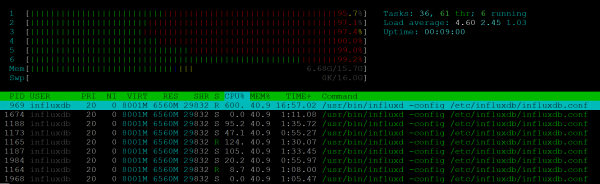
Under tiden gav NodeJs-processen ingen belastning.
Svarshastigheten försämrades redan vid 7-10 RPS: om en klient kunde få svar på 200 ms, skulle 10 klienter vänta i en sekund. 25 RPS är gränsen där stabiliteten påverkades, och kunderna fick 500-fel.
Med sådan prestanda är det omöjligt att använda Influx i vårt projekt. Dessutom, i ett projekt där övervakning måste visas för många kunder — kan liknande problem uppstå och metrics-servern blir överbelastad.
Utdata
Den viktigaste slutsatsen från den erhållna erfarenheten är att man inte ska använda en okänd teknik i ett projekt utan tillräcklig analys. En enkel genomgång av öppna ärenden på github skulle kunna ge information för att inte välja InfluxDB som huvudsakligt datalager.
InfluxDB borde ha passat bra för behoven i mitt projekt, men som praktiken visat sig, uppfyller denna databas inte behoven och har många problem.
I projektets repository kan man redan hitta version 2.0.0-beta, och man får hoppas att den andra versionen kommer med betydande förbättringar. Under tiden ska jag gå och studera dokumentationen för TimescaleDB.
Källa: habr.com
