

Idén till artikeln föddes spontant ur en diskussion i kommentarerna till en artikel .
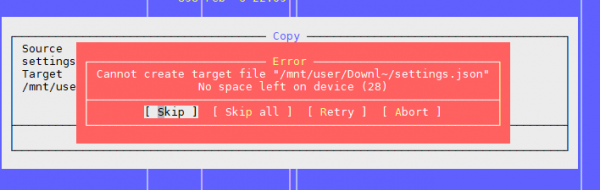
Problemet är att den interna specifikationen för våra tjänsters arbete innebär att vi lagrar ett enormt antal små filer. För närvarande har vi cirka hundratals terabyte av sådana data. Och vi har stött på vissa uppenbara och mindre uppenbara fallgropar och har framgångsrikt tagit oss förbi dem.
Därför delar jag med mig av vår erfarenhet, kanske det kan vara till nytta för någon.
Problem ett: »Inte tillräckligt med utrymme på enheten«
Som nämnts i den ovan nämnda artikeln är problemet att det finns lediga block på filsystemet, men inoderna är slut.
Antalet använda och lediga inoder kan kontrolleras med kommandot df -ih:
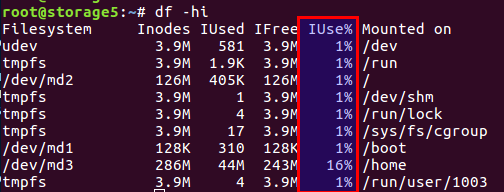
Jag tänker inte sammanfatta artikeln, men kort sagt, på disken finns det både block direkt för data och block för meta-information, som också kallas inoder (index-nod). Deras antal anges vid initiering av filsystemet (det handlar om ext2 och dess efterföljare) och ändras inte efter det. Balansen mellan datablock och inoder beräknas utifrån genomsnittliga data; i vårt fall, när det finns många små filer, bör balansen luta mer åt antalet inoder—de bör vara fler.
I Linux finns redan alternativ med olika balans, och alla dessa förberäknade konfigurationer finns i filen /etc/mke2fs.conf.
Därför kan rätt profil anges vid den första initialiseringen av filsystemet genom mke2fs.
Här är några exempel från filen:
    small = {
        blocksize = 1024
        inode_size = 128
        inode_ratio = 4096
    }

    big = {
        inode_ratio = 32768
    }

    largefile = {
        inode_ratio = 1048576
        blocksize = -1
    }
Det valda alternativet kan anges med alternativet »-T« när man anropar mke2fs. Man kan också manuellt ange nödvändiga parametrar om det inte finns en färdig lösning.
Mer information finns i manualerna för mke2fs.conf och mke2fs.
En särskild egenskap som inte berördes i den ovan nämnda artikeln är att blockstorlek för data kan anges. Uppenbarligen finns det för stora filer en fördel med en större blockstorlek, för småfiler en mindre.
Det är dock värt att ta hänsyn till en intressant funktion, nämligen processorarkitekturen.
Jag funderade en gång på att jag behövde en större blockstorlek för stora fotofiler. Det var under hemaförhållanden, på en hemlagringslösning av WD byggd på ARM-arkitektur. Utan att tänka för mycket, ställde jag blockstorleken till antingen 8k eller 16k istället för standard 4k, efter att ha mätt fördelen. Och allt var utmärkt precis tills lagringslösningen gick sönder, samtidigt som disken var intakt. När jag satte disken i en vanlig dator med en vanlig Intel-processor fick jag en överraskning: en icke-stödd blockstorlek. Vilken överraskning. Data fanns, allt var bra, men det gick inte att läsa. i386-processorer och liknande klarar inte av blockstorlekar som inte motsvarar minnessidans storlek, som är exakt 4k. I allmänhet slutade det med att vi använde verktyg från användarrummet, allt var långsamt och sorgligt, men vi räddade data. För den som är intresserad - googla namnet på verktyget. fuseext2. Moralen: antingen tänker man igenom alla scenarier på förhand, eller så försöker man inte vara en superhjälte och använder standardinställningar för hushåll.
UPD. På användarens anmärkning förtydligar jag att för i386 får blockstorleken inte överstiga 4k, men den behöver inte nödvändigtvis vara exakt 4k, så 1k och 2k är godkända.
Så här löste vi problemen.
För det första stötte vi på problemet när den multiterabyte disken var full av data och vi inte kunde ändra konfigurationen av filsystemet.
För det andra behövdes en snabb lösning.
Till slut kom vi fram till att vi var tvungna att ändra balansen och minska antalet filer.
För att minska antalet filer beslutade vi att packa filerna i ett gemensamt arkiv. Med tanke på vår specifik profil packade vi alla filer från en viss tidsperiod i ett arkiv och genomförde arkivering med en cron-jobb varje natt.
Vi valde zip-arkivet. I kommentarerna till den tidigare artikeln föreslogs tar, men det finns en svårighet: det har ingen katalog, och filerna i det är sekventiella (inte för inte som "tar" är en förkortning av "Tape Archive", ett arv från bandlagring), dvs. om du behöver läsa en fil i slutet av arkivet - måste du läsa hela arkivet, eftersom det inte finns några förskjutningar för varje fil i förhållande till början av arkivet. Därför är det en långsam operation. Med zip är allt mycket bättre: det har just den katalogen och filernas förskjutningar inuti arkivet, och åtkomsttiden till varje fil beror inte på dess placering. I vårt fall kunde vi ställa in komprimeringsalternativet "0" eftersom alla filer redan var komprimerade i gzip.
Kunder hämtar filer via nginx, och enligt det gamla API:t anges bara filnamnet, till exempel så här:
http://www.server.com/hydra/20170416/0453/3bd24ae7-1df4-4d76-9d28-5b7fcb7fd8e5
För att i realtid packa upp filer, hittade och kopplade vi modulen nginx-unzip-module () och konfigurerade två upstreams.
Resultatet blev en sådan konfiguration:
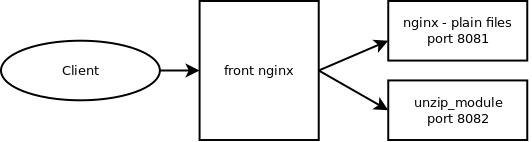
De två värdarna i inställningarna såg ut så här:
server {
  listen *:8081;

  location / {
    root      /home/filestorage;
  }
}
server {
listen *:8082;
location ~ ^/hydra/(\d+)/(\d+)/(.*)$ {
root /home/filestorage;
file_in_unzip_archivefile "/home/filestorage/hydra/$1/$2.zip";
file_in_unzip_extract "$2/$3";
file_in_unzip;
}
}
Och upstream-konfigurationen på den överordnade nginx:
upstream storage {
  server server.com:8081;
  server server.com:8082;
}
Hur det fungerar:
- Klienten går till front nginx
- Front nginx försöker ge filen från den första upstreamen, dvs. direkt från filsystemet
- Om filen inte finns - försöker den ge från den andra upstreamen, som försöker hitta filen inuti arkivet
Det andra problemet: återigen "No space left on device"
Detta är det andra problemet vi stötte på när det finns många filer i katalogen.
Vi försöker skapa en fil, systemet klagar på att det inte finns något utrymme kvar. Vi ändrar filnamnet och försöker skapa den igen.
Det fungerar.
Det ser ut ungefär så här:

Kontroll av inodes gav inget resultat - det finns många lediga.
Kontroll av utrymmet - samma sak.
Vi tänkte att det kanske är för många filer i katalogen, och det finns en begränsning för detta, men återigen nej: Maximum number of files per directory: ~1.3 × 10^20
Och man kan skapa en fil, om man ändrar namnet.
Slutsatsen - problemet ligger i filnamnet.
Ytterligare undersökningar visade att problemet ligger i hash-algoritmen vid konstruktion av katalogindexet, med ett stort antal filer förekommer kollisioner med alla följande konsekvenser. Du kan läsa mer om detta här:
Du kan stänga av det här alternativet, men... att söka efter filer med namn kan bli oförutsägbart långsamt när man går igenom alla filer.
tune2fs -O "^dir_index" /dev/sdb3
Överlag kan det fungera som en tillfällig lösning.
Moral: Många filer i en katalog är vanligtvis dåligt. Så gör man inte.
I sådana fall skapar man vanligtvis underkataloger, antingen efter de första bokstäverna i filnamnet eller efter något annat kriterium, till exempel datum. I de flesta fall räddar det situationen.
Men det totala antalet små filer är fortfarande dåligt, även om man delar upp dem i kataloger – då hänvisar vi till det första problemet.
Problem tre: Hur ser man en lista med filer om det finns många?
I vår situation, där vi har många filer, har vi hur som helst stött på problemet att se innehållet i katalogen.
Den standardlösning som används är kommandot ls.
Okej, låt oss se vad som händer med 4772098 filer:
$ time ls /home/app/express.repository/offercache/ >/dev/null

real	0m30.203s
user	0m28.327s
sys	0m1.876s
30 sekunder... det är lite för mycket. Huvudtiden går åt till att bearbeta filer i användarrummet, snarare än att kärnan arbetar.
Men det finns en lösning:
$ time find /home/app/express.repository/offercache/ >/dev/null

real	0m3.714s
user	0m1.998s
sys	0m1.717s
3 sekunder. 10 gånger snabbare.
Hurra!
UPD.
Ännu en snabbare lösning från en användare – stäng av sortering för ls
time ls -U /home/app/express.repository/offercache/ >/dev/null
real	0m2.985s
user	0m1.377s
sys	0m1.608s
Problem fyra: hög LA när man arbetar med filer
Det uppstår ibland situationer där man behöver kopiera många filer från en maskin till en annan. I dessa fall kan LA öka dramatiskt, eftersom det beror på prestandan hos själva diskarna.
Det mest rationella vore att använda SSD. Verkligen fantastiskt. Frågan är bara kostnaden för flera terabyte SSD.
Men om diskarna är vanliga, måste man kopiera filer, och det här är dessutom ett produktsystem där överbelastning leder till missnöje från kunderna? Det finns åtminstone två användbara verktyg: trevlig och ionice.
trevlig – minskar processens prioritet, vilket gör att schemaläggaren ger mer tid till andra, mer prioriterade processer.
I vår praktik har det hjälpt att ställa in nice till max (19 – detta är minimi-prioritet, -20 (minus 20) – max).
ionice – justerar prioriteten för in- och utdata (I/O-schemaläggning)
Om du använder RAID och det plötsligt behöver synkroniseras (efter en misslyckad omstart eller för att återställa RAID-arrayen efter diskbyte), kan det i vissa situationer vara meningsfullt att minska synkroniseringshastigheten så att andra processer kan fungera mer eller mindre adekvat. För detta kan följande kommando hjälpa:
echo 1000 > /proc/sys/dev/raid/speed_limit_max
Problem fem: Hur man synkroniserar filer i realtid
Vi har alla dessa enorma mängder filer som måste säkerhetskopieras till en andra server för att undvika… Filer skrivs ständigt, därför, för att minimera förluster, måste de kopieras så snabbt som möjligt.
Standardlösning: Rsync över SSH.
Det är ett bra alternativ om det inte behöver göras var några sekunder. Det finns många filer. Även om vi inte kopierar dem - måste vi fortfarande på något sätt förstå vad som har ändrats, och att jämföra flera miljoner filer tar tid och belastning på diskarna.
Det vill säga, vi måste veta direkt vad som ska kopieras, utan att starta en jämförelse varje gång.
Lösningen är - lsyncd. Lsyncd — . Det fungerar också via rsync, men monitorerar dessutom filsystemet för förändringar med hjälp av inotify och fsevents och startar kopiering bara för de filer som har tillkommit eller ändrats.
Problem sex: hur man förstår vem som belastar diskarna
Det vet nog alla, men för fullständighetens skull: för att övervaka diskundersystemet finns det kommandot iotop – liknande top, men visar de processer som mest aktivt använder diskarna.
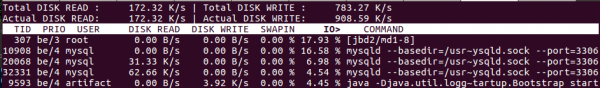
För övrigt kan den gamla hederliga top också hjälpa till att förstå om det finns problem med diskarna eller inte. För detta finns två särskilt lämpliga parametrar: Load Average och IOwait.
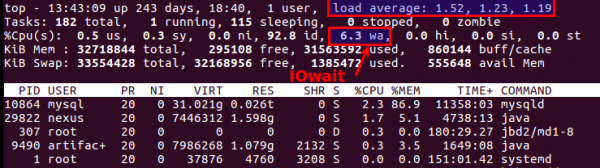
Den första visar hur många processer som står i kö för service, vanligtvis mer än 2 - något går redan fel. Vid aktiv kopiering till backupservrar tillåter vi upp till 6-8, efter detta anses situationen vara onormal.
Den andra - hur mycket processorn är upptagen med diskoperationer. IOwait >10% - orsaken till oro, även om vi på servrar med specifik belastningsprofil har stabilt 40-50%, och det är faktiskt normen.
Jag avslutar här, även om det säkert finns många moment som vi inte har stött på, ser jag fram emot kommentarer och beskrivningar av intressanta verkliga fall.
Källa: habr.com
