

Förord eller hur idén om sektionering uppstod
Början av historien här: Efter att nästan alla resurser för optimering av förfrågan vid den tidpunkten hade uttömts, uppstod frågan - vad händer härnäst? Så föddes idén om sektionering.
Ett lyriskt avsnitt:
Just 'vid den tidpunkten', för att . Tack och Habr !
Så hur kan man göra kunden lite lyckligare och samtidigt förbättra sina egna färdigheter?
Om man förenklar allt, finns det i grunden två sätt att radikalt förbättra databasens prestanda:
1) Extensiv väg - öka resurser, ändra konfiguration;
2) Intensiv väg - optimera förfrågningar
Eftersom det, som jag upprepar, vid den tidpunkten redan var oklart vad som mer skulle ändras i förfrågan för att öka hastigheten, valdes vägen - ändringar i tabellens design.
Så - den huvudsakliga frågan uppstår - vad och hur ska vi förändra?
Ursprungliga förhållanden
För det första, här är en sådan ERD (visas förenklat):
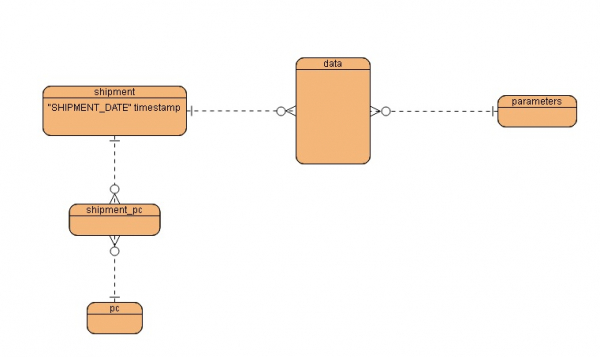
Huvudfunktioner:
- relationer ‘många till många’
- tabellen har redan en potentiell sektioneringsnyckel
Ursprunglig förfrågan:
SELECT
            p."PARAMETER_ID" as  parameter_id,
            pc."PC_NAME" AS pc_name,
            pc."CUSTOMER_PARTNUMBER" AS customer_partnumber,
            w."LASERMARK" AS lasermark,
            w."LOTID" AS lotid,
            w."REPORTED_VALUE" AS reported_value,
            w."LOWER_SPEC_LIMIT" AS lower_spec_limit,
            w."UPPER_SPEC_LIMIT" AS upper_spec_limit,
            p."TYPE_CALCUL" AS type_calcul,
            s."SHIPMENT_NAME" AS shipment_name,
            s."SHIPMENT_DATE" AS shipment_date,
            extract(year from s."SHIPMENT_DATE") AS year,
            extract(month from s."SHIPMENT_DATE") as month,
            s."REPORT_NAME" AS report_name,
            p."SPARAM_NAME" AS SPARAM_name,
            p."CUSTOMERPARAM_NAME" AS customerparam_name
        FROM data w INNER JOIN shipment s ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INNER JOIN parameters p ON p."PARAMETER_ID" = w."PARAMETER_ID"
             INNER JOIN shipment_pc sp ON s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INNER JOIN pc pc ON pc."PC_ID" = sp."PC_ID"
             INNER JOIN ( SELECT w2."LASERMARK" , MAX(s2."SHIPMENT_DATE") AS "SHIPMENT_DATE"
                          FROM shipment s2 INNER JOIN data w2 ON s2."SHIPMENT_ID" = w2."SHIPMENT_ID"
                          GROUP BY w2."LASERMARK"
                         ) md ON md."SHIPMENT_DATE" = s."SHIPMENT_DATE" AND md."LASERMARK" = w."LASERMARK"
        WHERE
             s."SHIPMENT_DATE" >= '2018-07-01' AND s."SHIPMENT_DATE" <= '2018-09-30' ;
Resultat av körningen på testdatabasen:
Kostnad : 502 997.55
Körningstid: 505 sekunder.
Vad ser vi? En vanlig förfrågan, baserat på tidsintervallet.
Vi gör en enkel logisk slutsats: om det finns ett urval av en tidsram, hjälper det oss? Rätt — partitionering.
Vad ska partitioneras?
Vid första anblick verkar valet uppenbart — deklarativ partitionering av tabellen "shipment" baserat på nyckeln "SHIPMENT_DATE" (för att gå lite för långt fram — i slutändan blev det inte riktigt så i produktion).
Hur partitionerar man?
Denna fråga är inte heller särskilt svår. Tack och lov, i PostgreSQL 10 finns det nu ett mänskligt vänligt partitioneringssystem.
Så:
- Spara en dump av den ursprungliga tabellen — pg_dump source_table
- Ta bort den ursprungliga tabellen — drop table source_table
- Skapa en föräldratabell med partitionering efter intervall — create table source_table
- Skapa partitioner — create table source_table, create index
- Importera dumpen som skapades i steg 1 — pg_restore
Skript för partitionering
För enkelhetens skull har steg 2, 3, 4 sammanfogats i ett enda skript.
Så:
Spara en dump av den ursprungliga tabellen
pg_dump postgres --file=\/dump\/shipment.dmp --format=c --table=shipment --verbose > \/dump\/shipment.log 2>&1Ta bort den ursprungliga tabellen + Skapa en föräldratabell med partitionering efter intervall + Skapa partitioner
--create_partition_shipment.sql
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;
begin
  RAISE NOTICE 'SKAPA TILLFÄLIG TABELL FÖR LEVERANS_DATUM';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;

  RAISE NOTICE 'TA BORT TABELL LEVERANS';
  drop table shipment cascade ;

  CREATE TABLE public.shipment
  (
    "SHIPMENT_ID" integer NOT NULL DEFAULT nextval('shipment_shipment_id_seq'::regclass),
    "SHIPMENT_NAME" character varying(30) COLLATE pg_catalog."default",
    "SHIPMENT_DATE" timestamp without time zone,
    "REPORT_NAME" character varying(40) COLLATE pg_catalog."default"
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
      OIDS = FALSE
  )
  TABLESPACE pg_default;

  RAISE NOTICE 'SKAPA PARTITIONER FÖR TABELL LEVERANS';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'LEVERANS_DATUM=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      IF to_number(current_month,'99') = to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         CONTINUE ;
      ELSE
       --NYA gränser endast för andra gången och framåt
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

      partition_name := 'shipment_shipment_date_'||begin_year||'-'||begin_month||'-01-'|| next_year||'-'||next_month||'-01'  ;

     EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF shipment FOR VALUES FROM ( %L ) TO ( %L )  ' , current_year||'-'||current_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'INDEXNAMN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      --Ta bort första gången flagga
      first_flag := false ;

  END LOOP;

end
$$;
Importera dump
pg_restore -d postgres --data-only --format=c --table=shipment --verbose shipment.dmp > /tmp/data_dump/shipment_restore.log 2>&1Kontrollera resultaten av partitioneringen
Vad har vi då i resultat? Den fullständiga texten av planen är stor och tråkig, så det räcker att begränsa sig till de slutliga siffrorna.
Det var
Kostnad: 502 997.55
Utförande tid: 505 sekunder.
Det blev
Kostnad: 77 872.36
Utförande tid: 79 sekunder.
Ett ganska bra resultat. Vi minskade kostnaden och utförandetiden. Således ger användningen av partitionering det förväntade resultatet och över lag — utan överraskningar.
Glädja beställaren
Testresultaten presenterades för beställaren för granskning. Efter genomgången kom en något oväntad dom: "Utmärkt, partitionera tabellen 'data'."
Ja, men vi har ju studerat helt andra tabellen 'shipment', tabellen 'data' har inte fältet 'SHIPMENT_DATE'.
Ingen fara, lägg till, ändra. Det viktigaste är att beställaren är nöjd med vad som kommer att bli resultatet, detaljerna i implementeringen är inte så viktiga.
Vi partitionerar huvudtabellen 'data'
På det hela ingen särskild svårighet dök upp. Även om algoritmen för partitionering självklart har förändrats något.
Vi lägger till kolumnen 'SHIPMENT_DATE' i tabellen 'data'
psql -h värd -U databas -d användare
=> ALTER TABLE data ADD COLUMN "SHIPMENT_DATE" timestamp without time zone ;
Vi fyller kolumnens värden 'SHIPMENT_DATE' i tabellen 'data' med värdena från den namngivna kolumnen i tabellen 'shipment'
-----------------------------
--update_data.sql
--uppdaterar för den ändrade tabellen "data" till värden av "shipment_data" från tabellen "shipment"
--version 1.0
do language plpgsql $$
declare
rec_shipment_data RECORD ;
shipment_date timestamp without time zone ;
row_count integer ;
total_rows integer ;
begin

  select count(*) into total_rows from shipment ;
  RAISE NOTICE 'Total %',total_rows;
  row_count:= 0 ;

  FOR rec_shipment_data IN SELECT * FROM shipment LOOP

   update data set "SHIPMENT_DATE" = rec_shipment_data."SHIPMENT_DATE" where "SHIPMENT_ID" = rec_shipment_data."SHIPMENT_ID";

   row_count:=  row_count +1 ;
   RAISE NOTICE 'row count = % , from %',row_count,total_rows;
  END LOOP;

end
$$;
Vi sparar dumpen av tabellen 'data'
pg_dump postgres --file=\/dump\/data.dmp --format=c --table=data --verbose > \/dump\/data.log 2>&1<\/sourceVi återskapar den partitionerade tabellen 'data'
--create_partition_data.sql
--skapa partitioner för tabellen "wafer data" efter intervallet "shipment_data" med en månads varaktighet
--version 1.0
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;

begin

  RAISE NOTICE 'SKAPA TILLFÄLLIG TABELL FÖR SHIPMENT_DATE';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;


  RAISE NOTICE 'RADERA TABELL data';
  drop table data cascade ;


  RAISE NOTICE 'SKAPA PARTITIONERAD TABELL data';

  CREATE TABLE public.data
  (
    "RUN_ID" integer,
    "LASERMARK" character varying(20) COLLATE pg_catalog."default" NOT NULL,
    "LOTID" character varying(80) COLLATE pg_catalog."default",
    "SHIPMENT_ID" integer NOT NULL,
    "PARAMETER_ID" integer NOT NULL,
    "INTERNAL_VALUE" character varying(75) COLLATE pg_catalog."default",
    "REPORTED_VALUE" character varying(75) COLLATE pg_catalog."default",
    "LOWER_SPEC_LIMIT" numeric,
    "UPPER_SPEC_LIMIT" numeric ,
    "SHIPMENT_DATE" timestamp without time zone
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
    OIDS = FALSE
  )
  TABLESPACE pg_default ;


  RAISE NOTICE 'SKAPA PARTITIONER FÖR TABELL data';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;
  i := 1;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'SHIPMENT_DATE=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      --Init gränser
      IF   begin_year = '0' THEN
       RAISE NOTICE '***Init gränser';
       first_flag := true ; --first time flag
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

--      RAISE NOTICE 'current_year=% , current_month=% ',current_year,current_month;
--      RAISE NOTICE 'begin_year=% , begin_month=% ',begin_year,begin_month;
--      RAISE NOTICE 'next_year=% , next_month=% ',next_year,next_month;

      -- Kontrollera aktuellt datum i gränser INTE för första gången

      RAISE NOTICE 'Aktuella data = %',to_char( to_date( current_year||'.'||current_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Börja data = %',to_char( to_date( begin_year||'.'||begin_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Nästa data = %',to_char( to_date( next_year||'.'||next_month, 'YYYY.MM'), 'YYYY.MM');

      IF to_date( current_year||'.'||current_month, 'YYYY.MM') >= to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         RAISE NOTICE '***Fortsätt';
         CONTINUE ;
      ELSE
       --NYA gränser endast för andra och efterföljande gånger
       RAISE NOTICE '***NYA GRÄNSER';
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;


      END IF;

      IF to_number(current_month,'99') < 10 THEN
        current_month := '0'||current_month ;
      END IF ;

      IF to_number(begin_month,'99') < 10 THEN
        begin_month := '0'||begin_month ;
      END IF ;

      IF to_number(next_month,'99') < 10 THEN
        next_month := '0'||next_month ;
      END IF ;

      RAISE NOTICE 'current_year=% , current_month=% ',current_year,current_month;
      RAISE NOTICE 'begin_year=% , begin_month=% ',begin_year,begin_month;
      RAISE NOTICE 'next_year=% , next_month=% ',next_year,next_month;

      partition_name := 'data_'||begin_year||begin_month||'01_'||next_year||next_month||'01'  ;

      RAISE NOTICE 'PARTITIONNUMMER % , TABELLNAMN =%',i , partition_name;

      EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF data FOR VALUES FROM ( %L ) TO ( %L )  ' , begin_year||'-'||begin_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_parameter_id_idx';
      RAISE NOTICE 'INDEXNAMN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_lasermark_idx';
      RAISE NOTICE 'INDEXNAMN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'INDEXNAMN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_parameter_id_idx';
      RAISE NOTICE 'INDEXNAMN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_date_idx';
      RAISE NOTICE 'INDEXNAMN =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_DATE") TABLESPACE pg_default ' ) ;

      --Ta bort första tidsflaggan
      first_flag := false ;

  END LOOP;
end
$$;
Laddar upp dumpfilen som skapades i steg 3.
pg_restore -h värd -user -d databas --data-only --format=c --table=data --verbose data.dmp > data_restore.log 2>&1Skapar en separat sektion för gamla data
---------------------------------------------------
--create_partition_for_old_dates.sql
--skapa partitioner för att behålla gamla datum
--version 1.0
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;

begin

      SELECT min("SHIPMENT_DATE") AS min_date INTO rec_shipment_date from data ;

      RAISE NOTICE 'Gammalt datum är %',rec_shipment_date.min_date ;

      partition_name := 'data_old_dates'  ;

      RAISE NOTICE 'PARTITIONSNAMNET ÄR %',partition_name;

      EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF data FOR VALUES FROM ( %L ) TO ( %L )  ' , '1900-01-01' ,
              to_char( rec_shipment_date.min_date,'YYYY')||'-'||to_char(rec_shipment_date.min_date,'MM')||'-01'  ) ;

      index_name := partition_name||'_shipment_id_parameter_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_lasermark_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_parameter_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_date_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_DATE") TABLESPACE pg_default ' ) ;

end
$$;
Slutresultat:
Det var
Kostnad: 502 997.55
Körningstid: 505 sekunder.
Det blev
Kostnad: 68 533.70
Utförande tid: 69 sekunder
Värdigt, helt värdigt. Och med tanke på att vi under vägen lyckades lära oss mekanismen för partitionering i PostgreSQL 10 – Ett utmärkt resultat.
En lyrisk avstickare
Kan vi göra det ännu bättre – JA, DET KAN VI!För detta behöver vi använda MATERIALIZED VIEW.
CREATE MATERIALIZED VIEW LASERMARK_VIEW
CREATE MATERIALIZED VIEW LASERMARK_VIEW
AS
SELECT w."LASERMARK" , MAX(s."SHIPMENT_DATE") AS "SHIPMENT_DATE"
FROM shipment s INNER JOIN data w ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
GROUP BY w."LASERMARK" ;

CREATE INDEX lasermark_vw_shipment_date_ind on lasermark_view USING btree ("SHIPMENT_DATE") TABLESPACE pg_default;
analyze lasermark_view ;
Skriver om frågan igen:
Fråga med användning av materialized view
SELECT
            p."PARAMETER_ID" as  parameter_id,
            pc."PC_NAME" AS pc_name,
            pc."CUSTOMER_PARTNUMBER" AS customer_partnumber,
            w."LASERMARK" AS lasermark,
            w."LOTID" AS lotid,
            w."REPORTED_VALUE" AS reported_value,
            w."LOWER_SPEC_LIMIT" AS lower_spec_limit,
            w."UPPER_SPEC_LIMIT" AS upper_spec_limit,
            p."TYPE_CALCUL" AS type_calcul,
            s."SHIPMENT_NAME" AS shipment_name,
            s."SHIPMENT_DATE" AS shipment_date,
            extract(year from s."SHIPMENT_DATE") AS year,
            extract(month from s."SHIPMENT_DATE") as month,
            s."REPORT_NAME" AS report_name,
            p."STC_NAME" AS STC_name,
            p."CUSTOMERPARAM_NAME" AS customerparam_name
        FROM data w INNER JOIN shipment s ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INNER JOIN parameters p ON p."PARAMETER_ID" = w."PARAMETER_ID"
             INNER JOIN shipment_pc sp ON s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INNER JOIN pc pc ON pc."PC_ID" = sp."PC_ID"
             INNER JOIN LASERMARK_VIEW md ON md."SHIPMENT_DATE" = s."SHIPMENT_DATE" AND md."LASERMARK" = w."LASERMARK"
        WHERE
              s."SHIPMENT_DATE" >= '2018-07-01' AND s."SHIPMENT_DATE" <= '2018-09-30';
Och vi får ytterligare en slutsats:
Det var
Kostnad: 502 997.55
Körningstid: 505 sekunder
Det blev
Kostnad: 42 481.16
Utförande tid: 43 sekunder.
Även om, så klart, ett så lovande resultat kan vara bedrägligt; presentationerna måste ju uppdateras. Så det slutliga datainsamlingstiden kommer inte att hjälpa så mycket. Men som experiment är det ganska intressant.
I själva verket, som det visade sig, tackar vi igen och Habr !-
Epilog
Så, kunden är nöjd. Och behöver utnyttjar situationen.
Ny uppgift: Vad kan vi komma på för att fördjupa och utvidga?
Och här kommer jag att tänka på - killar, vi har ingen övervakning av våra PostgreSQL-databaser.
Ärligt talat, det finns viss övervakning genom Cloud Watch på AWS. Men vilken nytta har den övervakningen för DBA? I stort sett ingen.
Om det finns en möjlighet att göra något användbart och intressant för sig själv, kan man inte missa en sådan chans …
EFTER SOM
Så här kom vi till det mest intressanta:
3:e december 2018.
Beslutet att påbörja arbetet med att undersöka de tillgängliga möjligheterna för övervakning av prestanda för PostgreSQL-frågor.
Men det är redan en helt annan historia.
Fortsättning följer…
Källa: habr.com
