

Vi kommer att titta på Zabbix arbete med databasen TimescaleDB som backend. Vi visar hur man startar från grunden och hur man migrerar från PostgreSQL. Vi kommer också att ge jämförande prestandatester av de två konfigurationerna.
HighLoad++ Sibirien 2019. Sal "Tomsk". 24 juni, 16:00. Texter och . Nästa konferens HighLoad++ kommer att hållas den 6 och 7 april 2020 i Sankt Petersburg. Detaljer och biljetter .
Andrey Gushin (hädanefter – AG): – Jag är ingenjör inom teknisk support för ZABBIX (hädanefter – "Zabbix"), tränare. Jag har arbetat mer än 6 år inom teknisk support och har direkt erfarenhet av prestanda. Idag kommer jag att berätta om den prestanda som TimescaleDB kan erbjuda i jämförelse med vanlig PostgreSQL 10. Jag ger också en viss introduktion – om hur det överhuvudtaget fungerar.
De största prestandautmaningarna: från insamling till rensning av data
Låt oss börja med att det finns vissa prestandautmaningar som varje övervakningssystem stöter på. Den första prestandautmaningen är snabb insamling och bearbetning av data.
Ett bra övervakningssystem bör snabbt och i tid få all information, bearbeta den i enlighet med triggeruttryck, det vill säga bearbeta den enligt vissa kriterier (detta varierar mellan olika system) och sedan spara den i databasen för framtida användning.
Den andra prestandautmaningen är att lagra historia. Att lagra data i databasen och samtidigt ha snabb och enkel tillgång till dessa mätvärden som samlats in under en viss tidsperiod. Det viktigaste är att det ska vara enkelt att få tillgång till dessa uppgifter, använda dem i rapporter, diagram, triggertabeller, i något tröskelvärde, för meddelanden, osv.
Det tredje prestationsutmaningen är rensning av historik, det vill säga när det kommer en dag då du inte behöver lagra detaljerade mätningar som har samlats in under 5 år (även månader eller två månader). Vissa nätverksnoder har tagits bort, eller vissa värdar, mätningarna är redan onödiga eftersom de har blivit föråldrade och inte längre samlas in. Allt detta måste rensas bort så att din databas inte växer till en storlek. Och överlag är rensning av historik ofta en allvarlig prövning för lagringssystemet - det påverkar ofta prestandan mycket.
Hur löser man cache-problem?
Jag kommer nu att prata specifikt om "Zabbix". I "Zabbix" har den första och andra utmaningen lösts med hjälp av caching.
Insamling och bearbetning av data - vi använder RAM för att lagra all denna data. Nu kommer jag att berätta mer om dessa data.
Det finns också viss caching på databasnivå för huvudsakliga urval - för grafer och andra saker.
Caching på sidan av själva Zabbix-servern: vi har ConfigurationCache, ValueCache, HistoryCache, TrendsCache. Vad är detta?
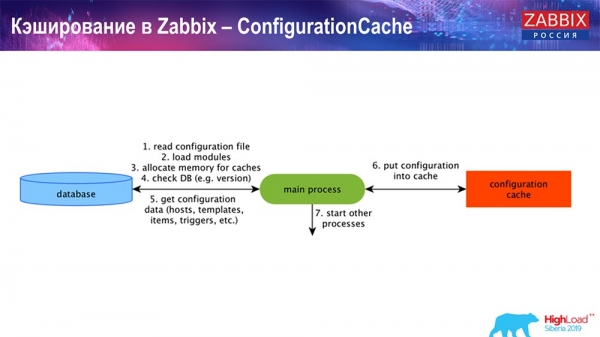
ConfigurationCache är den huvudsakliga cachen där vi lagrar mätningar, värdar, datainslag, trigger; allt som behövs för att bearbeta preprocessing, samla data, från vilka värdar man ska samla och med vilken frekvens. Allt detta lagras i ConfigurationCache så att vi inte behöver gå till databasen och skapa onödiga förfrågningar. Efter serverstart uppdaterar vi denna cache (skapar) och uppdaterar den periodiskt (beroende på konfigurationsinställningarna).
Caching i Zabbix. Datainsamling
Här är schemat ganska stort:
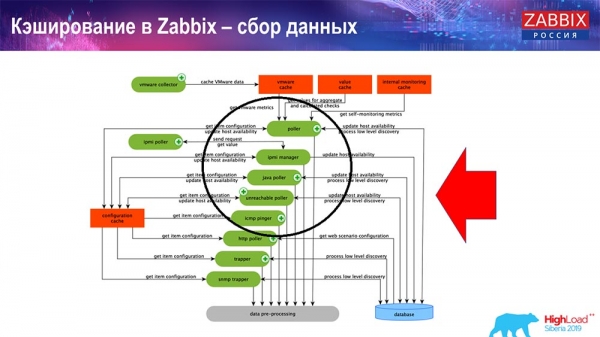
De viktigaste i schemat är dessa insamlare:
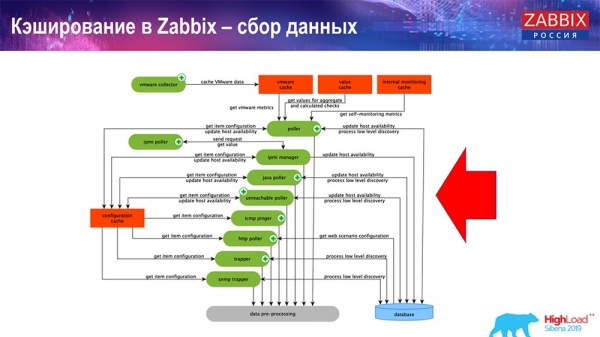
Detta är själva insamlingsprocesserna, olika "pollers" som ansvarar för olika typer av insamlingar. De samlar in data via icmp, ipmi, olika protokoll och skickar allt detta för preprocessing.
PreProcessing HistoryCache
Om vi har beräknade datainslag (de som är bekanta med "Zabbix" vet), det vill säga beräknade, aggregationsdata - hämtar vi dem direkt från ValueCache. Jag kommer att berätta mer om hur den fylls senare. Alla dessa insamlare använder ConfigurationCache för att hämta sina uppgifter och vidarebefordrar sedan till preprocessing.
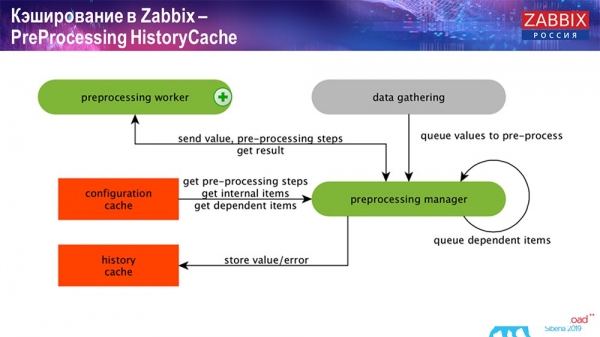
Preprocesseringen använder även ConfigurationCache för att hämta preprocesseringstegen och bearbetar dessa data på olika sätt. Från och med version 4.2 har vi flyttat det till en proxy. Detta är mycket praktiskt eftersom själva preprocesseringen är en ganska tung operation. Och om du har en mycket stor 'Zabbix', med ett stort antal datatelement och hög insamlingsfrekvens, så underlättar det arbetet avsevärt.
Därför, efter att vi har bearbetat dessa data på något sätt med hjälp av preprocessering, sparar vi dem i HistoryCache för att vidare bearbeta dem. Här slutar datainsamlingen. Vi går vidare till huvudprocessen.
Arbete med History syncer
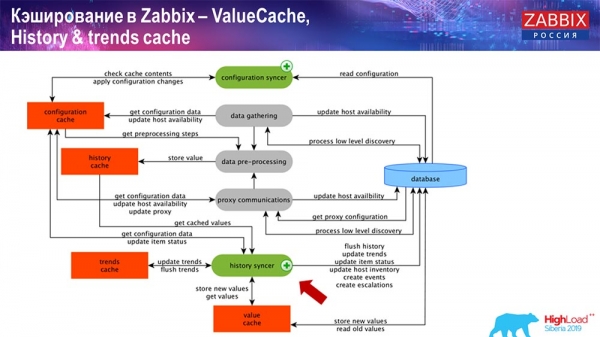
Huvudprocessen i 'Zabbix' (eftersom detta är en monolitisk arkitektur) är History syncer. Detta är huvudprocessen som sysslar med den atomära bearbetningen av varje datatelelement, det vill säga varje värde:
- ett värde kommer in (den tar det från HistoryCache);
- kontrollerar i Configuration syncer: finns det några triggers för beräkning – beräknar dem;
om det finns – skapar händelser, skapar eskaleringar för att generera ett meddelande om det är nödvändigt enligt konfigurationen; - skriver triggers för vidare bearbetning, aggregering; om du aggregerar för den senaste timmen och så vidare, sparar detta värde ValueCache, så att du inte behöver gå tillbaka till historiktabellen; på så sätt fylls ValueCache med de nödvändiga data som behövs för att beräkna triggers, beräknade element och så vidare;
- sedan skriver History syncer all data till databasen;
- databasen skriver dem till disken – vid denna punkt avslutas bearbetningsprocessen.
Databaser. Cachning
På databassidan, när du vill titta på grafer eller rapporter om händelser, finns det olika caches. Men inom ramen för denna presentation kommer jag inte att gå in på dem.
För MySQL finns Innodb_buffer_pool, och en mängd olika andra cacher som också kan konfigureras.
Men dessa är huvudpunkterna:
- shared_buffers;
- effective_cache_size;
- shared_pool.
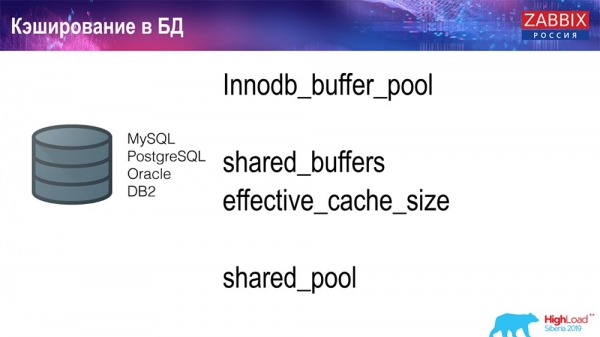
Jag har angivit för alla databaser att det finns specifika cacher som gör det möjligt att hålla i RAM de data som ofta behövs för förfrågningar. Där har de sina egna teknologier för detta.
Om databasens prestanda
Det finns en konkurrenssituation, vilket innebär att «Zabbix»-servern samlar in data och registrerar den. Vid omstart läser den också från historiken för att fylla ValueCache och så vidare. Här kan ni också ha skript och rapporter som använder «Zabbix»-API, som är byggt på webbgränssnittet. «Zabbix»-API går in i databasen och hämtar nödvändig data för att skapa grafer, rapporter eller någon lista över händelser och senaste problem.
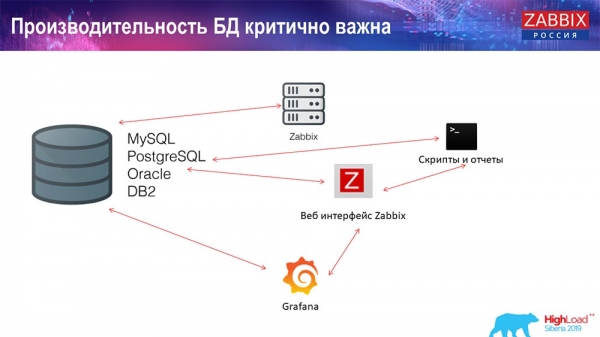
En annan mycket populär lösning för visualisering är Grafana, som används av våra kunder. Den kan direkt ansluta både via «Zabbix»-API och via databasen. Det skapar också en viss konkurrens för att hämta data: en mer detaljerad och bra inställning av databasen krävs för att kunna ge snabba resultat och tester.
Rensning av historik. I Zabbix finns Housekeeper.
Det tredje samtalet som används i «Zabbix» är rensning av historik med hjälp av Housekeeper. «Housekeeper» följer alla inställningar, det vill säga att vi i datatekniskan har angivit hur länge som ska sparas (i dagar), hur mycket som ska sparas av trender och dynamik i förändringar.
Jag nämnde inte TrendCache, som vi beräknar i realtid: data kommer in, vi aggregerar dem på en timme (främst dessa är siffror från den senaste timmen), medelvärde/minimum och registrerar detta en gång i timmen i tabellen för dynamik i förändringar («Trender»). «Housekeeper» körs och tar bort data från databasen med vanliga select-kommandon, vilket inte alltid är effektivt.
Hur gör man för att förstå att detta är ineffektivt? På prestationsgraferna för interna processer kan man se en sådan bild:
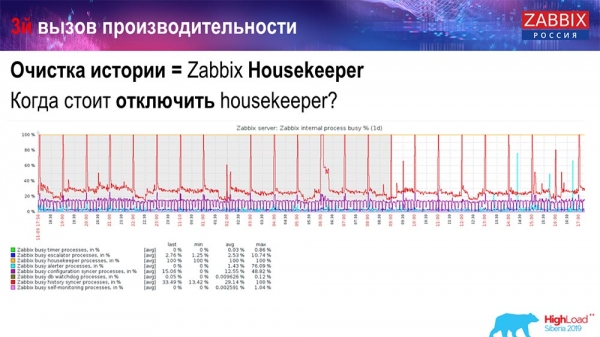
Ert History syncer är ständigt upptaget (röd graf). Och den «orangea» grafen som går ovanpå. Det är «Housekeeper», som körs och väntar på databasen för att ta bort alla rader som den har angivit.
Låt oss ta ett exempel på Item ID: vi behöver ta bort de senaste 5 tusen; självklart baserat på index. Men vanligtvis är datasetet tillräckligt stort – databasen läser fortfarande detta från disken och laddar upp i cache, vilket är en väldigt kostsam operation för databasen. Beroende på dess storlek kan detta orsaka vissa prestationsproblem.
Du kan enkelt stänga av "Housekeeper" – vi har det bekanta webbgränssnittet. I Administration general (inställningar för "Housekeeper") stänger vi av intern housekeeping för intern historik och trender. Därför hanterar inte "Housekeeper" detta längre:
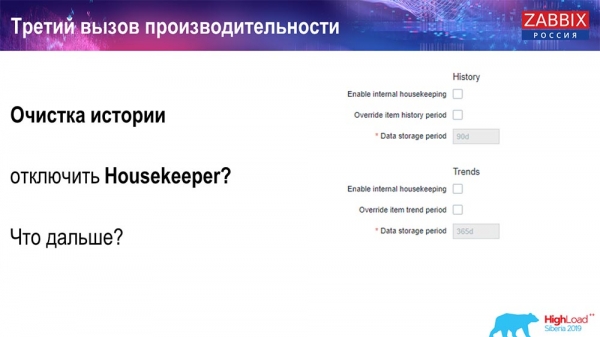
Vad kan man göra härnäst? Du har stängt av, dina diagram har stabiliserats… Vilka problem kan uppstå härnäst? Vad kan hjälpa?
Partitionering
Detta ställs vanligtvis in för varje relationsdatabas som jag har nämnt på olika sätt. MySQL har sin egen teknologi. Men generellt sett är de mycket lika om man pratar om PostgreSQL 10 och MySQL. Självklart finns det många interna skillnader i hur detta är implementerat och hur det påverkar prestandan. Men totalt sett leder skapandet av en ny partition ofta också till vissa problem.
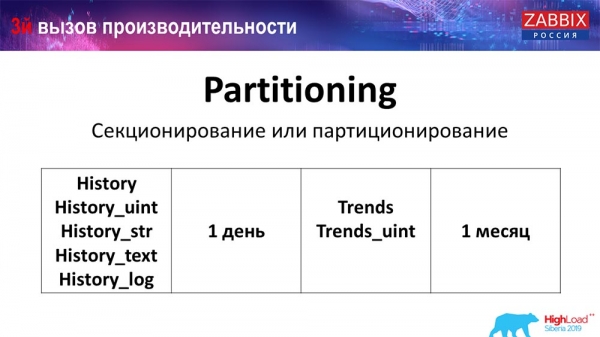
Beroende på din setup (hur mycket data som skapas på en dag), anger man vanligtvis den minsta – det är 1 dag/partition, och för "trender", dynamiken av förändringar – 1 månad / ny partition. Detta kan ändras om du har en väldigt stor setup.
Låt mig direkt säga något om storlekarna på setup: upp till 5 000 nya värden per sekund (så kallade nvps) räknas som en liten setup. Medium – från 5 000 till 25 000 värden per sekund. Allt över det är stora och mycket stora installationer som kräver mycket noggrann konfiguration av just databasen.
Vid mycket stora installationer är 1 dag kanske inte optimalt. Jag har personligen sett MySQL-partitioner på 40 gigabyte per dag (och mer kan förekomma). Detta är en mycket stor datavolym som kan orsaka några problem. Det behöver minskas.
Varför behövs partitionering?
Vad ger partitionering, tror jag att alla vet – det är sektorisering av tabeller. Ofta är det separata filer på disken och spänningsfrågor. Det väljer mer optimalt en partition om det ingår i den vanliga partitioneringen.
För «Zabbix» används det specifikt inom ett intervall, det vill säga vi använder en tidsstämpel (ett vanligt nummer, tiden sedan epoken började). Du ställer in början av dagen / slutet av dagen, och detta fungerar som partition. Om du begär data från två dagar tillbaka, hämtas allt detta från databasen snabbare, eftersom endast en fil behöver laddas in i cachen och levereras (och inte en stor tabell).
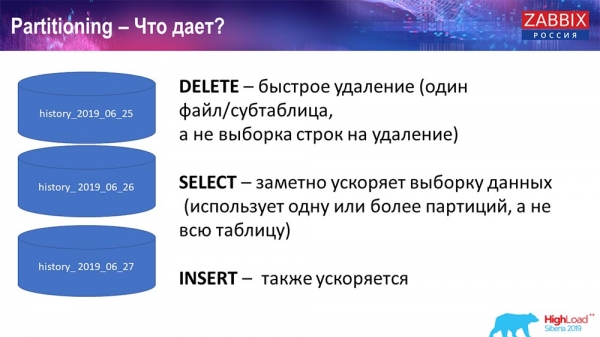
Många databaser snabbar också upp insättningar (inlägg i en child-tabell). Jag pratar fortfarande abstrakt, men detta är också möjligt. Partitionering hjälper ofta.
Elasticsearch för NoSQL
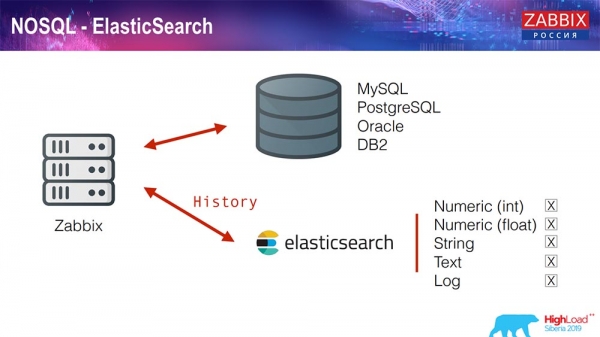
Nyligen, i version 3.4, implementerade vi en lösning för NoSQL. Vi lade till möjligheten att skriva till Elasticsearch. Du kan skriva vissa typer: välja – antingen skriva siffror eller specifika tecken; vi har strängtext, loggar kan skrivas till Elasticsearch… Webbgränssnittet kommer också att kommunicera med Elasticsearch. Detta fungerar utmärkt i vissa fall, men för tillfället kan detta användas.
TimescaleDB. Hypertabeller
För 4.4.2 observerade vi en sak, kring TimescaleDB. Vad är det? Det är en tillägg för «Postgres», vilket innebär att det har ett inhemskt PostgreSQL-gränssnitt. Dessutom tillåter detta tillägg att arbeta mycket effektivare med tidsseriedata och ha automatisk partitionering. Så här ser det ut:
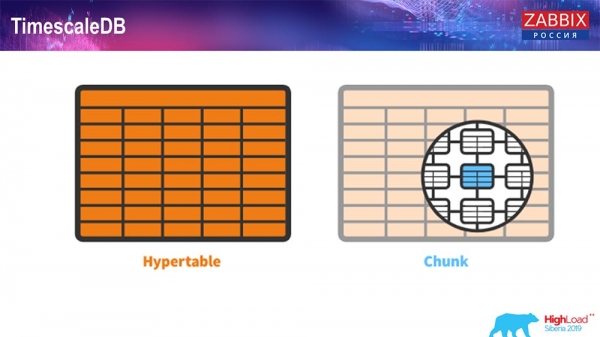
Detta är en hypertabell – det är ett begrepp inom Timescale. Det är en hypertabell som du skapar, och i den finns det chunkar. Chunkar är partitioner, det är child-tabeller, om jag inte minns fel. Detta är verkligen effektivt.
TimescaleDB och PostgreSQL
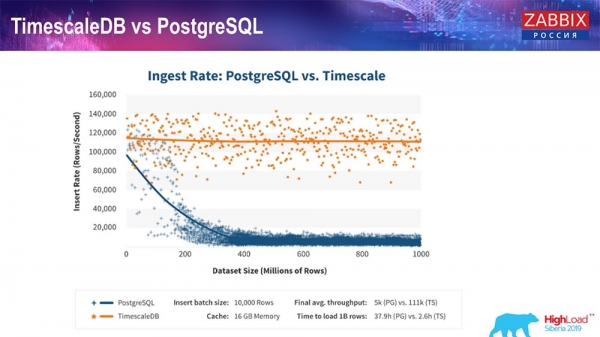
Som tillverkarna av TimescaleDB försäkrar, använder de en mer korrekt algoritm för att bearbeta förfrågningar, särskilt insättningar, vilket möjliggör ungefär konstant prestanda vid ökande storlek på dataset-inlägg. Det betyder att efter 200 miljoner rader börjar vanlig «Postgres» att kraftigt försämras och tappar prestanda bokstavligen till noll, medan «Timescale» möjliggör insättningar så effektivt som möjligt oavsett datamängd.
Hur installerar man TimescaleDB? Det är enkelt!
Det finns beskrivningar i dokumentationen – det kan installeras från paket för alla… Det beror på de officiella paketen för «Postgres». Man kan kompilera manuellt. Det råkade bli så att jag behövde kompilera för databasen.
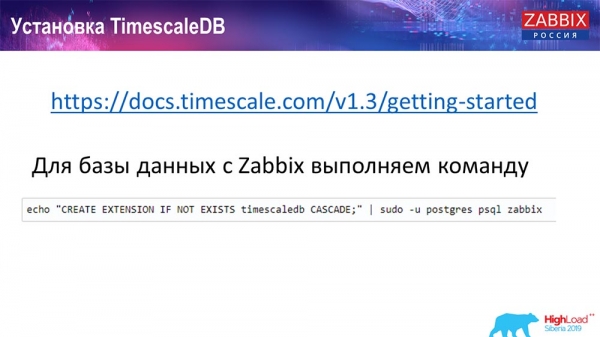
På "Zabbix" aktiverar vi bara Extention. Jag tror att de som har använt Extention i "PostgreSQL"... Du aktiverar bara Extention, skapar den för databasen "Zabbix" som du använder.
Och det sista steget...
TimescaleDB. Migration av historiktabeller
Du behöver skapa en hypertable. Det finns en speciell funktion för detta – Create hypertable. I den anger du som första parameter den tabell som behövs i denna databas (för vilken du vill skapa hypertabellen).
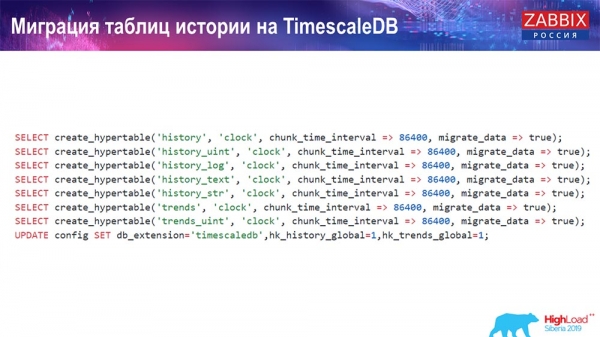
Fältet som ska skapas och chunk_time_interval (detta är tidsintervallet för chunkar (partitioner) som ska användas). 86 400 – det är en dag.
Parameter migrate_data: om du sätter den till true, så flyttar den alla aktuella data till förut skapade chunkar.
Jag använde själv migrate_data – det tar en hel del tid, beroende på storleken på din databas. Jag hade över en terabyte – skapandet tog mer än en timme. I vissa fall under testning tog jag bort historiska data för text (history_text) och sträng (history_str) för att inte flytta dem – jag var egentligen inte intresserad av dem.
Och den sista uppdateringen gör vi i vår db_extention: vi installerar timescaledb, så att databasen och, speciellt vår "Zabbix", förstår att det finns en db_extention. Den aktiverar den och använder korrekt syntax och frågor till databasen, med de "funktioner" som är nödvändiga för TimescaleDB.
Serverkonfiguration
Jag använde två servrar. Den första servern är en ganska liten virtuell maskin, 20 processorer, 16 gigabyte RAM. Jag installerade "PostgreSQL" 10.8 på den:
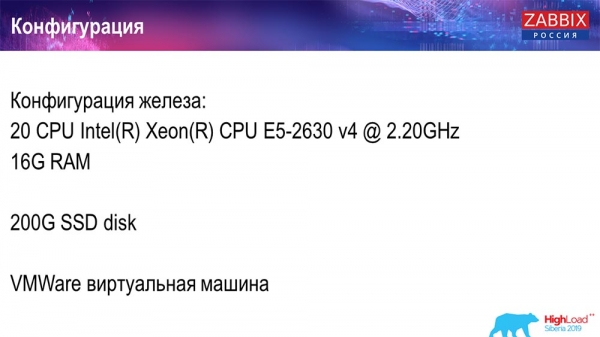
Operativsystemet var Debian, filsystemet – xfs. Jag gjorde minimala inställningar för att använda just denna databas, med undantag av vad som kommer att användas av "Zabbix" själv. På samma maskin var "Zabbix"-servern, PostgreSQL och belastningsagenterna installerade.
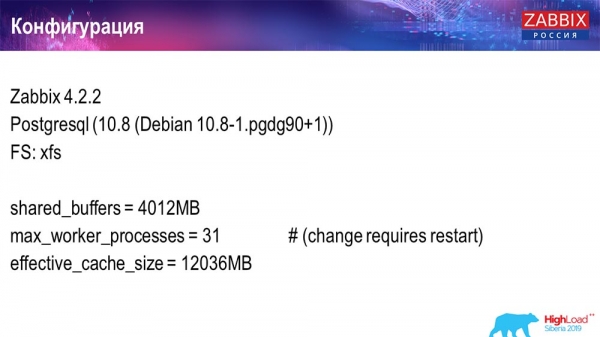
Jag använde 50 aktiva agenter som använder LoadableModule för att snabbt generera olika resultat. De genererade rader, nummer och så vidare. Jag fyllde databasen med en stor mängd data. Ursprungligen innehöll konfigurationen 5 000 datakElement per värd, och varje datakElement hade en trigger – för att det skulle vara en riktig setup. Ibland krävs till och med mer än en trigger för användning.
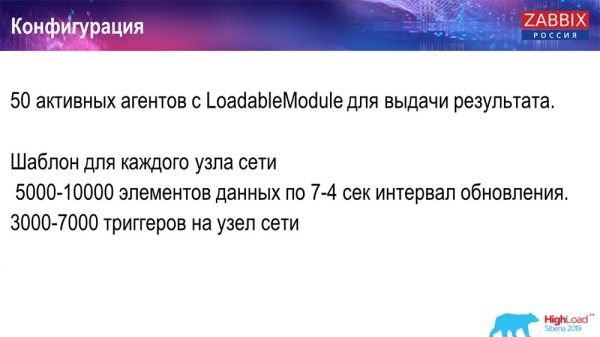
Uppdateringsintervallet, själva belastningen justerade jag genom att inte bara använda 50 agenter (jag lade till fler) utan också med hjälp av dynamiska datadelar och sänkte uppdateringsintervallet till 4 sekunder.
Prestandatest. PostgreSQL: 36 tusen NVP:er
Den första starten, första installationen hade jag på ren PostgreSQL 10 på denna hårdvara (35 tusen värden per sekund). Som man kan se på skärmen tar datainförseln bråkdelar av en sekund – allt fungerar bra och snabbt, SSD-enheter (200 gigabyte). Det enda som är att 20 GB fylls snabbt.
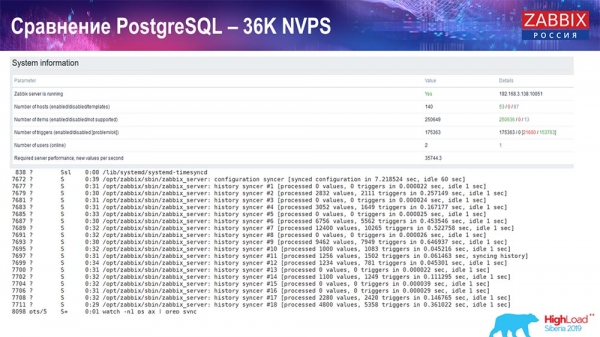
Det kommer att finnas många sådana grafer framöver. Detta är den standardprestandaöversikten för Zabbix-servern.
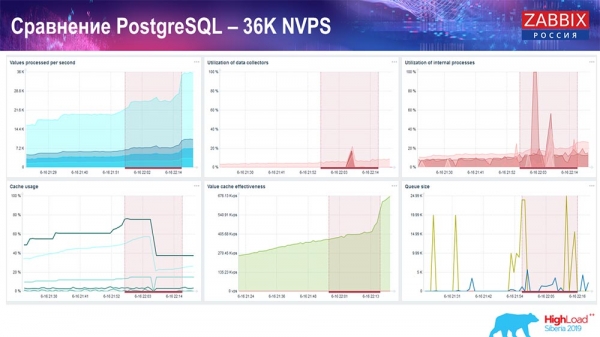
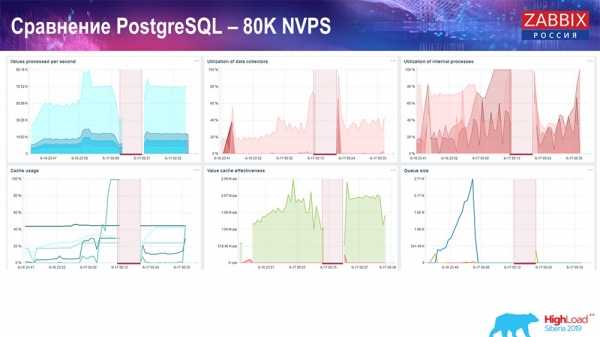
Den första grafen – antalet värden per sekund (blå, högst upp till vänster), 35 tusen värden i detta fall. Detta (uppe i mitten) är belastningen på processerna för insamling, och detta (uppe till höger) – belastningen på själva interna processerna: history syncers och housekeeper, som här (nere i mitten) utfördes under en viss tid.
Denna graf (nere i mitten) visar användningen av ValueCache – hur många träffar ValueCache har för triggers (flera tusen värden per sekund). En annan viktig graf – den fjärde (nere till vänster), som visar användningen av HistoryCache, som jag nämnde, som är en buffer före införsel i databasen.
Prestandatest. PostgreSQL: 50 tusen NVP:er
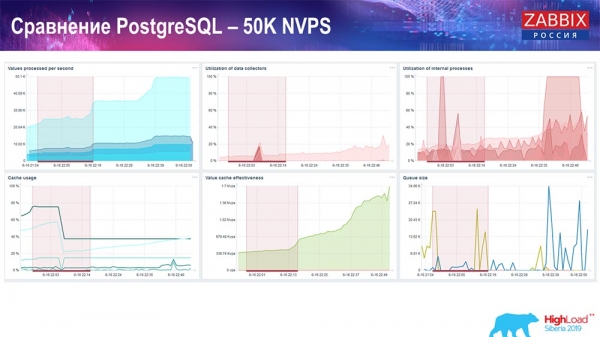
Därefter ökade jag belastningen till 50 tusen värden per sekund på samma hårdvara. Vid insamling med Housekeeper skrevs 10 tusen värden in på 2-3 sekunder med beräkningar. Det som faktiskt visas på nästa skärmdump:
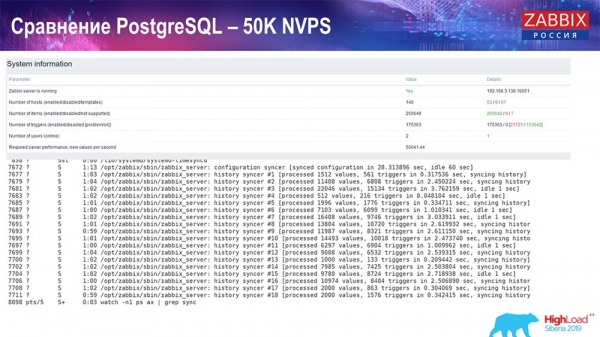
Housekeeper börjat störa arbetet, men i stort sett ligger belastningen på history syncers fortfarande på 60 % (den tredje grafen, uppe till höger). HistoryCache började aktivera och fyllas under Housekeepers arbete (nere till vänster). Den var omkring en halv gigabyte, fylldes med 20%.
Prestandatest. PostgreSQL: 80 tusen NVP:er
Jag ökade sedan till 80 tusen värden per sekund:
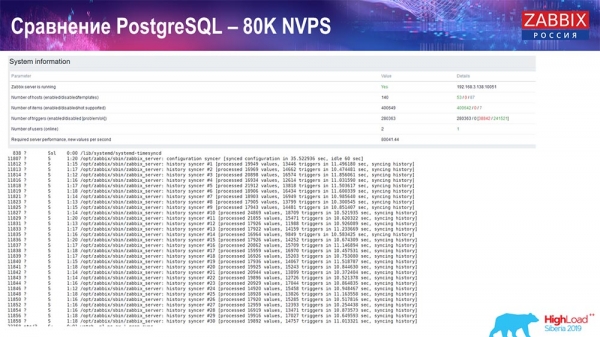
Det handlade om cirka 400 000 datapunkter och 280 000 triggers. Införandet, som ni ser, var redan ganska hög med belastningen av history-syncers (det fanns 30 av dem). Jag ökade därefter olika parametrar: history-syncers, cache… På den här hårdvaran började belastningen av history-syncers öka till max, nästan 'i taket' – därför gick HistoryCache till mycket hög belastning:
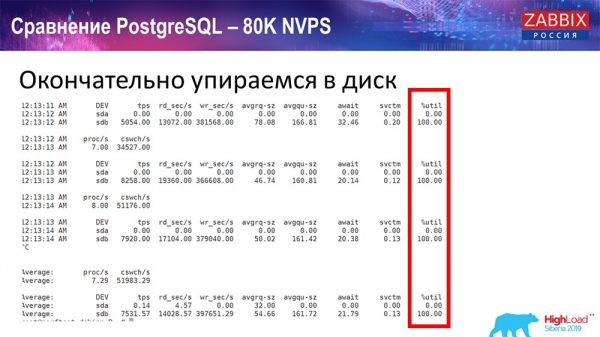
Under hela denna tid har jag övervakat alla systemparametrar (hur CPU:n används, RAM-minnet) och upptäckte att diskutnyttjandet var maximalt – jag hade uppnått maximal kapacitet på denna disk på denna hårdvara, på denna virtuella maskin. 'Postgres' började dumpa data ganska aktivt vid denna intensitet, och disken hann inte med att skriva eller läsa…
Jag tog en annan server som redan hade 48 processorer och 128 gigabyte RAM-minne:
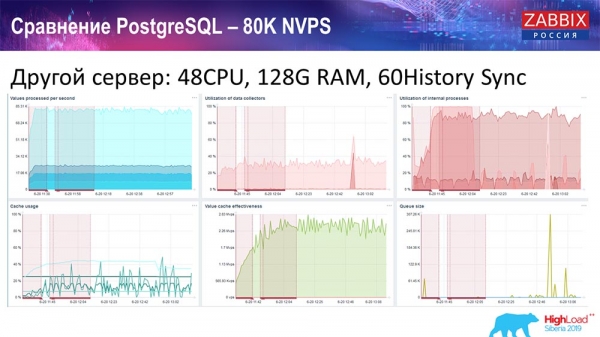
Jag 'tunade' också den – installerade 60 History syncers och uppnådde acceptabel prestanda. Egentligen är vi inte 'i taket', men det är nog redan gränsen för prestandan där man verkligen behöver ta något steg.
Prestandatest. TimescaleDB: 80 000 NVPs
Min huvuduppgift var att använda TimescaleDB. På varje graf syns ett fall:
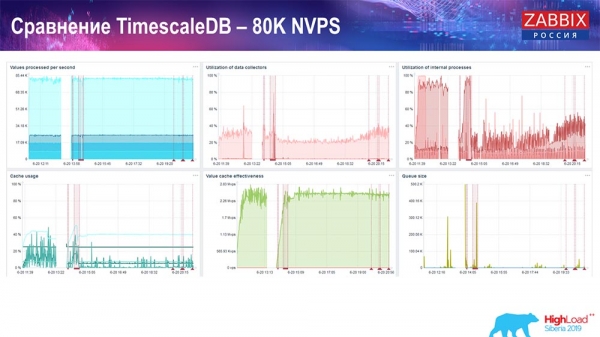
Dessa fall är just datamigreringen. Efter detta har profilen för belastningen av history-syncers i 'Zabbix'-servern, som ni ser, förändrats kraftigt. Den möjliggör nästan tre gånger snabbare infogning av data och använder mindre HistoryCache – därmed kommer ni att få data i tid. Återigen, 80 000 värden per sekund – det är ett ganska högt rate (naturligtvis inte för 'Yandex'). Överlag är detta en ganska stor setup, med en server.
Prestandatest av PostgreSQL: 120 000 NVPs
Sedan ökade jag antalet datapunkter till en halv miljon och fick ett beräknat värde av 125 000 per sekund:
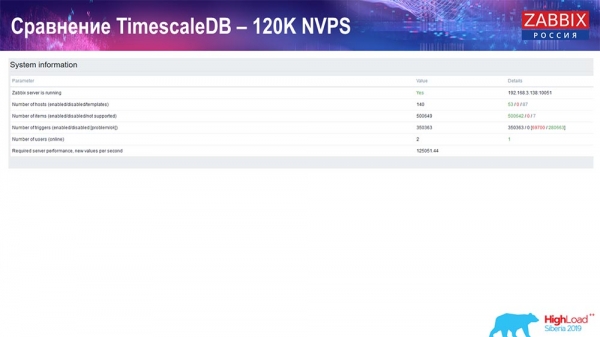
Och fick sådana här grafer:
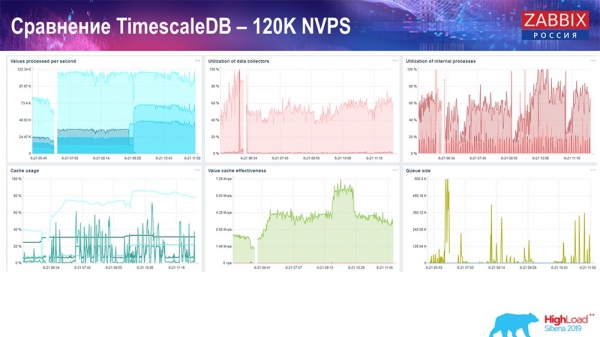
I princip är detta en fungerande setup, den kan fungera ganska länge. Men eftersom jag hade en disk på endast 1,5 terabyte förbrukade jag den på ett par dagar. Det viktigaste är att nya partitioner skapades på TimescaleDB samtidigt, och det påverkade prestandan helt osynligt, vilket inte går att säga om MySQL.
Vanligtvis skapas partitioner på natten eftersom det blockerar all insättning och arbete med tabeller, vilket kan leda till degradering av tjänsten. I det här fallet är det inte så! Huvuduppgiften var att kontrollera möjligheterna med TimescaleDB. Resultatet blev: 120 000 värden per sekund.
Det finns också exempel i "communityn":
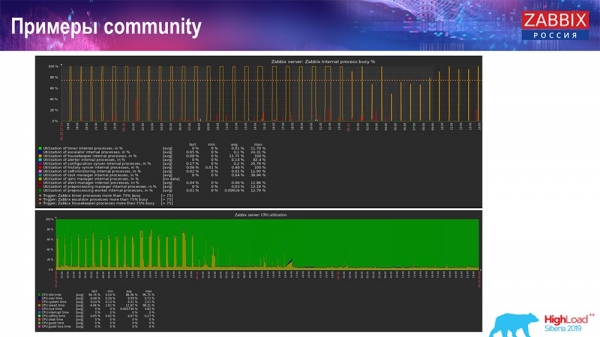
En person aktiverade också TimescaleDB och belastningen från io.weight sjönk på processorn; och användningen av interna processkomponenter minskade också tack vare aktiveringen av TimescaleDB. Och det är vanliga hårddiskar, det vill säga en vanlig virtuell maskin på vanliga diskar (inte SSD)!
För vissa små setup:ar som är begränsade av diskens prestanda, tycker jag att TimescaleDB är en mycket bra lösning. Det låter er fortsätta arbeta tills ni migrerar till snabbare hårdvara för databasen.
Jag bjuder in er alla till våra evenemang: Conference – i Moskva, Summit – i Riga. Använd våra kanaler – "Telegram", forum, IRC. Om ni har några frågor – kom gärna till vår disk, vi kan prata om allt.
Frågor från publiken
Fråga från publiken (nedan – A): – Om TimescaleDB är så enkelt att konfigurera, och ger en sådan prestandaökning, kanske det är värt att använda som bästa praxis för att konfigurera "Zabbix" med "Postgres"? Finns det några fallgropar eller nackdelar med denna lösning, eller om jag har bestämt mig för att använda "Zabbix", kan jag då lugnt ta "Postgres", installera "Timescale" där direkt, använda det och inte tänka på några problem?
AG: – Ja, jag skulle säga att det är en bra rekommendation: att använda "Postgres" direkt med TimescaleDB-tillägget. Som jag redan har sagt, har jag hört många goda omdömen, trots att denna "funktion" är experimentell. Men tester visar faktiskt att det är en utmärkt lösning (med TimescaleDB), och jag tror att den kommer att utvecklas! Vi följer hur detta tillägg utvecklas och kommer att justera det som behövs.
Under utvecklingen lutade vi oss till och med på en av deras kända "funktioner": där kunde man arbeta med chunks på ett lite annat sätt. Men sedan tog de bort det i nästa version, och vi tvingades sluta förlita oss på den koden. Jag skulle rekommendera att använda denna lösning på många setup:ar. Om du använder MySQL… För medelstora setup:ar fungerar vilken lösning som helst ganska bra.
A: – På de senaste graferna från communityn fanns det en graf med "Housekeeper":
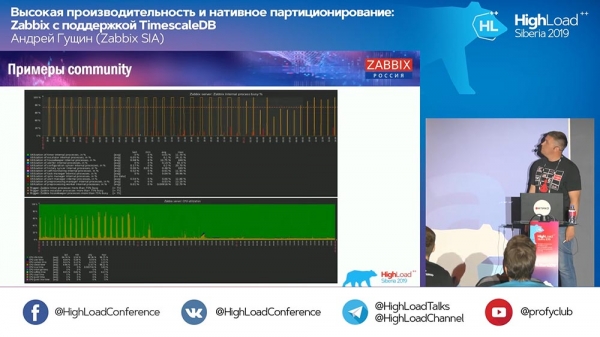
Han fortsatte att arbeta. Vad gör "Housekeeper" i fallet med TimescaleDB?
AG: – Jag kan inte säga exakt just nu – jag ska kolla koden och ge en mer detaljerad förklaring. Han använder förfrågningar exakt från TimescaleDB inte för att ta bort chunks, utan han aggregerar på något sätt. Jag är inte redo att svara på den tekniska frågan än. Vi kommer att klargöra det på mässan idag eller imorgon.
A: – Jag har en liknande fråga – om prestandan vid borttagning av data i "Timescale".
A (svar från publiken): – När du tar bort data från tabellen, om du gör det genom delete, så måste du gå igenom tabellen – ta bort, rensa, märka allt för framtida vakuum. I "Timescale", eftersom du har chunks, kan du droppa. Rent konkret säger du bara till filen som ligger i big data: "Ta bort!"
"Timescale" förstår helt enkelt att den chunken inte längre finns. Och eftersom den integreras i frågeplaneraren fångar den upp dina villkor i select-satsen eller andra operationer och förstår direkt att den chunken inte längre existerar – "Jag går inte dit längre!" (data saknas). Så är det! Det vill säga att tabellscanningen ersätts med borttagning av en binär fil, vilket gör det snabbt.
A: – Vi har redan berört ämnet icke-SQL. Såvitt jag förstår behöver "Zabbix" inte modifiera data särskilt mycket, utan allt detta är något som ett logg. Kan man använda specialiserade databaser som inte kan förändra sina data, men som samtidigt mycket snabbare lagrar, ackumulerar och ger – Clickhouse, till exempel något kafkaliknande? .. Kafka är ju också en logg! Kan de integreras på något sätt?
AG: – Export kan göras. Vi har en viss "funktion" från version 3.4: du kan skriva alla historiska filer, händelser och allt annat till filer; och sedan skickar du det med någon typ av processor till vilken annan databas som helst. Faktiskt är det många som gör om det och skriver direkt till databasen. Ögonblickligt skriver histori-synkronisatorerna allt detta till filer, roterar dessa filer med mera, och detta kan du överföra till "Clickhouse". Jag kan inte säga något om planerna, men det är möjligt att vidare stöd för NoSQL-lösningar (som "Clickhouse") kommer att fortsätta.
A: – Så det går verkligen att helt bli av med PostgreSQL?
AG: – Självklart, den mest utmanande delen i "Zabbix" är historiska tabeller som skapar flest problem, och händelser. I det här fallet, om du inte lagrar händelser för länge och istället lagrar historik med trender i något annat snabbt lagringsutrymme, så bör det inte bli några problem, tror jag.
A: – Kan du uppskatta hur mycket snabbare allt skulle fungera om man går över till "ClickHouse", till exempel?
AG: – Jag har inte testat. Jag tror att man åtminstone kan nå samma siffror ganska enkelt, med tanke på att "ClickHouse" har sitt eget gränssnitt, men kan inte säga det definitivt. Bättre att testa. Det beror helt på konfigurationen: hur många värdar ni har och så vidare. Införsel är en sak, men man måste också hämta dessa data – med Grafana eller något annat.
A: – Så det handlar om en jämlik kamp, inte ett stort övertag hos dessa snabba databaser?
AG: – Jag tror att vi när vi integrerar kommer att få mer exakta tester.
A: – Men vart tog den gamla goda RRD vägen? Vad fick er att gå över till SQL-databaser? Ursprungligen samlades ju alla metrik i RRD.
AG: – I "Zabbix" fanns RRD kanske i en mycket gammal version. Det har alltid funnits SQL-databaser – den klassiska metoden. Den klassiska metoden är MySQL, PostgreSQL (som faktiskt funnits länge nu). Vi har ett gemensamt gränssnitt för SQL-databaser och RRD har vi knappt använt.

Lite reklam 🙂
Tack för att ni stannar kvar hos oss. Gillar ni våra artiklar? Vill ni se fler intressanta material? Stöd oss genom att göra en beställning eller rekommendera oss till era vänner, , en unik motsvarighet till entry-level servrar som vi har skapat för er: (alternativ med RAID1 och RAID10 finns tillgängliga, upp till 24 kärnor och upp till 40GB DDR4).
Dell R730xd är två gånger billigare i datacentret Equinix Tier IV i Amsterdam? Bara hos oss i Nederländerna! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — från $99! Läs om
Källa: habr.com
