

Alla pratar om utvecklings- och testprocesser, utbildning av personal, ökad motivation, men dessa processer är få när en minuts stillestånd kostar astronomiska pengar. Vad ska man göra när man hanterar finansiella transaktioner under en strikt SLA? Hur kan man öka pålitligheten och redundansen i dina system, utan att involvera utveckling och testning?
Nästa konferens av HighLoad++ äger rum den 6 och 7 april 2020 i Sankt Petersburg. Mer information och biljetter finns på . Den 9 november, 18:00. HighLoad++ Moskow 2018, sal "Deli + Kalkutta". Sammanfattningar och .
Evgenij Kuzovlev (härefter EK): – Hej vänner! Jag heter Evgenij Kuzovlev. Jag kommer från företaget EcommPay, den specifika avdelningen är EcommPay IT, IT-avdelningen inom koncernen. Idag ska vi prata om stillestånd – hur man undviker det och hur man minimerar konsekvenserna om det inte går att undvika. Temat som presenterades är: "Vad gör man när en minut av stillestånd kostar 100 000 dollar"? För att förvarna, siffrorna är jämförbara.
Vad sysslar EcommPay IT med?
Vem är vi? Varför står jag här framför er? Varför har jag rätt att berätta något för er här? Och vad ska vi prata mer detaljerat om här?
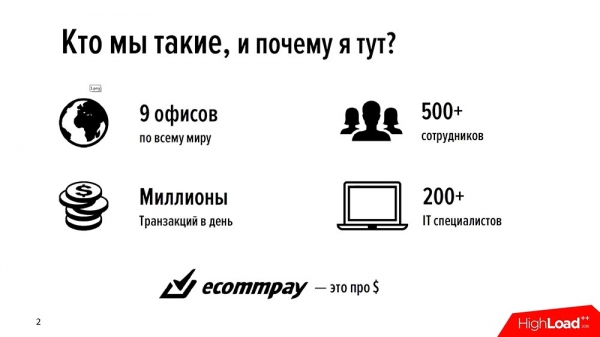
EcommPay-koncernen är en internationell förvärvare. Vi processar betalningar över hela världen – i Ryssland, Europa, och Sydostasien (All Around the World). Vi har 9 kontor, 500 anställda totalt och cirka hälften av dem är IT-specialister. Allt vi gör, allt vi tjänar pengar på, har vi skapat själva.
Vi har utvecklat alla våra produkter (och vi har rätt många – i vår serie av stora IT-produkter har vi cirka 16 olika komponenter); vi skriver själva, vi utvecklar själva. Just nu hanterar vi omkring en miljon transaktioner om dagen (miljoner är nog det rätta sättet att säga det). Vi är fortfarande ett ungt företag – vi har funnits i ungefär sex år.
För sex år sedan var det en startup, när grabbarna kom tillsammans med affärsidén. De var förenade av en idé (inget annat fanns, förutom idén), och vi sprang. Som vilken startup som helst sprang vi snabbt... För oss var hastighet viktigare än kvalitet.
Vid en viss tidpunkt stannade vi upp: vi insåg att vi inte längre kunde leva med den hastigheten och kvaliteten och att vi istället måste fokusera på kvalitet. I det ögonblicket beslutade vi att skriva en ny plattform som skulle vara rätt, skalbar och pålitlig. Vi började skriva denna plattform (började investera, utveckla, testa), men efter en tid insåg vi att utvecklingen och testningen inte möjliggjorde ett nytt kvalitetslyft för tjänsten.
Ni skapar en ny produkt, ni släpper den på produktion, men ändå går något fel någonstans. Idag ska vi prata om hur man når en ny kvalitetsnivå (hur vi gjorde det, om vår erfarenhet), med utveckling och testning bortsett; vi kommer att diskutera vad som är tillgängligt för driften – vad driften kan göra själv, vad den kan erbjuda testningen för att påverka kvaliteten.
Nertid. Driftsprinciper.
Alltid den grundläggande hörnstenen, om vad vi idag faktiskt kommer att prata om – nertid. Ett skrämmande ord. Om vi har en nertid – då har vi problem. Vi springer för att återställa, administratörer håller servern – Gud förbjude den faller, som det sjungs i den där låten. Det är detta vi ska diskutera idag.
När vi började ändra våra angreppssätt formade vi fyra principer. De presenteras på mina bilder:
Dessa principer är ganska enkla:
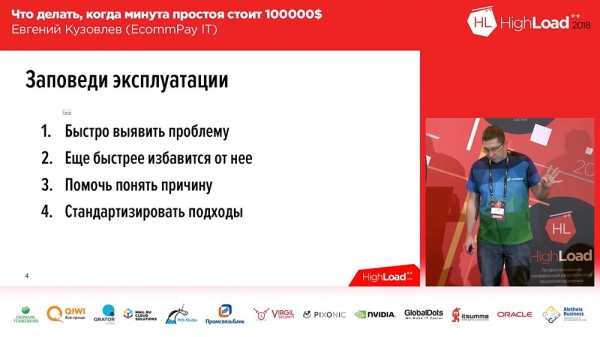
- Snabbt identifiera problemet.
- Ännu snabbare bli av med det.
- Hjälpa till att förstå orsaken (senare, för utvecklarna).
- Och standardisera angreppssätten.
Jag vill påpeka punkt nummer 2. Vi blir av med problemet, istället för att lösa det. Att lösa är sekundärt. För oss är det primärt att användaren är skyddad från detta problem. Det kommer att finnas i en viss isolerad miljö, men denna miljö kommer på inget sätt att interagera med användaren. Faktiskt kommer vi att gå igenom dessa fyra grupper av problem (vissa mer i detalj, andra mindre), jag kommer att berätta vad vi använder, vilken erfarenhet vi har med lösningar.
Problemavhjälpning: när de inträffar och vad man ska göra åt dem?
Men vi börjar inte i ordning, vi börjar med punkt nummer 2 – hur snabbt blir vi av med problemet? Det finns ett problem – vi måste åtgärda det. "Vad ska vi göra med detta?" – är den grundläggande frågan. Och när vi började tänka på hur vi skulle lösa problemet, formulerade vi vissa krav som processen för att lösa problem bör följa.
För att formulera dessa krav beslutade vi oss för att ställa frågan: "När uppstår våra problem?" Och problem, som det visade sig, förekommer i fyra fall:
- Hårdvarufel.
- Fel på externa tjänster.
- Byte av mjukvaruversion (den så kallade deployment).
- Explosiv ökning av belastning.
Vi kommer inte att prata om de första två. Hårdvarufel åtgärdas relativt enkelt: allt måste vara duplicerat. Om det handlar om diskar – ska diskarna vara sammanställda i RAID, om det handlar om en server – ska servern vara duplicerad, om ni har en nätverksinfrastruktur – bör ni installera en andra kopia av nätverksinfrastrukturen, det vill säga ni tar och duplicerar. Och om något går sönder, växlar ni till reservkraft. Här är det svårt att säga mycket mer.
Det andra är fel på externa tjänster. För de flesta system är det överhuvudtaget inget problem, men inte för oss. Eftersom vi behandlar betalningar är vi en aggregator som står mellan användaren (som anger sina kortuppgifter) och bankerna, betalningssystemen ("Visa", "MasterCard", "Mir" osv). Våra externa tjänster (betalningssystem, banker) tenderar att falla samman. Varken vi eller ni (om ni har sådana tjänster) kan påverka det.
Vad ska man göra då? Här finns två alternativ. För det första, om ni kan, bör ni på något sätt duplicera denna tjänst. Till exempel, om vi kan, omdirigerar vi trafiken från en tjänst till en annan: om vi behandlade kort via "Sberbank", och "Sberbank" har problem – flyttar vi trafiken [villkorligt] till "Raiffeisen". Det andra vi kan göra – är att mycket snabbt upptäcka fel på externa tjänster, och därför kommer vi att prata om reaktionshastighet i nästa del av presentationen.
Faktum är att av dessa fyra kan vi konkret påverka bytet av mjukvaruversioner – vidta åtgärder som leder till förbättringar i sammanhanget för distributioner och i samband med den explosiva ökningen av belastning. I själva verket har vi gjort detta. Här, återigen, en liten anmärkning...
Av dessa fyra problem löses flera omgående om du har en molntjänst. Om du befinner dig i molnen från "Microsoft Azure", "Ozon", eller använder våra moln från "Yandex" eller "Mail", så blir åtminstone hårdvarufel deras problem och du får omedelbart en förbättrad situation när det gäller hårdvarufel.
Vi är ett något okonventionellt företag. Här pratar alla om "Kubernetes" och moln – vi har varken "Kubernetes" eller moln. Däremot har vi rack med hårdvara på flera datacenter, och på denna hårdvara måste vi leva, vi måste ta ansvar för allt detta. Så i detta sammanhang kommer vi att diskutera. Så, angående problemen. De första två tar vi bort här.
Byte av mjukvaruversion. Grunder.
Våra utvecklare har inte tillgång till produktion. Varför är det så? Jo, vi är certifierade enligt PCI DSS, och våra utvecklare har helt enkelt inte rätt att gräva i "prod". Punkt slut. Helt och hållet. Därför slutar utvecklingsansvaret exakt i det ögonblick då utvecklingsavdelningen överlämnar byggandet för release.
Vår andra grund, som vi också har och som hjälper oss mycket – är att det inte finns några unika, dokumentationsfria kunskaper. Jag hoppas att ni har det på samma sätt. För att om det inte är så – kommer ni att få problem. Problem uppstår när dessa unika, odokumenterade kunskaper inte finns på rätt tid och plats. Låt oss säga att en person vet hur man distribuerar en specifik komponent – om den personen inte är tillgänglig, är på semester eller är sjuk – då har ni problem.
Och den tredje grunden som vi har kommit fram till. Vi kom fram till den genom smärta, blod och tårar – vi kom fram till att varje byggnad innehåller fel, även om den är utan fel. Vi har bestämt oss för att: när vi distribuerar något, när vi går live med något – så innebär vår byggnad fel. Vi har formulerat krav som vårt system måste uppfylla.
Krav för byte av mjukvaruversion.
Det finns tre krav:
- Vi måste snabbt kunna rulla tillbaka distributionen.
- Vi måste minimera påverkan av en misslyckad distribution.
- Och vi måste kunna snabbt distribuera parallellt.
Precis i den ordningen! Varför? För att hastigheten vid distribution av en ny version inte är viktig i första hand, men det är viktigt för er att snabbt kunna rulla tillbaka om något går fel och minimera påverkan. Men om ni har en uppsättning versioner i produktion, där det visar sig att det finns ett fel (som snön från klar himmel, det har inte genomförts någon distribution, men felet finns) – så är hastigheten på efterföljande distribution viktig för er. Vad har vi gjort för att uppfylla dessa krav? Vi har tagit till en metodik:
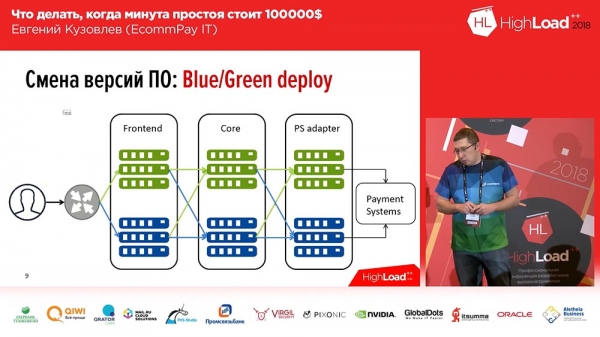
Den är ganska känd, vi har inte uppfunnit den – det är Blue/Green deployment. Vad är detta? För varje grupp av servrar som era applikationer körs på, bör det finnas en kopia. En "varm" kopia: det finns ingen trafik på den, men vid vilken tidpunkt som helst kan denna trafik skickas till kopian. Denna kopia innehåller den tidigare versionen. Och vid distributionen rullar ni ut koden på den inaktiva kopian. Sedan omdirigerar ni en del av trafiken (eller allt) till den nya versionen. Så för att ändra trafikflödet från den gamla versionen till den nya, behöver ni bara göra en åtgärd: ni behöver ändra lastbalanseraren upstream, ändra riktningen – från en upstream till en annan. Det är mycket bekvämt och löser problemet med snabb omkoppling, snabb återställning.Här är lösningen på den andra frågan – minimering: ni kan skicka till den nya linjen, på linjen med den nya koden, endast en del av er trafik (låt oss säga, till exempel 2%). Och dessa 2% är inte 100%! Om ni har förlorat 100% av trafiken vid en misslyckad distribution – det är skrämmande, om ni har förlorat 2% av trafiken – det är obehagligt, men det är inte skrämmande. Dessutom kommer användarna sannolikt inte ens att märka det, eftersom i vissa fall (inte alla) hamnar samma användare, när de trycker på F5, på en annan, fungerande version.
Blue/Green deployment. Routing
Men allt är inte så enkelt som att "göra Blue/Green deployment"… Alla våra komponenter kan delas in i tre grupper:
- det är frontend (betalningssidor som våra kunder ser);
- kärnan i bearbetningen;
- adapter för att arbeta med betalningssystem (banker, MasterCard, Visa…).
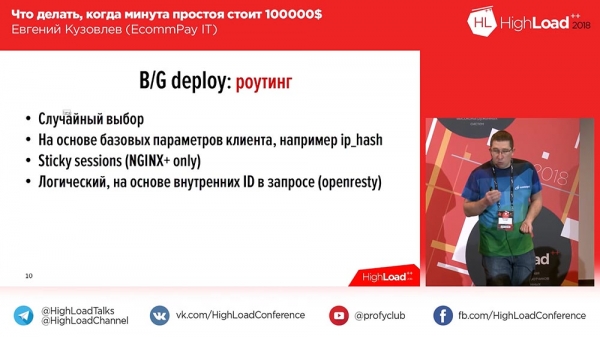
Och här finns en aspekt – aspekten handlar om routingen mellan linjerna. Om du bara växlar 100% av trafiken har du inga problem med det. Men om du vill växla 2% börjar frågorna dyka upp: "Hur gör man det?" Det enklaste sättet är direkt: du kan ställa in Random Selection, Round Robin i nginx, så att 2% går till vänster och 98% går till höger. Men det passar inte alltid.
Till exempel interagerar användaren med systemet inte med bara en förfrågan. Det är normalt: 2, 3, 4, 5 förfrågningar – dina system kan vara desamma. Och om det är viktigt för dig att alla användarförfrågningar går till samma linje som den första förfrågan, eller (det andra momentet) att alla användarförfrågningar går till en ny linje efter växlingen (användaren kan ha börjat arbeta med systemet tidigare, innan växlingen), – då passar inte den slumpmässiga fördelningen. Då finns det följande alternativ:
Det första alternativet, det enklaste – baserat på grundläggande parametrar från klienten (IP Hash). Du har en IP, och du delar upp den höger-vänster baserat på IP-adressen. Då fungerar det andra fallet som jag beskrev, när deployment har skett, och användaren redan kan ha börjat arbeta med ditt system, så från och med deployment går alla förfrågningar till den nya linjen (antingen den samma, låt säga).Om detta av någon anledning inte passar dig, och du måste nödvändigtvis skicka förfrågningar till den linje där den första, initierande användarförfrågan kom, då har du två alternativ...
Det första alternativet: du kan använda en betalversion av nginx+. Där finns det en mekanism för Sticky sessions, som vid den första förfrågan från användaren ställer in en session och kopplar den till en viss upstream. Alla efterföljande förfrågningar från användaren under sessionens livslängd kommer att skickas till samma upstream som sessionen kopplades till.Det passade inte oss, eftersom vi redan hade en vanlig nginx. Att byta till nginx+ – det var inte nödvändigtvis dyrt, men det var för oss något smärtsamt och inte helt rätt. "Sticky sessions" fungerade inte för oss, till exempel av den enkla anledningen att "Sticky sessions" inte ger möjlighet att routa enligt "eller-eller". Där kan man ställa in att vi gör "Sticky sessions", till exempel baserat på IP-adressen eller på både IP-adressen och cookies eller på postparameter, men "eller-eller" – där blir det svårare.
Därför kom vi fram till det fjärde alternativet. Vi använde Nginx på 'sterioder' (detta är OpenResty) – det är samma Nginx som dessutom stödjer att inkludera last-skript. Du kan skriva ett last-skript, ge det till denna 'OpenResty', och detta last-skript kommer att köras när en användarförfrågan kommer in.
Och vi skrev faktiskt ett sådant litet skript, installerade 'OpenResty' och i detta skript går vi igenom 6 olika parametrar genom konkatenering av 'Eller'. Beroende på tillgången till en viss parameter vet vi om användaren kommit till en sida eller en annan, till en linje eller en annan.
Blue/Green deploy. Fördelar och nackdelar.
Självklart hade vi kunnat göra det lite enklare (använda samma 'Sticky sessions'), men vi har dessutom den nyansen att inte bara användaren interagerar med oss inom en bearbetning av en transaktion... Utan dessutom interagerar betalningssystemen med oss: efter att vi har behandlat transaktionen (skickat en förfrågan till betalningssystemet) får vi en callback.
Om vi säger att inom vår kontur kan vi skicka användarens IP-adress med i alla förfrågningar och baserat på användarnas IP-adresser dela upp dem, så säger vi inte till 'Visa': 'Grabbar, vi är ett retroföretag, vi är liksom internationella (på hemsidan och i Ryssland)... Men skicka oss gärna användarens IP-adress i ett ytterligare fält, ert standardiserade protokoll'! Självklart kommer de inte att gå med på det.
Därför passade detta inte för oss – vi gjorde OpenResty. Följaktligen blev vår routning så här:Blue/Green deploy har, som sagt, fördelar och nackdelar.
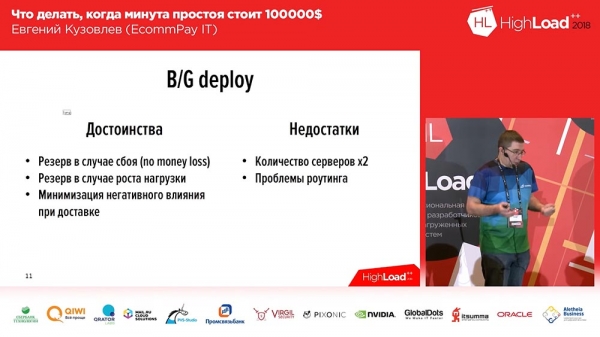
Det finns två nackdelar:
- du behöver lägga tid på routingen;
- den andra huvudsakliga nackdelen – kostnader.
Du behöver dubbelt så många servrar, du behöver dubbelt så många operativa resurser, du måste lägga dubbelt så mycket kraft på att upprätthålla hela denna djurpark.
Förresten, bland fördelarna finns ytterligare en sak jag inte nämnt tidigare: du har en reserv vid ökad belastning. Om du får en explosionsartad ökning av trafiken, och en stor mängd användare kommer, så sätter du bara på den andra linjen med en 50/50-fördelning – och plötsligt har du dubbelt så många servrar i din kluster tills du löser problemet med serverantalet.
Hur gör man en snabb deployment?
Vi diskuterade hur man löser problemet med minimalisering och snabb återställning, men frågan kvarstår: "Hur snabbt kan man deploya"?
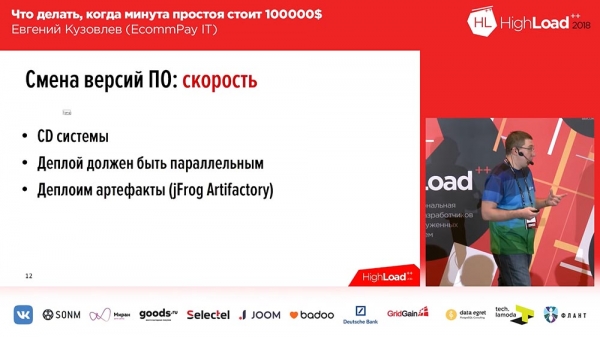
Här är det kort och enkelt.- Du måste ha ett CD-system (Continuous Delivery) – utan det går det inte. Om du har en server kan du deploya manuellt. Vi har ungefär ett och ett halvt tusen servrar, så klart kan vi inte ha ett team i storleken av det här rummet bara för att deploya.
- Deployment måste ske parallellt. Om din deployment är sekventiell, då är det dåligt. En server är okej, men att deploya tusen fem hundra servrar kommer ta hela dagen.
- Återigen, för att snabba upp processen, det här är nog inte nödvändigt längre. Vid deployment görs vanligtvis projektbyggande. Om du har ett webbprojekt finns det en frontend-del (du gör webbpaket, npm bygger – något liknande), och den processen är i princip inte lång – runt 5 minuter, men dessa 5 minuter kan vara kritiska. Därför gör vi till exempel så här: vi har tagit bort dessa 5 minuter, vi deployar artefakterna.
Vad är en artefakt? En artefakt är en byggnad som har genomgått hela byggprocessen. Denna artefakt lagrar vi i ett artefaktlager. Sådana lagrar har vi använt två stycken – det var Nexus och nu jFrog Artifactory. Vi använde ursprungligen "Nexus" eftersom vi började praktisera detta tillvägagångssätt i Java-applikationer (det passade bra för det). Sedan lade vi även in vissa applikationer skrivna i PHP där; och "Nexus" passade inte längre, och vi valde därför jFrog Artifactory, som kan hantera nästan allt. Vi har till och med kommit till den punkten att vi lagrar våra egna binärpaket, som vi bygger för servrar.
Explosiv ökning av belastning
Vi har pratat om att byta programversion. Nästa sak vi har är att det sker en explosiv ökning av belastningen. Här förstår jag kanske en felaktig sak om den explosiva ökningen av belastningen...
Vi har utvecklat ett nytt system – det är tjänsteorienterat, modernt och snyggt, med arbetare överallt, köer överallt, asynkronitet överallt. I sådana system kan data flöda genom olika kanaler. För den första transaktionen kan arbetare 1, 3 och 10 vara involverade, för den andra transaktionen – arbetare 2, 4 och 5. Och idag, låt oss säga, på morgonen har ni ett dataflöde som använder de tre första arbetarna, men på kvällen ändras det plötsligt, och alla tre andra arbetare används.
Och här blir det så att ni på något sätt behöver skala arbetarna, ni behöver på något sätt skala era tjänster, men utan att låta resurserna svälla.
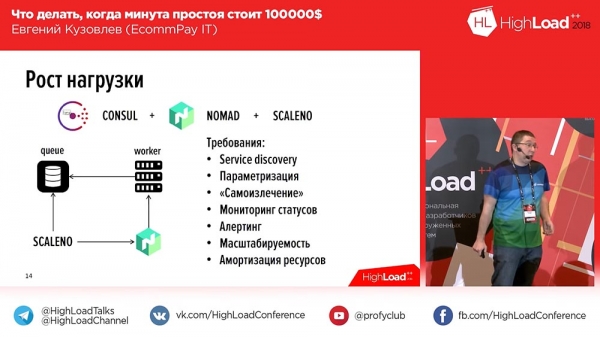
Vi har definierat våra krav. Dessa krav är ganska enkla: det ska finnas service discovery, parametrisering – allt standard för att bygga sådana skalbara system, förutom en punkt – resursamortisering. Vi har sagt att vi inte är redo att amortisera resurser för att låta servrarna värma luft. Vi har valt "Consul", vi har valt "Nomad" som hanterar våra arbetare.Varför är detta ett problem för oss? Låt oss backa lite. Just nu har vi cirka 70 betalningssystem bakom oss. På morgonen går trafiken genom "Sberbank", sedan kanske "Sberbank" går ner, och vi växlar till ett annat betalningssystem. Vi hade 100 arbetare som fungerade för "Sberbank", och efter det behöver vi plötsligt öka med 100 arbetare för det andra betalningssystemet. Och detta bör helst ske utan mänsklig medverkan. För om mänsklig medverkan är involverad måste en ingenjör sitta tillgänglig 24/7 och bara ta hand om detta, eftersom sådana störningar, när 70 system är kopplade till er, händer regelbundet.
Därför tittade vi på "Nomad", som har en öppen IP, och skrev vårt eget verktyg Scale-Nomad – ScaleNo, som gör ungefär följande: den övervakar köns tillväxt och minskar eller ökar antalet arbetare beroende på köns dynamik. När vi hade gjort det, tänkte vi: "Kanske vi ska open-sourcea det?" Sedan tittade vi på det – det är så enkelt som två ören.
Vi har fortfarande inte open-sourceat det, men om ni efter föredraget inser att ni behöver ett sådant verktyg, finns mina kontakter i den sista bilden – skriv gärna till mig. Om vi får ihop 3-5 personer – vi kommer att open-sourcea det.
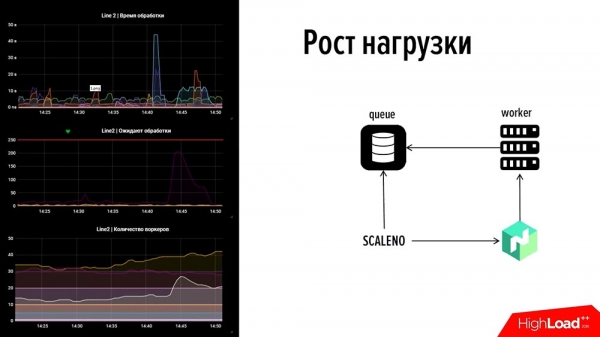
Hur fungerar det? Låt oss ta en titt! För att sammanfatta: till vänster finns en del av vår övervakning: det är en linje, överst – behandlingstiden för händelser, i mitten – antalet transaktioner, längst ner – antalet arbetare.Om vi tittar på denna bild finns det ett fel. I den övre grafen har en av kurvorna skjutits utanför 45 sekunder – en av betalningssystemen har kraschat. Här finns även trafik under 2 minuter och en ökning av kön i det andra betalningssystemet, där det inte fanns några arbetare (vi utnyttjade inte resurserna – tvärtom, vi utnyttjade resurserna korrekt). Vi ville inte överbelasta – där var det minimalt, omkring 5–10 arbetare, men de klarade inte av det.
I den sista grafen syns en 'knöl' som just visar att 'Skaleno' fördubblade detta antal. Och sedan, när grafen sjönk något, minskade han lite – antalet arbetare ändrades automatiskt. Så här fungerar detta. Vi pratade om punkt nummer 2 – 'Hur snabbt bli av med orsakerna'.
Övervakning. Hur snabbt identifierar man ett problem?
Nu är första punkten – 'Hur snabbt identifierar man ett problem?' Övervakning! Vi måste snabbt förstå vissa saker. Vilka saker måste vi snabbt förstå?
Tre saker!- Vi måste snabbt förstå och snabbt bedöma funktionaliteten hos våra egna resurser.
- Vi måste snabbt förstå om det sker en avbrott, övervaka funktionaliteten hos system som är externa för oss.
- Den tredje punkten – att identifiera logiska fel. Det är när systemet fungerar hos er, alla indikatorer är normala, men något går fel.
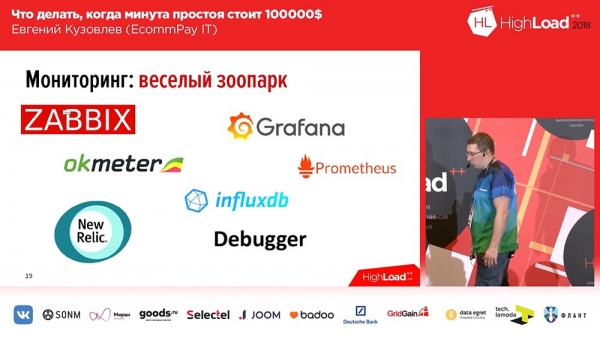
Här kommer jag nog inte att berätta något särskilt fantastiskt. Jag kommer att vara kaptenen Styrdig. Vi sökte efter vad som finns på marknaden. Vi har ett 'roligt zoo'. Så här ser vårt zoo ut just nu:
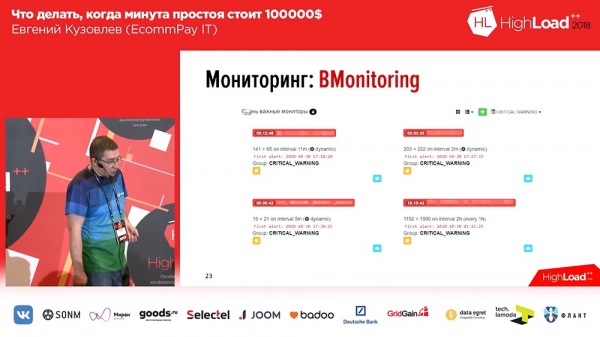
Vi använder 'Zabbix' för att övervaka 'hårdvara', för att övervaka de viktigaste serverindikatorerna. 'Okmeter' använder vi för databaser. 'Grafana' och 'Prometheus' använder vi för alla andra indikatorer som inte passade under de första två, delvis – med 'Grafana' och 'Prometheus', delvis – 'Grafana' med 'Influx' och Telegraf.För ett år sedan ville vi använda New Relic. En fantastisk grej, den kan göra allt. Men lika mycket som den kan, lika dyr är den. När vi växte till 1,5 tusen servrar kom en leverantör till oss och sa: «Låt oss teckna ett avtal för nästa år». Vi såg på priset och sa: nej, det tänker vi inte göra. Nu avstår vi från New Relic, vi har ungefär 15 servrar kvar under New Relics övervakning. Priset visade sig vara helt galet.
Och det finns ett verktyg som vi har implementerat själva – det är Debugger. Först kallade vi det «Bagger», men sedan kom vår engelsklärare och skrattade så mycket att vi bytte namn till «Debagger». Vad är det? Det är ett verktyg som i själva verket kör tester på allmän funktionalitet av komponenterna på 15-30 sekunder, som en «svart låda» av systemet.
Till exempel, om det är en extern sida (betalningssidan) – öppnar den bara sidan och ser hur den ska se ut. Om det handlar om bearbetning, skjuter den en testtransaktion – ser till att denna transaktion når fram. Om det handlar om kopplingen till betalningssystemen – skjuter vi en testförfrågan där vi kan och ser till att allt fungerar bra.
Vilka indikatorer är viktiga för övervakning?
Vad övervakar vi huvudsakligen? Vilka indikatorer är viktiga för oss?
- Svarstid / RPS på framsidan – en mycket viktig indikator. Den svarar direkt på att något är fel.
- Antal bearbetade meddelanden i alla köer.
- Antal arbetare.
- Huvudmetrik för korrekthet.
Den sista punkten – en «affärsmässig» metrik. Om du vill övervaka detsamma måste du bestämma en eller två indikatorer som är de viktigaste för dig. Vår metrik är genomströmning (det är förhållandet mellan antalet lyckade transaktioner och det totala flödet av transaktioner). Om något förändras inom 5-10-15 minuter – då har vi problem (om det förändras drastiskt).
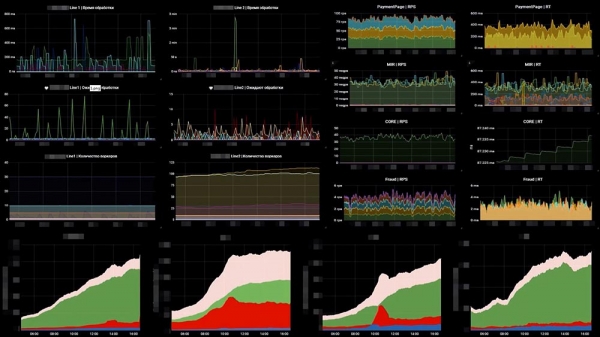
Hur ser det ut för oss – ett exempel på en av våra dashboards:
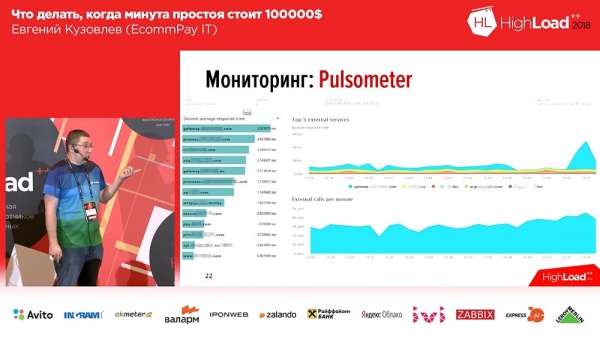
Till vänster finns 6 grafer, som visar linjerna - antalet arbetare och antalet meddelanden i köerna. Till höger - RPS, RTS. Längst ner - den så kallade "affärsmetrin". Och på "affärsmetrin" kan vi direkt se att något har gått fel på de två mittersta graferna... Det är just när det ytterligare en system har kraschat som står bakom oss.Det andra vi behövde göra var att övervaka nedstängningarna av externa betalningssystem. Här använde vi OpenTracing - en mekanism, standard, paradigm, som gör det möjligt att spåra distribuerade system; och vi modifierade det lite. Den standardiserade OpenTracing-paradigmen säger att vi bygger en spårning av varje enskild begäran. Det var inte vad vi behövde, så vi gjorde det till en total spårning, en aggregerad. Vi skapade ett verktyg som gör det möjligt för oss att övervaka hastigheten hos systemen som står bakom oss.
Grafen visar oss att ett av betalningssystemen började svara efter 3 sekunder - vi fick problem. Samtidigt reagerar denna grej när problemen började, med en tidsram på 20-30 sekunder.Och den tredje klassen av övervakningsfel som finns - det är logisk övervakning.
Ärligt talat visste jag inte vad jag skulle rita på den här bilden, eftersom vi länge letade på marknaden efter något som skulle passa oss. Vi hittade ingenting, så vi var tvungna att göra det själva.
Vad menar jag med logisk övervakning? Tänk dig: du skapar ett system (till exempel en klon av "Tinder"); du gör det, startar det. Den framgångsrika chefen Vasya Pupkin installerade det på sin telefon, ser en tjej, gillar henne... men like går inte till tjejen - like går till vakten Mikhailich i samma affärscentrum. Chefen går ner, och undrar sen: "Varför ler den här vakten Mikhailich så trevligt åt honom?"I sådana situationer... För oss låter denna situation lite annorlunda, eftersom (jag har skrivit) detta är en reputationsförlust som indirekt leder till finansiella förluster. Vi har motsatt situation: vi kan drabbas av direkta finansiella förluster – till exempel om vi har genomfört en transaktion som framgångsrik, men den var inte lyckad (eller tvärtom). Vi var tvungna att skriva vårt eget verktyg som följer antalet lyckade transaktioner i dynamik över en tidsperiod enligt affärsindikatorer. Vi hittade inget på marknaden! Det var den här tanken jag ville förmedla. För att lösa den här typen av uppgifter finns det inget på marknaden.
Detta var relaterat till frågan om hur man snabbt identifierar ett problem.
Hur man bestämmer orsakerna till deployment
Den tredje gruppen av uppgifter som vi löser – det är efter att vi har identifierat problemet, efter att vi har avfärdat det, skulle det vara bra att förstå orsaken för utveckling, för testning och att göra något åt det. Därför behöver vi forska, vi behöver samla loggar.
Om vi pratar om loggar (den huvudsakliga orsaken – loggar), så ligger huvuddelen av loggarna hos oss i ELK Stack – nästan alla har det så. Vissa kanske inte använder ELK, men om du skriver loggar i gigabyte så kommer du förr eller senare att landa i ELK. Vi skriver dem i terabyte.
Det finns ett problem här. Vi har fixat, rättat till ett fel för användaren, började gräva i vad det var, gick in i "Kibana", skrev in transaktions-ID:t och fick ut en sådan rullning (visar mycket). Och i denna rullning är ingenting klart. Varför? För att det är otydligt vilken del som tillhör vilken worker, vilken del som tillhör vilken komponent. Och i det ögonblicket insåg vi att vi behövde spårning – den där OpenTracing som jag nämnde.Vi tänkte på detta för ett år sedan, vände vårt fokus mot marknaden, och där visade det sig att det fanns två verktyg – det är "Zipkin" och "Jaeger". "Jaeger" är i praktiken en ideologisk arvinge, en ideologisk fortsättning på "Zipkin". I "Zipkin" är allt bra, förutom att det inte kan aggregera, kan inte inkludera loggar i spårningen, endast tidsmässig spårning. Och "Jaeger" stödde detta.
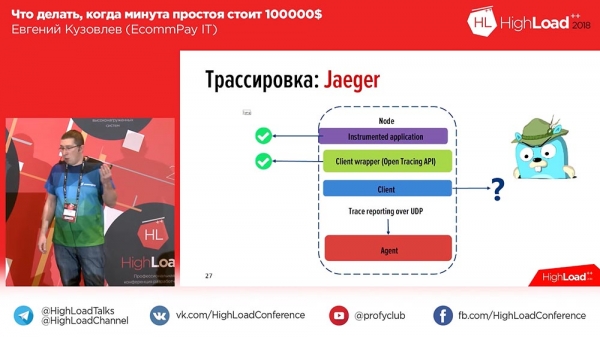
Vi tittade på "Eger"; vi kan instrumentera applikationer och skriva till API:et (standarden för API:et för PHP var vid den tidpunkten, som sagt, inte godkänd – det var för ett år sedan, och nu är den redan godkänd), och det fanns absolut ingen klient. "Okej", tänkte vi, och skrev vår egen klient. Vad fick vi till? Så här ser det ut:
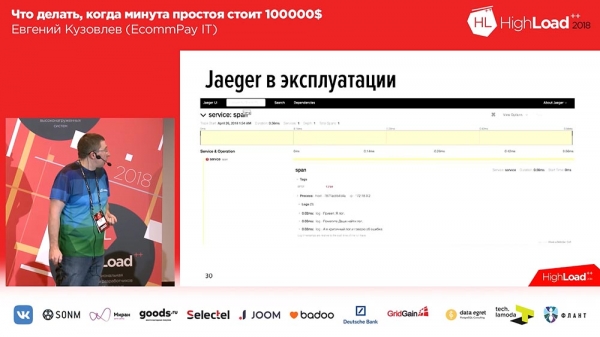
I "Eger" skapas spans för varje meddelande. Det innebär att när en användare öppnar systemet ser han en eller två block för varje inkommande förfrågan (1-2-3 – så många inkommande förfrågningar som användaren hade, så många block). För att underlätta för användarna har vi lagt till taggar till loggar och tids spårning. Därför, i händelse av ett fel, kommer vår applikation att markera loggen med den relevanta taggen Error. Man kan filtrera efter taggen Error och endast de spans som innehåller detta block med fel visas. Så här ser det ut när vi expanderar span:
Inuti span finns ett antal spårningar. I detta fall är det tre testspårningar, och den tredje spårningen säger oss att ett fel har inträffat. Här ser vi också tids spårningen: vi har en tidslinje högst upp, och vi kan se vid vilken tidsperiod loggen spelades in.Därför gick det mycket bra för oss. Vi skrev vårt eget tillägg och vi öppen källkodade det. Om du vill arbeta med spårning, om du vill arbeta med "Eger" på PHP-språket – här är vårt tillägg, välkommen till användning, som man säger:
Vårt tillägg är en klient för att arbeta med OpenTracing API, gjort som en php-tillägg, så att du kommer behöva samla ihop det och lägga in det i systemet. För ett år sedan fanns det ingenting annat. Nu har det kommit andra klienter, som komponenter. Här är det ditt val: antingen laddar du ner komponenterna med Composer, eller så använder du tillägget, upp till dig.Företagsstandarder
Vi talade om de tre buden. Det fjärde budet – att standardisera tillvägagångssätten. Vad handlar detta om? Det handlar ungefär om detta:
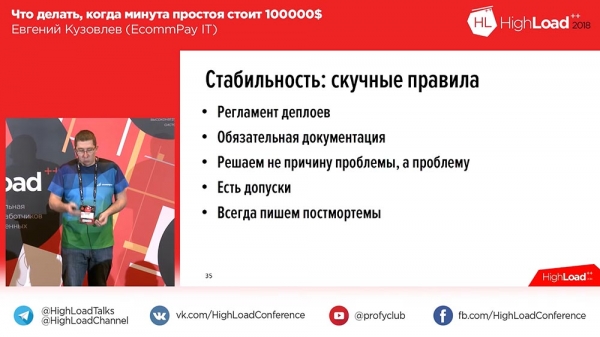
Varför ordet "företags" här? Inte för att vi är ett stort eller byråkratiskt företag, nej! Ordet "företags" ville jag använda här i betydelsen att varje företag, varje produkt måste ha sina egna standarder, och det gäller er också. Vilka standarder har vi?- Vi har riktlinjer för deployment. Utan dem kan vi inte gå framåt. Vi gör cirka 60 deployments i veckan, vilket innebär att vi ständigt har deploymentar. Vi har också en regel i våra riktlinjer för deploymentar att vi inte får göra några deploymentar på fredagar - som princip gör vi inga deploymentar.
- Vi har obligatorisk dokumentation. Ingen ny komponent går i produktion om det inte finns någon dokumentation för den, även om den skapades av våra RnD-team. Vi kräver en deploymentguide, en övervakningskarta och en ungefärlig beskrivning (ja, som programmerare kan skriva) av hur den här komponenten fungerar och hur man felsöker den.
- Vi löser inte problemet, utan orsaken – som jag redan nämnt. Det är viktigt för oss att skydda användaren från problem.
- Vi har toleranser. Till exempel anser vi inte att det är downtime om vi under två minuter tappar 2 % av trafiken. Det räknas i princip inte i vår statistik. Om det är mer i procent eller tidsram, då räknar vi det.
- Och vi skriver alltid post mortem-rapporter. Oavsett vad som händer, varje situation som uppträder onormalt i produktion kommer att återspeglas i post mortem-rapporten. En post mortem är ett dokument där du beskriver vad som hände, en detaljerad tidslinje för vad du gjorde för att åtgärda det och (detta är en obligatorisk del!) vad du kommer att göra för att undvika det i framtiden. Detta är nödvändigt för efterföljande analys.
Vad räknas som downtime?
Vad ledde allt detta till?Det ledde till att (vi hade vissa stabilitetsproblem som varken kunder eller vi var nöjda med) under de senaste 6 månaderna har vår stabilitetsnivå varit 99,97. Man kan säga att det inte är särskilt mycket. Ja, vi har målsättningar att sträva efter. Ungefär hälften av detta resultat är stabilitet som egentligen inte är vår, utan vår web application firewall som står framför oss och används som tjänst, men det spelar ingen roll för kunderna.
Vi har lärt oss att sova om natten. Äntligen! För sex månader sedan kunde vi inte. Och på denna not vill jag lägga till en kommentar. Igår kväll var det en fantastisk föreläsning om systemet för att styra kärnreaktorer. Om jag hör människor som har skrivit detta system – snälla, glöm det jag har sagt om "2 % – det är inte downtime". För er är 2 % downtime, även om det bara handlar om två minuter!
Det är allt! Era frågor.
Om lastbalanserare och migration från databasen
Fråga från publiken (härefter – F): – God kväll. Stort tack för en så bra administrativ presentation! Frågan är kort, om era lastbalanserare. Ni nämnde att ni har WAF, så jag förstår att ni använder någon extern lösning som lastbalanserare…
EK: – Nej, som lastbalanserare använder vi våra egna tjänster. I det här fallet är WAF enbart ett verktyg för att skydda mot DDoS-attacker.
L: – Kan ni ge några ord om lastbalanserare?
EK: – Som jag redan nämnt, det är en grupp servrar i openresty. Vi har just nu 5 grupper reserverade som enbart hanterar… det vill säga, servern som enbart har openresty installerat, den proxyar bara trafiken. För att förstå hur mycket vi hanterar: just nu har vi en standard trafikbelastning på flera hundra megabit. De klarar det bra, de anstränger sig inte ens.
L: – Ännu en enkel fråga. Det finns Blue/Green deployment. Vad gör ni till exempel med databas-migrationer?
EK: – Bra fråga! Titta, i vårt Blue/Green deployment har vi separata köer för varje linje. Det vill säga, när vi pratar om händelseköer som överförs från arbetare till arbetare, finns det separata köer för blå linje och grön linje. När vi pratar om själva databasen, har vi avsiktligt smalnat av den efter bästa förmåga, vi har nästan allt flyttat till köer, i databasen lagrar vi endast transaktionsstacken. Och transaktionsstacken är gemensam för alla linjer. När det gäller databasen i detta sammanhang: vi delar inte upp den på blå och grön, eftersom båda kodalternativen måste veta vad som händer med transaktionen.
Vänner, jag har en liten prisatt som jag vill ge er – en bok. Jag behöver ge den för den bästa frågan.
L: – Hej. Tack för presentationen. Här är en fråga. Ni övervakar betalningar, ni övervakar tjänster som ni kommunicerar med… Men hur övervakar ni att en person på något sätt kommit till er betalningssida, genomfört betalningen, och projektet har krediterat pengarna? Det vill säga, hur övervakar ni att märket är tillgängligt och har accepterat ert callback?
EK: – "Märket" för oss i detta fall är exakt som vilken extern tjänst som helst, såsom betalningssystemet. Vi övervakar svarstiden för "märket".
Om databasens kryptering
L: – Hej. Jag har en liten fråga bredvid. Ni har känsliga data enligt PCI DSS. Jag ville veta hur ni lagrar PAN:er i köerna som ni behöver bearbeta? Använder ni någon kryptering? Och här är den följdfrågan: enligt PCI DSS måste databasen krypteras om igen periodiskt vid förändringar (till exempel uppsägning av administratörer) – hur går det till med tillgängligheten i sådana fall?
EK: – Utmärkt fråga! För det första lagrar vi inte PAN:er i köerna. Vi har egentligen inte rätt att lagra PAN överhuvudtaget i okrypterad form, så vi använder en speciell tjänst (vi kallar den "Keydemon") – det är en tjänst som gör en enda sak: den tar emot ett meddelande och ger ett krypterat meddelande i utbyte. Och vi lagrar allt med detta krypterade meddelande. Därför är nyckellängden under en kilobyte för att det ska vara riktigt säkert och pålitligt.L: – Behövs det redan 2 kilobyte nu?
EK: – Det var väl 256 igår… Hur mycket mer kan man behöva?!
Detta är det första. För det andra stöder lösningen en procedur för ny kryptering – det finns två nyckelpärsar (kekar) som ger dek som krypterar (key är nycklar, dek är derivat av nycklar som krypterar). Och vid initiering av proceduren (den genomförs regelbundet, från 3 månader till ± något) laddar vi en ny nyckelpärs, och vi genomför krypteringen på nytt. Vi har separata tjänster som drar ut alla data, krypterar dem på nytt; varje data har en identifierare för den nyckel som de är krypterade med. Så snart vi har krypterat data med de nya nycklarna raderar vi de gamla nycklarna.
Ibland behöver betalningar genomföras manuellt…
L: – Så om det har kommit en återbetalning för någon transaktion, krypterar ni med den gamla nyckeln?
EK: – Ja.
L: – Då har jag en liten fråga till. När det inträffar något fel, ett haveri, en incident, måste transaktionen drivas igenom manuellt. Sådana situationer uppstår.
EK: – Ja, det händer.
L: – Var får ni dessa data ifrån? Eller går ni själva manuellt in i detta lagringsutrymme?
EK: – Nej, det är klart – vi har ett slags backoffice-system som innehåller ett gränssnitt för vår support. Om vi inte vet vilket status en transaktion har (till exempel om betalningssystemet har svarat med timeout) – så vet vi per automatik inte, det vill säga vi tilldelar det slutliga statusen först när vi är helt säkra. I det fallet klassificerar vi transaktionen i ett speciellt status för manuell behandling. På morgonen nästa dag, så snart supporten får information om att det finns sådana transaktioner kvar i betalningssystemet, behandlar de dem manuellt i detta gränssnitt.
L: – Jag har ett par frågor. En av dem handlar om fortsättningen av PCI DSS-zonen: hur extraherar ni loggar från deras kontur? Jag ställer denna fråga eftersom utvecklaren kan ha lagt vad som helst i loggarna! Den andra frågan: hur implementerar ni hotfixar? Att göra det manuellt i databasen är ett alternativ, men kan det finnas gratis hotfixar – vad är då rutinen? Och den tredje frågan, som nog handlar om RTO och RPO. Ni hade en tillgänglighet på 99,97, nästan fyra nollor, men jag förstår att ni har en andra datacenter och en tredje datacenter och en femte datacenter… Hur synkroniserar ni dem, replikationen och allt annat?EK: – Låt oss börja med den första. Var den första frågan om loggar? När loggar skrivs finns det ett lager som maskerar alla känsliga data. Det ser på mönstret och på ytterligare fält. Följaktligen kommer våra loggar ut med redan maskerade uppgifter och PCI DSS-konturen. Detta är en av de regelbundna uppgifterna som tilldelas testavdelningen. De är skyldiga att kontrollera varje uppgift, inklusive de loggar de skriver, och detta är en av de regelbundna uppgifterna vid kodgranskning, för att säkerställa att utvecklaren inte har registrerat något oönskat. Den efterföljande kontrollen genomförs regelbundet av informationssäkerhetsavdelningen ungefär en gång i veckan: loggar från den senaste dagen väljs slumpmässigt och körs genom en speciell skanner-analysator från testservrar för att kontrollera allt detta.
Om hotfixar. Det är inkluderat i vår utplacering av regler. Vi har en separat punkt angående hotfixar. Vi anser att vi distribuerar hotfixar dygnet runt när vi behöver det. Så snart versionen är byggd, så snart den har körts, så snart vi har artefakten – så tillkallas en jouransvarig systemadministratör från supporten, och han distribuerar det i det ögonblick som det behövs.Om "fyra nior". Den siffra vi har nu har verkligen uppnåtts, och vi har strävat efter den även med ett annat datacenter. Nu har vi ett andra datacenter, och vi börjar routa mellan dem, och frågan om replikering mellan datacentren är verkligen en icke-trivial fråga. Vi har försökt lösa det på olika sätt: vi försökte använda "Tarantul" – vi lyckades inte, det säger jag direkt. Därför kom vi fram till att vi gör en "senza" beställning manuellt. Varje applikation kör faktiskt den nödvändiga synkroniseringen av "change – done" asynkront mellan datacentren.
L: – Om ni har fått en andra, varför har ni inte fått en tredje? För att Split-brain ingen...
EK: – Och vi har inget "Split-brain". Eftersom varje applikation kör multimaster, spelar det ingen roll till vilket centrum förfrågan kom. Vi är beredda på att om vårt ena datacenter faller (det planerar vi för) och mitt i en användarförfrågan växlar till det andra datacentret, är vi beredda att förlora den användaren, verkligen; men det kommer att vara få, absolut få.
L: – God kväll. Tack för presentationen. Ni pratade om er debugger som kör vissa testtransaktioner i produktion. Men berätta om testtransaktionerna! Hur djupt går det?
EK: – Det går igenom hela cykeln av hela komponenten. För komponenten finns ingen skillnad mellan testtransaktion och produktionstransaktion. Ur logikens synvinkel är det helt enkelt ett separat projekt i systemet, där endast testtransaktioner körs.
L: – Och var avskär ni den? Här skickade Core...
EK: – Vi följer "Core" i det här fallet för testtransaktioner... Vi har ett begrepp som heter routing: "Core" vet till vilket betalningssystem det ska skicka – vi skickar till ett falskt betalningssystem som helt enkelt ger en http-respons och inget mer.
L: – Kan ni berätta, är ert program skrivet som en stor monolit, eller har ni delat upp det i några tjänster eller till och med mikrotjänster?
EK: – Det är inte en monolit, självklart, vi har en tjänsteorienterad applikation. Vi har ett skämt om att vi har tjänster bestående av monoliter – de är faktiskt ganska stora. Att kalla det för mikrotjänster känns inte riktigt rätt, men det är trots allt tjänster där arbetare från distribuerade maskiner arbetar.
Om en tjänst på servern har blivit komprometterad...
L: – Då har jag en följdfråga. Även om det skulle vara en monolit, har ni fortfarande många av dessa instant-servrar, alla hanterar i princip data, och frågan är: "Vid en kompromiss av en av instant-servrarna eller applikationen, av en specifik del, finns det något slags åtkomstkontroll? Vem kan göra vad? Vem ska man vända sig till för att få någon information?
EK: – Ja, utan tvekan. Säkerhetskraven är ganska strikta. För det första har vi öppna datarörelser, och portar är endast de som vi i förväg förutser kommer att hantera trafik. Om en komponent kommunicerar med databasen (säg, med MySQL) via 5-4-3-2, kommer den endast att ha 5-4-3-2 öppna, och andra portar, andra trafikriktningar kommer inte att vara tillgängliga. Dessutom bör man förstå att vi i produktion har cirka 10 olika säkerhetszoner. Och även om applikationen på något sätt skulle blivit komprometterad, Gud förbjude, så kan angriparen inte få åtkomst till serveradministrationskonsolen, eftersom det är en annan säkerhetszon.L: – I det här sammanhanget är jag mer intresserad av den punkt att ni har vissa avtal med tjänster – vad de kan göra, genom vilka "åtgärder" de kan kommunicera med varandra... Och i ett normalt flöde begär vissa specifika tjänster en viss rad av "åtgärder" från den andra. De vänder sig normalt sett inte till andra, och har andra ansvarsområden. Om en av dem skulle bli komprometterad, kan den då dra nytta av "åtgärderna" från den tjänsten?
EK: – Jag förstår. Om kommunikation generellt var tillåten med en annan server i en normal situation, ja. Enligt SLA-kontraktet övervakar vi inte att du bara har tillåtelse för de första 3 "åtgärderna", medan den fjärde "åtgärden" inte är tillåten. Det skulle nog vara överflödigt för oss, eftersom vi redan har ett 4-nivå skyddssystem för konturer. Vi föredrar att skydda oss på konturnivå snarare än på nivå med interna komponenter.
Hur Visa, MasterCard och "Sberbank" fungerar
L: – Jag vill förtydliga en punkt om användarens växling från ett datacenter till ett annat. Såvitt jag vet arbetar "Visa" och "MasterCard" enligt det binära synkrona protokollet 8583, där finns mixar. Jag ville veta, menar vi nu växlingen – är det direkt med "Visa" och "MasterCard" eller till betalningssystemen, till processorer?
EK: – Det handlar om mixarna. Mixarna har vi i ett datacenter.
L: – Grovt sagt, har ni en anslutningspunkt?
EK: – För "Visa" och "MasterCard" – ja. Bara för att "Visa" och "MasterCard" kräver ganska stora investeringar i infrastruktur för att ingå separata kontrakt för att få ett andra par mixar, till exempel. De är reserverade inom ett datacenter, men om vårt datacenter, Gud förbjude, kraschar där mixarna för anslutning till "Visa" och "MasterCard" står, så kommer vi att förlora kontakten med "Visa" och "MasterCard"…
L: – Hur kan de vara reserverade? Jag vet att "Visa" tillåter att hålla bara en anslutning i princip!
EK: – De levererar själva utrustningen. Hur som helst, vi har fått utrustning som är hårdvarumässigt reserverad.
L: – Så det är rack från deras Connects Orange..?
EK: – Ja.
L: – Men hur är det i det här fallet: om ert datacenter försvinner, hur kan ni använda det framöver? Eller stannar helt enkelt trafiken?
EK: – Nej. I det här fallet kommer vi helt enkelt att växla trafiken till en annan kanal som, naturligtvis, blir dyrare för oss, dyrare för kunderna. Men trafiken kommer inte att gå genom vårt direkta anslutning till "Visa", "MasterCard", utan genom villkorlig "Sberbank" (mycket förenklat).
Jag ber om ursäkt om jag har berört anställda på "Sberbank". Men enligt vår statistik, av ryska banker, kraschar "Sberbank" oftast. Det går knappt en månad utan att "Sberbank" skulle ha något som går ner.

Lite reklam 🙂
Tack för att ni stannar kvar hos oss. Gillar ni våra artiklar? Vill ni se fler intressanta material? Stöd oss genom att göra en beställning eller rekommendera oss till era vänner, , en unik motsvarighet till entry-level servrar som vi har skapat för er: (alternativ med RAID1 och RAID10 finns tillgängliga, upp till 24 kärnor och upp till 40GB DDR4).
Dell R730xd är två gånger billigare i datacentret Equinix Tier IV i Amsterdam? Bara hos oss i Nederländerna! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — från $99! Läs om
Källa: habr.com
