

Nästa konferens HighLoad++ äger rum den 6 och 7 april 2020 i Sankt Petersburg.
Detaljer och biljetter . HighLoad++ Sibirien 2019. Sal "Krasnojarsk". 25 juni, 12:00. Sammanfattningar och .
Det förekommer att praktiska krav krockar med teorin, där viktiga aspekter för kommersiella produkter inte beaktas. I detta föredrag presenteras processen för att välja och kombinera olika metoder för att skapa komponenter för kausal konsistens baserat på akademiska studier, med utgångspunkt i kraven för kommersiella produkter. Lyssnarna får veta mer om de teoretiska metoderna för logiska klockor, beroendespårning, systemettänkande, klocksynchronisering, och varför MongoDB valde vissa lösningar.
Mikhail Tyulenev (hädanefter MT): – Jag kommer att prata om kausal konsistens – en funktion som vi arbetade med på MongoDB. Jag jobbar i gruppen för distribuerade system, vi utvecklade den för cirka två år sedan.
Under processen var jag tvungen att bekanta mig med en stor mängd akademisk forskning, eftersom denna funktion är ganska välstudierad. Det visade sig att ingen artikel passar in i vad som krävs i produktion, en databas med mycket specifika krav som i stort sett finns i alla produktionsapplikationer.
Jag kommer att diskutera hur vi, som konsumenter av akademisk forskning, förbereder något sådant som vi sedan kan erbjuda våra användare i form av en färdig produkt, som är bekväm och säker att använda.
Kausal konsistens. Definiera termer
Till att börja med vill jag i allmänna termer förklara vad kausal konsistens är. Det finns två karaktärer – Leonard och Penny (från serien "Den stora upptäckten"):
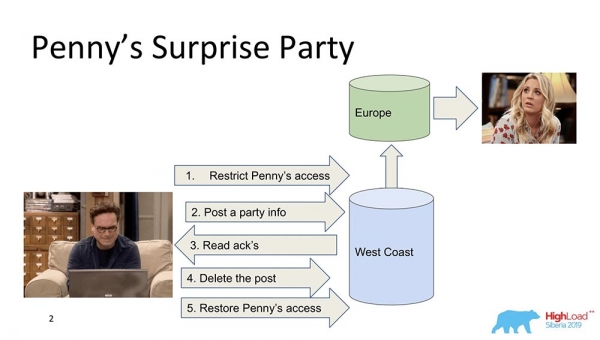
Anta att Penny är i Europa, och Leonard vill göra en överraskning för henne, en fest. Och han kommer inte på något bättre än att ta bort henne från vänlistan, skicka en uppdatering till alla sina vänner på flödet: "Låt oss glädja Penny!" (hon är i Europa, sover, ser inget av detta och kan inte se, eftersom hon inte är där). I slutet tar han bort det inlägget, raderar det från "Flödet" och återställer tillgången så att hon inte märker något och inga skandaler uppstår.
Det här är allt utmärkt, men låt oss anta att systemet är distribuerat och att händelserna inte har gått riktigt som de borde. Det kan till exempel hända att begränsningen av access till Penny inträffade efter att detta inlägg postades, om händelserna inte är relaterade till varandra med orsakssamband. Detta är i själva verket ett exempel på när kausal konsistens krävs för att genomföra en affärsfunktion (i detta fall).
Detta är faktiskt ganska icke-triviala egenskaper hos databaser – mycket få system stödjer dem. Låt oss gå vidare till modellerna.
Konsistensmodeller (Consistency Models)
Vad är egentligen en konsistensmodell i databaser? Det är vissa garantier som ett distribuerat system ger angående vilka data och i vilken ordning en kund kan få dem.
I princip kan alla konsistensmodeller reduceras till hur likt det distribuerade systemet fungerar som ett system som till exempel körs på en nod på en bärbar dator. Och i vilken grad ett system som körs på tusentals geografiskt distribuerade noder liknar en bärbar dator där alla dessa egenskaper uppfylls automatiskt.
Därför tillämpas konsistensmodeller endast på distribuerade system. Alla system som tidigare existerade och fungerade med vertikal skalning upplevde inte sådana problem. Det fanns en Buffer Cache och all data lästes alltid därifrån.
Stark modell
Den allra första modellen är den Starka (eller Linearity, som den ofta kallas). Det är en konsistensmodell som garanterar att varje ändring, så snart den bekräftas, blir synlig för alla användare av systemet.
Detta skapar en global ordning för alla händelser i databasen. Detta är en mycket stark konsistensegenskap och den är dessutom kostsam. Ändå har den mycket bra stöd. Den är bara mycket dyr och långsam – den används sällan. Detta kallas linearitet.
Det finns en annan, ännu starkare egenskap som stöds i 'Spanner' – den kallas extern konsistens. Vi kommer att prata mer om det senare.
Kausal
Nästa är Causal, precis det jag pratade om. Mellan Strong och Causal finns det ytterligare några undernivåer, som jag inte kommer att gå in på, men de alla relaterar till Causal. Detta är en viktig modell, eftersom den är den starkaste av alla modeller, den starkaste konsistensen vid nätverk eller partitioner.
Causals är faktiskt en situation där händelser är kopplade genom orsak och verkan. De uppfattas ofta som Read your on rights ur kundens perspektiv. Om en kund har observerat vissa värden kan han eller hon inte se värden som fanns i det förflutna. De börjar redan se prefixläsningar. Allt detta handlar om samma sak.
Causals som en konsistensmodell innebär en partiell ordning av händelser på servern där händelser från alla kunder observeras i samma sekvens. I detta fall – Leonard och Penny.
Eventual
Den tredje modellen är Eventual Consistency. Detta är något som alla distribuerade system stöder, den minimi modell som överhuvudtaget är meningsfull. Den innebär följande: när vi gör vissa förändringar i data, blir de vid en viss tidpunkt konsistenta.
Vid den tidpunkten säger den ingenting, annars skulle den ha blivit External Consistency – det skulle ha blivit en helt annan historia. Trots det är detta en mycket populär modell, den mest utbredda. Som standard använder alla användare av distribuerade system Eventual Consistency.
Jag vill ge några jämförande exempel:
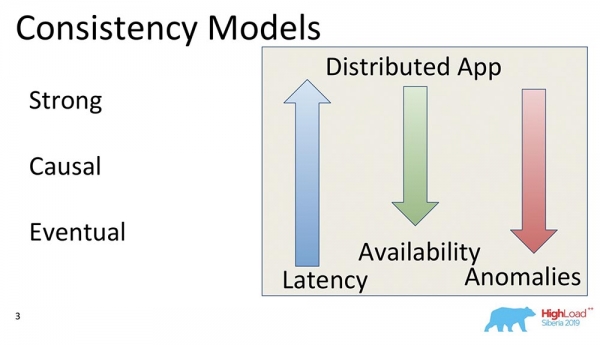
Vad betyder dessa pilar?
- Latens. När styrkan i konsistensen ökar blir den större av uppenbara skäl: man behöver göra fler skrivningar, få bekräftelse från alla värdar och noder som deltar i klustret på att data redan finns där. Därför ger Eventual Consistency det snabbaste svaret, eftersom man vanligtvis kan committa även i minnet och att detta i princip räcker.
- Tillgänglighet. Om detta förstås som systemets möjlighet att svara vid nätverksavbrott, partitioner eller några typer av fel – ökar felmotståndet när konsistensmodellen minskar, eftersom vi bara behöver att en värd fungerar och samtidigt ger viss data. Eventual Consistency garanterar överhuvudtaget ingenting om data – det kan vara vad som helst.
- Anomalier. Det är dock självklart att antalet anomalier ökar. I stark konsistens bör det knappt förekomma några, medan eventual consistency kan ha vilka anomalier som helst. Frågan uppstår: varför väljer människor eventual consistency om den innehåller anomalier? Svaret ligger i att eventual consistency-modeller är tillämpliga och anomalier finns, till exempel under en kort tid; det finns möjlighet att använda en master för att läsa och mer eller mindre läsa konsekventa data; det finns ofta möjlighet att använda starka konsistensmodeller. Praktiskt fungerar detta, och ofta är antalet anomalier tidsbegränsat.
CAP-teoremet
När du ser orden konsistens, tillgänglighet – vad kommer då till ditt sinne? Rätt, CAP-teoremet! Jag vill nu avfärda en myt... Det är inte jag – det är Martin Kleppmann som har skrivit en utmärkt artikel, en utmärkt bok.
CAP-teoremet är ett principiellt uttalande som formulerades under 2000-talet, om att konsistens, tillgänglighet och partitioner: ta vilken som helst av de två, och du kan inte välja tre. Det var ett slags princip. Det bevisades som en teorem några år senare av Gilbert och Lynch. Sedan började det använda som en mantra – system började delas upp i CA, CP, AP och så vidare.
Detta teorem bevisades faktiskt för specifika fall... Först betraktades tillgänglighet inte som ett kontinuerligt värde från noll till hundra (0 – systemet "dött", 100 – svarar snabbt; vi är vana vid att se det så), utan som en egenskap hos en algoritm som garanterar att den vid alla sina körningar återger data.
Det finns ingen information om svarstiden! Det finns en algoritm som returnerar data efter 100 år – en helt utmärkt tillgänglig algoritm, som är en del av CAP-teoremet.
För det andra: teoremet bevisades för förändringar i värdena av samma nyckel, medan dessa förändringar är en resizable-linje. Det betyder att de i praktiken nästan inte används eftersom andra modeller, eventual consistency, strong consistency (kan vara) är mer tillämpbara.
Vad leder allt detta till? Jo, att CAP-teoremet i den form det bevisats är praktiskt taget inte tillämpligt, sällan används. I teoretisk form begränsar det på något sätt allt. Det blir en slags princip som är intuitivt korrekt men på något sätt inte bevisad.
Causal consistency – den starkaste modellen
Det som händer just nu är att man kan få alla tre saker: Konsistens, Tillgänglighet kan uppnås med Partitioner. Särskilt Causal consistency – den starkaste konsistensmodellen, som trots Partitioner (nätverksavbrott) fortfarande fungerar. Därför är den av så stort intresse, och därför har vi arbetat med den.
För det första förenklar den utvecklarnas arbete. Speciellt finns det stort stöd från servern: när alla poster som görs av en enda klient garanterat kommer i rätt ordning till en annan klient. För det andra klarar den av partitioner.
Den interna verksamheten i MongoDB
Med tanke på att det är lunch, rör vi oss till köket. Jag kommer att förklara systemmodellen, nämligen vad MongoDB är för dem som hör talas om denna databas för första gången.
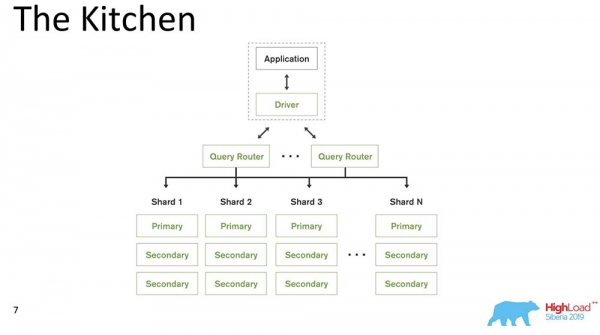
MongoDB (nedan kallad "MongoDB") är ett distribuerat system som stöder horisontell skalning, det vill säga sharding; och inom varje shard stöder den också dataröda, det vill säga replikering.
Sharding i "MongoDB" (en icke-relationell databas) utför automatisk balans, vilket innebär att varje dokumentkollektion (eller "tabell" i relationella datatermer) delas upp i bitar, och servern flyttar automatiskt dem mellan sharden.
Query Router, som distribuerar förfrågningar, är en slags klient för kunden, genom vilken denne arbetar. Den vet redan var och vilka data som finns, och dirigerar alla förfrågningar till rätt shard.
Ytterligare en viktig punkt: MongoDB är en single master. Det finns en Primary – den kan ta emot poster som stödjer de nycklar den innehåller. Multi-master skrivning är inte möjligt.
Vi har släppt version 4.2 – där finns nya intressanta saker. Särskilt har vi infört Lucene – sökningen – precis executable java direkt i "Mongo", och där kan man göra sökningar via Lucene, på samma sätt som i "Elasticsearch".
Och vi har skapat en ny produkt - Charts, som också är tillgänglig på "Atlas" (Mongo's egna moln). De har en Free Tier – man kan leka med detta. Charts tyckte jag mycket om – datavisualisering, mycket intuitiv.
Ingredienser till Causal consistency
Jag har räknat till cirka 230 artiklar som har publicerats om detta ämne – av Leslie Lamport. Nu kommer jag att återge några delar av dessa material från mitt minne.
Allt började med en artikel av Leslie Lampert som skrevs på 1970-talet. Som ni kan se fortsätter forskningen inom detta ämne fortfarande. Just nu får Causal consistency nytt intresse i samband med utvecklingen av distribuerade system.
Begränsningar
Vilka begränsningar finns? Detta är faktiskt en av de viktigaste punkterna eftersom begränsningarna som ställs av produktionssystem skiljer sig kraftigt från de som finns i akademiska artiklar. Ofta är de ganska artificiella.
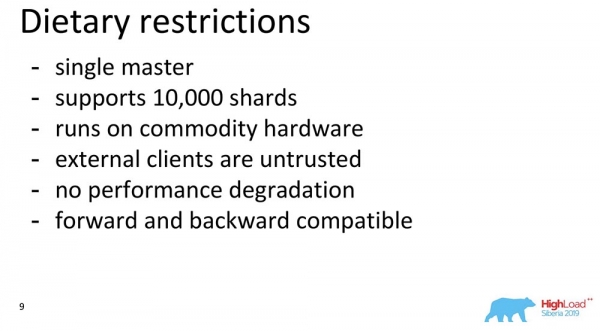
- För det första är "MongoDB" ett single master, som jag redan har sagt (detta förenklar mycket).
- Vi anser att systemet bör stödja omkring 10 000 shards. Vi kan inte fatta arkitektoniska beslut som uppenbart skulle begränsa detta värde.
- Vi har en molntjänst, men vi anser att användare ska ha möjligheten att ladda ner en binär och köra den på sin laptop, och allt ska fungera perfekt.
- Vi förutsätter att det som sällan används i forskning är: externa klienter kan göra vad de vill. "MongoDB" är open source. Således kan klienterna vara smarta, elaka – de kan vilja förstöra allt. Vi förutsätter att bysantinska fel kan inträffa.
- För externa klienter, som befinner sig utanför perimeterna – en viktig begränsning: om den här funktionen är avstängd, bör inga prestandaförsämringar observeras.
- En annan punkt – överhuvudtaget antiakademisk: kompatibilitet mellan tidigare versioner och framtida. Gamla drivrutiner måste stödja nya uppdateringar, och databasen måste stödja gamla drivrutiner.
I stort sett ställer allt detta upp begränsningar.
Komponenter av Causal consistency
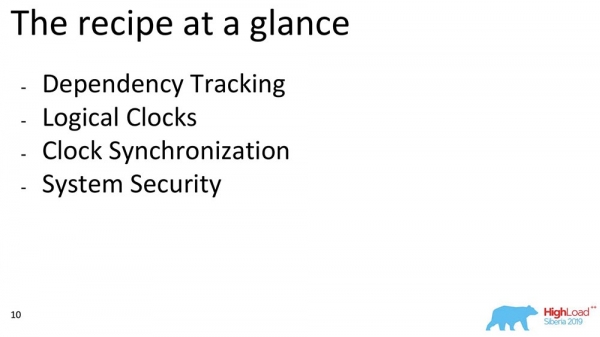
Jag kommer nu att tala om några av komponenterna. Om man överhuvudtaget ser på Causal consistency kan man identifiera block. Vi valde från arbeten som relaterar till något block: Dependency Tracking, valet av klockor, hur dessa klockor kan synkroniseras och hur vi säkerställer säkerheten – detta är en ungefärlig plan för vad jag kommer att tala om:
Fullständig spårning av beroenden (Full Dependency Tracking)
Varför behövs det? För att när data replikeras, ska varje post och varje ändring av data innehålla information om vilka förändringar den är beroende av. Den allra första och mest grundläggande förändringen är när varje meddelande, som innehåller en post, även innehåller information om tidigare meddelanden:
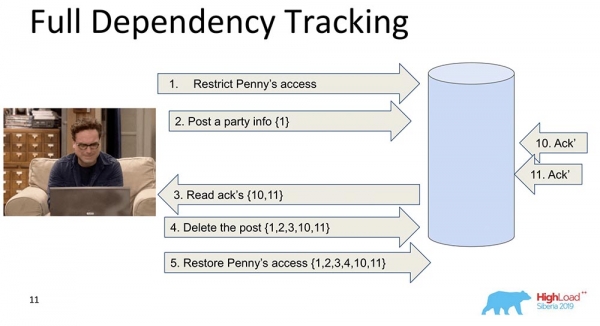
I det här exemplet representerar numret inom klamrarna – posternas nummer. Ibland överförs dessa poster med värden till och med helt, ibland överförs vissa versioner. Poängen är att varje ändring innehåller information om den föregående (den bär tydligt detta i sig).
Varför beslutade vi oss för att inte använda den metoden (full spårning)? Uppenbart för att denna metod är opraktisk: varje förändring i ett socialt nätverk beror på alla tidigare förändringar i det sociala nätverket, vilket skulle innebära att man måste skicka, låt oss säga, "Facebook" eller "VKontakte" i varje uppdatering. Det finns dock många studier om Full Dependency Tracking – detta före sociala medier, vilket fungerar i vissa situationer.
Tydlig spårning av beroenden (Explicit Dependency Tracking)
Den följande metoden är mer begränsad. Här diskuteras också överföringen av information, men endast den som är tydligt beroende. Vad som beror på vad bestäms vanligtvis av applikationen. När data replikeras, ges endast svar när tidigare beroenden har uppfyllts, det vill säga när de har visats. Det är själva essensen av hur kausal konsistens fungerar.
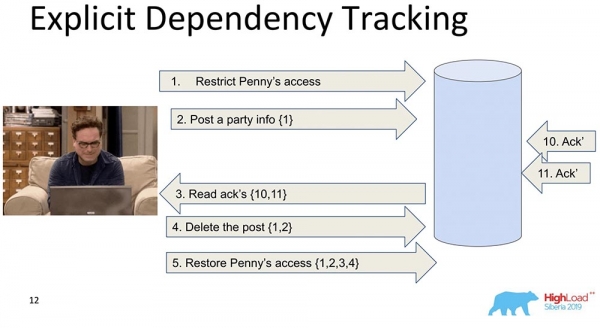
Den ser att post 5 är beroende av poster 1, 2, 3, 4 – därmed väntar den innan klienten får tillgång till de ändringar som gjorts av Penny's access-beslut, när alla tidigare ändringar redan har utförts i databasen.
Detta passar oss inte heller, eftersom det fortfarande finns för mycket information, och detta kommer att sakta ner processen. Det finns en annan metod…
Lamports klocka (Lamport Clock)
De är mycket gamla. Lamport Clock innebär att dessa beroenden sammanfattas i en skalarfunktion, som kallas Lamport Clock.
En skalar funktion är ett abstrakt tal. Den kallas ofta för logisk tid. Vid varje händelse ökar denna counter. Den counter som processen just nu känner till skickar varje meddelande. Det är klart att processerna kan vara desynkroniserade, de kan ha helt olika tider. Ändå balanserar systemet på något sätt klockorna genom denna meddelandeutbyte. Vad händer i så fall?
Jag delade den stora shard i två för att göra det tydligt: Vänner kan bo på en nod som innehåller en del av samlingen, medan Feed – helt på en annan nod, som innehåller en del av denna samling. Hur kan de då hamna utanför kön? Först säger Feed: "Replikerad", och sedan – Vänner. Om systemet inte garanterar att Feed inte kommer att visas förrän beroenden för Vänner i samlingen också har levererats, så kommer vi precis att få den situation som jag nämnde.
Du ser hur den logiska tiden för counter på Feed ökar:
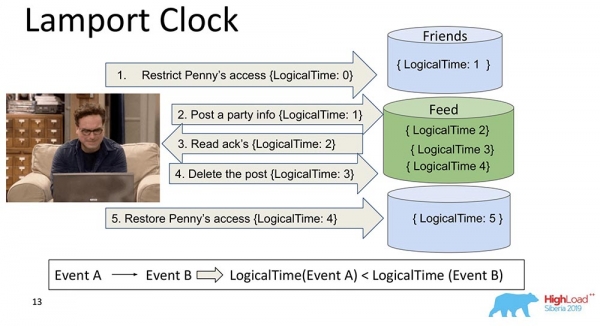
Därför är huvudegenskapen hos denna Lamport-klocka och kausal konsistens (förklarad genom Lamport-klockan) följande: om vi har händelser A och B, och händelse B beror på händelse A *, så följer det att LogicalTime för Event A är mindre än LogicalTime för Event B.
* Ibland sägs det också att A hände före B, det vill säga A inträffade före B – detta är en relation som delvis ordnar hela mängden av händelser som har inträffat.
Detta gäller inte åt andra hållet. Det är faktiskt en av de största nackdelarna med Lamport-klockan – delvis ordning. Det finns en uppfattning om samtidiga händelser, det vill säga händelser där varken (A hände före B) eller (B hände före A). Ett exempel kan vara parallell vänskap som Leonard lägger till någon annan (inte ens Leonard, utan Sheldon till exempel).
Det är just denna egenskap som ofta utnyttjas vid arbete med Lamport-klockor: man ser just på funktionen och drar slutsatsen – kanske är dessa händelser beroende av varandra. För i en riktning är det sant: om LogicalTime A är mindre än LogicalTime B, så kan B inte hända före A; och om det är större, så kan det vara.
Vektor klockor (Vector Clock)
Det logiska utvecklingen av Lamport-klockan är Vektor klockor. De skiljer sig åt genom att varje nod som finns här innehåller sina egna, separata klockor, och de överförs som en vektor.
I det här fallet ser du att den noll-indexerade vektorn svarar för Feed, medan den första indexerade vektorn svarar för Friends (var och en av dessa noder). Och nu kommer de att öka: noll-indexen för "Feed" ökar vid skrivning – 1, 2, 3:
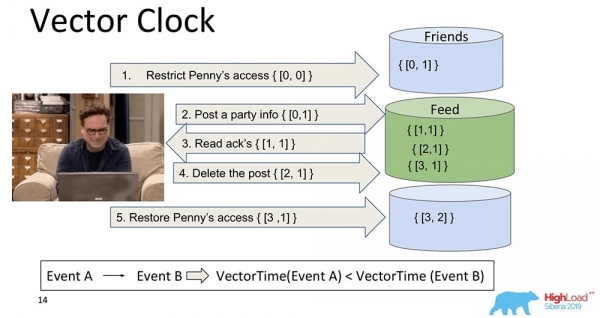
Vad gör vektorur bättre? De gör det möjligt att förstå vilka händelser som är samtidiga och när de sker på olika noder. Detta är mycket viktigt för sharding-systemet som "MongoDB". Vi valde dock inte detta, även om det är en fantastisk sak som fungerar bra och skulle passa oss, antagligen...
Om vi har 10 000 shardar kan vi inte överföra 10 000 komponenter, även om vi komprimerar och hittar på andra lösningar – lastern kommer fortfarande att vara många gånger mindre än volymen av hela denna vektor. Så, med tungt hjärta och tänder, avstod vi från detta tillvägagångssätt och gick över till ett annat.
Spanner TrueTime. Atomur
Jag sa att det skulle handla om "Spanner". Det är en fantastisk grej, verkligen 2000-talet: atomur, GPS-synkronisering.
Vad är idén? "Spanner" är ett Google-system som nyligen blev tillgängligt för allmänheten (de lade till SQL). Varje transaktion där har en viss tidsstämpel. Eftersom tiden är synkroniserad* kan varje händelse tilldelas en specifik tid – atomuren har väntetid efter vilken en annan tid garanterat "sker".
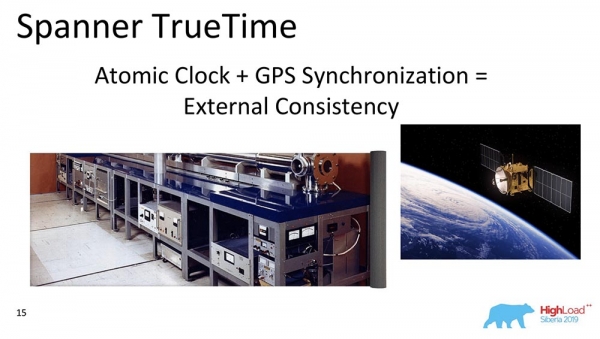
Så genom att helt enkelt skriva till databasen och vänta en viss tidsperiod garanteras serialiserbarheten för händelsen automatiskt. De har den starkaste konsistensmodellen som överhuvudtaget kan föreställas – den är extern konsistens.
* Detta är det grundläggande problemet med Lamports klockor – de är aldrig synkroniserade i distribuerade system. De kan avvika, även med NTP fungerar de fortfarande inte särskilt bra. "Spanner" har atomur och synkronisering, verkar vara på mikrosekundsnivå.
Varför valde vi inte det? Vi förutsätter inte att våra användare har inbyggda atomur. När de blir inbyggda i varje laptop, med supercool GPS-synkronisering – då ja… Men just nu är det bästa som är möjligt – "Amazon", basstationer – för entusiaster… Därför använde vi andra klockor.
Hybridklockor (Hybrid Clock)
Det här är faktiskt vad som tickar i 'MongoDB' för att säkerställa kausal konsistens. Vad är de hybridiska? En hybrid är ett skalarvärde, men det består av två komponenter:
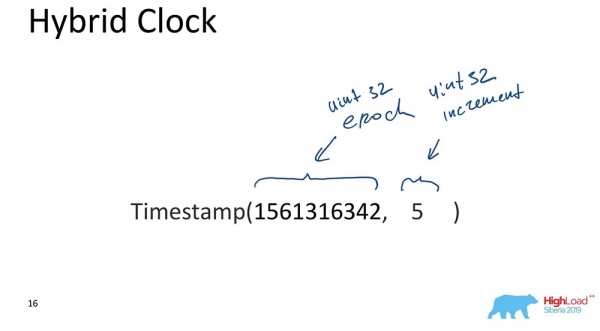
- Den första är Unix-epoken (hur många sekunder som har passerat sedan 'början av den digitala världen').
- Den andra är en viss inkrement, också en 32-bitars unsigned int.
Det är faktiskt allt. Det finns en metod: den del som ansvarar för tiden synkroniseras hela tiden med klockan; varje gång en uppdatering görs, synkroniseras den delen med klockan och det visar sig att tiden alltid är mer eller mindre korrekt, medan inkrementet gör det möjligt att särskilja händelser som inträffade vid samma tidpunkt.
Varför är detta viktigt för 'MongoDB'? För det möjliggör att skapa backup-restaureringar vid specifika tidpunkter, det vill säga händelsen indexeras med tid. Detta är viktigt när vissa händelser behövs; för databaser är händelser förändringar i databasen som inträffade vid specifika tidsintervall.
Den viktigaste orsaken säger jag endast till er (snälla, säg det inte till någon annan)! Vi gjorde det på det här sättet för att så ser ordnade, indexerade data ut i MongoDB OpLog. OpLog är en databasstruktur som innehåller alla förändringar i databasen: de hamnar först i OpLog och tillämpas sedan på lagringen i de fall det är replikerad data eller shard.
Detta var den huvudsakliga anledningen. Det finns också praktiska krav på databasutveckling, vilket innebär att det måste vara enkelt – lite kod, så få saker som möjligt som behöver skrivas om och testas. Att våra op-logs visade sig vara indexerade med hybridklockor hjälpte mycket och möjliggjorde rätt val. Det har verkligen lönat sig och fungerade på något magiskt sätt på den första prototypen. Det var riktigt häftigt!
Klocksynkronisering
Det finns flera sätt att synkronisera som beskrivs i den vetenskapliga litteraturen. Jag pratar om synkronisering när vi har två olika shards. Om det finns ett replikasett så behövs ingen synkronisering: det är en "singel-master"; vi har en OpLog dit alla förändringar går – i så fall är allt redan sekventiellt ordnat i själva "OpLog". Men om vi har två olika shards är tidssynkronisering viktig. Här har vektorklockor hjälpt mer! Men vi har inga.
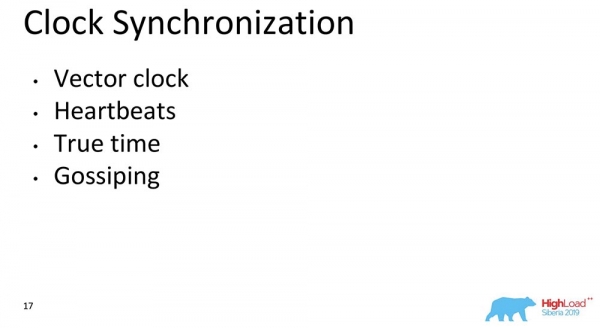
Det andra alternativet är "Heartbeats". Man kan utbyta vissa signaler som sker varje tidsenhet. Men "Heartbeats" är för långsamma, vi kan inte säkerställa latensen för vår klient.
True time – det är självklart en fantastisk sak. Men å andra sidan, det är nog framtiden… Även om man redan kan göra det i "Atlas", det finns redan snabba "amazoniska" tidssynkroniserare. Men detta kommer inte vara tillgängligt för alla.
Gossiping – det är när alla meddelanden inkluderar tid. Det är ungefär vad vi använder. Varje meddelande mellan noder, drivrutiner, routers för datanoder, absolut allt för "MongoDB" – det är vissa element, komponenter i databasen som innehåller klockor som tickar. De har överallt ett hybridt tidsvärde som överförs. 64 bitar? Det är möjligt, det kan göras.
Hur fungerar allt detta tillsammans?
Här överväger jag ett replikasett för att göra det lite enklare. Det finns en Primary och en Secondary. Secondary gör replikering och är inte alltid helt synkroniserad med Primary.
Det sker en insättning (insert) i "Primary" med ett visst tidsvärde. Denna insättning ökar den interna räknaren med 11, om det är max. Eller så kommer den att kontrollera tidsvärdena och synkronisera enligt klockorna, om tidsvärdena är högre. Det möjliggör tidsordning.
Efter att den har gjort en registrering sker en viktig punkt. Klockorna i "MongoDB" inkrementeras endast vid registrering i "OpLog". Detta är händelsen som förändrar systemets tillstånd. I praktiskt taget alla klassiska artiklar betraktas en händelse som att ett meddelande kommer in i noden: meddelandet kom – vilket betyder att systemet har ändrat sitt tillstånd.
Detta beror på att när man undersöker kan man inte riktigt förstå hur detta meddelande kommer att tolkas. Vi vet med säkerhet att om det inte reflekteras i "Oploggen", så kommer det inte att tolkas på något sätt, och förändringen av systemets tillstånd är endast en registrering i "Oploggen". Detta förenklar allt för oss: både modellen förenklas och det möjliggör ordning inom ett enda replikasett, och mycket annat användbart.
Det värde som redan är registrerat i "Oploggen" återlämnas – vi vet att detta värde redan ligger i "Oploggen", och dess tid är 12. Nu, låt oss säga, börjar läsningen från en annan nod (Sekundär), och den skickar redan afterClusterTime i själva meddelandet. Den säger: "Jag behöver allt som hände minst efter 12 eller under klockan tolv" (se bilden ovan).
Detta kallas för Kausal konsekvent (CAT). Det finns ett begrepp i teorin att detta är en viss tidsutsikt som är konsekvent i sig själv. I detta fall kan vi säga att detta är systemets tillstånd som observerades vid tidpunkten 12.
Just nu finns det inget här, eftersom detta på något sätt imiterar situationen när Sekundär behöver replikera data från Primär. Den väntar… Och här kommer datan – den återlämnar dessa värden.
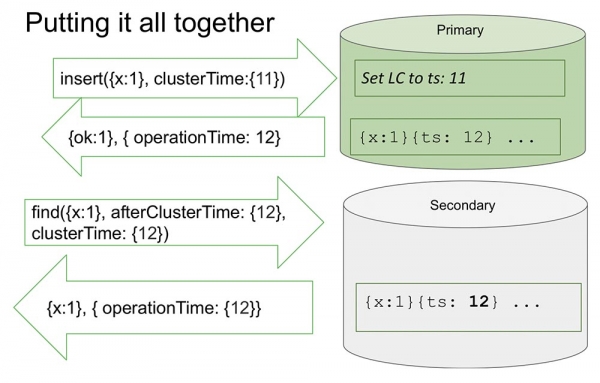
Så här fungerar det ungefär. Nästan.
Vad betyder "nästan"? Låt oss anta att det finns en viss person som läste och förstod hur allt detta fungerar. Förstod att varje gång sker ClusterTime, den uppdaterar de interna logiska klockorna, och sedan ökar nästa registrering med ett. Denna funktion tar 20 rader. Anta att denna person överför det maximalt stora 64-bitars numret, minus ett.
Varför "minus ett"? För att de interna klockorna kommer att sättas in i detta värde (uppenbarligen det största möjliga och större än den aktuella tiden), sedan kommer en registrering ske i "Oploggen", och klockorna kommer att öka med ännu ett – och då kommer det att vara det maximala värdet (där är bara ettor, det finns inget mer, unsaint int:s).
Det är tydligt att efter detta blir systemet helt otillgängligt för något. Det kan bara avlastas, rengöras – mycket manuellt arbete. Full tillgänglighet:
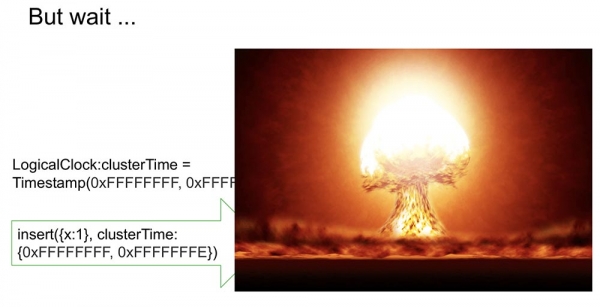
Om detta skulle replikeras någon annanstans, skulle hela klustret fallera. En absolut oacceptabel situation som vem som helst snabbt och enkelt kan åstadkomma! Därför betraktade vi denna punkt som en av de viktigaste. Hur kan vi förhindra det?
Vår väg är att signera clusterTime
Så det överförs i meddelandet (före den blå texten). Men vi började också generera en signatur (blå text):
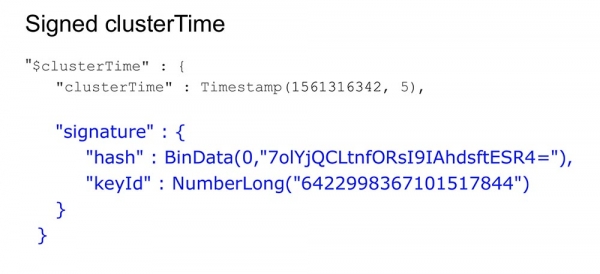
Signaturen genereras med en nyckel som lagras inom databasen, inom ett skyddat område; den genereras och uppdateras (användare ser inget av detta). En hash genereras, och varje meddelande signeras vid skapandet och valideras vid mottagandet.
Det väcker antagligen frågan hos folk: "Hur mycket sakta ner allt detta?" Jag har sagt att det ska fungera snabbt, särskilt utan denna funktion.
Vad betyder det att använda Causal consistency i detta fall? Det innebär att visa afterClusterTime-parametern. Utan den kommer den helt enkelt att överföra värden oavsett. Gossiping har alltid fungerat från version 3.6.
Om vi lämnar konstant signering av signaturer, kommer det att sakta ner systemet även utan funktioner, vilket inte stämmer överens med våra metoder och krav. Vad gjorde vi?
Gör detta snabbt!
En ganska enkel sak, men en intressant trick – jag delar med mig, kanske någon finner det intressant.
Vi har en hash som lagrar signerade data. All information går genom cachen. Cachen signerar inte specifikt tiden, utan Range. När ett visst värde kommer, genererar vi Range, maskerar de senaste 16 bitarna, och det värdet signerar vi:
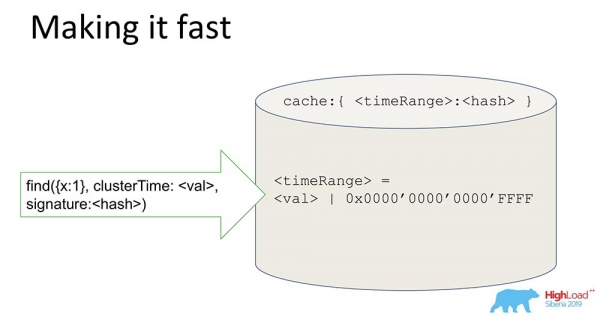
Genom att få en sådan signatur ökar vi systemets hastighet (teoretiskt) med 65 tusen gånger. Det fungerar utmärkt: när vi satte upp experimenten – tiden minskade verkligen med 10 tusen gånger när vi hade sekventiella uppdateringar. Klart att det inte fungerar när de är oordnade. Men i de flesta praktiska fall fungerar det. Kombinationen av Range-signaturen tillsammans med signaturen löste säkerhetsproblemet.
Vad har vi lärt oss?
Lektioner vi dragit från detta:
- Man måste läsa material, berättelser, artiklar, för att vi har mycket intressant. När vi arbetar med en funktion (särskilt nu när vi har genomfört transaktioner osv.) måste vi läsa och förstå. Det tar tid, men det är verkligen väldigt nyttigt, eftersom det blir tydligt var vi står. Vi har inte direkt kommit på något nytt – vi har bara tagit ingredienser.
Det råder överhuvudtaget en viss skillnad i tänkandet när det handlar om en akademisk konferens (som "Sigmon", till exempel) – där fokuserar alla på nya idéer. Vad är nyheten med vår algoritm? Här finns det inte mycket nyhet. Nyheten ligger snarare i hur vi blandade ihop befintliga metoder. Därför är det viktigt att läsa klassikerna, från Lamport.
- Inom produktion är kraven helt andra. Jag är säker på att många av er inte står inför "sferiska" databaser i ett abstrakt vakuum, utan med normala, verkliga saker som har problem med tillgänglighet, latens och felmotstånd.
- Det sista är att vi var tvungna att överväga olika idéer och kombinera flera helt olika artiklar till en metod, tillsammans. Idén om signering, till exempel, kom överhuvudtaget från en artikel som behandlade Paxos-protokollet, som för icke-byzantinska fel inom auktorisationsprotokollet, för byzantinska – utanför auktorisationsprotokollet... I stort sett är det precis vad vi i slutändan gjorde.
Det finns absolut ingenting nytt här! Men så snart vi blandade allt detta tillsammans... Det skulle vara som att säga att receptet på Olivier-sallad är nonsens, eftersom ägg, majonnäs och gurkor redan är uppfunna... Det är ungefär samma historia.
Jag avslutar här. Tack!
Frågor
Fråga från publiken (nedan – F): – Tack, Michail, för föredraget! Temat om tid är intressant. Ni använder Gossiping. Ni sa att alla har sin egen tid, alla vet sin lokala tid. Jag förstod det som att vi har en drivrutin – det kan finnas många kunder med drivrutiner, också många query-planners, och det finns också många shards... Vad händer med systemet om vi plötsligt får en avvikelse: någon bestämmer sig för att vara en minut före, någon annan – en minut efter? Var hamnar vi?
MT: – Faktiskt en bra fråga! Jag ville just nämna sharding. Om jag förstår frågan rätt, är vår situation sådan att vi har shard 1 och shard 2, och läsning sker från dessa två shards – de har olika tidpunkter och interagerar inte med varandra, eftersom den tid de är medvetna om är olika, särskilt tiden som de har i loggarna.
Anta att shard 1 har gjort en miljon poster, medan shard 2 inte har gjort något. Om en förfrågan kommer in till bägge shards och den första har afterClusterTime som är mer än en miljon. I en sådan situation, som jag har förklarat, kommer shard 2 aldrig att svara.
L: – Jag ville veta hur de synkroniserar och väljer en logisk tid.
MT: – Det är mycket enkelt att synkronisera. När en shard får afterClusterTime och inte hittar någon tid i "Loggen" – initierar den no approved. Det innebär att den manuellt höjer sin tid till detta värde. Det betyder att den inte har händelser som motsvarar denna förfrågan. Den skapar denna händelse konstgjort och blir därmed Causal Consistent.
L: – Men om den efter det skulle få flera händelser, som har försvunnit i nätverket?
MT: – Sharding är utformat så att de inte kommer att anlända, eftersom det är en single master. Om den redan har skrivit, så kommer de inte att anlända, utan de kommer senare. Det kan inte hända att något har fastnat någonstans, sen gör den no write, och plötsligt anländer dessa händelser – vilket skulle bryta den Causal consistency. När den gör no write måste alla komma igen (den kommer att vänta på dem).
L: – Jag har några frågor angående köer. Causal consistency innebär att det finns en specifik kö av åtgärder som måste utföras. Vad händer om en paket försvinner? Låt oss säga 10:e, 11:e… 12:e paketet försvinner, medan alla andra väntar på att det ska utföras. Om plötsligt maskinen kraschar, kan vi inte göra något. Finns det en maximal längd på kön som samlas innan den utförs? Vilken fatal failure inträffar vid förlust av ett enda tillstånd? Dessutom, om vi skriver att det finns ett tidigare tillstånd, hur ska vi då basera oss på det? Men vi baserade oss inte på det!
MT: – Också en utmärkt fråga! Vad gör vi? I MongoDB finns det begreppet kvorumförändringar och kvorumläsningar. Under vilka omständigheter kan ett meddelande försvinna? När en förändring inte är kvorum eller när en läsning inte är kvorum (det kan också vara något skräp).
Angående Causal consistency har vi genomfört omfattande experimentell testning, vars resultat visar att när skrivningar och läsningar är icke-kvorum finns det brott mot Causal consistency. Precis det du säger!
Vårt råd: använd åtminstone kvorum-läsning vid användning av Causal consistency. I så fall kommer inget att gå förlorat, även om kvorum-skrivningen försvinner... Det är en ortogonal situation: om användaren inte vill att data ska försvinna, måste kvorum-skrivning användas. Causal consistency garanterar inte hållbarhet. Hållbarhet garanteras av replikering och den mekanism som är kopplad till replikering.
L: – När vi skapar en instans som sköter vår sharding (inte master, utan slav), baseras den på maskinens unix-tid eller på "masterns" tid; synkroniseras den första gången eller periodiskt?
MT: – Låt mig förtydliga. En shard (dvs. en horisontell partition) har alltid en Primary. I en shard kan det finnas en "master" och det kan finnas repliker. Men en shard stödjer alltid skrivningar, eftersom den måste upprätthålla en viss domän (i sharden finns en Primary).
L: – Så allt beror helt och hållet på "mastern"? Används alltid "master-tid"?
MT: – Ja. Man kan bildligt säga: klockorna tickar när det görs en skrivning på "mastern", i "OpLog".
L: – Vi har en kund som kopplar upp sig, och han behöver inte veta något om tiden?
MT: – Absolut inget behöver han veta! Om vi pratar om hur detta fungerar på klientsidan: för klienten, när han vill använda Causal consistency, måste han öppna en session. Just nu finns allt där: både transaktioner i sessionen och hämta rättigheter… En session är en ordning av logiska händelser som inträffar med klienten.
Om han öppnar denna session och säger att han vill ha Causal consistency (om sessionen stödjer Causal consistency som standard), fungerar allt automatiskt. Drivrutinen kommer att komma ihåg denna tid och öka den när den får ett nytt meddelande. Den kommer att komma ihåg vilket svar som kom tillbaka från servern, som återgav data. Nästa begäran kommer att innehålla afterCluster ("tid större än detta").
Kunden behöver inte veta något alls! Det är helt oklart för dem. Vad gör man om man använder dessa funktioner? För det första kan man säkert läsa från sekundärer: man kan skriva till primär och läsa från geografiskt replikerade sekundärer och vara säker på att det fungerar. Dessutom kan sessioner som sparas på primär överföras till sekundär, dvs. man kan använda mer än en session.
L: – Den nya delen av datavetenskap som är starkt kopplad till temat eventuella konsekvenser är datatyperna CRDT (Conflict-free Replicated Data Types). Har ni övervägt integrationen av dessa datatyper i databasen och vad kan ni säga om det?
MT: – Bra fråga! CRDT är meningsfullt för konflikter vid skrivning: i MongoDB – en enda master.
L: – Jag har en fråga från devops. I den verkliga världen finns det sådana jesuitiska situationer där bysantinsk felaktighet inträffar och illvilliga människor inom den skyddade perimetern börjar manipulera protokollet, skickar specialtillverkade paket?
MT: – Illvilliga människor inom perimetern är som en trojansk häst! Illvilliga människor inom perimetern kan göra många dåliga saker.
L: – Det är uppenbart att lämna ett hål i servern, om man säger så, genom vilket man kan föra in en djurpark med elefanter och permanent krossa hela klustret... Det kommer att ta tid för manuell återställning... Det är, mildt uttryckt, fel. Å andra sidan är det intressant: förekommer det sådana situationer i verkliga livet, där sådana interna attacker inträffar?
MT: – Eftersom jag sällan stöter på säkerhetsbrott i verkliga livet, kan jag inte säga om de verkligen inträffar. Men när det gäller utvecklingsfilosofin så anser vi så här: vi har en gräns som skyddar de som arbetar med säkerhet – det är låset, muren; och inom perimetern kan man göra vad man vill. Det är klart att det finns användare med enbart utsiktsrättigheter, och det finns användare med rätten att radera kataloger.
Beroende på rättigheterna kan den skada som användare kan orsaka vara som en mus, eller så kan det vara en elefant. Det är klart att en användare med fulla rättigheter kan göra vad som helst. En användare med begränsade rättigheter kan orsaka avsevärt mindre skada. I synnerhet kan han inte krossa systemet.
L: – In the secured perimeter, someone is trying to form unexpected protocols for the server, to bring the server down, and if they’re lucky, maybe even the entire cluster… Is it ever that “good”?
MT: – I have never heard of such things. That it’s possible to take down a server this way is no secret. Taking it down from the inside, being an authorized user who can write something into the message… In fact, it can’t be done, because it still must be verified. There is a way to disable this authentication for users who do not want it – that’s their problem; they’ve essentially built walls themselves and could stuff an elephant in there, which would trample… Generally speaking, you can dress up as a repairman, come in, and pull it out!
L: – Thank you for the report. Sergey (Yandex). In Mongo, there is a constant that limits the number of voting members in the Replica Set, and this constant is equal to 7 (seven). Why is this a constant? Why isn’t this some kind of parameter?
MT: – We can have Replica Sets with up to 40 nodes. There is always a majority there. I don’t know which version…
L: – In a Replica Set, you can run non-voting members, but voting members are limited to a maximum of 7. How do we deal with a shutdown in this case, if our Replica Set is distributed across 3 data centers? One data center can easily go down, and another machine might drop out.
MT: – That’s already a bit beyond the scope of the report. It’s a general question. Maybe I can talk about it later.
Lite reklam 🙂
Tack för att ni stannar kvar hos oss. Gillar ni våra artiklar? Vill ni se fler intressanta material? Stöd oss genom att göra en beställning eller rekommendera oss till era vänner, , en unik motsvarighet till entry-level servrar som vi har skapat för er: (alternativ med RAID1 och RAID10 finns tillgängliga, upp till 24 kärnor och upp till 40GB DDR4).
Dell R730xd är två gånger billigare i datacentret Equinix Tier IV i Amsterdam? Bara hos oss i Nederländerna! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — från $99! Läs om
Källa: habr.com
