

In-Memory — en uppsättning koncept för datalagring där informationen sparas i applikationens minne och disken används för backup. I klassiska metoder lagras data på disken och minnet används som cache. Till exempel, en webbapplikation med backend för databehandling begär data från lagringen: den hämtar, transformerar och överför stora datamängder via nätverket. Med In-Memory skickas beräkningarna till data — till lagringen, där de behandlas och nätverket belastas mindre.

Vilka ytterligare möjligheter som erbjuds med In-Memory och vad denna metod innebär, kommer att diskuteras av Vladimir Pligin — ingenjör på GridGain. Detta översiktsmaterial kommer vara användbart för backendutvecklare av webbapplikationer som inte har arbetat med In-Memory och vill prova, eller som är intresserade av moderna utvecklingstrender och arkitekturprojekt.
Anmärkning. Artikeln är baserad på en avskrift av Vladimirs föredrag vid konferensen #GetIT Conf. Fram till införandet av självisolering höll vi regelbundet meetups och konferenser för utvecklare i Moskva och Sankt Petersburg: vi diskuterade trender, aktuella frågor inom utveckling, problem och deras lösningar. Nu kan vi inte hålla konferenser, men det är en utmärkt tid att dela värdefullt material från det förflutna.
Vem och hur använder In-Memory
In-Memory används oftast där det krävs snabb interaktion med användaren eller behandling av stora datamängder.
- Banker använder In-Memory, till exempel för att minska fördröjningar när kunder använder applikationer eller för att analysera kunder före utlåning.
- Fintech använder In-Memory för att förbättra prestandan av tjänster och applikationer för banker som outsourcar bearbetning och analys av data.
- Försäkringsbolag: för riskbedömning, till exempel genom att analysera kunddata under flera år.
- Logistikföretag. De hanterar stora mängder data, till exempel för att räkna ut optimala rutter för gods- och passagerartransport med tusentals parametrar, samt spåra status på leveranser.
- Detaljhandeln. In-Memory lösningar hjälper till att snabbare betjäna kunder och hantera stora volymer information: leveranser, fakturor, transaktioner, tillgänglighet av tusentals varor på lagren och skapa analytiska rapporter.
- I IoT In-Memory ersätter traditionella databaser.
- Pharmaceutical företag använder In-Memory, till exempel för att pröva kombinationer av läkemedelsingredienser.
Jag kommer att ge några exempel på hur våra kunder använder In-Memory lösningar och hur ni kan implementera dem själva.
In-Memory som primär lagring
En av våra kunder är en stor leverantör av medicinsk forskningsutrustning från USA. De använder en In-Memory lösning som primär datalagring. Alla data lagras på disk, medan en delmängd av de aktivt använda data hålls i RAM. Åtkomstmetoderna till lagringen är standard — GDBC (Generic Database Connector) och SQL-språk.
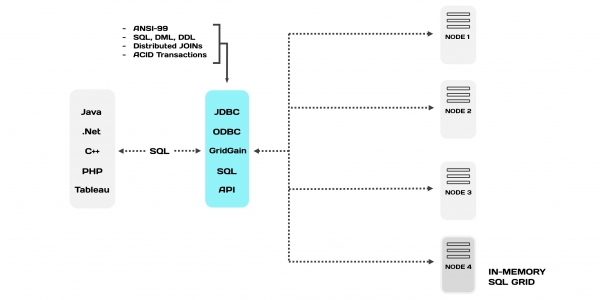
Tillsammans kallas detta In-Memory Database (IMDB) eller Memory-Centric Storage. Denna typ av lösningar har många namn, och det är inte de enda.
Funktioner hos IMDB:
- Data som lagras i In-Memory och är tillgängliga via SQL är desamma som i andra tillvägagångssätt. De är synkroniserade, endast sättet att representera och hur man kommer åt dem skiljer sig. Det finns transaktionalitet mellan data.
- IMDB är snabbare än relationella databaser, eftersom det är snabbare att hämta information från RAM än från disk.
- Interna optimeringsalgoritmer har färre instruktioner.
- IMDB är lämpliga för att hantera data, händelser och transaktioner i applikationer.
IMDB stöder delvis ACID: atomicitet, konsistens och isolering. Men de stöder inte 'haltbarhet' — vid strömavbrott försvinner all data. För att lösa problemet kan man använda snapshots – en 'bild' av databasen, analog med databackup på en hårddisk, eller registrera transaktioner (loggar) för att återställa data efter omstart.
För att skapa robusta applikationer
Vi presenterar en klassisk arkitektur för ett felresilient webbapplikation. Den fungerar så här: alla förfrågningar fördelas av en webbbalanserare mellan servrarna. Detta system är motståndskraftigt eftersom servrarna duplicerar varandra och skyddar vid incidenter.
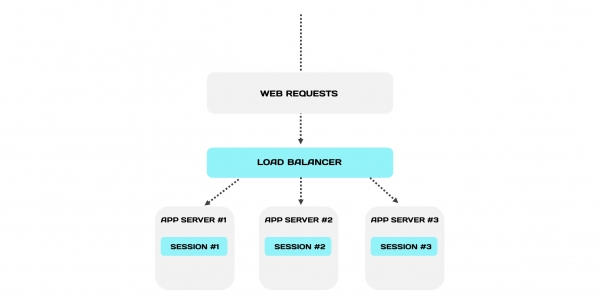
Balanseraren dirigerar alla förfrågningar från en session strikt till en server. Detta är ett mekanism för sticky sessions: varje session knyts till servern, där den lagras och bearbetas lokalt.
Vad händer när en av servrar?
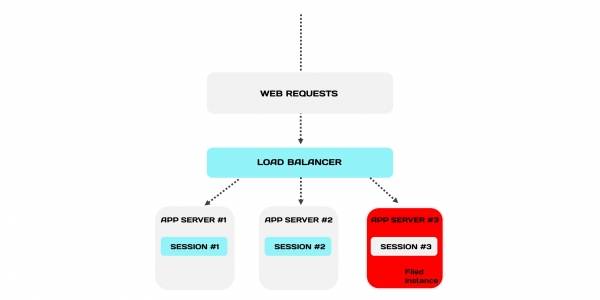
servrarna fallerar? Tjänsten påverkas inte, eftersom arkitekturen är duplicerad. Men vi kommer att förlora en del av sessionerna från den avlidna servern. Dessutom förlorar vi användare som är kopplade till dessa sessioner. Till exempel, om en kund gör en beställning och plötsligt blir utloggad. Han kommer att bli missnöjd när han måste logga in igen och upptäcker att han måste göra om hela beställningen.
Det krävs att webbapplikationen ska stödja ett stort antal användare och inte "segna ner" för att ge dem en bekväm arbetsmiljö. Men vid ett fel, med varje följande förfrågan kommer tiden för kommunikation med sessionens lagring att öka. Detta ökar den genomsnittliga latensen för de övriga användarna. Men de vill inte vänta längre än de är vana vid.
Detta problem kan lösas, som vårt andra klient — en stor PASS-leverantör från USA. De använder In-Memory för att klustra webb-sessioner. För detta lagrar de dem inte lokalt, utan centralt — i en In-Memory kluster. I det här fallet är sessionerna mycket snabbare tillgängliga, eftersom de redan finns i RAM.
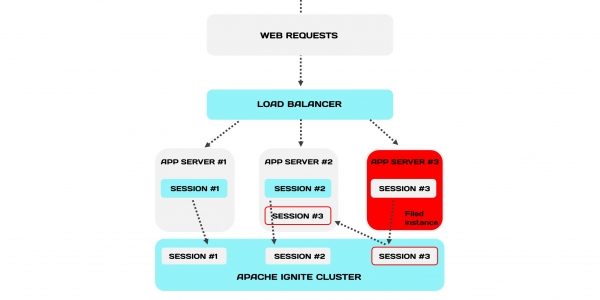
När en server faller, skickar balanceraren förfrågningar från den nedlagda servern till andra servrar, precis som i den klassiska arkitekturen. Men det finns en viktig skillnad: sessionerna lagras i In-Memory klustret och servrarna har tillgång till sessionerna från den nedlagda servern.
Denna arkitektur ökar hela systemets felresistens. Dessutom är det möjligt att helt överge mekanismen för sticky sessions.
Hybrid transaktions-analytisk bearbetning (HTAP)
Vanligtvis hålls transaktions- och analytiska system åtskilda. När de delas upp belastas den primära databasen. För analytisk bearbetning kopieras data till en replika, så att den analytiska bearbetningen inte stör transaktionsprocesserna. Men kopieringen sker med fördröjning — utan fördröjning är replikering omöjlig. Om vi gör detta synkront kommer det också att sakta ner den primära databasen, och vi får inga vinster.
I HTAP fungerar allt annorlunda — samma datalager används för transaktionsbelastning från applikationer och för analytiska frågor, som kan ta lång tid att utföra. När data ligger i RAM-minnet utförs de analytiska frågorna snabbare, och databasservern belastas mindre (i genomsnitt).
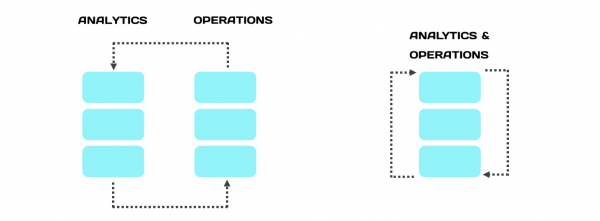
Den hybrida metoden "bryter väggen" mellan transaktionsbearbetning och analys. Om vi gör analys på samma datalager, kommer de analytiska frågorna att köras på data från RAM-minnet. De är mycket mer precisa, mer tolkbara och adekvata.
Integrering av In-Memory-lösningar
Ett enkelt (relativt) sätt — att utveckla allt från grunden. Vi håller data på disken, medan heta data lagras i minnet. Det hjälper oss att överleva serveromstarter eller strömavbrott.
Här fungerar två huvudscenarier när data lagras på disken. I det första vill vi överleva krascher eller planerade omstarter av klustret eller delar därav — vi vill använda det som en vanlig databas. I det andra scenariot, när det finns för mycket data, är en del av den i minnet.
Om det inte är möjligt att bygga allt från grunden kan vi integrera In-Memory i redan existerande arkitektur. Men inte alla In-Memory-lösningar är lämpliga för detta. Det finns tre obligatoriska villkor. In-Memory-lösningen måste stödja:
- ett standardiserat sätt att ansluta till databasen som kommer att vara under den (till exempel MySQL);
- ett standardiserat frågespråk för att inte behöva omskriva och ändra logiken för interaktionen med lagret;
- transaktionshantering — för att bevara semantiken i interaktionen.
Om alla tre villkor är uppfyllda är integration möjlig. Vi placerar In-Memory Data Grid mellan applikationen och databasen. Nu kommer skrivfrågor att delegeras till den underliggande databasen, medan läsförfrågningar går till databasen om data inte finns i cachen.
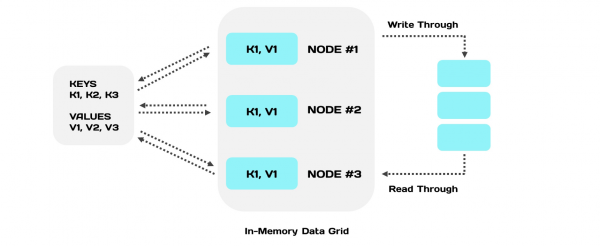
Om snabb åtkomst till data och dess bearbetning är viktigt för dig, till exempel för affärsanalys – kan man överväga att implementera In-Memory. För genomförandet kan du använda båda metoderna när du designar en ny arkitektur.
Källa: habr.com
